前言
大多数糟糕的数据库,往往是由一群认真做事的人亲手打造的。
我修复过的每个问题数据库结构,起点都惊人一致:有人从某处读到一条规则,然后不加区分地把它应用到所有地方。软删除、UUID 主键、严格按书本做规范化。刚引入时,它们看起来都很正确。账单是在数据增长之后才送来的。
十多年来,我一直在收拾这些规则留下的残局。下面是我如今会反对默认采用的十条实践。
全文会贯穿同一个例子:一家网店,包含四张表:customers、products、orders 和 order_items。
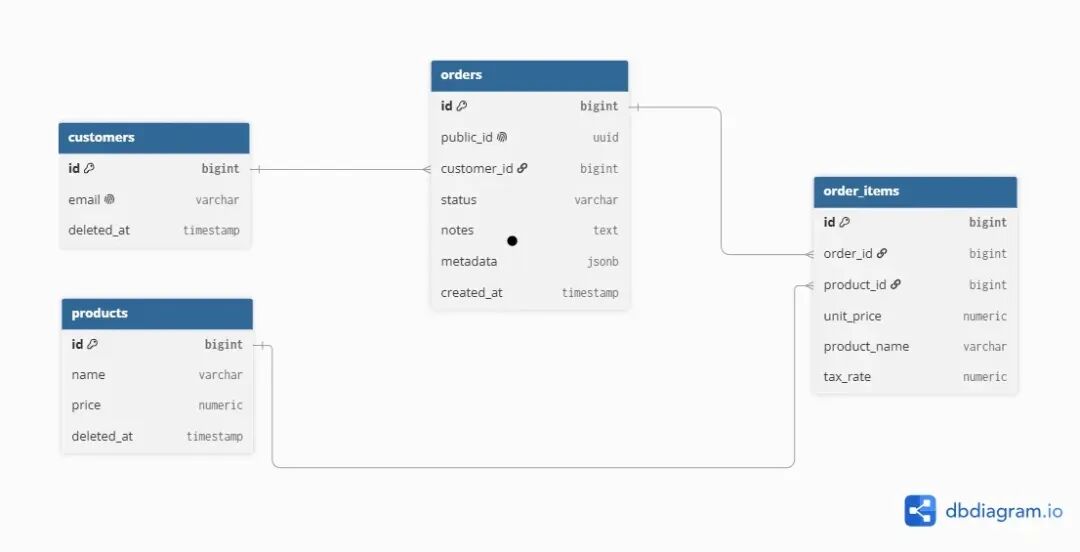
设想这样的情景:上线当天只有五千行数据,两年后增长到四千万行。下面这些做法在前一种规模下都无伤大雅,到了后一种规模却都代价高昂。
1. 对每一行数据都使用软删除
常见观念: 永远不要删除任何数据。给每张表添加一个 deleted_at 列,读取时隐藏这些行。
我接手的数据库结构中,几乎都能看到软删除。理由总是一样。
但没人提醒你,隐藏这些行的工作永远不会结束。对这张表的每次查询,都必须排除已删除的行。每个服务都要如此,只要产品还在运行。只要忘记一次,已删除的商品就会出现在店铺页面上。我确实发布过这样的 bug,而且是客户先发现的。
-- 现在,每个服务中的每次读取都必须带上这个过滤条件
SELECT * FROM products WHERE deleted_at IS NULL;
唯一列是第二个意外。客户删除了账户,后来又使用同一个邮箱回来注册。旧记录仍然在那里,于是唯一性约束拒绝了他们。
我仍然对订单和客户使用软删除,因为业务确实会要求恢复它们。会话表和日志表则真正删除数据。在使用软删除的地方,我会把过滤条件集中放在一个视图中。如果几百条查询都靠记忆来确保过滤,店铺页面上的那个 bug 就已经在等着你了。
2. 使用随机 UUID 作为主键
常见观念: 所有主键都用 UUID。它们可以跨服务使用,不会暴露客户数量,而且客户端也能生成。
这些理由都很好,也正因如此,这条实践很难反驳。问题出在版本上。UUID 第 4 版是随机的。随机键与数据库存储数据行的方式相冲突。
在 MySQL 中,表按主键的顺序进行物理存储。新行会被放到其键值对应的位置。使用随机键时,这个位置往往在中间。
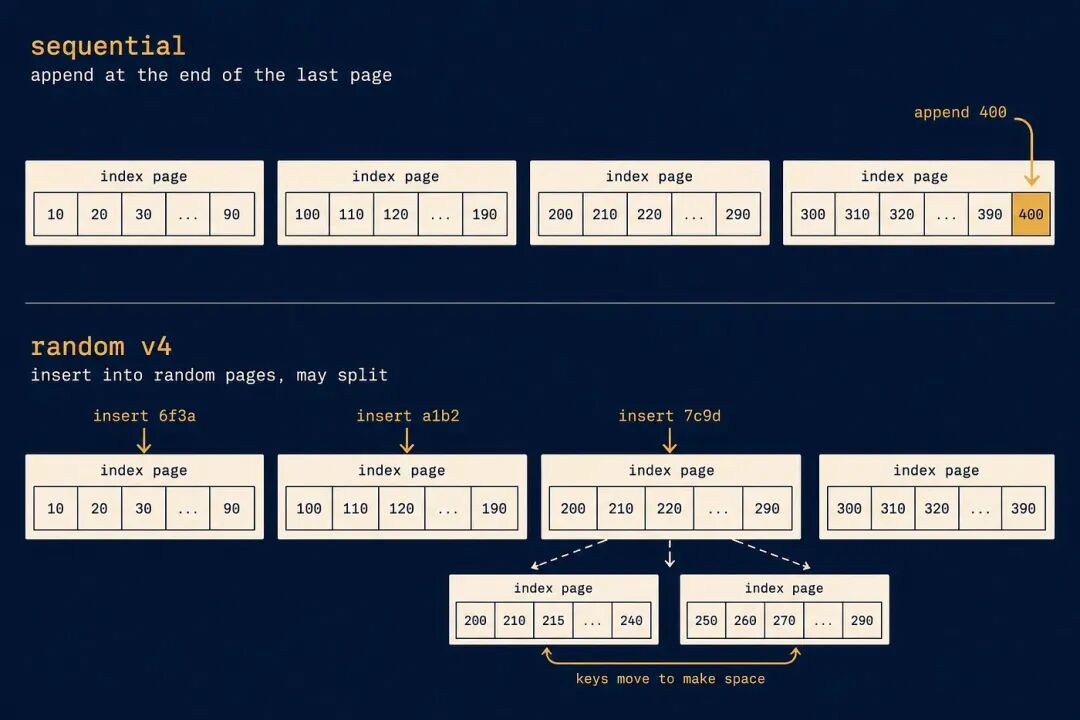
于是,数据库需要分裂数据页、移动数据来腾出空间。索引还装得进内存时,这没什么问题。一旦装不下,插入就得等待磁盘操作。
键的大小又让情况更糟。UUID 占 16 字节,bigint 占 8 字节。其他每个索引都会在自身数据旁边存储一份主键副本。我的 order_items 表有四千万行和四个索引。这个差异最终达到了数 GB。
你可以保留那些好处,同时避免这种代价:使用能按时间排序的 ID。UUIDv7 和 ULID 都以时间戳开头。这样,新行就会落在索引末尾,而不是中间。
对于已经到处使用第 4 版 UUID 键的数据库结构,我会采用另一种方式:数据库内部使用 bigint 主键,对外暴露 UUID。
ALTER TABLE orders ADD COLUMN public_id UUID NOT NULL UNIQUE;
3. 规范化到得不偿失
常见观念: 每个事实只存储在一个地方,任何值都不要重复。
规范化让人觉得自己在认真、正确地做事,所以它很容易通过评审。对于当下成立的事实,它很有效。对于历史信息,它却会悄悄失效。
以订单为例。order_items 存储 product_id,价格则存储在 products 中。有人三月份花 499 买了一件衬衫。六月份,你把价格涨到了 799。于是,三月份的发票现在也显示 799。
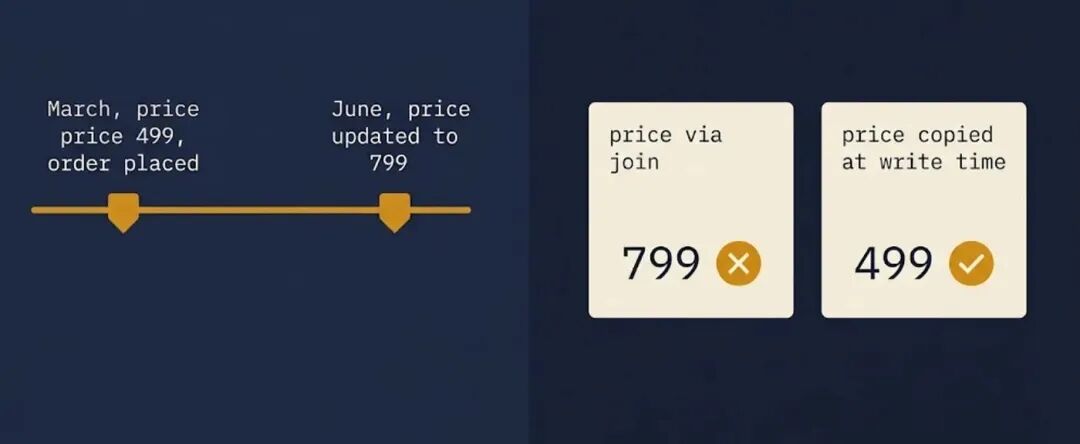
你并不是丢失了旧价格,而是从来没有把它记录下来。
任何必须保持不变的信息,都应该在下单时复制一份。价格、商品名称和税率,都直接存储在订单记录中。
-- order_items 保存的是客户实际支付的价格,而不是这件衬衫今天的价格
unit_price NUMERIC(10,2) NOT NULL,
product_name TEXT NOT NULL,
tax_rate NUMERIC(5,2) NOT NULL
这是有意为之的重复。商品目录一旦变化,它就不再是重复信息。订单记录的是已经发生的事情。读取成本也顺带降低了。发票页面所需的联接从六次减少到了一次。
4. 每遇到一条慢查询就添加索引
常见观念: 查询慢,就给它加一个索引。不断重复,直到慢查询列表清空。
索引是善意不断堆积的地方。告警消失后,所有人都继续忙别的事。没人回头看看还有哪些索引留在那里。代价落在写入上。插入一条订单,除了更新表,还要更新表上的每个索引。
我接手的 orders 表有十四个索引,其中好几个在做同一件事。如果已经有了 (status, created_at) 索引,那么单独的 status 索引就是累赘。组合索引也能处理只按 status 查询的情况。
另一些索引根本不会被使用。status 只有四种可能的值,所以查询规划器认为扫描整张表更便宜。创建任何索引之前,先看执行计划。EXPLAIN ANALYZE 会告诉你,数据库到底会不会选择它。然后,再去找那些没人使用的索引。
SELECT indexrelname, idx_scan
FROM pg_stat_user_indexes
WHERE idx_scan = 0;
一个下午,我删掉了其中六个。写入耗时下降了大约三分之一。
5. 为了速度移除外键
常见观念: 外键会拖慢写入,反正应用已经在验证数据了。
应用验证的是你记得覆盖的路径。批量导入不走这些路径,管理脚本也不走,某个人晚上十一点执行的一次性修复同样不走。
等我检查时,已经有接近一万两千条 order_items 记录指向不存在的商品。数据损坏几个月后,一份财务报表崩溃,才暴露了这个问题。
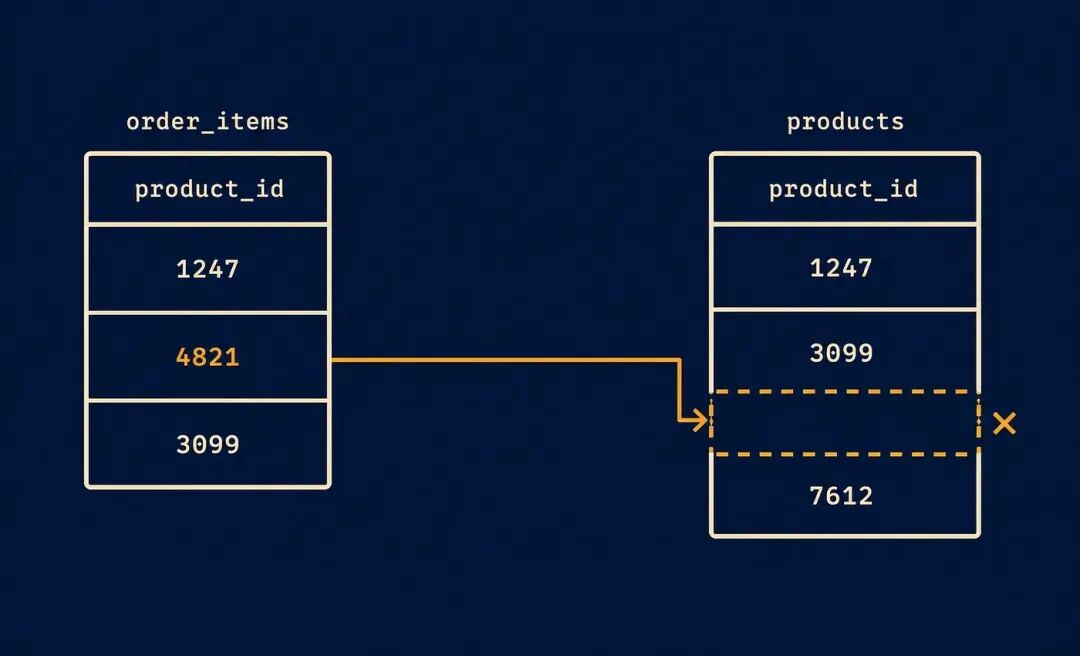
算一算你想省掉的那点成本:外键每次写入只需要一次索引查找。在单个服务的数据库内部,我始终保留外键。跨两个服务时,则无法建立这样的外键。因此,必须有一个机制定期比较两边的数据,并报告不一致之处。
6. 让 ORM 编写所有查询
常见观念: 所有查询都交给 ORM。代码保持可移植,也没人需要写 SQL。
处理普通读写时,ORM 有充分的价值。但当你开始构建第一个仪表盘时,它就不再处处合适了。为一个页面加载五十条订单,再让每条订单各自获取客户信息。为了显示一个页面,你执行了五十一条查询。实现这个行为的代码,看起来只有一行。
# 看起来只有一行,却执行了五十一条查询
for order in Order.objects.all()[:50]:
    print(order.customer.name)
更隐蔽的成本来自多余的列。ORM 会请求整行数据。
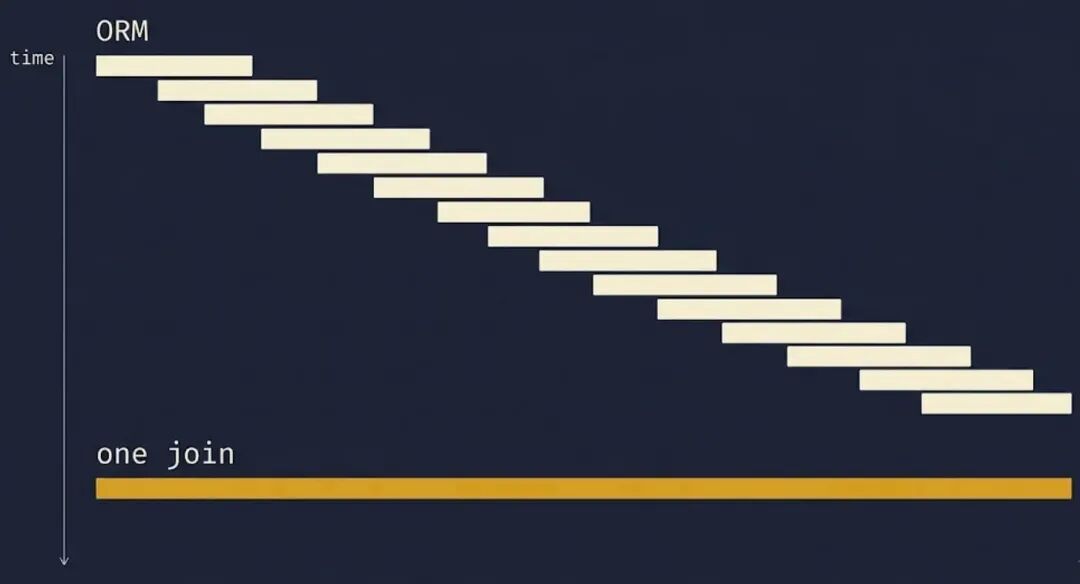
你的 orders 表有一个占 4KB 的备注字段。你只需要 ID 和总金额,却为此传输了 200MB 的数据。
(原文此处数字不一致:若沿用前面的五十条订单,仅备注字段的数据量约为 200KB。)
我仍然让 ORM 处理 CRUD。报表、仪表盘和关键性能路径则用 SQL 编写。开发时,统计每个请求执行的查询数。超过二十条,就值得在发布前检查一下。
7. 把业务规则放进触发器
常见观念: 放在数据库里的规则无法被绕过。把规则写进触发器,每个客户端都能受到保护。
触发器是我态度尤其坚决的一项,因为它曾让我白白损失了一个星期。
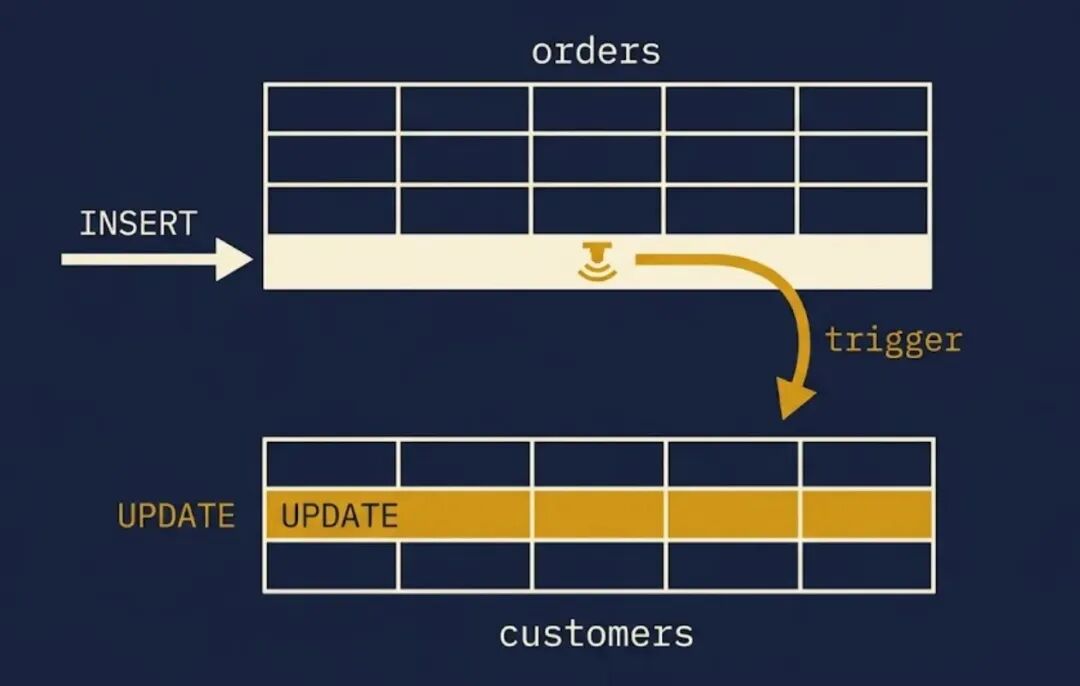
网店里的订单总是自行改变状态。没有任何支持工单能解释原因,日志也对不上。于是,我检查了所有会操作 orders 表的代码:API、管理后台、后台任务,以及一个夜间运行的报表脚本。然后,我给它们全都加上日志。我亲眼看到一次状态变化发生,但新增的日志一条都没有输出。
原因是一个触发器。它是我几个月前亲手写的,但我已经忘记了它的存在。这才是把规则放在那里真正的代价。触发器不会留下可供追踪的线索。没有堆栈跟踪指向它,在代码仓库里搜索也找不到任何结果。
性能成本更容易看出来。触发器每行触发一次。导入二十万条历史订单,就悄悄变成了二十万次额外写入。测试也救不了你。大多数测试套件会用一个假的数据库替换真实数据库。规则根本不会在你能观察到的地方运行。
约束留在数据库中,业务规则放在应用里。NOT NULL、CHECK、UNIQUE 和外键描述什么样的数据行才有效,这部分是数据库的职责。触发器只用来写审计记录,别做其他事情。
8. 把数据库当作任务队列
常见观念: 既然已经在运行 Postgres,就把任务放在一张表里。消息代理只会增加一项运维负担。
对于小项目,我仍然会为这个做法辩护。运行消息代理确实需要运维工作,而任务表没有额外成本。当网店每天的任务量超过几千个时,这种方案就撑不住了。十个任务处理进程每秒都轮询这张表,每个进程更新自己抢到的那一行。
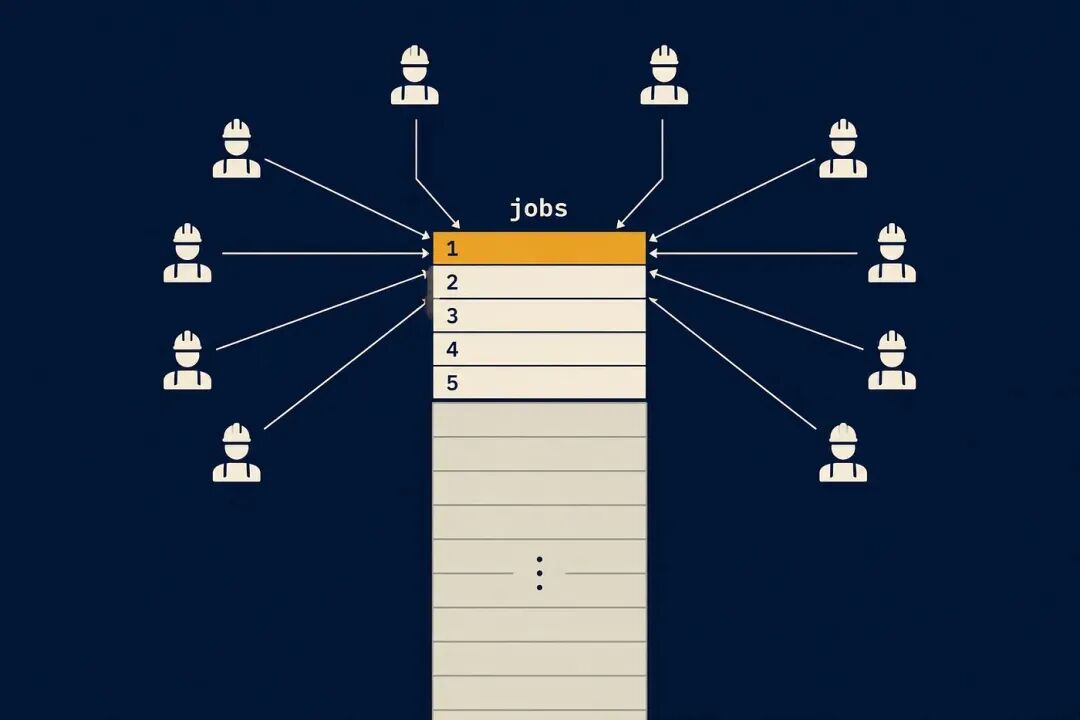
它们的大部分时间都花在互相等待上,因为它们总是在争抢同一些行。已经完成的任务让情况更糟。Postgres 不会立即清除旧版本的数据行,负责清理它们的后台进程已经跟不上了。在一家卖衬衫的店里,一张待处理任务表竟然成了最忙的东西。
保留 outbox。同一个事务里同时写入任务和业务数据,这个能力值得保留。但投递工作应该交给专门为此设计的系统。如果不能使用消息代理,就用 FOR UPDATE SKIP LOCKED。这样,每个任务处理进程只会获取未被其他进程持有的行。每天清理一次,则能防止这张表无限增长。
SELECT * FROM jobs
WHERE status = 'pending'
ORDER BY created_at
LIMIT 10
FOR UPDATE SKIP LOCKED;
9. 所有可能变化的内容都放进 JSON 列
常见观念: 需求一直在变,所以添加一个 metadata JSON 列,省掉数据库迁移。
它始于一点小小的便利,最后却变成了数据被遗忘的地方。orders 表里就有这么一列,里面放着优惠码、礼物留言、推荐来源和 A/B 测试分组。没有类型约束,也没有任何校验。两个团队连续八个月分别往同一列中写入 coupon_code 和 couponCode。没人注意到。
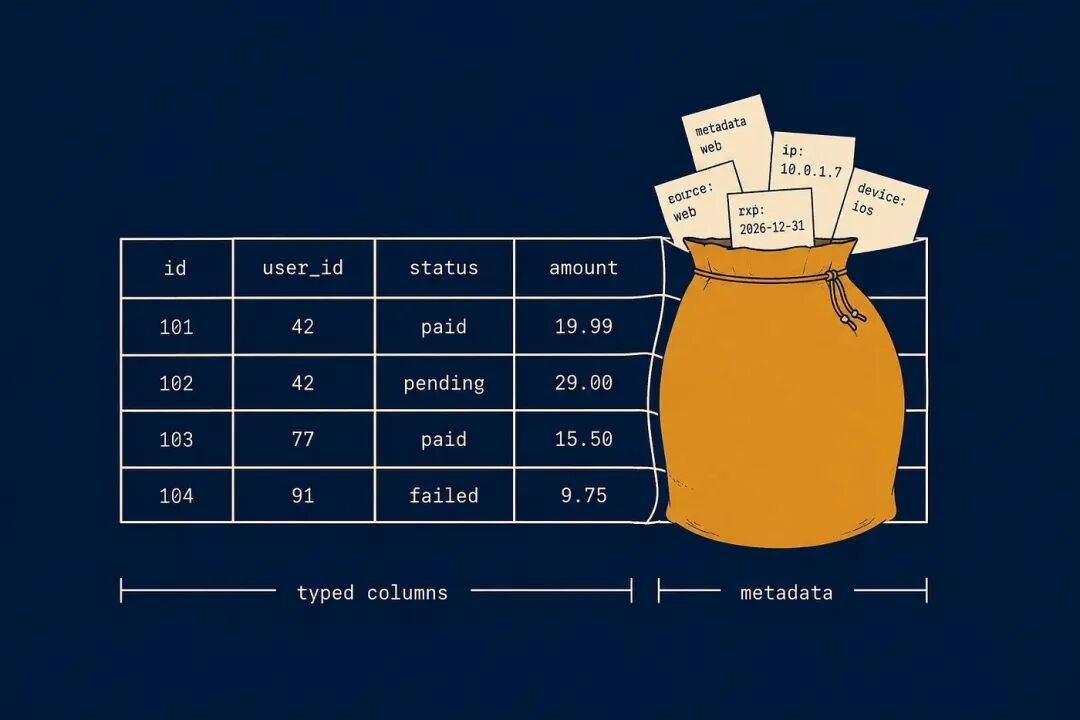
后来,财务终于来问优惠券一共花了多少钱。每条查询都需要 JSON 路径,而一半的记录使用了另一种拼写。原本几分钟就能得到的答案,花了好几天。
JSON 应该用于结构不受你控制的数据。实际来说,就是 webhook 请求体和第三方响应。只要开始按某个键进行筛选或生成报表,就把它提升为真正的列。一次迁移的成本,比一年后猜测字段拼写要低得多。
10. 在应用启动时运行迁移
常见观念: 应用启动时运行迁移。数据库结构始终与代码匹配,部署也只需要一步。
直到应用运行多个副本的那一天,这个说法都成立。网店运行了三个 pod。一次部署同时启动了它们,三个都尝试执行迁移。
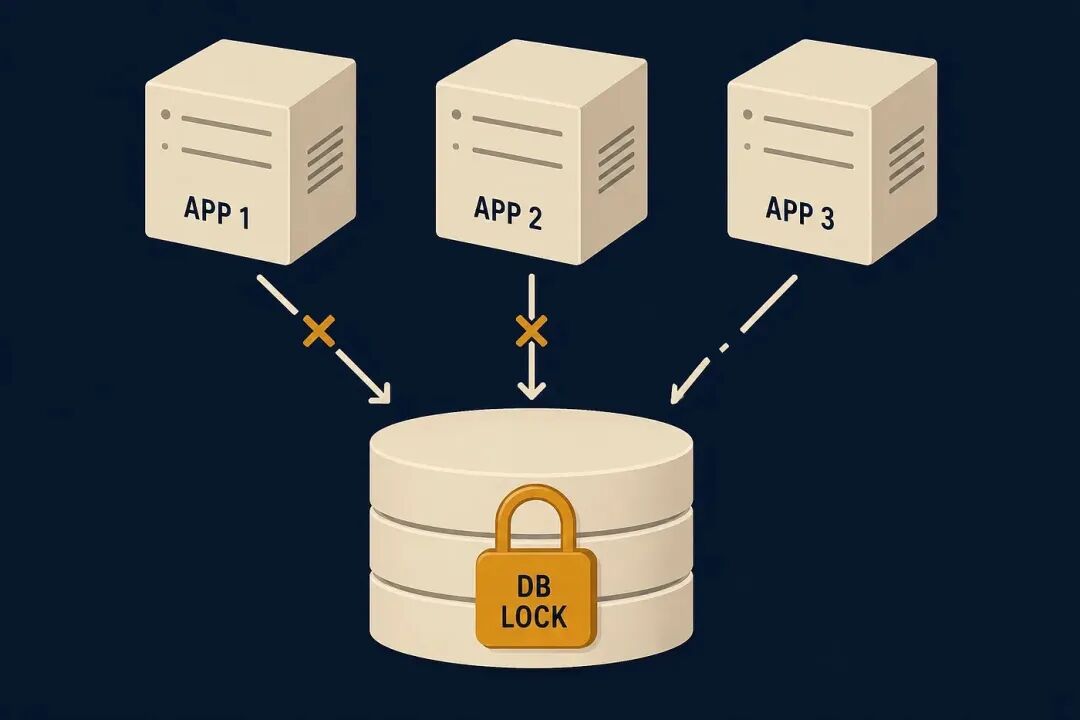
其中两个等不到锁,放弃了。第三个执行到一半就崩溃了。此时的数据库结构,与代码仓库中的任何分支都不匹配。真正痛苦的是回滚。现在,要撤销数据库结构变更,竟然还需要部署代码,而且是在故障处理中、网站已经停机的时候。
在流水线里给迁移安排独立步骤,放在部署之前。只有一个进程,也只有一份日志需要查看。高风险改动分阶段发布。先添加列,再发布同时写入新旧两列的代码,接着回填数据,最后在后续版本中删除旧列。步骤更多了,但网站在整个过程中都能保持运行。
这十条实践有什么共同点
每一条都会让你今天得到一点便利,也都会在以后向你收取代价。软删除省去一次迁移,却让你欠下每次查询都必须带上的过滤条件。JSON 列跳过一次结构变更,却换来一个报表问题。
如果这是你有意识作出的取舍,就没有什么问题。问题在于它默认就这样发生了。某篇文章把它称为最佳实践,于是没人计算过成本。数据库比应用代码更难容忍错误。一个糟糕的类,一个下午就能重写。修改四千万行数据表的主键,则是一个需要回滚计划的项目。
我现在遵循的最佳实践
这些做法都不稀奇。它们是我设计新数据库结构时采用的默认做法,也是接手已有数据库时最先调整的地方。
- 复制所有必须保持不变的信息。 价格、商品名称和税率应该直接放在订单记录里,而不是通过联接获取。
- 让键值有序。 使用 UUIDv7 或 ULID,或者内部用
bigint 主键,对外用 UUID。
- 创建索引前,先证明它有用。 先运行
EXPLAIN ANALYZE,再检查 idx_scan,看看哪些索引可以删除。
- 完整性放在数据库结构中,行为放在代码里。 约束描述有效的数据行,决策属于应用。
- 只对业务会恢复的数据使用软删除。 订单可以,会话表不行。把过滤条件集中在一个视图中。
- 开始查询 JSON 键时,就把它提升为列。 一旦代码需要按某个字段筛选或生成报表,就为它建立单独的列。
- 在任务表成为热点之前,把工作移出去。 保留 outbox,让真正的队列负责投递。
- 数据库结构与代码分开发布。 迁移在流水线中只运行一次,放在逐步部署之前。
- 按今天数据量的一百倍评估每项选择。 那才是你真正需要长期面对的数据表。
这些实践没有哪一条在所有场景下都是错误的。软删除适用于订单,JSON 列适用于 webhook 载荷,触发器用于审计表也没问题。重要的是:一条规则是为哪个阶段写的,以及你应用它时处于哪个阶段。大多数数据库建议是为上线当天写的,却在两年后才被读到。
制定这些规则的人并没有错。他们的建议适用于另一个数据库,而不是你现在拥有的这个。
如果你也踩过类似的数据库设计坑,欢迎到云栈社区分享你的实战经验。
 发表于 1 小时前
|
查看: 5|
回复: 0


