服务器返回 200、香港节点延迟正常、页面也打开了,但“加入购物车”的按钮却被一个透明图层遮住,用户仍然无法下单。这就是合成监控要解决的缺口:不只监控组件是否存活,而是按真实用户路径定期完成一次任务,证明用户确实能走完关键旅程。
AWS 在 9 月 28 日发布了一套基于 Amazon Nova Act 与 Bedrock AgentCore 的实现: EventBridge Scheduler 定时启动, AgentCore Runtime 托管执行, Browser 工具为每次运行提供隔离浏览器,Nova Act 根据截图和自然语言执行动作,失败后通过 SNS 通知。官方样例代码已经公开,典型 6 步旅程依页面加载情况通常需要 2—4 分钟。
传统 Selenium 脚本常把 class 或 XPath 当成真相,界面一重构就会大面积误报。Nova Act 用多模态大模型处理截图,官方称早期企业案例中浏览器流程准确率超过 90%。不过这是厂商案例,不是对所有网站的承诺;Agent 同样会看错、点错,因此必须把“动作”和“结果断言”分开。
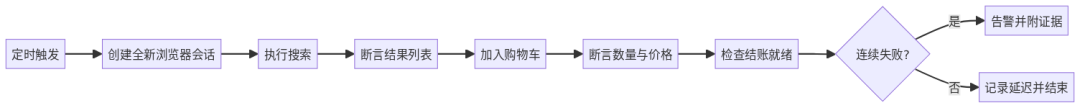
最小实践:别让一次模型抖动直接升级为事故
from dataclasses import dataclass

@dataclass
class Step:
    name: str
    ok: bool
    ms: int

def assess(run):
    required = {"search", "cart", "checkout"}
    seen = {step.name for step in run if step.ok}
    return required <= seen and sum(step.ms for step in run) < 10_000

runs = [
    [Step("search", True, 800), Step("cart", True, 900), Step("checkout", True, 1200)],
    [Step("search", True, 700), Step("cart", False, 1100), Step("checkout", False, 0)],
    [Step("search", True, 750), Step("cart", False, 1300), Step("checkout", False, 0)],
]

results = [assess(run) for run in runs]
alert = len(results) >= 2 and results[-2:] == [False, False]
print("results=", results, "alert=", alert)
assert alert
保存为 journey_gate.py,用 Python 3.9+ 直接运行,没有第三方依赖。这段代码不只是要求三个关键结果全部出现,还限制了总时间,并且只在连续两次失败后才触发告警。本次在 Python 3.9.6 中实际运行,结果为 [True, False, False],告警断言通过。当然,这只验证了状态与告警逻辑;本次没有 AWS 凭据,因此并未实际运行 Nova Act 或 AgentCore。
真实实现中,每次旅程都应该使用全新会话,避免 cookie、LocalStorage 或购物车残留让测试“假通过”。AWS 文档提到, AgentCore Runtime 采用一会话一 Firecracker microVM,合成监控也推荐使用临时会话。身份凭据放在 Secrets Manager 中,运行角色只授予打开浏览器和发送告警的最小权限,监控账号不应具备真实支付能力。
最常见的误区有三个:把“点了按钮”当成“结果正确”;为了降低误报而无限重试,最终把真故障拖成数分钟后的延迟告警;只在一个地域运行,却宣称全球用户旅程正常。每个告警都应保留失败步骤、截图或视频、总时间、会话 ID 和模型版本,同时对账号、地址和支付信息做脱敏处理。
这套方法适合视觉改动频繁、选择器维护成本高,且业务结果可以明确断言的流程。对于稳定 API、简单健康检查或每秒高频探测,传统脚本更快、更便宜、也更可预测。我的判断是, Agent 监控不会替代指标、日志和追踪,它更像是第四层证据:用户真的能完成任务。
要让告警真正可处置,每个关键步骤都要有独立的结果断言。搜索成功不是“输入框被点了”,而是页面出现了与关键字相关的结果;加购物车成功不是“按钮消失”,而是购物车数量、商品标识与价格一致;结账就绪也不是真正提交付款,而是到达一个明确的安全停止点。如果断言只是在复述 Agent 自己的动作说明,整个监控就会变成模型给自己打分。
为了区分产品故障和 Agent 抖动,可以为同一条旅程设置两类对照。一类是传统 API 或页面元素探针,用来证明后端基础能力;另一类是 Agent 旅程,用来证明真实交互。如果 API 正常而 Agent 失败,优先检查界面、模型或提示词;如果两者都失败,更可能是真实业务事故。这种对照能明显缩短排查路径。
告警策略也不是越灵敏越好。支付页面可以每五分钟检查一次,并在连续两次失败后告警;但一个每天才执行的报表流程,如果也按连续两次失败才告警,就意味着 24 小时的发现延迟。门槛要根据业务损失速度、模型单次失败概率和执行成本共同定义。对高价值旅程,可以在第一次失败后立即用另一个地域或不同测试账号复核,而不是无上限地原地重试。
成本同样不能只看 EventBridge 的调度费用。AWS 示例把定时调用、 Runtime 会话、 Browser 会话、 Nova Act 操作和通知分开估算。团队还应该计入每次旅程的平均步数、重试次数、多地域倍数、证据存储和人工处置成本。一个月运行数千次的任务,即使单次不贵,也可能在重试与视频证据上累积出不小的账单。
上线前最好做一次人为故障演练。例如临时隐藏购物车按钮、让价格接口返回错误币种、制造缓慢加载,然后检查 Agent 是否在正确步骤停止,告警是否附带足够证据,值班人员能否不登录生产账号就确认问题。如果 Agent 在首个关键断言失败后仍尝试继续结账,说明流程把“完成任务”错误地置于“可安全失败”之上。
还要定期复查监控自身的漂移。页面文案、商品数据和 Agent 模型都会更新,去年有效的断言今天可能已经过宽或过窄。团队应保存一小组已知成功与已知失败的录像,每次升级提示词、模型或浏览器镜像后先回放,确认告警敏感度没有发生静默变化。
你的线上监控能证明页面打开了,还是能证明用户真的完成了任务?
 发表于 2 小时前
|
查看: 5|
回复: 0


