接口都已经报错返回了,后台的 goroutine 却还在原地等着。
这类问题不一定马上把服务打挂。你可能先看到协程数量缓慢上涨,过一会儿内存也跟着涨;重启后恢复,跑一阵又回来。排查时只盯着接口耗时,很容易错过真正卡住的位置。
Go 官方最近的《Goroutine Leak Profiles》给了一个典型案例:多个 worker 向同一个 channel 发送结果,接收方遇到错误提前返回,剩下的发送方再也等不到接收。
return 只结束当前函数
假设一个接口并发查询三个上游,任意一个报错就结束。下面是问题核心,work 返回包含 err 的结果:
ch := make(chan result)
for i := 0; i < 3; i++ {
    go func(id int) {
        ch <- work(id)
    }(i)
}
for i := 0; i < 3; i++ {
    r := <-ch
    if r.err != nil {
        return r.err
    }
}
ch 没有缓冲。发送能完成的条件,是还有接收方愿意拿走结果。
第一个错误被接收后,主函数返回了;其他 worker 即使已经算完,仍可能停在 ch <- ...。请求结束,不会自动替你关闭所有子任务。
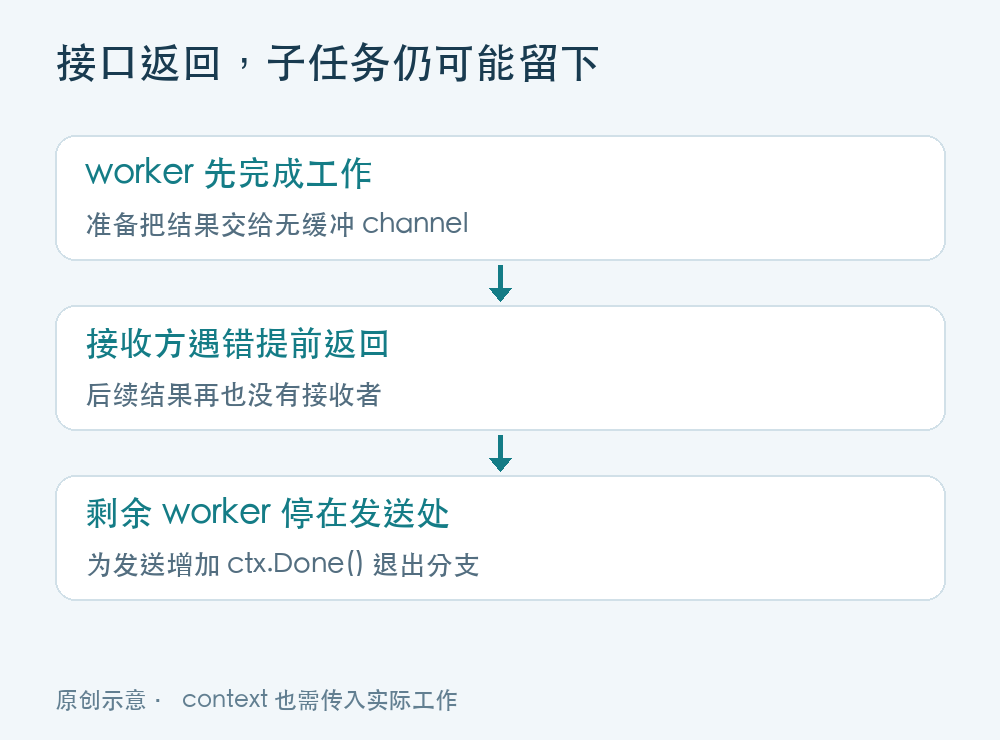
接收方退出后,发送方需要另一条退出路径。
这里也别急着 defer close(ch)。如果 worker 还在发送,关闭 channel 会导致 panic;关闭不是向所有生产者发送取消信号的通用替代品。
Go 1.27 多了一个排查入口
Go 1.27 正式提供 Goroutine 泄漏 profile。通过 runtime/pprof 可以采集;服务已接入 net/http/pprof 时,也有对应端点。
下面只在本机监听,便于开发环境排查:
import (
    "log"
    "net/http"
    _ "net/http/pprof"
)

// 放在 main 中启动
go func() {
    log.Println(http.ListenAndServe(
        "127.0.0.1:6060", nil,
    ))
}()
检查服务实际使用的 Go 版本,再采样:
curl -o leak.prof   http://127.0.0.1:6060/debug/pprof/goroutineleak
go tool pprof leak.prof
进入 pprof 后用 top 看主要位置,再用 list 定位相关函数。没有这个端点时,先确认编译服务的版本和是否注册了 pprof,不要直接归因于“没有泄漏”。诊断端点也不应直接暴露到公网。
这个工具有一个很重要的边界:它关注能证明永远无法解除的 channel、锁等阻塞。网络 I/O、系统调用,以及仍能从全局变量或运行中的 goroutine 访问到的同步对象,可能不在报告里。
所以,空报告不等于服务没有泄漏;goroutine 数量多,也不直接等于泄漏。还要结合负载变化、普通 goroutine 栈和重复采样判断。
它凭什么判断“再也等不到”?
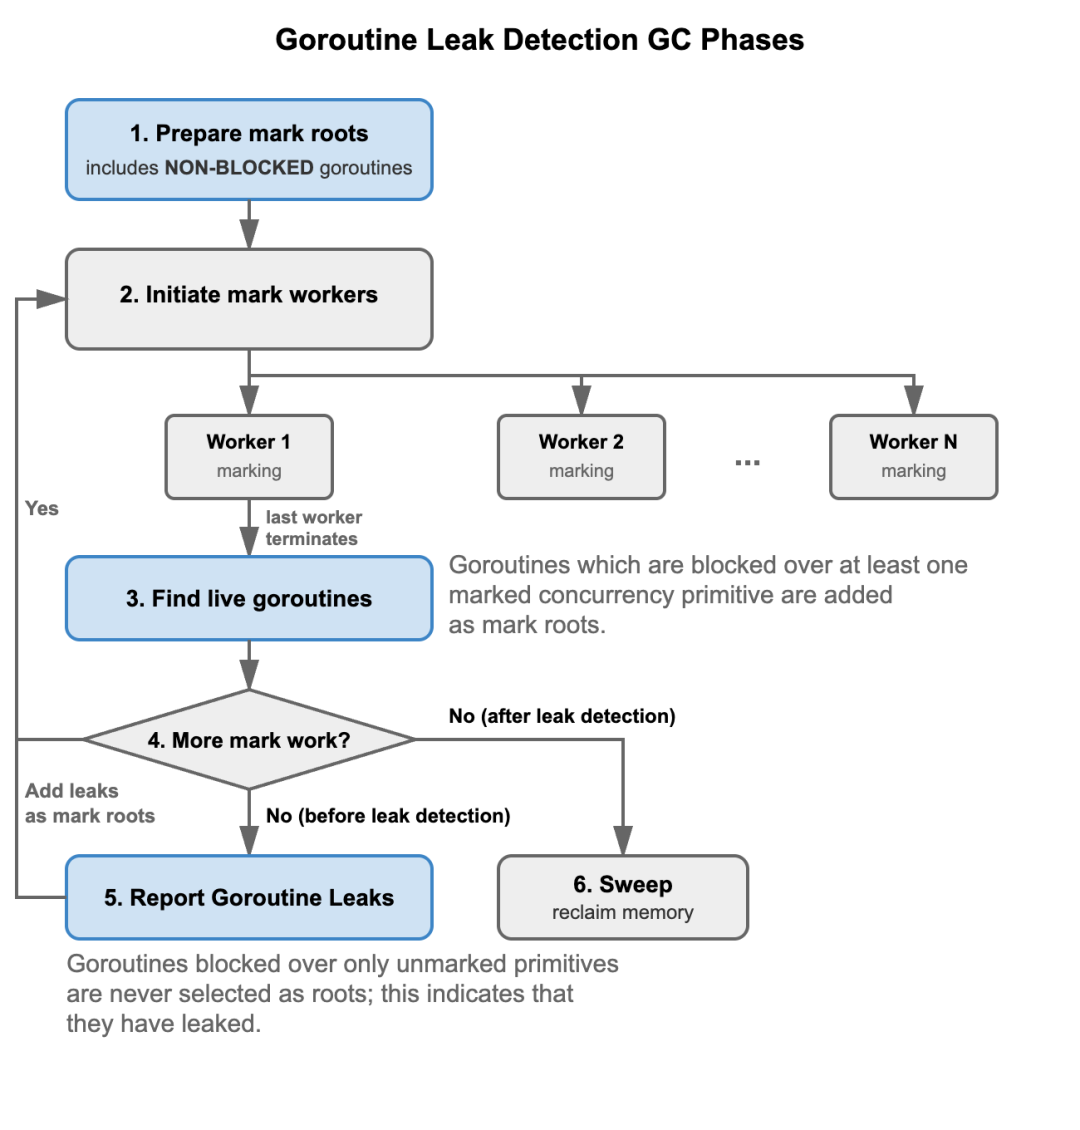
Go 官方原文:泄漏检测过程示意。
可以把这张图理解成一次“还有谁能唤醒谁”的检查:从未阻塞的 goroutine 等起点出发,标记仍可触及的对象;如果某个等待中的 goroutine 所依赖的同步对象仍可达,就继续把它纳入存活分析,直到没有新的变化。
最后无法被这一过程认定为存活的 goroutine,会被标记为泄漏。标记之后,运行时仍要保留相关内存,不能把“检测出来”理解为已经强制回收了 goroutine。
这也解释了前面的限制:某个 channel 即使业务上再也没人使用,只要它仍通过全局变量可达,分析就可能无法证明它永远不会再收到操作。工具输出的是特定条件下的证据,不是替你推断全部业务意图。
修复要照顾两个等待点
第一处是 worker 自己的工作,比如等待 HTTP 返回;第二处是工作结束后,等待把结果交出去。
给前者设置超时,却忘记后者,仍然可能卡住。发送也要能感知取消:
select {
case ch <- r:
case <-ctx.Done():
    return
}
下面是完整的收集函数。work(ctx, id) 必须遵守传入的 context,返回 result;完整可运行程序随素材包提供。
func collect(parent context.Context) error {
    ctx, cancel := context.WithCancel(parent)
    var wg sync.WaitGroup
    defer func() {
        cancel()
        wg.Wait()
    }()

    ch := make(chan result)
    for i := 0; i < 3; i++ {
        wg.Add(1)
        go func(id int) {
            defer wg.Done()
            r := work(ctx, id)
            select {
            case ch <- r:
            case <-ctx.Done():
            }
        }(i)
    }

    for i := 0; i < 3; i++ {
        select {
        case r := <-ch:
            if r.err != nil {
                return r.err
            }
        case <-ctx.Done():
            return ctx.Err()
        }
    }
    return nil
}
注意清理顺序:先取消,再等 worker 结束。这里用一个 defer 把顺序写明白,避免多个 defer 的后进先出让等待发生在取消之前。
这也不是强制杀死 goroutine。work 如果忽略 context、卡在不会结束的调用中,Wait 同样可能一直等。HTTP 请求要传入 context,数据库调用要用相应的 Context API,不能只在函数签名里加个参数。
加缓冲为什么有时也管用?
如果总共三个 worker、每个只发送一次,把缓冲设为 3,可以容纳所有结果,让发送者退出。这在边界明确的小任务里是有效方法。
但如果以后变成循环发送,或者 worker 自身还在跑耗时任务,缓冲只能解决有限次发送的等待,不能代替取消。
| 方案 |
能解决什么 |
| 足够大的缓冲 |
已知数量结果的发送阻塞 |
| context + select |
取消后退出等待发送 |
| 上游超时与取消 |
结束实际的网络或业务工作 |
用同一个错误场景回归
配套程序用三个 worker 模拟一次失败,分别跑有问题和修复后的版本。每种模式在独立进程执行 20 轮,记录 goroutine 变化,并保存文本 profile。
go run . -mode=leaky
go run . -mode=fixed
go test -race -v .
本地使用 Go 1.27.1(macOS ARM64)运行:问题版 20 轮后从 1 个 goroutine 增至 41 个,修复版仍为 1 个;竞态检查及两项退出测试通过。这是固定小样本的结果,不是线上压测。
本文只把这个小程序当排错练习。实际服务还要覆盖上游超时、客户端取消、正常完成和反复失败等路径,不能拿一次数量回落证明所有分支都安全。
如果你正在写调用 Claude、GPT 的后端,同样要处理上游请求的超时与取消。模型 API 接入服务可以了解 RouteFast;接入之后,请求生命周期仍由自己的服务负责。
你遇到过哪一种:接收方先走了、发送方堵住了,还是 cancel 调了,上游仍然不退出?这几类现象相似,修复位置却不一样。
参考:Vlad Saioc,Go 官方博客《Goroutine Leak Profiles》,及 Go 1.27 发布说明、context 文档。
 发表于 昨天 23:36
|
查看: 3|
回复: 0


