本文仅用于安全研究与学习交流,所有敏感信息均已脱敏,请勿将相关技术用于任何非法用途。
最近很多博主都在分享用 AI“秒”各种站点的经验,我自己也深度用 AI 做逆向有段时间了。不过这次想聊的不是传统逆向套路,而是 AI 辅助逆向的分析过程——主角是 Cursor + Claude Opus 4.6,受害者则是 hCaptcha。
先把目标地址贴出来(已脱敏编码):
aHR0cHM6Ly93d3cuaGNhcHRjaGEuY29tL3Bybw==
hCaptcha 的验证组件看起来人畜无害,一个复选框加一个“我是真实访客”,但背后的检测逻辑远比表面复杂。要把它的前端 HTML 文件改成下面这种结构,才能直接发包拿到明文结果:
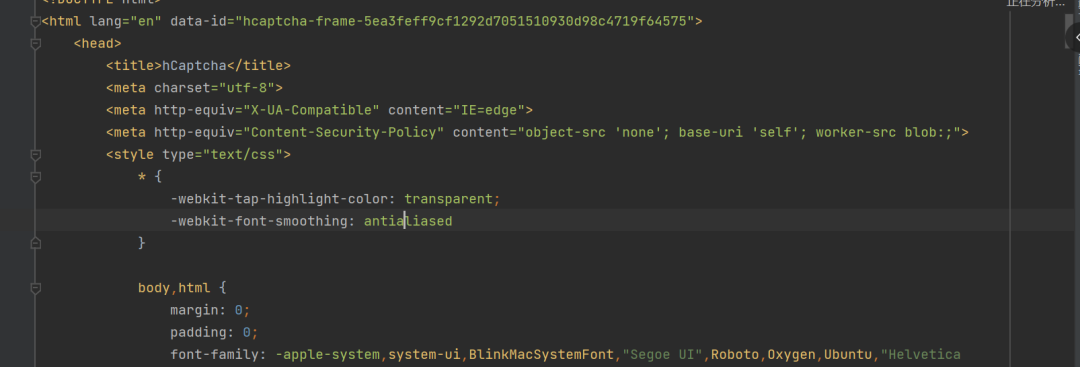
那么问题来了:怎么调教 AI 来完成这件事?关键不是一股脑把页面扔给模型,而是先明确目标,再拆解流程。你得清楚地告诉 AI 每一步要做什么,预期产出是什么,否则它很容易在复杂的验证逻辑里“跑偏”。
hCaptcha 到底检测哪些指纹?简单梳理一下:
- 常见对象与对象描述符的
toString 检测
- 堆栈报错检测
- 方法是否允许
new
canvas、webgl- 字体、音频、视频
worker、原型链- Node 环境特征
其中有一段核心逻辑涉及 ArrayBuffer 的处理,代码如下:
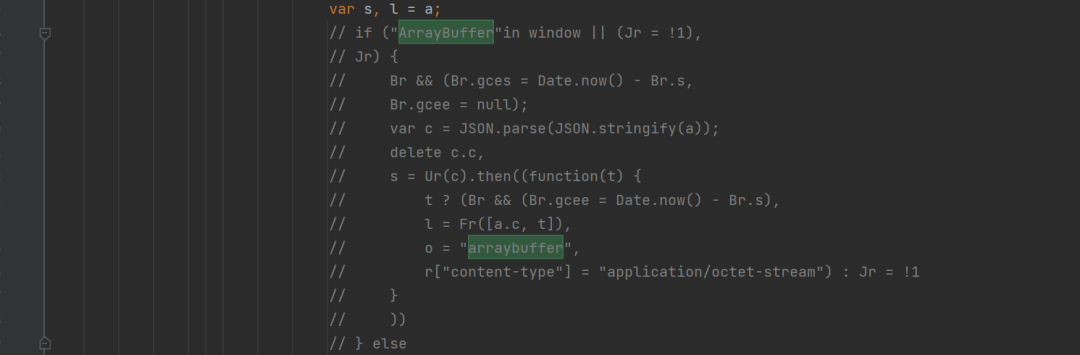
总体来看,生成值的长度达到 2.1W+ 就能通过前端校验。这个数字本身就是一个很好的“验收标准”——如果 AI 输出的结果长度不够,基本可以确定某个环节漏掉了。
那么问题又来了:AI 都这么强了,Web 逆向是不是走到头了?从目前的体验看,还真不是。AI 逆向仍然需要一定的逆向基础来兜底。它能快速给出方向、生成代码框架,但遇到上下文缺失或逻辑矛盾时,还是需要人来及时修正和指正。至少现阶段,想完全“放养”AI 去做逆向,不太现实。
最后附上成功执行的日志截图,可以看到 generated_pass_UUID 已经正常返回:
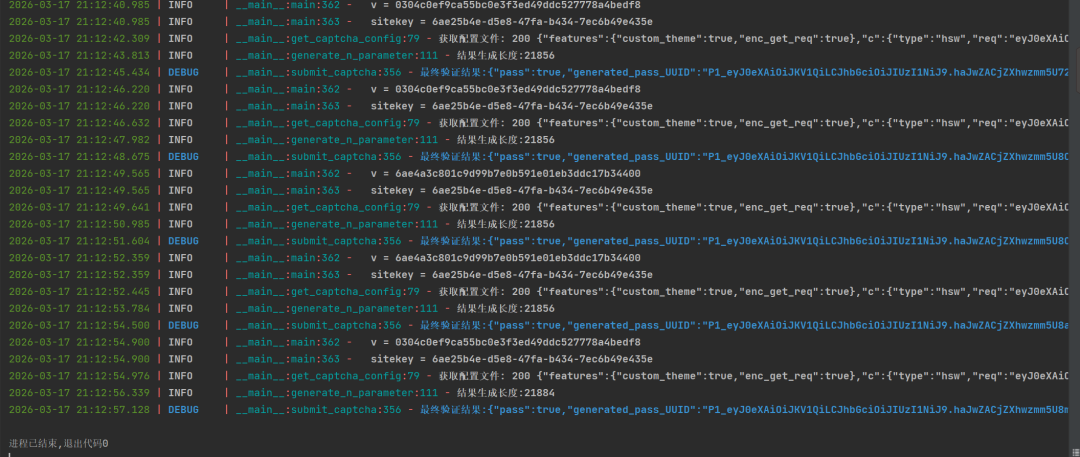
整体流程跑通之后,这套调教 AI 的方法论值得沉淀。指纹检测的每一条都可以作为独立的验证步骤拆解,当生成值长度达标且服务端校验通过,才算真正拿下。类似这种Web逆向的实操经验,云栈社区里也有不少讨论。如果你在调教 AI 做逆向时遇到什么坑,欢迎多交流。 |  发表于 4 天前
|
查看: 1|
回复: 0


