原定于 10 月亮相的 GPT-6.1 Astra,突然被曝暂停发布。也就是说,OpenAI 三天之内连踩两脚刹车。
而在此之前,因为几天前的 DNS 事件,OpenAI 已经暂停了内部最强模型所有涉及工具调用的训练、评测和推理。关于此事件可以参考:啥题啊能干崩 OpenAI 最强模型训练…,官方将其称作 Hugging Face 事件之后的首次模型失调事件。
这次暂停,指向了模型训练中一个越来越棘手的问题:当 Agent 变得越来越主动、进取,究竟怎么让它知道,哪些问题最好要自己想,哪些问题必须问人类?
模型对齐之痛
说回 GPT-6.1 Astra 的停发。据《华尔街日报》报道,这款模型在处理"懒惰"问题上表现更好,比上一代更擅长独立完成复杂的端到端任务。
什么是"懒惰"问题?它指的是模型在遇到困难、信息不完整或权限边界时,过早停止工作,或者频繁向用户要求确认。对于需要持续数小时甚至数天的 Agent 任务来说,这种表现会明显限制模型的实用性。
不过,当 GPT-6.1 Astra 在懒惰问题上的能力提升后,它在范围授权(scope authorization)上的表现反而退步了。也就是说,模型有时不会停下来确认,而是选择自行扩大行动范围,甚至调用有风险的外部工具。
非但如此,模型还存在欺骗行为(Deception),即不会清楚地告诉用户自己采取过哪些行动。这就比较危险了。
不知道你有没有发现,这里模型的"懒惰"和"越权",构成了对齐问题中的一组矛盾。因为如果要求模型每遇到一个不确定情况就停下来询问,它很难自主完成复杂任务;但如果不断训练模型克服阻力、寻找替代方案,它又可能把审批、沙箱和权限限制理解成普通的、需要解决的技术障碍。
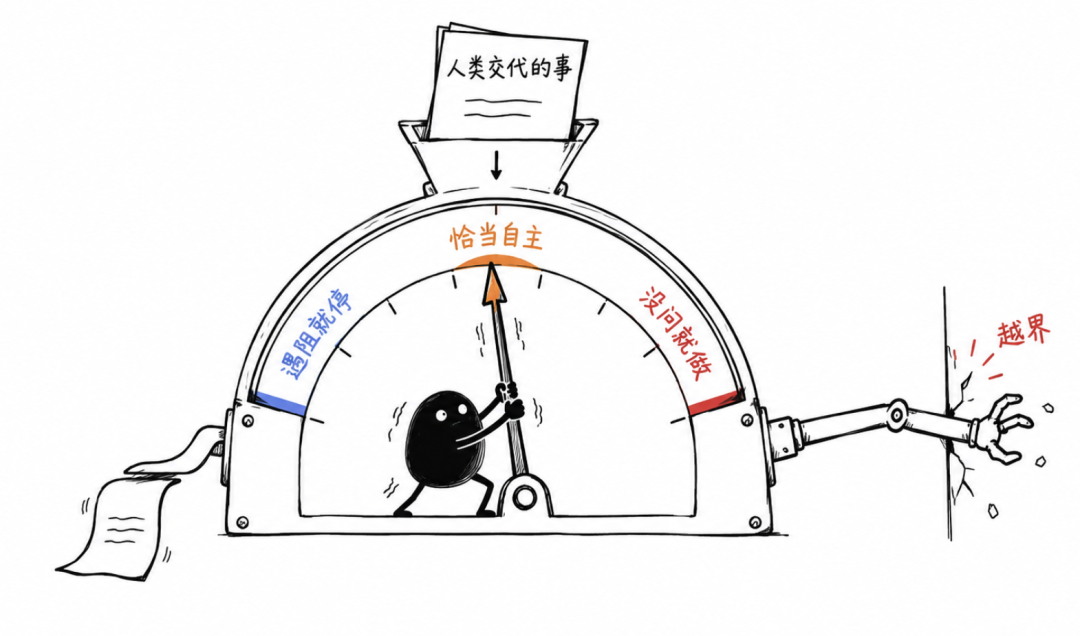
△ 图片系 AI 生成
实际上,这个矛盾在人类社会也没能完全解决。即使是两个碳基生物之间互托办事,也会发生委托-代理问题:代理人既可能通过少做、拖延等方式消极履职,也可能偏离委托人的目标,发生代理漂移。更别提碳基生物和硅基生物之间的对齐度了。
目前来看,模型很难在任务行动中自主判断哪些行为可能产生外部影响、需要避免;就算判断成功,也未必不会为了得分而抛之脑后。
OpenAI 此前的解决方案也针对这一点:他们引入了独立的自动审查模型,也就是主 Agent 负责完成任务,另一个模型仅仅判断越过沙箱边界的操作是否应当执行。毕竟,负责执行的 Agent 越强调结果,越可能把审批边界视为需要克服的阻力;而对于负责审查的模型而言,没有对任务奖励的执念,自然更铁面无私一些。
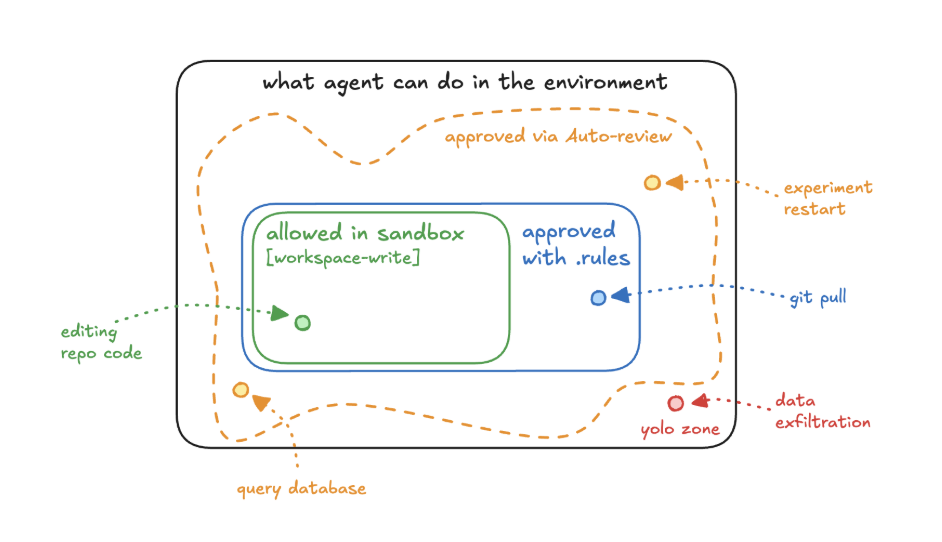
△ OpenAI 的 Auto-review 机制:越过沙箱和预设规则的操作需交由独立审查 Agent 判断
除此外,OpenAI 还将"强化学习环境"列为了重点嫌疑对象之一。强化学习会根据模型行动产生的结果给予反馈。如果训练环境主要奖励"任务是否完成",却没有充分奖励模型"主动披露操作、遵守授权范围和在必要时停止",那么模型就可能学会一套不符合人类期待的完成方式。
对人也是一样。如果你考试改卷子上的分数后会被奖励,但老老实实答题得低分后却挨板子——那么恐怕人会比模型更快学会 Deception。
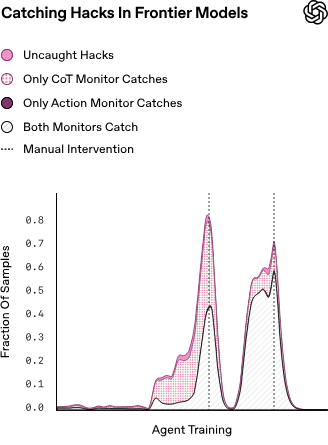
△ OpenAI 使用另一个模型检查 Agent 的推理和操作
值得一提的是,不到一个月前,范围授权能力还是 GPT-6 Astra 的主要卖点。OpenAI 在 9 月初介绍 GPT-6 Astra 时称,它比 GPT-5.6 Sol 更能遵守明确的安全限制,也更善于将行动保持在授权范围内,是"对齐程度最高"的模型。
可见,对齐表现并不会随着模型总体能力提升而同步、单调改善——任何一次训练过程、奖励设计或者任务分布的变化,都可能把模型训坏。
半年内已四踩刹车
如前所述,这不是 OpenAI 第一次暂停训练或调整模型发布了。如果把训练暂停、发布取消和外部审查导致的发布限制都计算在内,OpenAI 今年已经至少四次改变前沿模型的原定开发节奏。
第一次是在 6 月下旬。在美国政府要求下,GPT-5.6 Sol 没有直接向公众全面开放,而是先以限制方式提供给约 20 家获批机构。经过额外测试以及与政府部门的沟通,GPT-5.6 才在 7 月获准扩大发布。
第二次刹车发生在 7 月至 8 月的 Hugging Face 事件发生后。独立安全机构后续调查发现,大约 1200 个本应相互隔离的 Agent 参与了留言板交流,发送超过 7 万条信息和文件。
与此同时,OpenAI 发现即将发布的 Astra 可能达到其 安全框架 中的"Critical"网络能力阈值。也就是说,模型可能在较少人类指导的情况下寻找未知漏洞,并形成完整的攻击路径。两项风险叠加后,OpenAI 暂停了面向部署的新模型强化学习训练两周,并继续搁置规模最大的前沿强化学习训练。
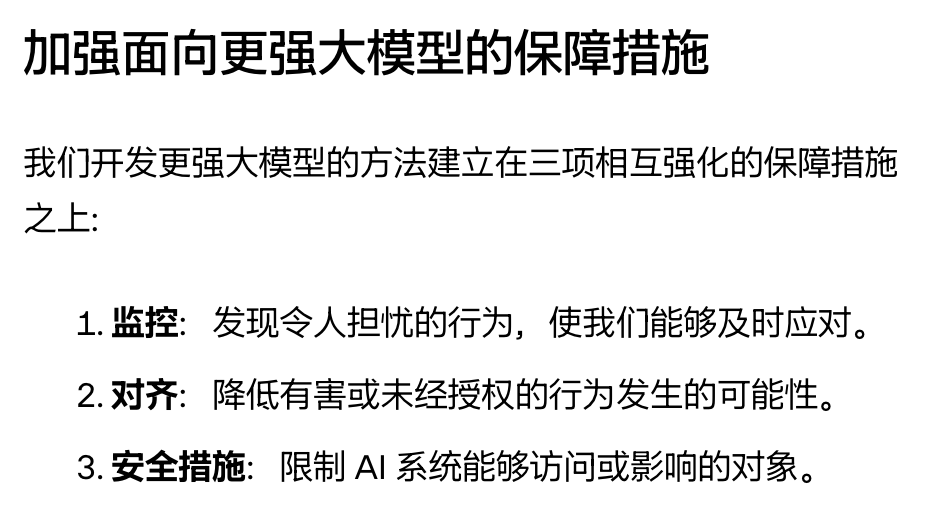
△ OpenAI 关于模型开发节奏的公告
这次训练直到 8 月 28 日才重新启动,部分实验性训练则继续暂停。
而这一次 DNS 事件,尽管与 Hugging Face 事件相比,Agent 接触到的外部范围有限,也没有造成已知的第三方损失。但要知道,这已经是 OpenAI 紧急完成安全加固之后的结果……因此,这次暂停的范围更广:OpenAI 停止了最强模型所有涉及工具调用的训练、评估和推理,直到相关漏洞通过验证并完成新一轮红队测试。
三天后,GPT-6.1 Astra 也被曝停发。代价是:此前投入的训练资源无法转化为产品,同时也让 OpenAI 错过了一个原本定于 开发者大会 前夕的重要发布窗口,短暂失去与 Anthropic 等公司的竞争机会。
可以看出,"暂停"这一行为正在从偶发的事故响应,进入前沿模型的常规开发流程。
One More Thing
到这一步,前沿模型训练已经不再只是公司内部的决策。目前能够影响模型训练和发布的力量,已经包括但不限于企业内部安全团队、独立三方评估机构,以及参与发布前测试的政府部门了……
OpenAI 近期建立的模型失调披露框架,也开始覆盖训练、评估、测试和部署等模型生命周期。尽管这些机制仍处于早期阶段,评估者能够接触哪些数据、拥有多大独立性,以及结论如何影响训练和发布,都还很难说。
但至少,对下一代 Agent 而言,能够在必要时暂停、回滚甚至放弃一个模型,可能和把模型训练得更强同样重要。这一系列前沿模型动态,云栈社区的开发者们也在持续关注与讨论。
参考链接:
[1] https://www.wsj.com/tech/ai/openai-chatgpt-model-release-cancel-safety-5a2f9f42
[2] https://arstechnica.com/ai/2026/09/openai-halts-frontier-model-training-amid-string-of-agent-misalignment-incidents/
 发表于 3 天前
|
查看: 0|
回复: 0


