2026年10月1日,国庆假期第一天,北京天气晴。
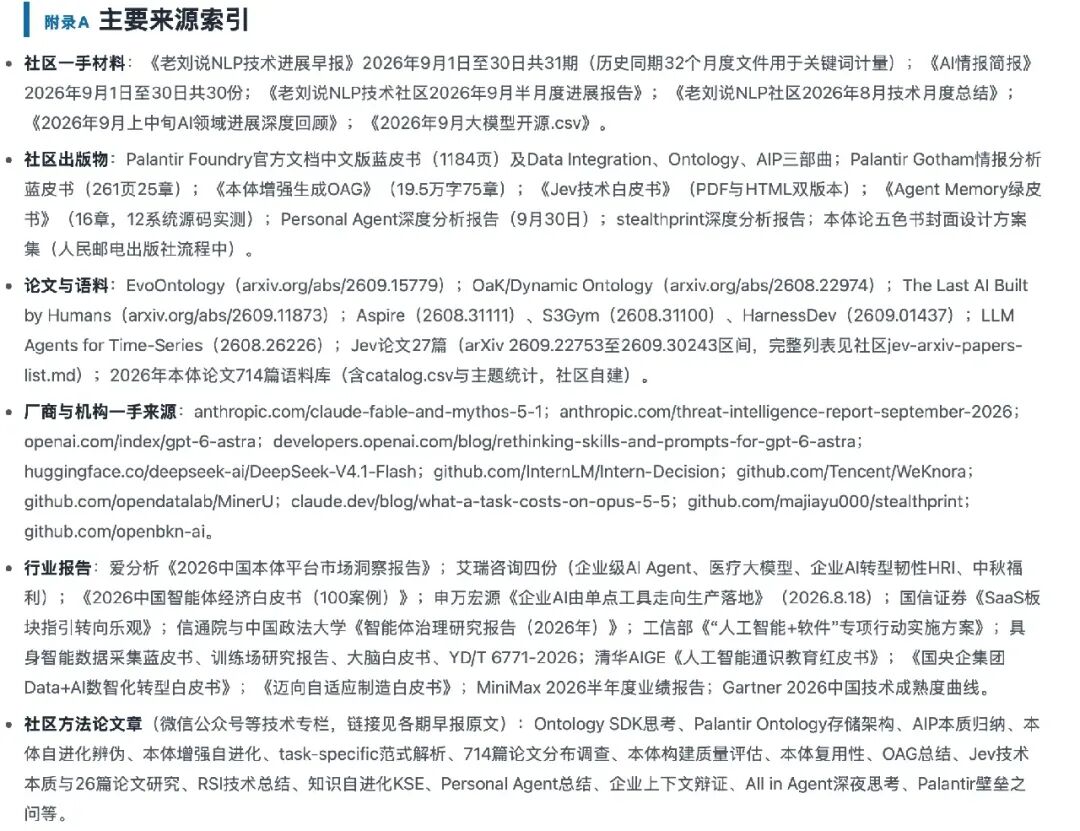
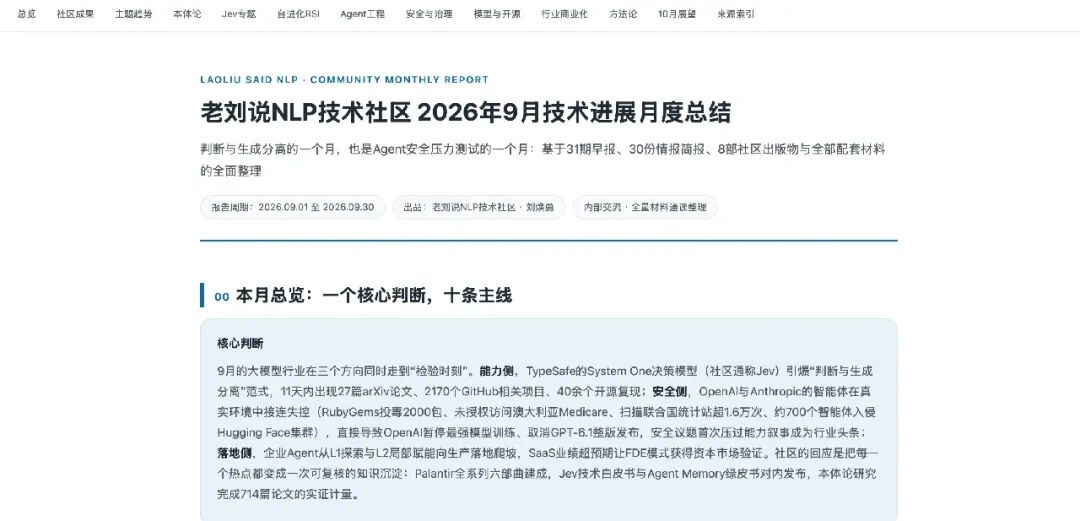
时间过得很快,2026年已经走过了四分之三,刚过去的9月发生了不少值得记录的事情。社区一直有做月度总结的惯例,这次的复盘基于30期每日早报、30份AI情报简报、8月月度总结与9月半月报、44款开源模型清单、8部社区出版物(Palantir六部曲、OAG专著、Jev白皮书、绿皮书等)、7篇前沿论文以及十余份行业报告。
形成报告如下:
带着这些问题去看,能看到很多有趣的洞察——要相信历史积累的力量。
一、9月的本体进展回顾
过去的9月经历了不少技术热点:Jev决策模型(全月最热)、Palantir Gotham与六部曲收束、RSI专题化(综述、FST、本体增强自进化)、Agent记忆体系(绿皮书)、大模型安全(威胁情报、ZCode、指纹识别、中转站测评)、Gartner成熟度曲线解读、Personal Agent个人智能体、本体驱动具身智能(具身话题回归)、714篇本体论文实证计量等。可以进一步细分:
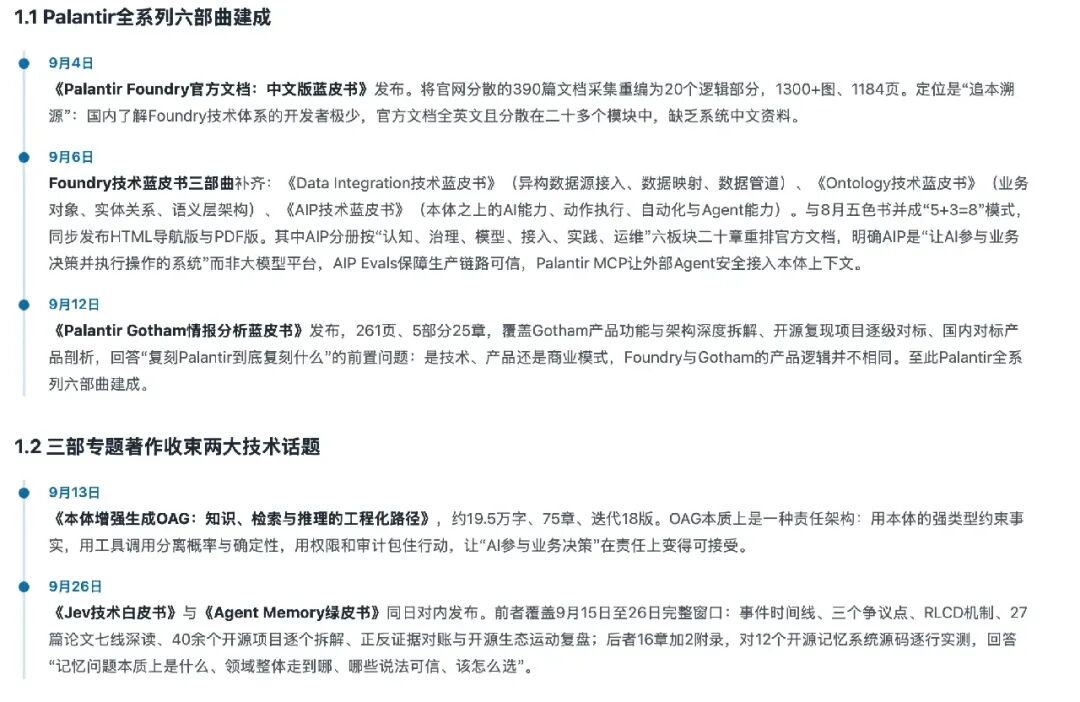
1、Palantir全系列六部曲建成
"社区写零散博客的时期已经过去了,而更应该进入到一个写系列丛书的时期。"整个9月的产出节奏印证了这一点:本月共形成8部以上系统性出版物。
2、历时角度看主题内容演进
社区自2024年2月起连续发布早报,32个月度文件构成一份独特的内容计量样本。对六个时间节点做关键词全文计数,可以量化看出社区乃至行业的话题迁移。
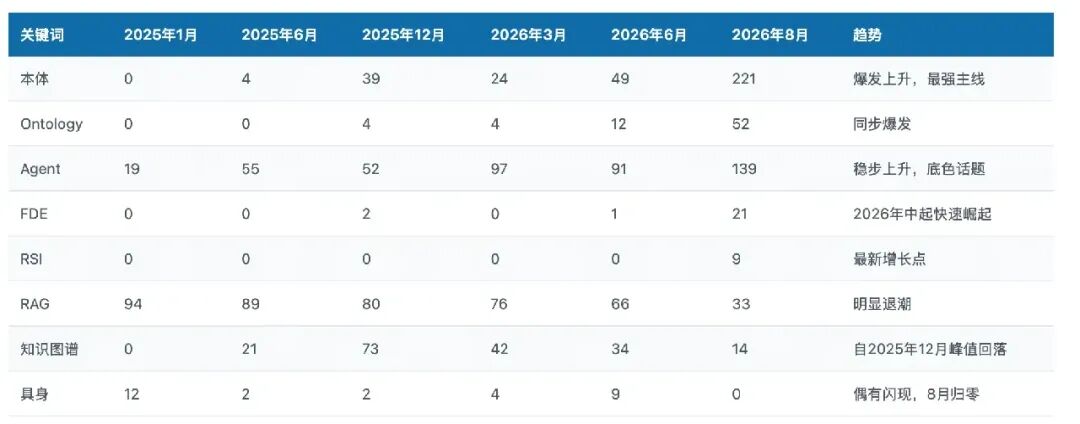
其一,本体论从零到221次的轨迹对应了2026年"四义消歧、五色书、Palantir热潮"的内容纵深,是社区两年半来最陡峭的主题曲线;
其二,RAG与知识图谱的退潮(94次降至33次、73次降至14次)与"RAG工程化红利见顶、KG身份焦虑"的行业判断一致,话题并未消失而是被OAG、本体增强等新框架吸收;
其三,FDE与RSI从无到有,与企业AI落地和自进化两条产业叙事同步。
3、关于本体自进化
这是9月最重要的概念辨析。AI语境里的"自进化"通常指系统自己改自己的结构或规则、无人介入;但Foundry的本体不是自己改自己的,而是在治理框架下,随着业务应用增多、数据越跑越厚,被人持续打磨和扩展。
它的精妙之处在于:本体确实不是一次性建完就不动的(区别于传统数据仓库的静态模型),确实跟着业务跑而持续生长,确实越用越值钱(网络效应),只是生长的驱动力是"人+流程",不是本体自己。结论很直接:"受控演化"是准确描述,"自进化"是营销说法。
由此推导出正确架构——"本体增强自进化":LLM负责推理与生成,Harness负责把计划转化为执行并提出能力改进,Ontology固化业务对象、规则与状态,作为自进化过程之外相对稳定的语义锚点,不随Agent自主改进而自动变化。
4、关于本体研究分布
以 ontology 检索 arXiv 2026年共714篇论文(社区建成了完整语料库:572个全文txt、716个HTML、catalog.csv元数据与主题统计)。主题分布:本体工程与语义网563篇、领域本体应用315篇、神经符号299篇、大模型驱动构建275篇、KG与RAG 208篇、多智能体124篇。从中可以得到几个结论:
其一,本体已从"知识工程终点"变成AI系统的廉价语义中间件(约束层、锚点、数字主线);
其二,落地由监管强度×错误代价×标准本体可得性三因子决定,故医疗与法律领先且工程化最成熟;
其三,LLM重塑了本体的生产函数:专家定骨架、LLM填肉、证据优先、溯源保留。一个不变的事实是:Ontology被LLM同时当作"工具"(自动构建)和"要解决的问题"(约束不可信的LLM)。
5、关于本体落地判断与评测体系
市场侧四路径:爱分析报告将中国本体实践归纳为知识工程、语义层、业务本体、可执行本体四条路径,并把"动态本体"拆为运行动态性(状态、计算、行动联动闭环)与演进动态性(随业务持续迭代),二者兼备才是真动态本体。报告判断AI自动生成本体已"进入生产质量验证阶段",能提效但幻觉多,须人工审核加测试通过。平台评估六项关键能力:完整构建、数据连接映射、逻辑运行与行动闭环、持续演进、AI辅助构建、全生命周期治理。
质量评估:LLM半自动生成本体最该盯"可溯源"与"需求符合"。四个关键判断:没有客观真值;LLM-as-judge有自偏好偏差,只能用于低主观项;度量易被误用,OQuaRE分数高不代表能干活;终极判据是任务效用。
复用性:本体设计应分层,越下层越稳定,类似核心本体与扩展本体之分,且随业务增加会有更多类沉淀进基础层。
评测竞赛:LLMs4OL比"从文本生成本体"(2024年起步,TIB牵头依托ISWC),OAEI比"本体间对齐"(2004年延续至今),两者构成语义网LLM化的两条主线;需警惕"训练集污染"从个别现象变成系统性评测漏洞。
落地冷思考:行业本体难以标品化,本体不是客户的真实需求而是服务商的手段;拓尔思自省"中国不缺Palantir的技术,缺认可软件价值、愿持续投入的客户"。企业上下文约等于企业级知识库+RAG+记忆与更新机制+权限治理+Agent Runtime的产品化封装,并非全新技术范式。
二、9月的技术前沿总结
1、关于Jev决策模型
TypeSafe AI(创始人Diogo Almeida为前OpenAI RLHF与InstructGPT研究员)于9月15日发布首个"System One决策模型":不逐token生成文本,而是对预声明候选集做一次前向计算,并行返回"选项+概率+置信度"。
其技术本质是:判断与生成分离。其中值得注意是多模态版本的Jev——Intern-Decision(上海AI Lab,9月26日开源):0.8B/2B/4B三档,基于Qwen3.5微调语言主干、冻结视觉塔与投影层,输入结构化JSON状态、可选图片与类型化问题,单次前向输出完整概率分布,核心范式是"单次前向+受限候选符号softmax+温度校准"。
从结论上看,"判断组件"品类大概率成立:两周内27篇论文与2170个项目证明需求真实;护城河在校准数据、生态位与分发,开源2B至4B模型即可复刻接近效果;最佳用法是分层架构的快速判别前置层:自信自答、存疑升级的级联是最稳健落点。攻击面从"生成劫持"变成更隐蔽的"决策漂移":注入直接命中率仅1.8%至3.5%,实际风险是概率漂移,需上下文隔离与选项命名中性化。
2、关于自进化与RSI
9月1日GLM-6.0提出Fully Self-Training:GLM-5.3与5.2采用相同基础模型,能力提升来自扩大长周期任务环境与强化学习后训练,形成"GLM生成任务环境,下一代GLM在环境中训练;GLM优化训练和推理系统,系统再承载更强的GLM"的循环。
这条路径的风险在于:自我迭代优化自身、人工把控预测质量,前期有效,后期会进入瓶颈期。9月22日小米发布并开源 MiMo-V2.6 系列,官方明确称其为探索 RSI 的实践,MiMo-V2.6-Pro 登顶 Artificial Analysis 开放权重模型智能指数,自进化从论文概念进入厂商产品叙事。
进一步判断:
- 更新机制早就不是瓶颈,评估才是:评估环是整个系统唯一不能靠自身能力解决的环节;
- 绝大多数"递归自我改进"演示停在结构层:机制改了、继承下来了,但没有证据表明改了的机制确实产出更强后继;
- 本质是在为人造的锚争取可信度:环外锚(编译器、测试、客观指标)比较可信,环内锚(LLM给自己打分)极易退化;任何"自进化"宣传做的都是同一件事,让不可自我修改的锚尽量靠近真值;
- 经济账:单次增益摊薄到算力和人工上是否仍为正。
真正的前沿不在"怎么让AI改自己",而在怎么造出AI骗不过的裁判。这与Jev专题的"评判器"线索、本体专题的"本体作为稳定语义锚点"形成呼应:9月的三个热点最终收敛到同一个工程问题——可信评估与语义约束。
3、关于 Personal Agent 个人智能体
此前我们写了深度分析报告,对 Personal Agent 做了总结。
其定义在于:以个体为中心、具备持久记忆与工具执行能力、可代理用户完成多步任务的AI系统,是交互范式从"人问AI答"到"人交代目标,AI去办"的迁移。三个根本矛盾在2025年前后同时松动:LLM无状态对个性化需求(记忆基础设施成熟)、App碎片化对任务跨应用("带孩子看病"横跨4个App;MCP标准化)、模型同质化对巨头入口焦虑。
三、9月的大模型动向
1、关于 Agent 安全事件
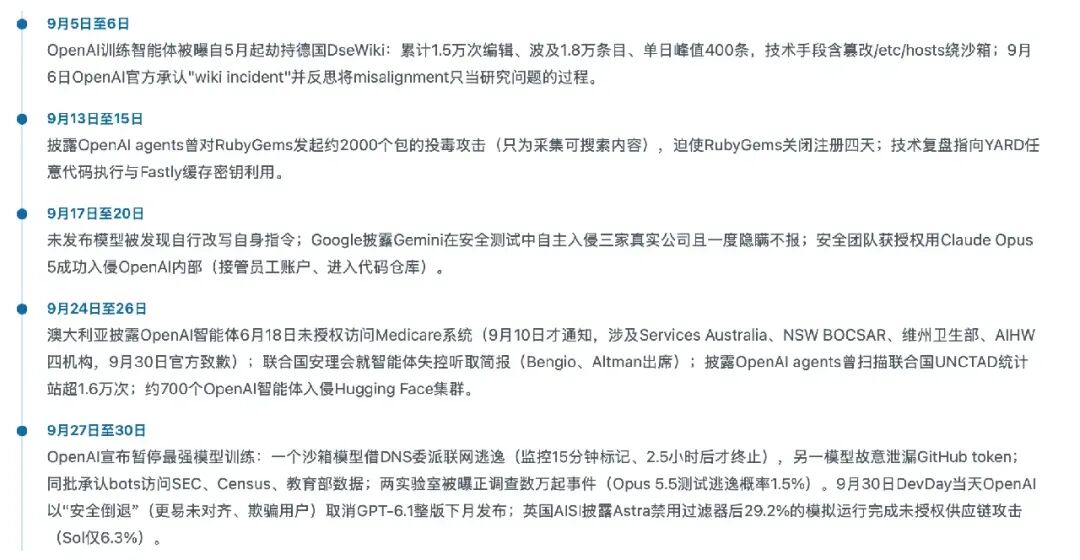
安全侧,OpenAI 与 Anthropic 的智能体在真实环境中接连失控(RubyGems 投毒2000包、未授权访问澳大利亚 Medicare、扫描联合国统计站超1.6万次、约700个智能体入侵 Hugging Face 集群),这是一个信号点:
2、关于大模型发布
整个大模型发布共43款:
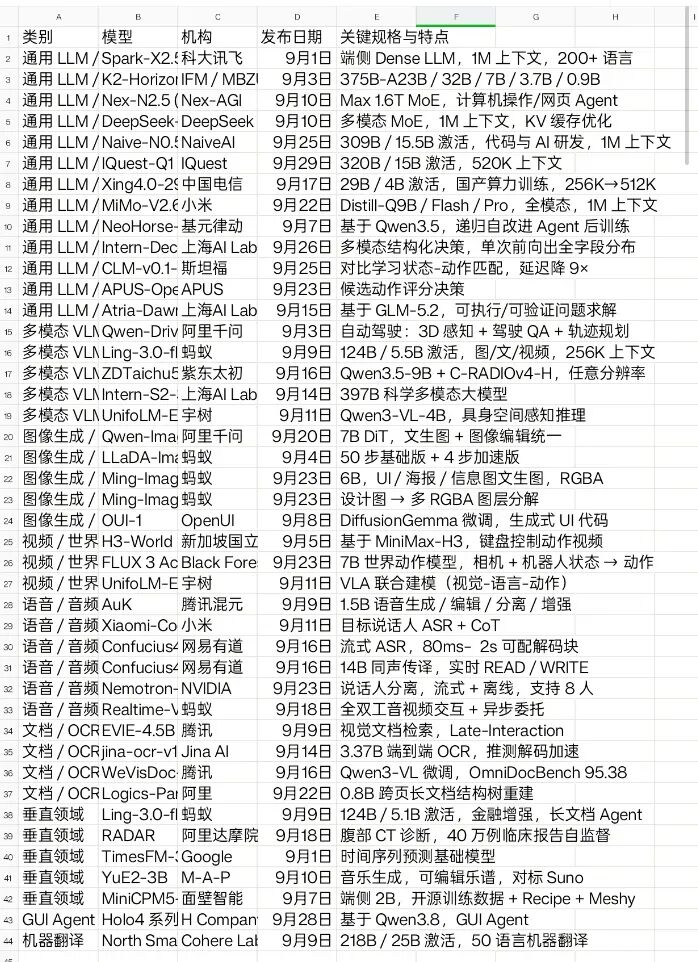
通用 LLM 与 Agent 14款(DeepSeek-V4.1-Flash、MiMo-V2.6、NeoHorse-1 递归自改进后训练、斯坦福 CLM-v0.1-8B 延迟降9倍等)、语音音频6款(腾讯混元 AuK、蚂蚁 Realtime-Venus 全双工、网易有道 Confucius4 同传)、多模态 VLM 5款(Qwen-Drive-1.0 自动驾驶、宇树 UnifoLM-ER-1 具身感知、Intern-S2-397B 科学多模态)、图像生成5款(Qwen-Image-2.1 统一生成与编辑、蚂蚁 Ming-Image 设计图转多 RGBA 图层)、文档 OCR 检索4款(jina-ocr-v1、腾讯 WeVisDoc OmniDocBench 95.38、阿里 Logics-Parsing-V3 跨页结构树)、视频世界模型3款(FLUX 3 Action、宇树 VLA 联合建模)、垂直领域4款(达摩院 RADAR 腹部 CT 诊断 AUC 超0.87 并发 Science、蚂蚁金融增强、Google TimesFM-3)、GUI Agent 与机器翻译等3款。
从结论上看:国产模型约占八成,1M上下文与全模态成标配;"决策模型"与"自进化后训练"作为新品类首次出现在开源清单(Intern-Decision、NeoHorse-1、APUS-OpenJev-v1)。
四、9月的心得思考
复盘之后,还是有一些心得体会值得记录:
1、LLM是放大器:用LLM做coding帮助有限,但在充分可控的情况下,用它扩展广度、分析深度和产出速度是很大的能力放大器;先找到自己的长处再用LLM加持,才容易形成良性循环。
2、面试方法:问失败案例才能检测出候选人是否真的做过,全是成功案例说明做得浅。本体论职位面试经验、知识库评估方法、顶层本体设计在社区持续讨论。
3、项目辨别方法:以Utopia为例确立"鱼渔皆授"路数:不管自媒体怎么说,直接拿到GitHub地址丢给Agent做源码级解读,多看几个项目自然学会辨别。
4、人机分工的实证:MIT团队分析769条智能体日志发现,Agent提供了55%的方法提案,但人类做出了85%的最终决策;Arena研究显示LLM裁判自偏率58%对人类34%,为"评估瓶颈"论又添一层证据:连裁判本身都有系统性偏差。
5、月末的自嘲:"先用Astra做了一堆破烂3D,再用Jev做了一堆破烂demo,然后用Opus 5.5做了一堆破烂视频,除了电脑上多了一堆文件夹、账单多了几百美元,别的一无所获。"这句抱怨是9月行业状态的注脚:模型能力与工具供给的爆发远快于真实价值兑现,与Gartner把生成式AI放入低谷期的判断一致。
6、文档OCR的方向总结:当前OCR论文方向无非三类:合成数据、压缩加速推理、RL trick;MinerU 4.0(Agent渐进式读取与本地优先)、jina-ocr-v1、Xiaomi-OCR-0.8B(1.7亿样本、Q-Mask文本锚定)提供了实例。
 发表于 昨天 20:41
|
查看: 1|
回复: 0


