一颗芯片只有一面,这件事持续了六十年。
晶体管做在硅片上,上面一层层堆金属线。信号在金属线里跑,电也从金属线里下来。这套结构叫后端互连,先进节点上能堆到十五层到二十层。这么多年没人觉得有什么问题,因为金属层一直够用。
到 2nm 附近,不够用了。行业开始动一件事:把整个供电网络从晶圆正面搬到背面去。
这不是一次工艺优化,是芯片形态的变化。六十年里,芯片第一次有了两面。
电和信号,在抢同一块地
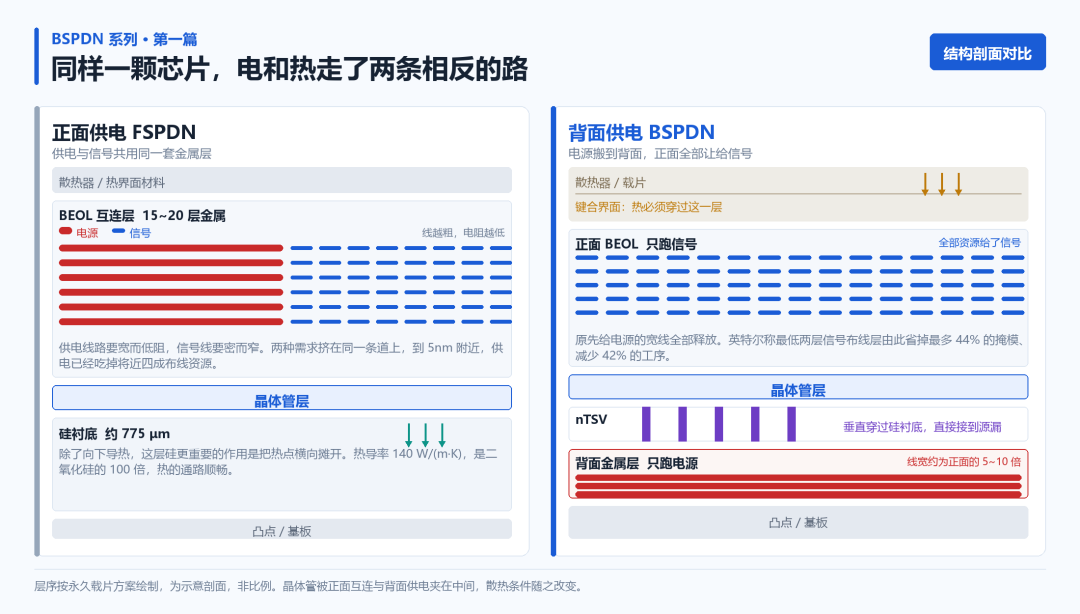
正面那些金属层要同时干两件事:送电,传信号。而这两件事对线宽的要求正好相反。
送电要的是又宽又厚。线越宽,电阻越低,同样电流下压降越小,送到晶体管那一端的电压才稳,芯片才能跑在设计频率上。传信号要的是又密又窄,同样一块面积里塞进更多走线,单位面积才能堆下更多逻辑。
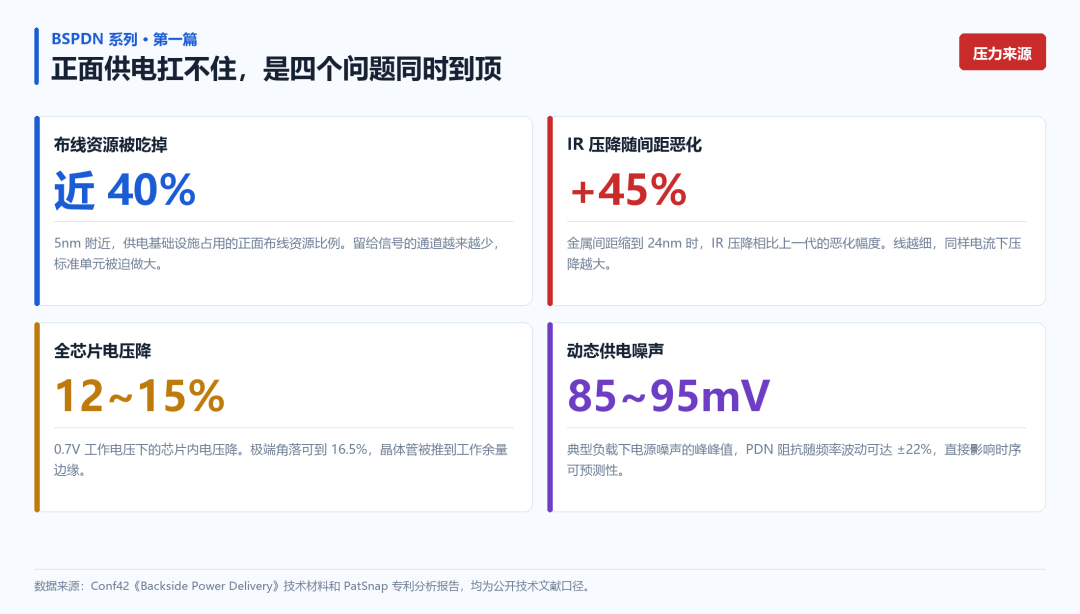
一条道上跑两种需求,挤到先进节点就出事了。5nm 附近,供电基础设施已经占掉接近四成正面布线资源。剩下的通道要装下全部信号,标准单元只能做大,密度红利被白白吃掉一块。
压降问题同时恶化。金属间距缩到 24nm 这一档,IR 压降比上一代要涨 45%。道理很直白,线细了,同样电流下压降就大。在 0.7V 这样的低工作电压下,芯片内部电压降能到 12% 到 15%,最差的角落能到 16.5%。晶体管的性能余量本来就不宽,压降吃掉一截,频率就上不去。
还有一层麻烦是噪声。动态负载下电源噪声的峰峰值落在 85mV 到 95mV 之间,供电网络的阻抗随频率波动,最大能偏 22%。时序分析依赖一个前提,就是电压是定值。这个前提在高负载场景下越来越站不住。
这些问题不是谁做错了什么,是正面布线这条路径本身走到了尽头。
把供电整个搬到背面
背面供电(Backside Power Delivery Network,BSPDN)的思路,字面上就是把电源网络从晶圆正面挪到背面,让正面腾出来专门跑信号。
听起来像搬家。实际上是把整条工艺链重排一遍,每一步都在跟物理极限较劲。
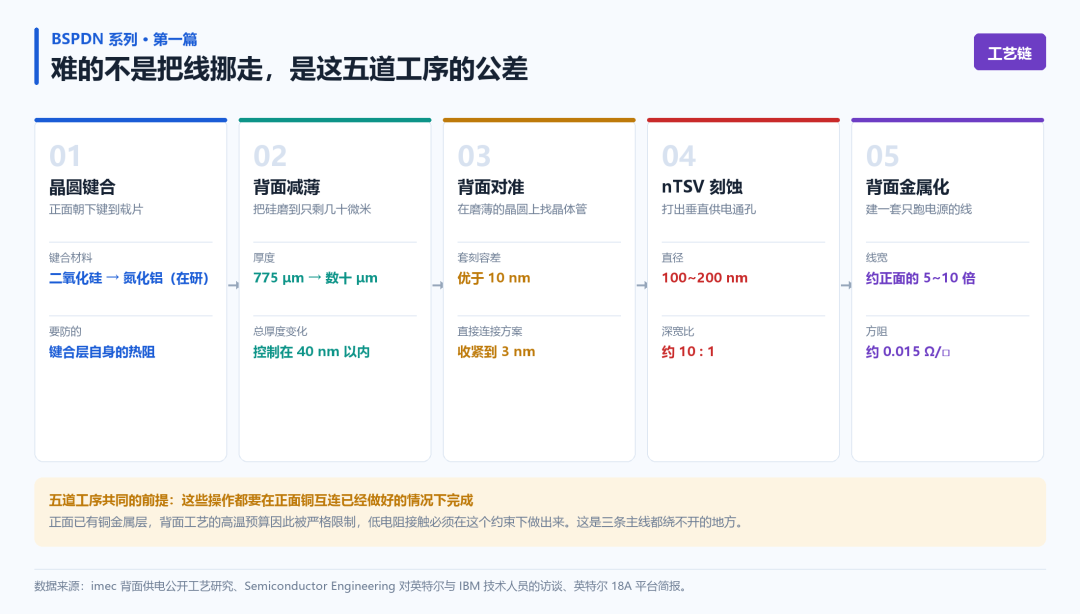
第一件事是键合。正面做完之后,晶圆要正面朝下贴到一片载片上,之后才有资格谈背面。
载片贴好,才能动硅。要把晶圆从 775 微米磨到只剩几十微米,imec 的实验把总厚度变化压到 40 纳米以内。这个数字值得多想一下:整片 300 毫米晶圆上,任意两点的高度差不能超过几十个原子层。磨到这个程度晶圆会翘,边缘最明显,而后面还要在它上面做光刻。
光刻才是真正卡人的地方。要在磨薄的背面找回正面晶体管的位置,套刻精度得优于 10 纳米。硅对红外线半透明,光刻机可以拿红外光去照背面的金属对准标记,问题是键合本身会让晶圆产生形变,常规的对准机制补偿不了这种畸变。业界的做法是改进晶圆对晶圆键合的精度,再叠一层高级光刻修正,代价是逐芯补偿在大规模量产里很耗时间。正在研究的直接连接方案,把公差进一步收到 3 纳米。这个量级意味着对准误差要控制在十几个硅原子以内。
对准之后才轮到打孔。nTSV,纳米硅通孔,直径 100 到 200 纳米,深宽比大约 10:1,垂直穿过硅衬底,直接接到晶体管的源极和漏极。孔要打得直,孔壁要干净,还不能伤到旁边的器件。
背面那套金属网络反而是整条链里最舒坦的一步。它不用再跟信号抢道,线宽可以做到正面的 5 到 10 倍,方阻约 0.015 欧姆每方。线宽上去了,电阻和压降自己就下来了。
整条链上有个共同前提容易被忽略:这些操作全都要在正面铜互连已经做好的情况下完成。铜经不起高温,背面工艺的热预算因此被严格限制,低电阻接触得在这个约束里做出来。
收益要一组一组地对
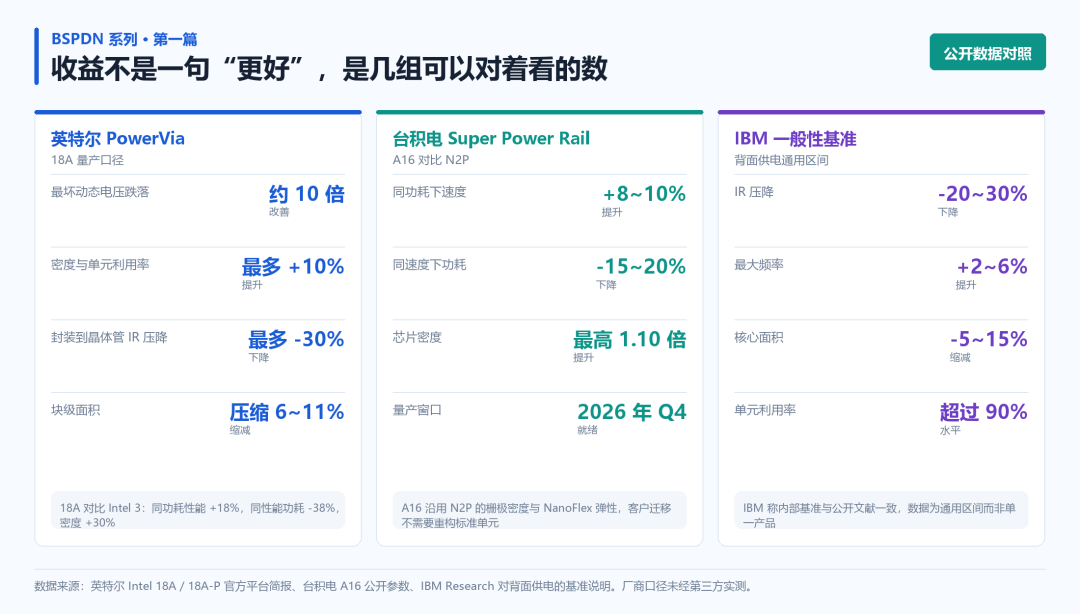
背面供电的收益不是一句"更好",是几组可以对着看的数。要说清楚的是,下面这些基本都是厂商自己披露的口径,没有第三方实测。
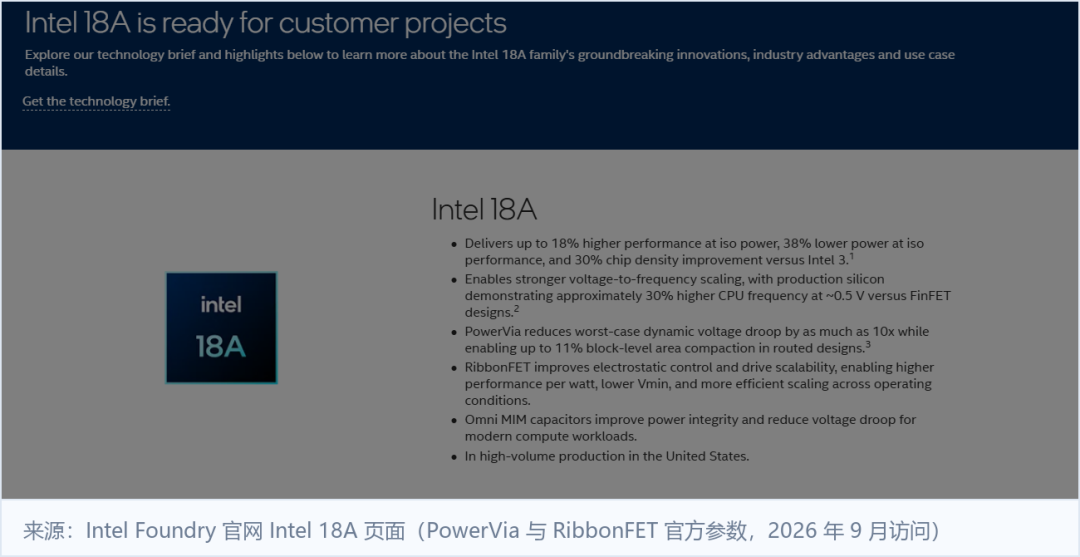
英特尔最早把它做进量产。PowerVia 随 18A 落地,官方给的数是最坏情况动态电压跌落改善约 10 倍,密度和单元利用率最多提升 10%,从封装到晶体管的 IR 压降最多降低 30%,块级面积压缩 6% 到 11%。换成跟自家上一代比,18A 对 Intel 3 同功耗下性能提升 18%,同性能下功耗降低 38%,密度提升 30%。这组数里有晶体管和供电两份贡献,不能全记在背面供电头上。
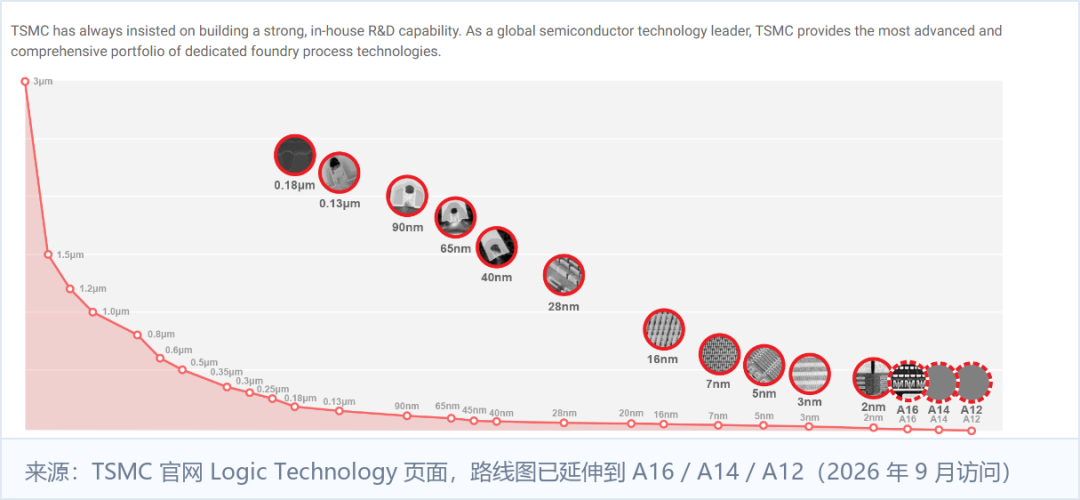
台积电的落在 A16 上,对比 2nm 增强版 N2P:同等功耗下速度提升 8% 到 10%,同等速度下功耗降低 15% 到 20%,芯片密度最高到 1.10 倍。三项同步改善,这在工艺升级里其实不常见,通常的做法是拿速度换功耗、再拿功耗换密度。台积电自己把 A16 定位成给 AI 和高性能计算用的平台,不是给手机用的。
IBM 给的是通用区间,IR 压降降低 20% 到 30%,最大频率提升 2% 到 6%,核心面积缩减 5% 到 15%,单元利用率超过 90%。IBM 说这组数跟自己内部的基准测试对得上,可以当作一个相对中性的参照,注意它跟厂商产品级的数字不是一回事。
这几组放在一起看,我最在意的其实是另一个数:供电从正面移走后,芯片需要的金属层数从原来的 10 到 12 层降到 7 到 8 层。层数少意味着掩模少,英特尔在最低两层信号布线层上改成单次直接打印的极紫外光刻,掩模数减少最多 44%,工序减少最多 42%。省下来的光刻成本,正好抵掉新增背面金属层的开销。英特尔负责互连技术的 Kevin Fischer 说过一句话,背面供电在成本上不是纯加法,指的就是这个。
散热这笔账要重算
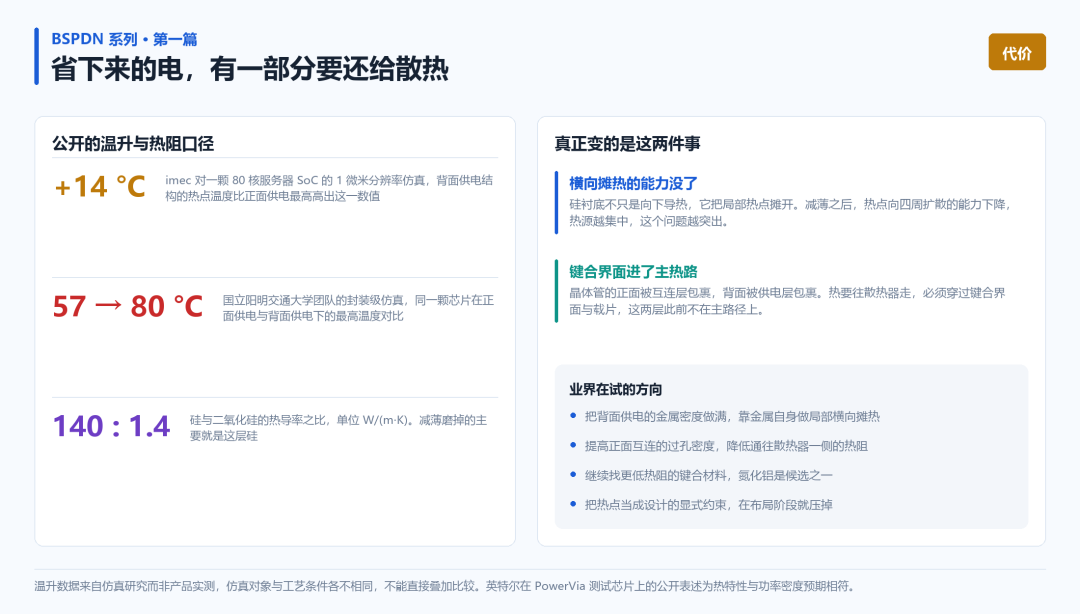
省下来的电,有一部分要还给散热。
把供电搬到背面之后,晶体管的处境变了:正面被互连层包裹,背面被供电层包裹,发热的器件等于被夹在两层金属中间。热要走到散热器,得穿过键合界面和载片,而这两层以前不在主散热路径上。
imec 对一颗 80 核服务器 SoC 做过 1 微米分辨率的温度仿真,按真实负载的功耗分布算,背面供电结构的热点温度比正面供电最高高出约 14 摄氏度。国立阳明交通大学的团队做封装级仿真,同一颗芯片在正面供电下最高温度 57 摄氏度,换到背面供电是 80 摄氏度。这两个数字来自不同研究对象和不同条件,不能直接叠加,但方向是一致的。
根子在一层硅上。硅衬底的作用不只是向下导热,它更是把局部热点横向摊开的介质。硅的热导率是 140 W/(m·K),二氧化硅只有 1.4,差一百倍。背面减薄磨掉的主要就是这层硅,横向摊热的能力跟着下降。热源越集中,这个问题越突出。
英特尔的 Myers 有句话说得挺准:热点大概率会变得更小,也更热。
应对办法有不少人在试,暂时没看到定论。有人在背面金属的密度上做文章,让金属自己也承担一部分横向扩散;也有团队把功夫下在正面,提高互连的过孔密度,把通往散热器那一侧的热阻压下去。键合材料这一环,氮化铝是被提得比较多的候选,但还在评估阶段。最彻底的想法是把热点当成设计的显式约束,在布局阶段就压掉,这要牵动 EDA 工具 和设计流程,短期内落不了地。
三家做出了三种做法
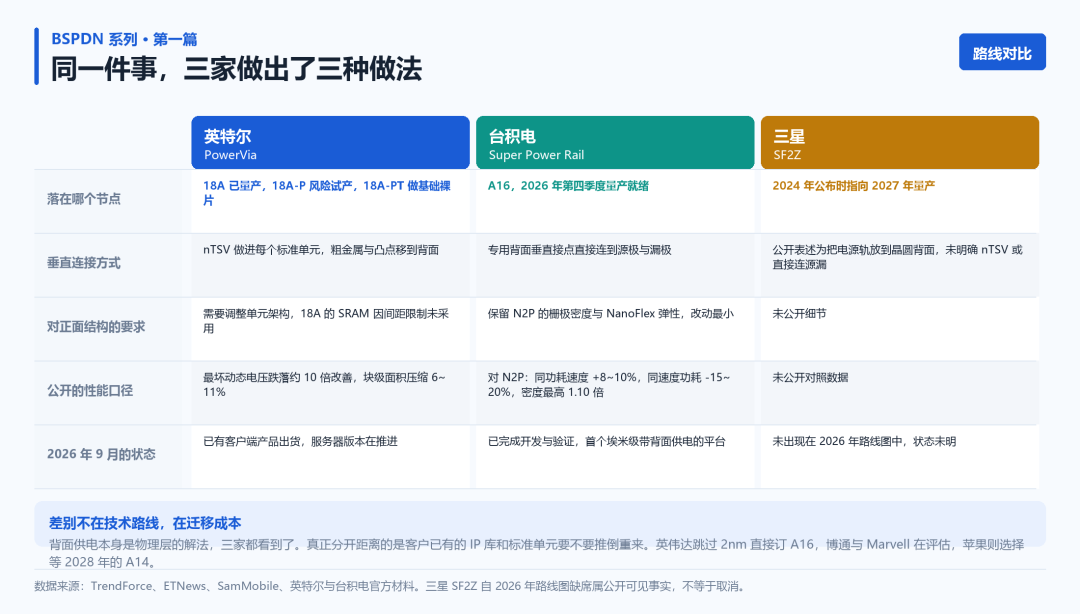
同一件事,三家给出了三种答案。差别不在原理,在客户要不要推倒重来。
最激进的是英特尔。PowerVia 把 nTSV 做进每一个标准单元,粗金属和凸点全部移到背面,代价是要调整单元架构,包括改接脚数量、放宽金属间距。
这里有个细节值得单独拎出来:18A 的 SRAM 阵列没有用 PowerVia。
原因是间距。PowerVia 要求电源通孔从全环绕栅极结构之间穿过去,间距不够就过不去。SRAM 单元的间距比逻辑区更紧,强行插入要把单元高度撑大约 1.1 倍。英特尔官方给的说法是背面供电对 SRAM 收益不明显,但从结构上看,间距限制才是更根本的那个原因。这个问题要留到 14A,14A 改用 BSCON 结构,从背面直接接源极,不再受栅极间距约束。换句话说,背面供电到现在还没能进到最密的阵列结构里去。
台积电的选择正好相反,往回收。A16 用一套专用背面垂直接点,电源网络完整放到背面,正面只动最小的幅度。这样 A16 保住了 N2P 的栅极密度和 NanoFlex 设计弹性,客户基于 N2 做好的 IP 库和标准单元不必大规模重构就能迁过来。
对设计周期动辄几年、IP 又极度庞杂的 AI 加速器来说,这一点比多几个百分点的性能值钱得多。还有个附带好处,A16 不需要高数值孔径极紫外光刻机,现有的极紫外设备就能生产,而单台高数值孔径设备的成本接近 4 亿美元。
三星的情况得说清楚,因为外面流传的说法不太一致。SF2Z 是 2024 年三星晶圆代工论坛公布的节点,名字里明确带背面供电,当时给的量产时间是 2027 年。到 2026 年的 SAFE Forum,路线图里已经看不到 SF2Z,同样消失的还有车规节点 SF2A。三星既没有发取消声明,也没有给新时间。能确认的是两句话:三星是第一个把全环绕栅极做进量产的厂商,但不是第一个把背面供电做进产品的厂商。
客户的选择比厂商的说法更能说明问题。英伟达跳过 2nm 直接锁定 A16,用于下一代 Feynman 架构,2028 年下半年量产,有报道说可能用 A16 加 N3P 的混合方案来应对产能。博通和 Marvell 在评估 A16,面向 2028 到 2029 年的下一代网络芯片。苹果走了另一条路,跳过 A16,等 2028 年的 A14。手机芯片的功耗规模远低于 AI 大芯片,背面供电带来的增益有限,苹果更看重晶体管密度能不能再往上走一步。
布线挪了位置,设计也得挪
电源搬到背面,改动远不止制造端。
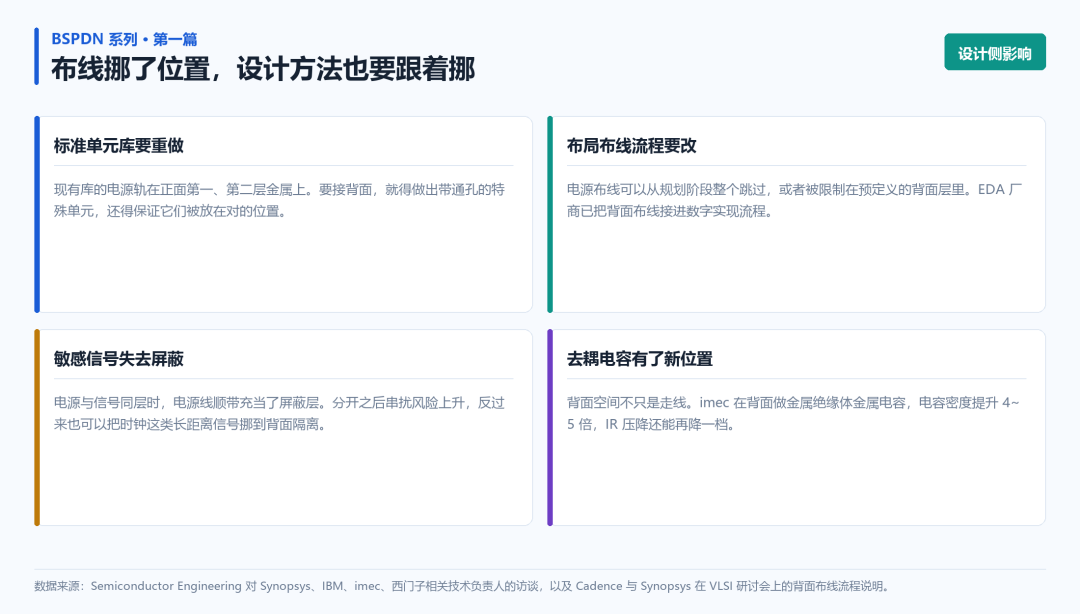
标准单元库要重做。现有库的电源轨在第一、第二层金属上,要接背面,就得做出带通孔的特殊单元,还得保证这些单元被放在能连上电源轨的位置。另一条路是直接用埋入式电源轨,把轨道做在器件下方。
布局布线流程要改。电源布线可以从规划阶段整个跳过,或者被限制在预定义的背面层里。Cadence 和 Synopsys 都已经把背面布线接进数字实现流程,IBM 也修改了行业标准的布局布线流程来支持多种背面供电架构的建模。
敏感信号失去了屏蔽。电源与信号同层的时候,电源线顺带充当了屏蔽层。分开之后,耦合噪声的影响变大,屏蔽变得更难做。反过来也有余地:时钟这类长距离信号可以搬到背面,与正面的干扰源隔开。时钟树通常是芯片上最关键的网络,原本占用的就是电阻最低的那几层金属。
去耦电容有了新位置。背面空间不只是走线,imec 在背面做了 2.5D 金属绝缘体金属电容,电容密度提升 4 到 5 倍,还能把 IR 压降再压一档。英特尔把储能元件移到背面的做法也是同一个思路。
对 EDA 工具来说,布线拥堵缓解之后,原位布线阶段花的时间会明显缩短。这算是设计工程师能直接感受到的一部分回报。
国产这一步,意义不一样
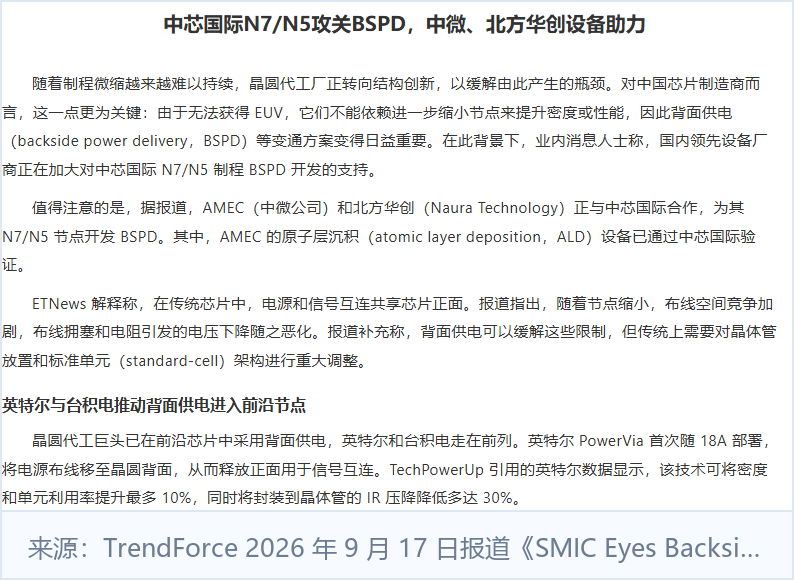
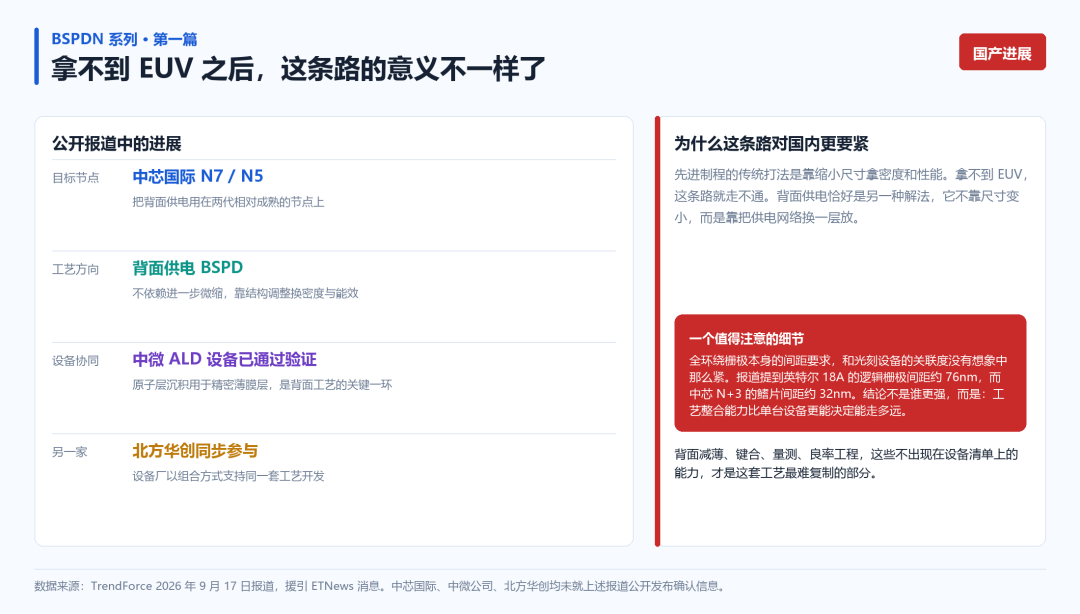
国内的动作出现在 2026 年 9 月。有报道称,中芯国际正在为 N7 和 N5 两代节点开发背面供电,中微公司和北方华创参与设备协同,其中中微的原子层沉积设备已经通过中芯国际验证。原子层沉积用于做精密薄膜层,是背面工艺链条上的关键一环。三家都没有就这条报道公开发布确认信息。
放在国内语境里,这件事的意义和台积电、英特尔那边不太一样。
先进制程的传统打法是靠缩小尺寸换密度和性能。拿不到极紫外光刻设备,这条路就走不通,只能在既有节点上磨。背面供电恰好是另一种解法,它不靠尺寸变小,而是靠把供电网络换一层放,用结构创新换性能和能效。对无法继续微缩的厂商来说,这是一条能走的路。
还有一个细节值得单独说。全环绕栅极对间距的要求,和光刻设备的关联度没有想象中那么紧。有报道提到,英特尔 18A 的逻辑栅极间距约 76nm,而中芯 N+3 的鳍片间距约 32nm。这个对比的结论不是谁更强,而是间距参数并不完全由光刻设备决定,器件结构的选择本身也会影响间距需求。在光刻设备受限的情况下,反而可以通过器件结构的选择来放宽间距要求。
真正难复制的是另一批能力:背面减薄、晶圆键合、量测、良率工程,以及减薄前后各做一次电性测试带来的成本上升。这些不出现在设备采购清单上,却直接决定工艺能不能稳定跑下去。工艺整合的门槛,往往就藏在这些不写进技术文档的实操环节里。
观点
行业习惯用节点数字描述进步,2nm、1.8nm、1.6nm。可这一次变的不是数字。芯片还是那颗芯片,只是它第一次有了两面:电从背面进来,信号在上面跑。上一次互连结构出现这个量级的改动,还是九十年代把铝换成铜。
六十年来,晶体管的性能上限基本就是芯片的性能上限,互连一直算配套。这个关系现在有点松动了。晶体管还能继续缩,可电送不进去、热散不出来,纸面上的性能就兑现不了。英特尔的 18A 里,最密的 SRAM 阵列还没用上背面供电。台积电把 A16 定在 2026 年第四季度量产,而最积极的客户英伟达要等到 2028 年才有产品上市。三星更干脆,那个节点直接从路线图上消失了。三家节奏差这么远,本身就说明事情还没收敛。
代价也是实打实的。14 摄氏度左右的温升,多出来的一整套背面工艺,还有一条要重新搭的供应链。对功耗数千瓦的 AI 加速器,这笔账算得过来。换成手机芯片就未必,苹果跳过 A16 已经说明了这一点。
散热也让我没底。热点变小变热是背面供电自己带出来的麻烦,如果背面金属的横向摊热和氮化铝键合这些手段不够用,它就会变成这项技术真正的上限。
后面几篇会接着往下拆:晶圆减薄与键合那道工序到底难在哪,背面供电之后散热方案会怎么演化,还有全环绕栅极和背面供电为什么必须协同设计。
(本文基于 TrendForce、ETNews、Semiconductor Engineering、imec 公开研究、英特尔与台积电官方材料整理,涉及厂商效率与性能的数字均为厂商自行披露口径,未经第三方实测;三星 SF2Z 自 2026 年路线图缺席属公开可见事实,不等于取消;中芯国际、中微公司、北方华创未就相关报道公开发布确认信息。本文不构成投资建议。)
 发表于 昨天 23:46
|
查看: 5|
回复: 0


