Hindsight 是 Vectorize 开源的 Agent 记忆系统,MIT 协议。它的定位一句话就能记住,Agent Memory That Learns,会学习的记忆。不满足于让 AI 记住更多,而是让 AI 在记忆之上长出理解和判断。
今天聊一个我觉得方向感很正的开源项目 vectorize-io/hindsight。
它管的是 AI 圈一块公认的短板——记忆。
它解决什么问题
你跟一个 AI 助手聊了三个月,它知道你的技术栈、项目卡在哪、你讨厌什么样的方案。换个会话,它一脸空白。
这不是玄学,是工程现实。大模型本身没有状态,上下文窗口就是它的全部记忆。窗口再大也有边界,把全部历史塞进去,成本和延迟都会失控。
业界的补法主要是两种。
一种是 RAG,把资料切片做向量检索,问什么查什么。另一种是知识图谱,把事实组织成实体和关系。两条路都能解决一部分问题,但有一个共同的局限——它们只是查找,不是记忆。
查到的东西不会沉淀。昨天告诉它你换了工作,今天它不会因此更新对你的认识。新信息和旧信息安静地躺在一起,没有冲突检测,没有信念更新,更没有「想通了一件事」这种过程。
Hindsight 的野心就落在这一步。它 README 里的表述我很喜欢:大多数 Agent 记忆系统聚焦于回忆对话历史,Hindsight 聚焦于让 Agent 学习,而不只是记住。
效果有第三方背书。它的基准成绩被弗吉尼亚理工 Sanghani 中心和华盛顿邮报的研究者独立复现过,在 LongMemEval 这个长期记忆基准上拿到了目前公开方案里最好的表现。项目方说它已经在财富 500 强企业的生产环境里跑着。
实现原理
先看整体结构。
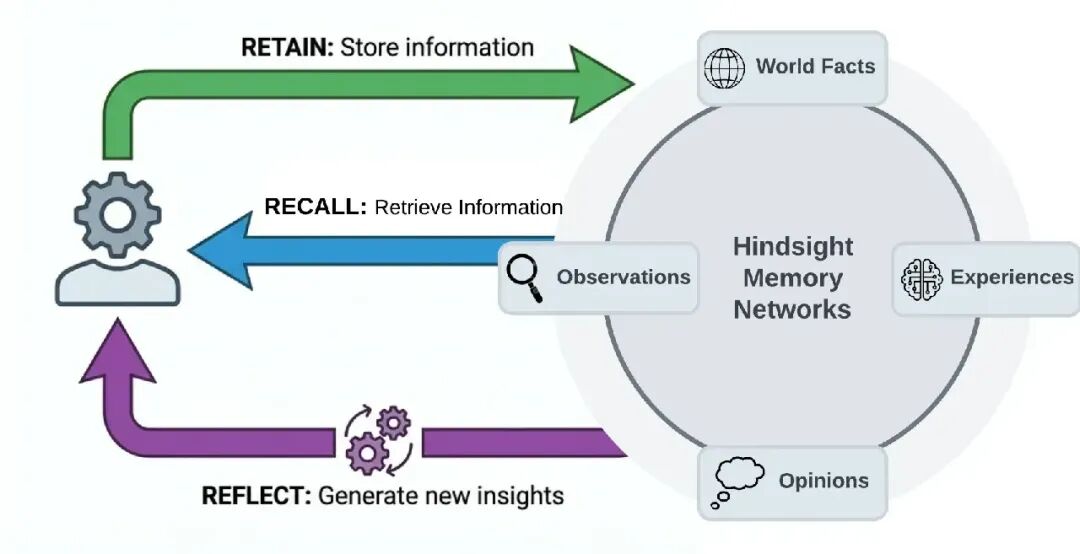
仿生的记忆分层。 Hindsight 不把记忆当成一堆平等的向量,它用类脑的数据结构把记忆分成四类:世界事实(world facts),比如「炉子会烫」;经历(experiences),比如「我摸了炉子,真的很疼」;观察(observations),从大量记忆里巩固出来的、带证据的信念;心智模型(mental models),从观察和事实里合成的对世界的整体理解。
前两类是原料,后两类是沉淀。它区别于向量库的地方就在这——有「巩固」这个动作。
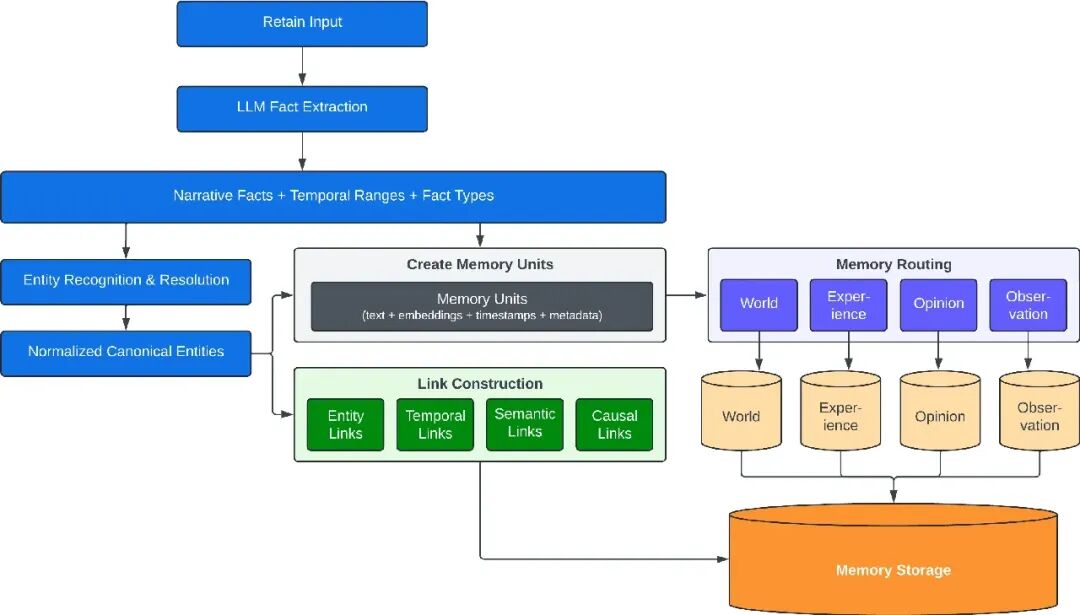
具体运转靠三个操作:retain、recall、reflect。
retain 负责存。你把一段内容丢给它,它在后台用 LLM 抽取关键事实、时间数据、实体和关系,再经过规范化,变成统一实体、时间序列和搜索索引。原文进了仓库,结构进了通路。
recall 负责取。一次查询,它并行跑四路检索:语义向量找相似,BM25 找精确关键词,图谱找实体和因果关联,时间过滤负责「六月发生了什么」这类问题。四路结果用倒数排序融合,再过一个交叉编码器重排,最后按 token 预算裁剪。
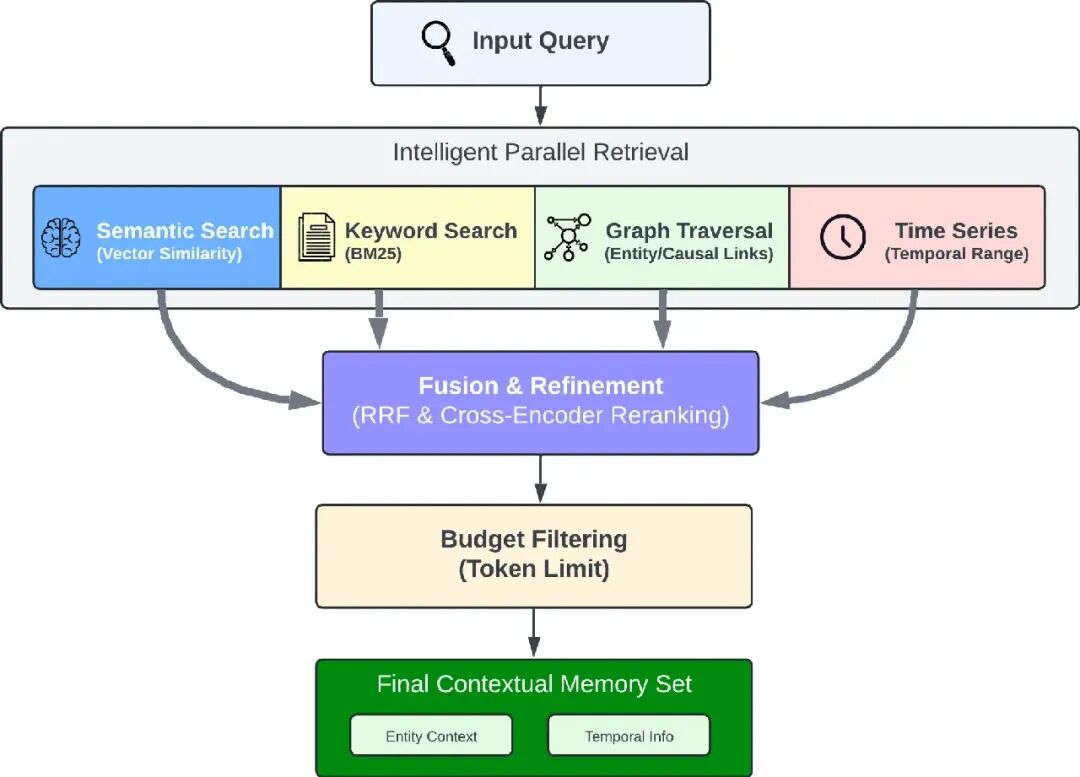
混合检索这件事,RAG 系统里也能见到。差别在于 Hindsight 检索的对象是经过巩固的记忆,不是生切片。
reflect 是最有意思的一个,负责想。它对已有记忆做更彻底的分析,让 agent 在记忆之间建立新的连接。官方的例子很具体:一个 AI 项目经理 reflect 一下,发现哪些项目风险还没被处理;一个销售 agent reflect 一下,想明白为什么某类外联消息有回复而另一类石沉大海。
观察的巩固机制,是我觉得最值得细看的部分。
事实存进去不是一堆散沙,后台会把相关事实逐步巩固成「观察」。每个观察保留支持它的原始引文和证据计数。新证据到来时,它不覆盖旧结论,而是强化、弱化或者延伸这个信念。
这个设计很像人。你听一个人说了三遍他喜欢徒步,你对「他喜欢徒步」的信心就比听一遍强。听到反例,信心下调,但不会瞬间归零。
心智模型和知识页。 心智模型是对某个常驻问题的标准答案,比如「这个用户的偏好是什么」。你定义一次问题,Hindsight 写答案、存答案,并在后台随着学习不断重写。读取时只是一次数据库查询,不用检索,不用调 LLM,agent 启动时就带着一页沉淀好的知识开工。知识页是心智模型的封装,一个记忆库关于自己的活文档,wiki 式组织,可以直接导出成 markdown。
工程细节也抠得细。 每个记忆库(bank)严格隔离,一个用户、一个 agent、一个项目一个大脑,不跨库泄漏。bank 还能设置性格特质,比如怀疑度、字面性、共情度,影响 reflect 的推理风格。多语言是默认能力,实体保留原生文字——张伟进去,出来还是张伟,不会被音译成 Zhang Wei。还有个叫 Memory Defense 的可选策略,入库前按 45 种模式扫描密钥和个人信息,命中就脱敏或者拦截,把 token 泄漏这类事故从源头堵住。
如何部署
部署路径给得很全,从个人体验到企业级都有。
export OPENAI_API_KEY=sk-xxx

docker run -it --pull always --name hindsight --restart unless-stopped \
  -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest
一条命令,镜像自带嵌入式 PostgreSQL,API 起在 8888 端口,管理界面在 9999。这是个人起步最快的路。
生产环境的选择也不少。外部 PostgreSQL 用 docker compose,集群用 Helm 装进 Kubernetes,裸机 pip install hindsight-api 直接跑,嫌麻烦还有托管云。存储支持 PostgreSQL 加 pgvector,企业场景可以换 Oracle AI Database,功能完全对齐。
模型这一层自由度很大。OpenAI、Anthropic、Gemini、DeepSeek 这些主流 API 都行,Ollama、LM Studio 这类本地推理也行,任何 OpenAI 兼容端点都能接。甚至你的 ChatGPT Plus、Claude Pro、Cursor、GitHub Copilot 订阅都可以直接拿来用,不需要单独的 API key。官方列出的提供商超过 25 家。
平台覆盖 Linux、macOS(Intel 和 Apple Silicon)、Windows 全套。
协议是 MIT,商用没有心理负担。
怎么使用
接进来比想象中简单。
最直接的方式是 SDK,Python、Node.js、Go、CLI、REST API 都有。核心就三个调用。
from hindsight_client import Hindsight

client = Hindsight(base_url="http://localhost:8888")

# 存
client.retain(bank_id="my-bank", content="Alice 在 Google 做软件工程师")

# 取
client.recall(bank_id="my-bank", query="Alice 是做什么的?")

# 想
client.reflect(bank_id="my-bank", query="关于 Alice,我应该知道什么?")
更省事的办法是 LLM Wrapper,两行代码给现有的 LLM 客户端包一层。
from openai import OpenAI
from hindsight_litellm import wrap_openai

client = wrap_openai(OpenAI(), bank_id="user-123")
包完之后什么都不用改。每次调用前它自动召回相关记忆,调用后自动保存新对话,上层代码完全无感。底层是 LiteLLM,一百多个模型都能这么包。
生态集成官方列了六十多个。编码工具有 Claude Code、Codex、Cursor、GitHub Copilot;框架有 LangGraph、LlamaIndex、CrewAI、OpenAI Agents SDK;低代码平台有 n8n、Dify、Zapier。大部分集成不需要改代码。
编码 agent 这条线值得单独说。一条命令装完,Hindsight 会为每个仓库自动建一个记忆库,从 git 历史和过往会话里构建项目记忆,agent 开工时自动注入,内容包括架构、约定和进行中的工作。
npx @vectorize-io/hindsight-coding-agents install all
它还内置了 MCP 端点,每个 bank 一个。任何 MCP 客户端指过来,retain、recall、reflect 就变成三个可调用的工具。
另外有个嵌入式模式,pip install hindsight-all,不部署服务器,Python 进程里直接起一个完整的 Hindsight,适合本地实验和单机应用。
README 里有个坦诚的提醒我觉得挺好:如果你的场景只是简单的 n8n 工作流,上 Hindsight 可能是杀鸡用牛刀。它真正瞄准的是需要长期积累、根据反馈改变行为、越用越懂你的那类 agent。
多说一句
AI 行业这两年卷模型、卷上下文长度、卷工具调用,唯独记忆这块,大家默认它难,就先绕着走。
RAG 给了 AI 一座图书馆,随查随用。Hindsight 想给的,是一个会随经历生长的大脑。查到和记得是两回事,记得和想通又是两回事。
记忆不是存储的堆叠,是经历的沉淀。Agent 真正的成人礼,是从「什么都查得到」走到「什么都想得通」。
这条路要验证的东西还很多:巩固的质量、遗忘的策略、长周期下的成本。但方向本身,值得所有做 Agent 产品的人认真想一遍。
项目地址 https://github.com/vectorize-io/hindsight ,文档在 https://hindsight.vectorize.io ,技术论文在 arXiv 上也找得到。
 发表于 3 天前
|
查看: 0|
回复: 0


