关于理解 Agent Harness,其实这篇文章基本覆盖了你要知道的全部内容。
早在 2023 年,我们刚开始接触 LLM 时,交互模式还很直接:提出问题,然后得到答案。像我这样的程序员通常会问:“用 Python 编写一个对数字数组进行排序的函数”。我们几乎能实时拿到结果,模型也不会进入“思考”模式。因为那时的模型还只是基础 LLM,并不具备如今 agentic 系统中的各种复杂能力。
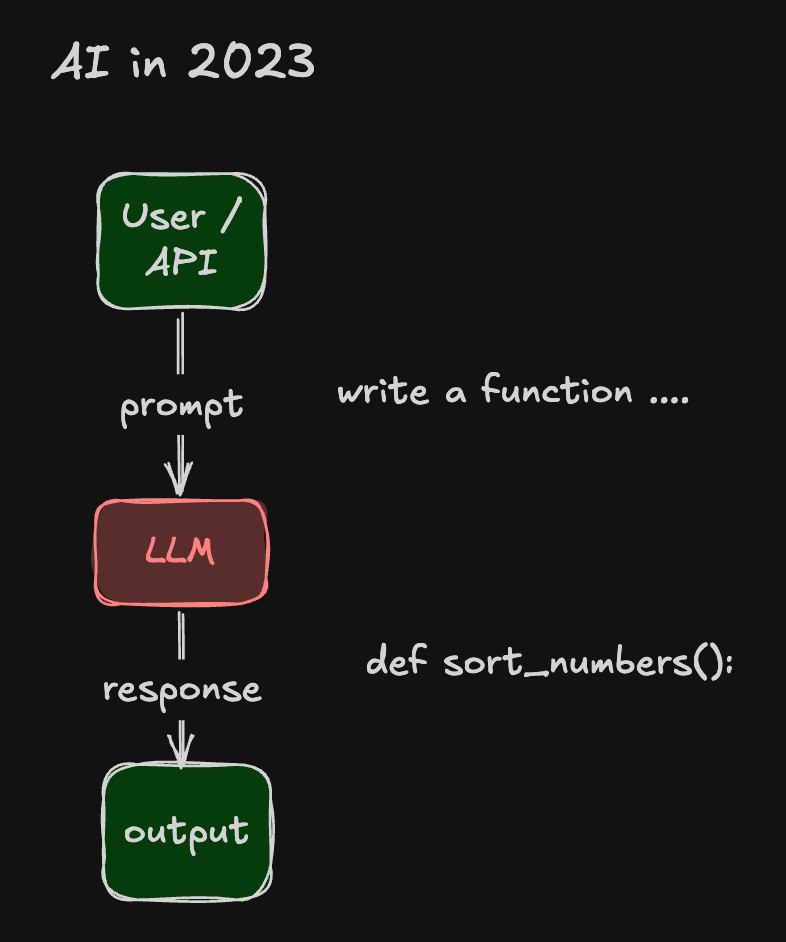
这里说的复杂能力,指的是 tools、memory、skills,以及更多在 2026 年已经不可或缺的能力。正是这些附加组件,让一个简单的 LLM 变成了 AI agent。
一边是 Agentic 竞赛
2023 到 2024 年,竞争焦点还集中在模型本身。OpenAI 有当时最强的通用模型之一,Anthropic 则有最强的 coding 模型之一。各家不断推出新模型,希望在 MMLU、SWE-bench 等标准 benchmark 上击败对手。
模型竞赛逐渐趋于饱和,reasoning、context 等能力开始出现。聊天 UI 里开始冒出类似“thinking...”的提示。人们也开始好奇:当 UI 出现“thinking...”时,底层到底发生了什么?
Agent 竞赛就此开始……
另一边是用户的野心
模型变复杂的同时,我们作为用户也变得更加激进。我们不再只是提问,而是开始派发任务。为了回答这些问题,agent 需要设定目标、调用 browser 等外部工具、从 memory 中回忆过去的对话和事实,甚至还要做更多动作。
我至今记得很清楚:自己曾经截了一张 Amazon landing page 的截图,直接丢给一个 coding model,让它照着截图一次性做出一个网站。它确实生成了相似的 UI。但再想一步:如果用户希望 UI、backend、infrastructure 以及周边所有东西都一次性配置完成呢?
这就是我们在 2026 年所处的位置。
所以现在,我会输入这样的 prompt:“解决 GitHub issue #122 中报告的 bug”。这种 prompt 对 LLM 的要求高得多。看似简单的一句话里其实包含多个步骤。2023 年的 LLM 大概率会回答:“抱歉,我无法访问你的 GitHub repo。”
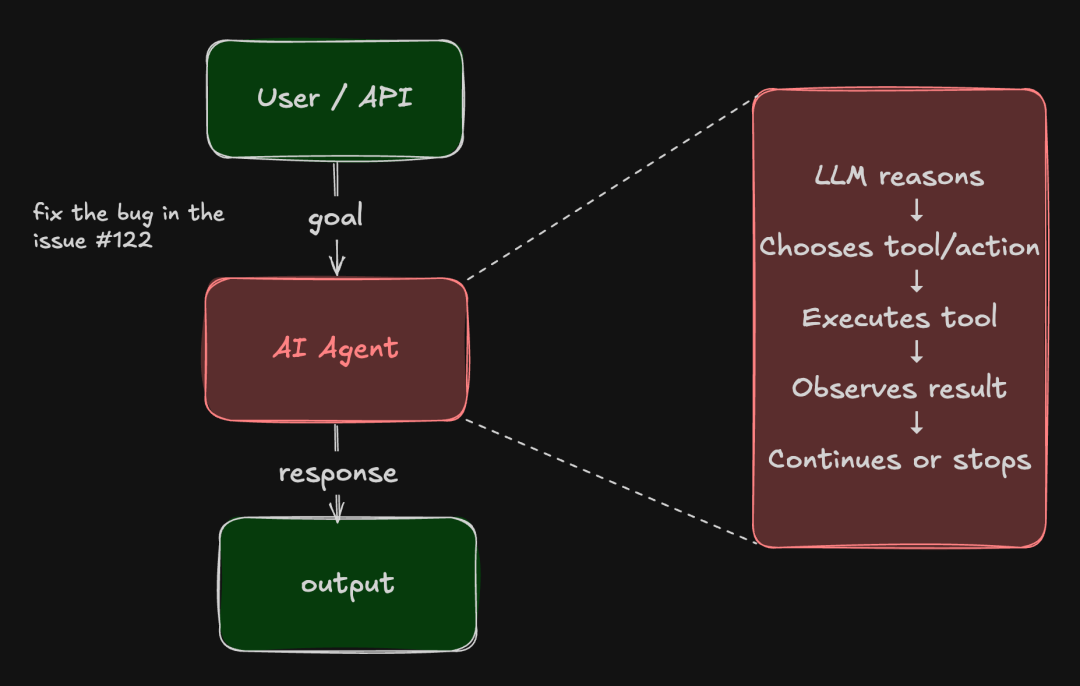
而一个具备良好 Agent Harness 的 LLM 会进入“思考”模式。它会经历 reasoning → planning → choose tool/action → execute tool → observe result → repeat or stop。
我明白了,但 Agent Harness 到底是什么?
既然我们要在 LLM 外围封装 context、tools、memory 这么多附加组件,那就需要一种高效方式来工程化这些组件与 LLM 的交互。Agent Harness,正是对这种机制的称呼。它的正式定义是:
Agent harness 是包裹、控制、测试、监控和评估 AI agent 的基础设施层。
简单说,它就是围绕 LLM 构建的“操作系统”。
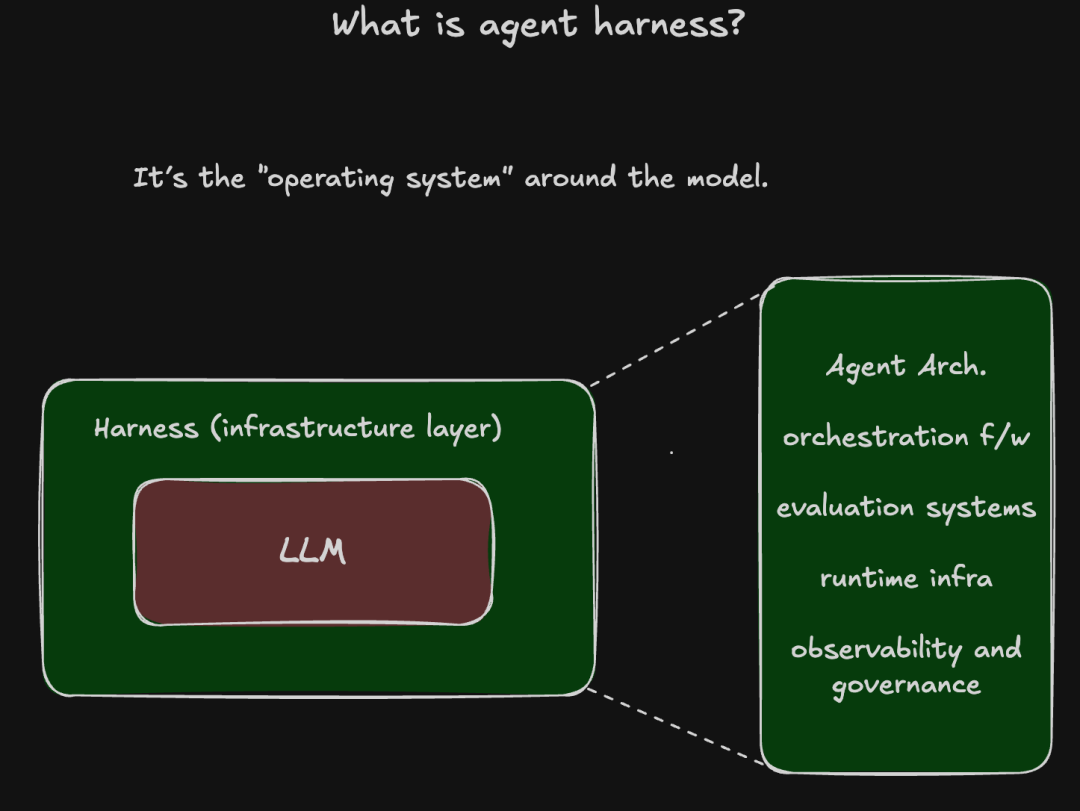
作为包裹在 LLM 外围的基础设施层,harness 由 agent architecture、用于编排多个 sub-agent 的 orchestration framework、用于评估 agent 输出的 evaluation system、runtime infrastructure、security、governance,以及同样重要的 observability 组成。
为什么需要 agent harness?
随着我们给 AI agent 设置越来越大的目标,它完成任务所需的时间也在不断变长。下面这张来自 Anthropic 的图表就很直观。
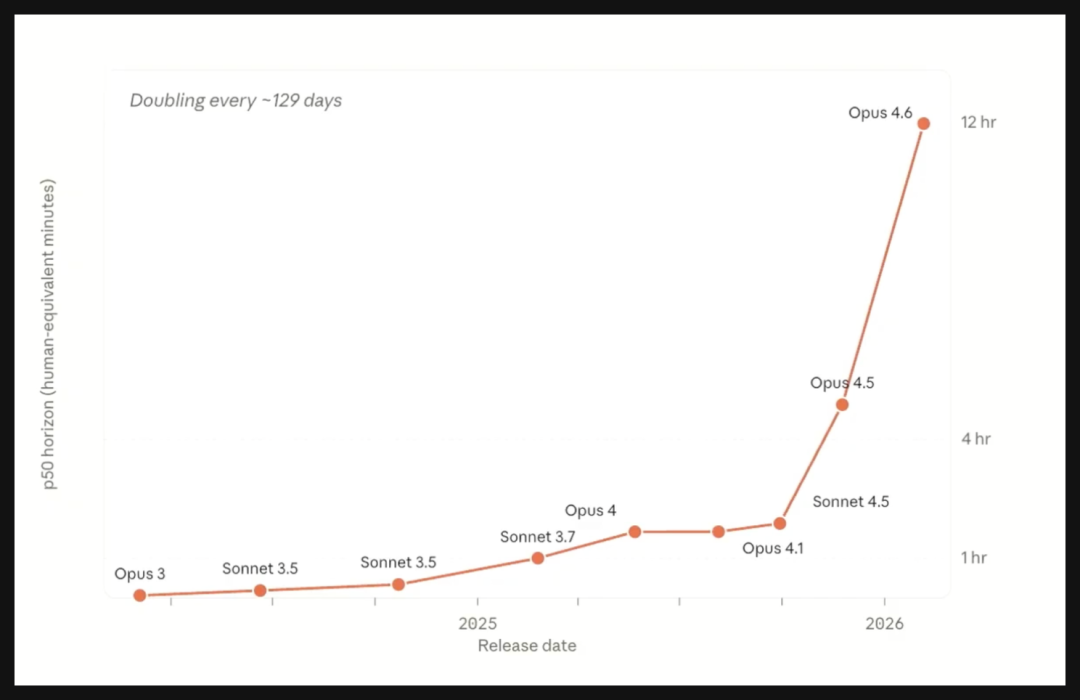
就在 2025 年,也就是一年前,agent 执行一项给定任务通常还需要大约一小时。但如今,这个时间已经徘徊在 12 小时上下。这些 long-horizon 任务会带来很多麻烦:可能无限循环、幻觉式调用工具、破坏 agent state、超出 token budget、丢失 context、重试错误操作、静默失败、滥用权限,甚至忘记目标。
这些问题成本很高。想象一个 AI agent 陷入 12 小时的无限循环,它消耗的 token 和 compute 会非常惊人。而我们在 harness 中为任意给定任务设置 budget,就能解决这个问题。这个 budget 可以是时间、token 或 compute budget。
更值得担心的是安全问题。想象 LLM 选择了一个具有破坏性的工具,比如删除文件系统中所有文件的工具。通过 harness,我们可以对 LLM 能访问什么做细粒度控制。
简而言之,正是 harness 让你能控制 agent,从而确认 agent 正在执行你希望它执行的操作。
Agent harness 的组件
不管一个 harness 被怎么命名,它通常都由以下组件组成。
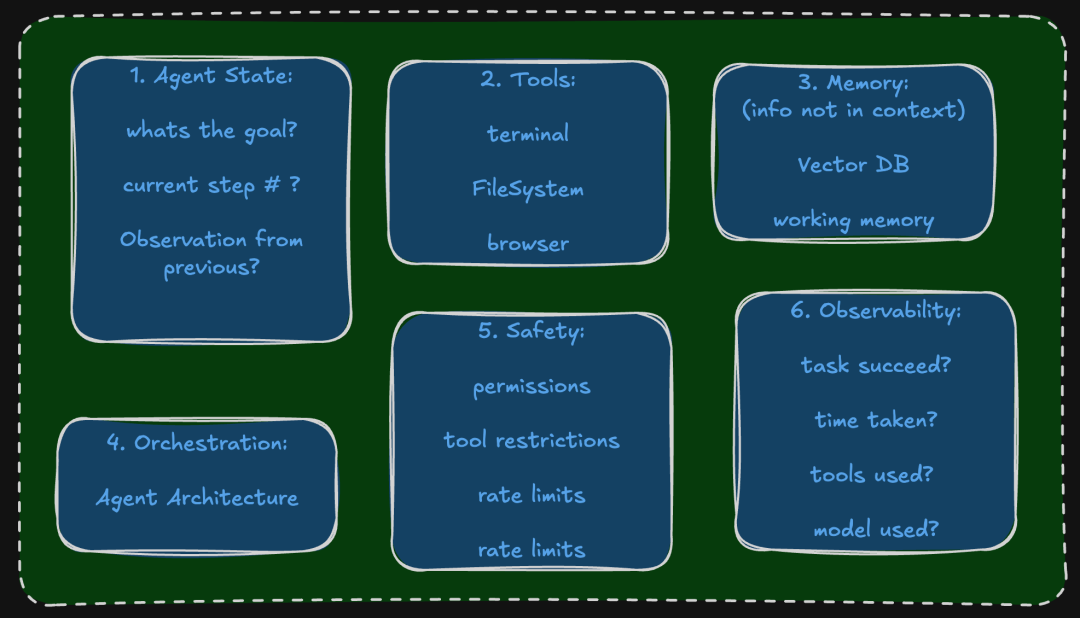
- Agent state。 回答“我现在在哪里?”它会跟踪当前任务、步骤、观察结果和决策。比如 agent 的计划包含 4 步来完成目标,state 就会跟踪哪些步骤已完成、当前状态是什么、还剩哪些工作。
- Tools。 回答“我能做什么?”它为 agent 提供 code execution、browser、APIs、databases、shell 等能力。所有组件中,tools 最直观。对 coding agent 来说,
read_file 可能就是最基本的工具之一。
- Planning。 回答“我应该做什么?”它决定接下来该发生什么,并创建或修订计划。在 coding task 中,planning component 可以给出 4–5 个需要按顺序完成的步骤。
- Memory。 回答“我知道或记得什么?”它会跨步骤或 session 存储、检索信息。当我们从 Vector DB 检索信息并放进 context 时,可能值得先做总结来优化 context,进而优化 working memory。这些需要 harness 的 memory component 来管理。
- Orchestration。 回答“我该如何执行这个过程?”它控制 execution loop、tool calls、retries、sub-agents、parallelism、handoffs 等。例如 agent 在处理购买任务时,可以调用 payment sub-agent,同时让 inventory agent 并行更新库存;也可以让 inventory agent 在 payment agent 完成后再顺序执行。
- Context Management。 回答“LLM 现在应该看到什么?”它决定每一步把哪些信息放进 LLM 的 context window。
- Safety & Governance。 回答“我被允许做什么?”Permissions、sandboxing、approval gates、policies、limits、authentication 都属于这一组件。即使模型能使用很强大的工具,也要限制它能执行到什么程度。比如允许模型在 coding task 中编辑文件,也要确保它不能删除文件系统中的全部或部分文件。
- Observability & Evaluation。 回答“它真的成功了吗?”它追踪发生了什么,并衡量 agent 是成功、失败还是违反了约束。模型完成任务的代价都会在 observability 中被跟踪。例如模型可能只用 10 个工具中的 3 个就完成了任务,跟踪这些工具的使用方式就有价值。如果失败,是模型缺某个工具,还是 context 里缺了数据?
而 harness engineering 则是一门新兴学科,研究如何设计、实现和执行上述组件,让 agent 发挥最佳表现。
一个实际的 coding agent 示例
了解组件之后,我们看看它们在一个简单 coding task 中如何交互。
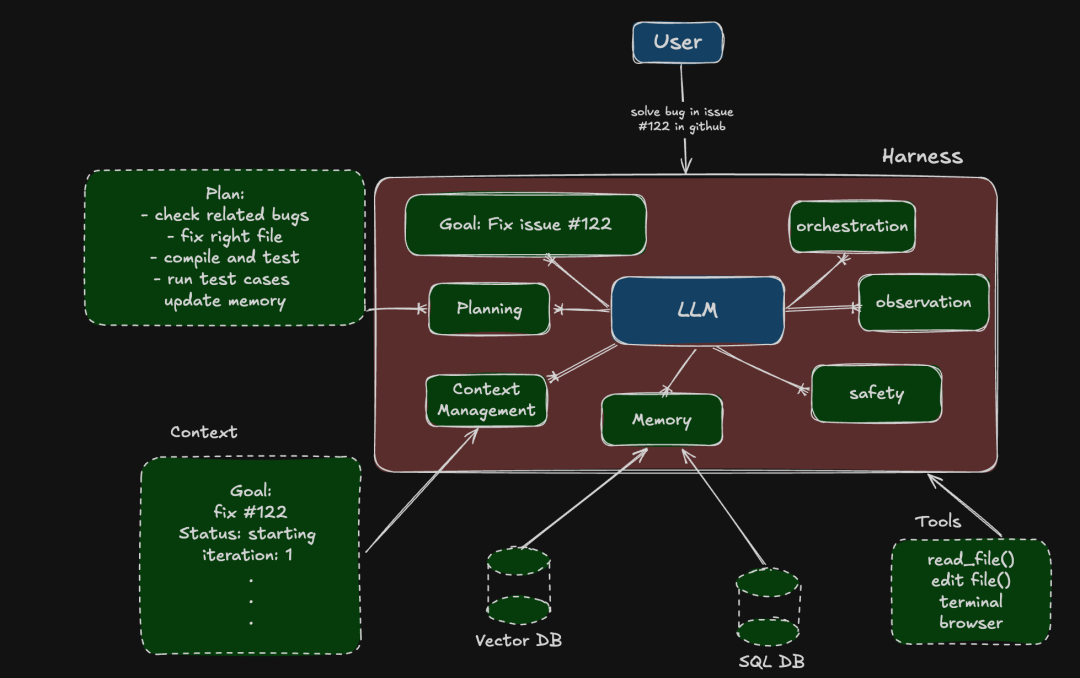
假设我们已经为某个 coding agent 实现了 harness。用户发来这样的 prompt:
解决 GitHub issue #122 中的 bug
注意,这不是简单的“给我解释……”类问题,而是真正要执行的任务。要完成它,需要 planning、tool use、memory 以及更多 agentic 能力。
下面是实现该 harness 的一种合理方式:
- 首先,用户输入进入 context。模型开始 reasoning,并提出一个目标。目标完成前,它会一直留在 context 中。
- 然后,模型决定为任务执行做一次“plan”。它给出的计划是:检查相关 bug、修复正确文件、编译并测试、运行 test cases、更新 memory。
- 执行第一步时,harness 从 Vector DB 中检索 memory,找到与当前任务相关的历史 bug 详情。它发现与 authentication 相关的信息最匹配,于是将其放进 context。
- 接着,模型利用 context 中的信息,决定读取
auth.py 文件来修复 authentication bug。这需要 read_file 和 write_file 两个工具。模型使用它们编辑文件并保存。
- 模型决定通过 terminal 测试代码变更,因此需要调用 terminal tool。该工具在模型可用的 tools 集合中,harness 也会确保模型拥有访问 terminal 和文件的适当权限。
- 模型按计划继续下一步,运行 test cases。这时需要访问更多 tools。整个过程每一步都会更新 context,让模型清楚自己走到哪里、还剩多少工作。
- 这期间,observability component 会确保所有内容被记录:使用了哪些 tools、任务耗时、用到的 memory、中途发生的失败等。
- 还要注意,这里还没涉及 evaluation。这本身就是一个大主题,它不只是衡量准确率,还能根据 agent 的实际行为覆盖多个指标。
那么,我们将走向何方?
如今 agentic AI 最大的挑战之一,是 long-horizon reliability。随着运行数小时甚至数天的 agent 成为现实,我们必须保证运行绝对可靠。如果 agent 陷入无限循环,或进入某种损坏的 state,最终会浪费大量资源,并带来安全风险。
接下来,随着我们围绕模型构建更复杂的 harness,evaluation 也会变得相当困难。每项任务都会留下包含大量数据的 traces,比如用过的 memory。我该换一个模型,还是改进 harness?我该加更多 tools,还是修复现有 tools?
随着社区积极构建复杂的 harness,这些问题正在不断出现。
未来会怎样,我们拭目以待。下一篇文章再见……
 发表于 4 天前
|
查看: 12|
回复: 0


