一家 AI 公司,为什么要把吃饭的家伙开源出去?
9 月 30 日,DeepSeek 发了一条开源公告,看的人不少,但我觉得大部分人没看懂它到底重在哪。
它不是又发了个模型,是把训练自己模型用的那套底层工具,整套搬到了华为昇腾的芯片上。
先把结论摆前面:模型发得多新,明年可能就忘了;但这次开源的东西,会一直留在国产算力的地基里。
01 这次到底发了什么
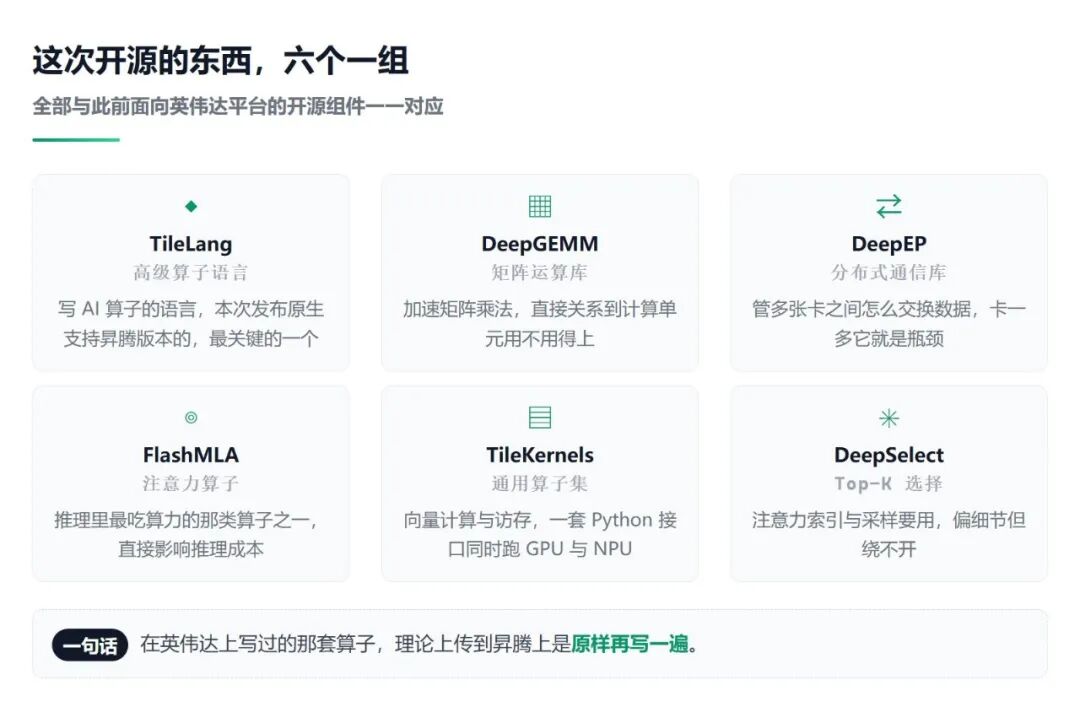
一句话:一套给英伟达 GPU 写代码的工具链,现在华为昇腾也能用了。
官方说法是「所有组件与此前面向英伟达平台的开源组件一一对应」。这个「一一对应」不是文案,是真的一条一条对着搬的。
TileLang —— 高级算子语言
写 AI 算子的语言,这次发布了原生支持昇腾的版本,是最关键的那一个。
DeepGEMM —— 矩阵运算库
负责加速矩阵乘法,直接关系到计算单元用不用得上。
DeepEP —— 分布式通信库
管多张卡之间怎么交换数据,卡一多这个就是瓶颈。
FlashMLA —— 注意力算子
推理里最吃算力的那类算子之一,直接影响推理成本。
TileKernels —— 通用算子集
覆盖向量计算、访存这些常见活,一套 Python 接口能跑 GPU 也能跑 NPU。
DeepSelect —— Top-K 选择
注意力索引和采样要用的,属于偏细节但绕不开的算子。
六件套齐了。再加上双方联合推的基于昇腾 950 的 128 卡超节点方案。
一句话总结:从现在起,你在英伟达上写过的那套算子,理论上能在昇腾上原样再写一遍。
02 为什么说「写算子」是整个行业最疼的那块
要理解这次开源的分量,得先知道「算子」是干嘛的。
你可以把一张 AI 芯片 想成一座工厂。理论产能很高,但货能不能顺畅地在流水线上跑,取决于每条产线怎么排布。算子,就是排流水线的那份图纸。
图纸排得不好,几万块钱一块的芯片,可能只跑出 20% 的力气。图纸排得好,能到 95% 以上。
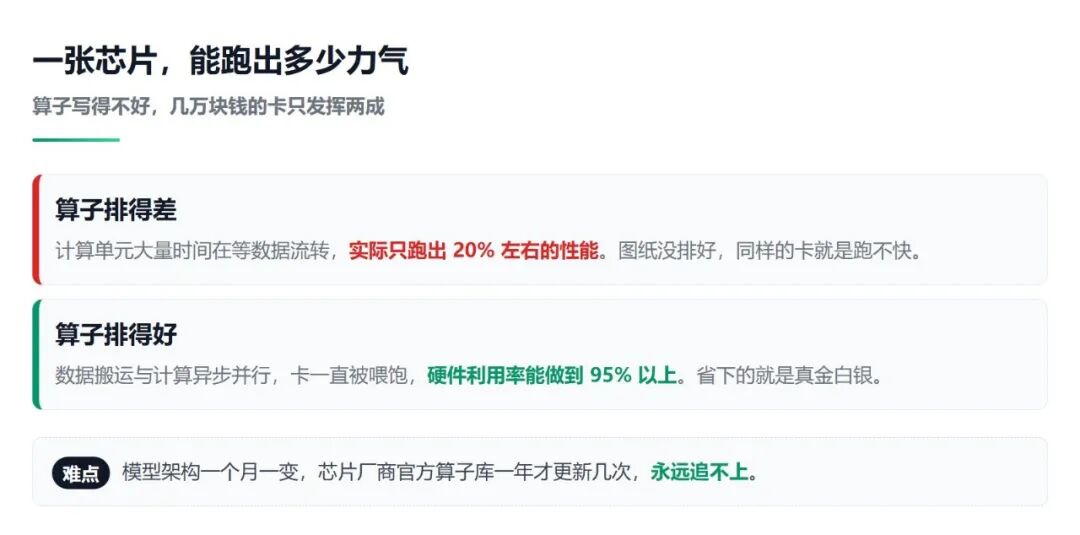
难点在于,模型架构一个月一变,芯片厂商的官方算子库一年才更新几次。永远追不上。
过去开发者就三条路,条条有坑:
手写 CUDA —— 性能最高,效率最低
能榨出芯片全部力气,但一个矩阵乘法要管三级缓存、线程块调度、数据预取、寄存器分块,上千行代码打磨好几周是常态。而且还绑死在英伟达上,换块芯片全部重来。
用厂商预制库 —— 开箱即用,改不动
像 cuBLAS 这种,标准算子直接调用性能拉满,但内部逻辑你看不到也改不了,想做算子融合没门。新算法很容易卡在这一层。
用高层编译器 —— 门槛低,天花板也低
比如 OpenAI 的 Triton,写起来简单多了,但性能上限受编译器策略限制,而且对昇腾、AMD 这些非英伟达硬件原生支持很差,适配成本高。
三条路,要么绑死英伟达,要么性能上不去,要么适配贵。
TileLang 走的是第四条路。
03 TileLang 到底新在哪
TileLang 的核心思路叫「多级分块」(Tiling)。
打个比方,你要算一个巨大的矩阵乘法。传统做法是你自己盯着整个计算过程,手动决定哪块数据放哪、哪个线程干哪段。
TileLang 让你只声明「每块数据在哪里算」,剩下的数据搬运、线程同步这些脏活,编译器自动做完。
用它的写法,一个传统 CUDA 里要 500 多行的通用矩阵乘法,能压到 30 多行 Python。
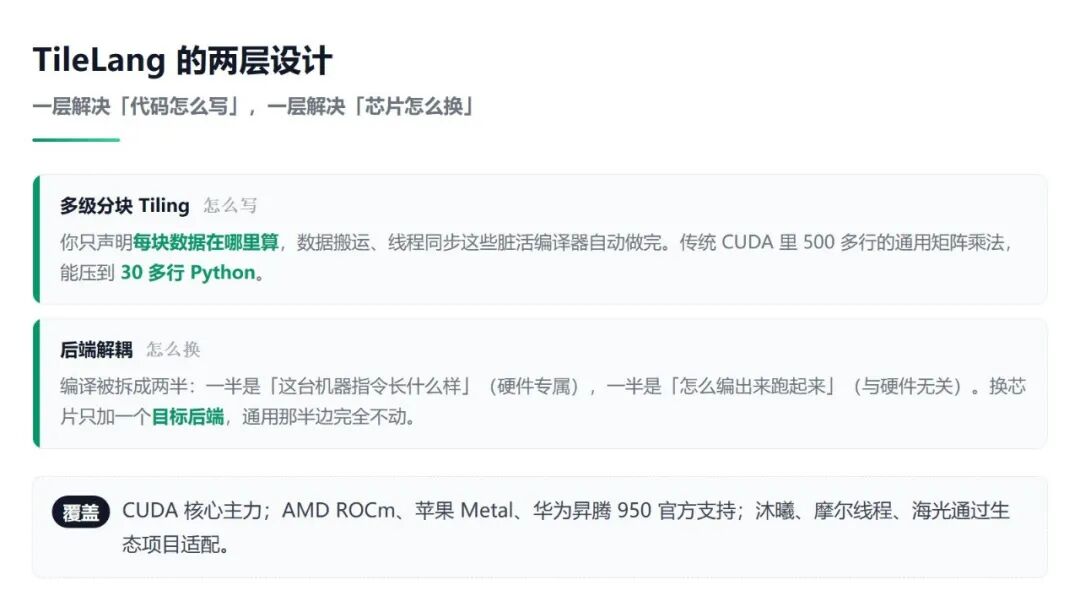
它上面还有一层更重要的设计,官方叫「后端解耦,目标与执行分离」。
说白了就是:编译这件事被拆成两半。一半是「这台机器指令长什么样」(硬件专属),另一半是「怎么把代码编出来跑起来」(跟硬件无关)。
适配一款新芯片,只需要新增一个「目标后端」,通用那半边完全不用动。
现在的覆盖情况是:英伟达 CUDA 是核心主力,功能最全;AMD ROCm、苹果 Metal、华为昇腾 950 属于官方支持级;LLVM CPU、WebGPU 这些还在实验阶段。沐曦、摩尔线程、海光这些国产芯片,通过生态项目在做适配。
这也是为什么它能一套代码跑多个平台。英伟达官方工具只服务自家芯片,TileLang 不是。
04 它凭什么让人信
光说设计好听没用,得看跑分。
TileLang 不是从零写的 编译器,它站在 Apache TVM 的肩膀上。TVM 是陈天奇团队做的那套机器学习编译器,在 AI 圈的地位大概相当于编程语言界的 LLVM。
效果上,官方放出来的数据是:
对 PyTorch —— 快 2 到 20 倍
基于 TileLang 优化的 DeepSeek V3.2 稀疏注意力 TopK 算子,比 PyTorch 原生实现快 2 到 20 倍。
对 Triton —— 大幅超越
同样在 H100 上跑核心算子,速度超过了 OpenAI 主推的 Triton。
对 cuBLAS —— 追平官方
甚至追平了英伟达官方调校的 cuBLAS 和官方版 FlashAttention。
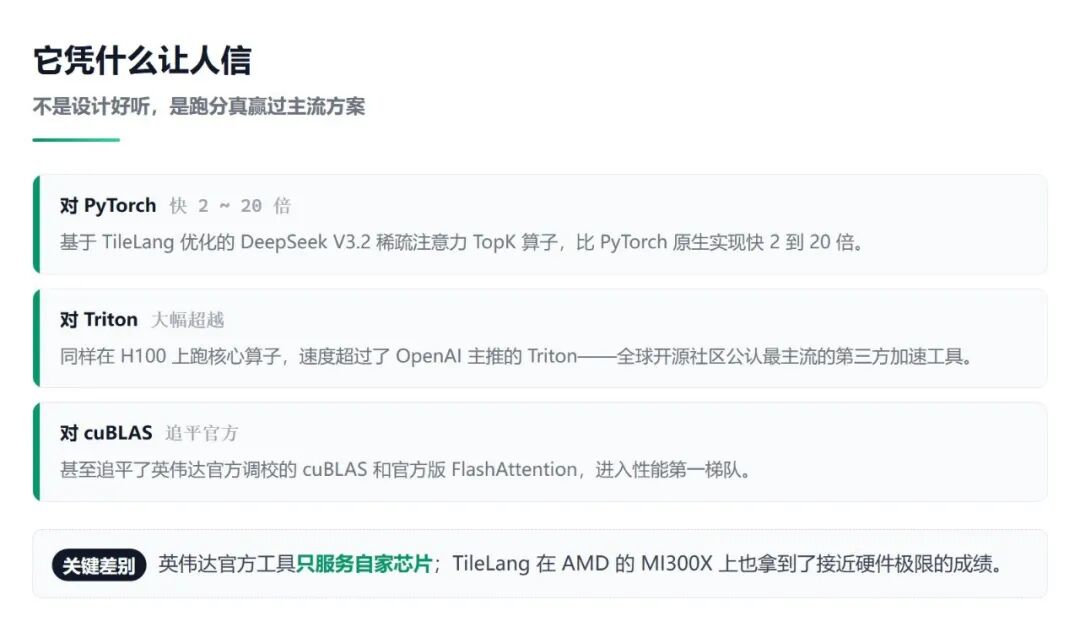
这里面的对比对象得说清楚。PyTorch 是当今用得最多、生态最大的 AI 框架,Triton 是全球开源社区公认最主流的第三方加速工具。TileLang 同时赢过这两个,才有资格说自己进了第一梯队。
而且英伟达官方工具只跑英伟达的芯片。TileLang 在 AMD 的 MI300X 上跑,也拿到了接近硬件极限的成绩。
05 最容易被忽略的一点:这背后是笔大钱
工具开源是一层意思,DeepSeek 真正在下的是另一盘棋。
据媒体报道,DeepSeek 已下单采购至少 16 万颗华为昇腾 950DT 加速器,金额约 25.6 亿美元,用于内蒙古乌兰察布在建的数据中心,最快今年四季度开始交付。
梁文锋在投资人闭门会上把「用华为或其他国产芯片训练模型」形容成公司「最大的赌注之一」,还加了一句「必须成功」。
目前这批昇腾主要面向推理侧,训练环节暂时还是以英伟达为主。
DeepSeek 正在训练一款 2 万亿参数的 大模型,比现有旗舰 V4 的 1.6 万亿更大;还规划了 8 万亿参数的更大模型。
模型越大,对算力的需求就越夸张。软件栈这一层如果理不顺,卡买回来也白搭。这次开源,本质上是在给这批卡铺路。
06 该说的问题也得说
我不想把这件事说得太顺,有三个坑是实实在在的。
训练代码全部重写 —— 工作量巨大
DeepSeek 的 V3、V4 训练代码最早是为英伟达的架构写的。要在昇腾上跑,每一处底层库调用都得替换成昇腾对应的版本,自研算子也要逐个在昇腾 950 上重新验证性能。
通信原语要换底层 —— 坑很深
训练要在成千上万张卡之间同步梯度。英伟达生态的 NCCL 和昇腾的 HCCL,接口设计、性能曲线、容错模型都不一样。这不是改个引用那么简单,任何一处适配偏差都可能让整轮训练静默失效。
产能是最大的不确定 —— 卡得先交得出来
推动大家转向国产芯片的是出口管制,但同一套管制也在限制昇腾扩产。16 万颗的押注,隐含前提是四季度交付别掉链子。目前看华为受先进内存等元器件短缺影响,还有供货缺口。
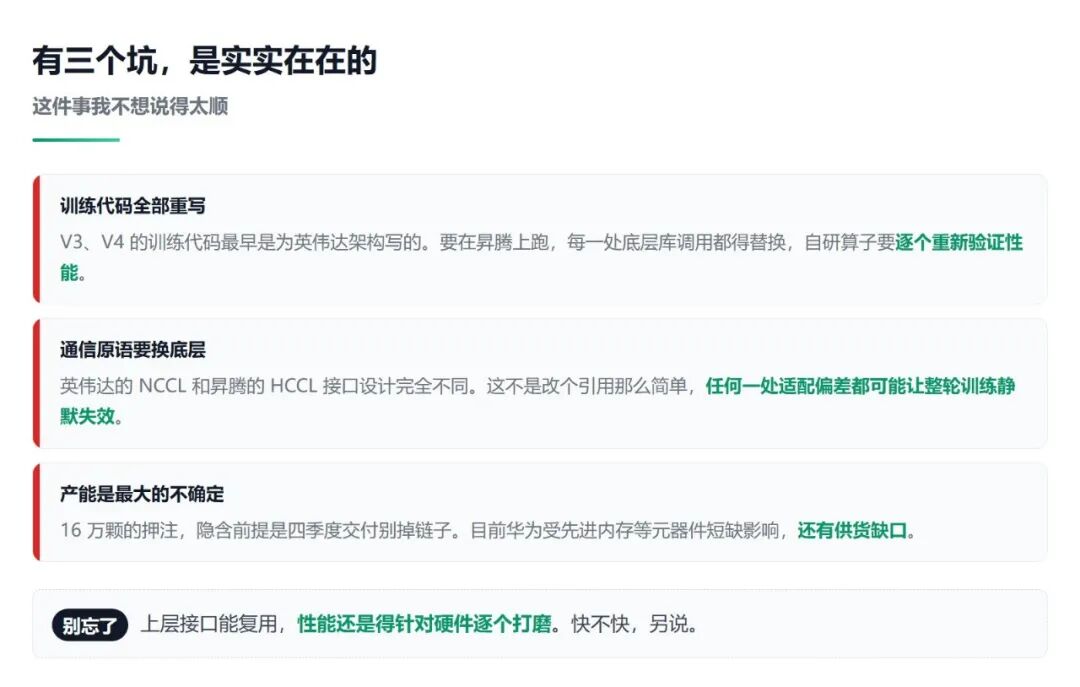
还有个不能忽视的现实:接口能复用,性能还是得针对硬件逐个打磨。上层 Python 接口是同一套,但底下的实现按硬件走,快不快另说。
07 这件事的意义在哪
CUDA 和 TileLang,其实是两种生态路线。
CUDA 是闭源、全栈、深度绑定硬件的厂商主导路线,积累厚,但迁移成本极高。
TileLang 是开源、聚焦、跨硬件的社区化工具,只解决大模型最核心的算子问题,灵活度高、移植成本低。
TileLang 的意义不是替代 CUDA,是补上了眼下最紧的那块短板。
它让国产芯片不用从零搭一整条软件生态,就能先拿到大模型训练需要的顶级算子能力。当越来越多模型厂商基于它开发算子,国产芯片的适配成本会往下掉,生态迭代会往上走。
未来一年,至少四个变量决定这场赌局的成败:昇腾 950 的交付率、TileLang 昇腾后端能不能在半年内追平 CUDA 后端、字节腾讯阿里会不会跟着押注、出口管制会不会再升级。
这四个问题,现在都还没有答案。
但有一件事已经清楚了:国产算力生态怎么建,从一个纯工程问题,变成了一个生态问题。云栈社区后续会持续追踪这四个变量的变化。
 发表于 前天 21:40
|
查看: 22|
回复: 0


