2026 年 4 月中旬,黄仁勋在访谈中表达了对 DeepSeek 绕过英伟达硬件的担忧。他的原话很直接:DeepSeek 在华为芯片上发布模型的那一天,对美国将是“可怕的结果”。
这话落地时,DeepSeek 的新一代基础模型 V4 已经比原计划推迟了近两个月。外界普遍预期它会适配华为昇腾芯片。4 月 24 日,DeepSeek 发布并开源 V4 系列预览版。华为昇腾计算业务部同期宣布,经过双方“芯模协同”,昇腾超节点全系列产品均已支持 V4。华为还向路透社表示,V4 的部分训练过程也使用了昇腾芯片。
9 月 30 日,DeepSeek 进一步开源面向昇腾平台的全套底层基础设施组件,涵盖算子编程语言编译工具、计算库和分布式通信库——与此前面向英伟达平台的开源版本逐一对应。合作从模型适配推到了支撑训练与推理的底层软件层面。不过 DeepSeek 也承认,高端算力依然是掣肘,V4-Pro 目前的服务吞吐量“十分有限”。要等下半年昇腾 950 超节点批量上市后,Pro 版本的价格才会大幅下调。
黄仁勋口中的“那一天”似乎已经到来。但拆开看,DeepSeek 与国产算力的适配到底走到了哪一步?
推理端的“首日支持”
V4 不是昇腾与 DeepSeek 的首次合作。2025 年 2 月,DeepSeek-R1、V3 等模型已经上线昇腾社区;同年 9 月 DeepSeek 发布 V3.2-Exp 时,华为在发布当天完成适配,并向开发者开源了全部推理代码和算子实现。但彼时昇腾的角色是追随者:DeepSeek 先在英伟达平台上开发和优化,华为工程师再把模型移植到自家芯片上。
到了 V4 这一代,情况变了。DeepSeek 首次将英伟达 GPU 和昇腾 NPU 放进同一个硬件框架,在两个平台上分别完成了细粒度专家并行方案的验证——所谓 EP,就是把混合专家模型中不同的“专家”子网络分配到不同芯片上并行计算。
据华为披露,昇腾 950 通过融合算子和多流并行技术,降低了超长上下文场景下注意力计算和访存的开销,并结合多种量化算法部署 V4 推理。昇腾 A3 超节点也完成适配,还额外提供了一份训练参考实现,供企业在国产硬件上微调 V4。华为的异构计算架构 CANN,也就是昇腾芯片的底层软件栈(自 2025 年 8 月起开源),其团队在 V4 发布当天公开了优化指南、性能数据和部署代码。
美国半导体研究机构 SemiAnalysis 在 6 月发布的独立评估中给出了一个耐人寻味的判断:V4 架构“部分是为昇腾推理协同设计的”。他们还指出,V4 发布首日,仅有英伟达的 CUDA 和华为的 CANN 两套软件栈提供了完整可用的支持。
SemiAnalysis 对昇腾 950 DT 运行 V4-Flash 的性能剖析显示,华为的优化关键词是“重叠”:昇腾芯片将矩阵计算、向量计算与通信并行,把共享专家的计算完全隐藏在路由专家的计算之下。
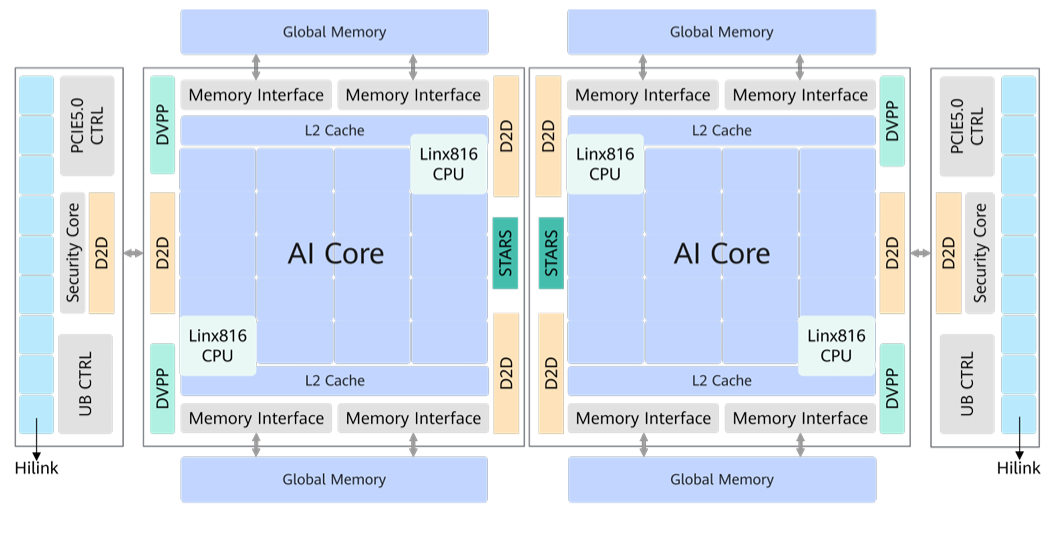
昇腾 950 芯片架构示意图(来源:昇腾社区)
模型一侧也在为“非英伟达硬件”降门槛。V4 用压缩稀疏注意力和重度压缩注意力两种机制组成混合注意力,在 100 万 Token 上下文下,推理所需的计算量只有 V3.2 的 27%,键值缓存只有 V3.2 的 10%。混合专家层的专家权重采用 4 位浮点精度存储。对内存带宽和显存容量都弱于英伟达旗舰的国产芯片来说,这类设计直接放宽了部署条件。
首日适配还有个值得留意的细节:英伟达自研推理引擎 TensorRT-LLM 的融合内核把隐藏层维度写死为 4096,DeepSeek 此前的模型和 V4-Flash 都符合这个数值,但 V4-Pro 的隐藏层维度是 7168,所以跑不起来。工程师最初的处理是删掉报错检查,结果模型在默认配置下静默输出错误结果,直到第三方提交修复,前后耗时一周以上。
同一时间,开源推理框架 vLLM 和 SGLang 在 CUDA 上首日即可正常运行 V4。这两个框架都已有昇腾版本,寒武纪也在发布当天基于 vLLM 完成了对 V4 两个版本的适配并开源代码。北京智源人工智能研究院则宣布其 FlagOS 系统已在包括华为、海光、摩尔线程在内的 8 种以上芯片架构上完成 V4-Flash 的推理部署。
事实上,市场对低成本高效模型已不再意外:V4 位居开源模型第一梯队,却没有明显拉开与 Kimi、Qwen 等国内对手的差距,DeepSeek 也承认依然落后最先进的闭源模型 3~6 个月。
海外对 V4 的评价开始出现偏移。在 Ankura China Advisors 董事总经理阿尔弗雷多·蒙图法尔-埃卢看来,V4 的意义更多在于国家竞争层面。市场研究机构 Omdia 半导体研究总监何辉则指出,昇腾是中国最好的英伟达替代品,对 V4 Day 0 的支持说明顶级中国模型已经可以在中国硬件上运行。
SemiAnalysis 还透露了一个细节:昇腾 950 在华为内部的代号是“大卫”,取自《圣经》中以弹弓击倒巨人歌利亚的少年。华为已经证明自己能在首日掷出石子,但英伟达这个“歌利亚”不会原地踏步。能否击倒后者,仍有待观察。
训练与产能依然是限制
推理端的国产化已经可以验证,但在训练端,DeepSeek 使用国产芯片完成前沿模型预训练的证据依然模糊。这一步的难度也远高于推理。有媒体推测,V4 很可能仍依赖英伟达 GPU 训练,昇腾主要承担与推理更接近的强化学习阶段。
围绕训练芯片,还有两项“捕风捉影”的指控。2025 年 12 月,美国科技媒体 The Information 援引匿名信源称,DeepSeek 通过第三国转运、拆解再组装的方式获得了数千颗英伟达 Blackwell 架构芯片,英伟达和 DeepSeek 均予以否认。2026 年 2 月,路透社援引一名特朗普政府高级官员的说法,称 V4 是用 Blackwell 芯片训练的,DeepSeek 没有回应。
即便缺乏可靠证据,这些说法依然构成了海外舆论理解 V4 的另一条思路——“推理跑在昇腾上”和“训练依赖英伟达”,两者并不互斥。
DeepSeek 在华为芯片上训练受挫早有先例。2025 年 8 月,英国《金融时报》援引三名知情人士报道,R1 发布后,DeepSeek 尝试用昇腾芯片训练下一代推理模型 R2。华为派出工程师团队驻场协助,但由于技术不够成熟、芯片稳定性不足,数月都没能完成一次成功的训练。DeepSeek 最终改用英伟达 H20 训练,只把昇腾用于推理。
V4 的延期也被指与此相关。国内媒体曾指出,由于将训练框架从英伟达迁移至昇腾,DeepSeek 在 2025 年中遭遇过一次较严重的训练失败。V4 原本被普遍预期在 2 月发布,最终推迟到 4 月下旬。
产能则是国产芯片的第二大约束。V4 的专家权重采用 4 位浮点精度,昇腾 950 新增了对这类格式的硬件支持,而 DeepSeek 此前使用的英伟达 Hopper 芯片并不支持该格式。在 V4 系列上,模型设计与昇腾 950 系列的硬件特性高度匹配,V4-Pro 的服务能力和价格将与昇腾 950 的出货量密切挂钩。
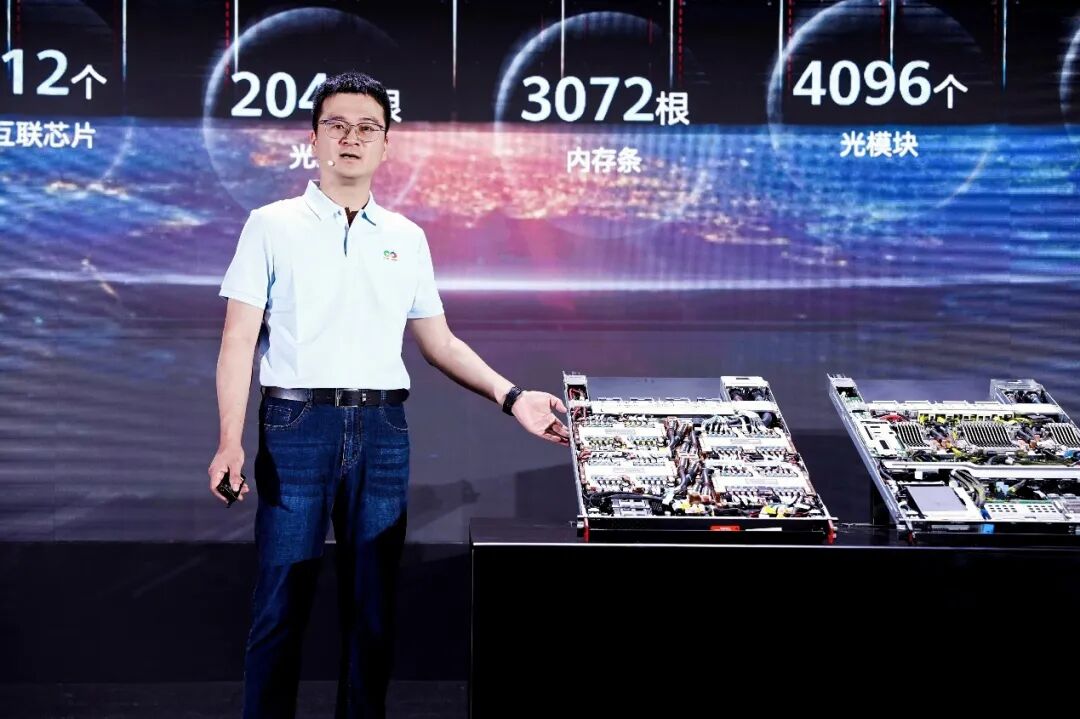
(来源:昇腾社区)
媒体数据显示,华为计划在 2026 年交付约 75 万颗昇腾 950 PR,经性能折算,这相当于美国一周的 AI 芯片产量。9 月初,据彭博社报道,DeepSeek 计划在内蒙古新建的数据中心部署至少 16 万颗昇腾 950 DT,用于运行模型。一名知情人士表示,DeepSeek 目前没有用这批芯片训练模型的计划,部署进度取决于华为的产能。
同月召开的华为全联接大会上,华为轮值董事长汪涛宣布,昇腾 950 超节点已进入规模商用阶段;此前的昇腾 910C 超节点则已部署超过 1000 套。
DeepSeek 想要的不止一家供应商
7 月 7 日,路透社消息称,DeepSeek 正在研发自己的 AI 推理芯片,项目已推进约一年,仍处于早期阶段。DeepSeek 正在与芯片设计、晶圆代工和存储器公司接触。报道指出,研发自有芯片的目的是降低对英伟达和华为两家供应商的依赖。DeepSeek 没有回应置评请求。
这一选择与同行的路径高度一致:今年 4 月,Anthropic 被曝出正在评估自研芯片;OpenAI 在 6 月发布了与博通合作设计的首款定制推理芯片。国内,阿里巴巴、百度同样在推进自研芯片。
模型巨头纷纷下场自研硬件,商业逻辑不难理解:推理是算力需求增长最快、也最直接对应收入的环节。
DeepSeek 的处境则更复杂:自研芯片通常需要数年时间和大量资本,而美国的限制措施既让中国芯片设计公司无法使用最先进的境外晶圆代工产能,也切断了高带宽内存的进口来源。
资本方面,DeepSeek 在 2026 年开启了成立以来的首轮外部融资。英国《金融时报》5 月报道,国家集成电路产业投资基金正在洽谈领投,估值约 450 亿美元,腾讯也参与了谈判。如果消息属实,则进一步证实 DeepSeek 的模型愿景正在与国产芯片绑定。
回头看 V4 的技术选择可以发现,DeepSeek 在软件层面早已为“多硬件”做准备。例如,V4 的底层算子不再完全用 CUDA 编写,而是部分改用领域专用语言 TileLang 描述计算,再编译到不同硬件上;模型在后训练和推理中引入了开放的低精度格式 MXFP4,可适配昇腾、寒武纪、壁仞等国产芯片;为降低专家并行通信等待而开发的融合算子 MegaMoE,也已在昇腾上跑通。
一套能在多种芯片上高效运行的软件栈,确实会降低模型对 CUDA 的依赖,但它同时也在降低对 CANN 的依赖。
不过同期,华为也在加快节奏。9 月的全联接大会上,华为宣布昇腾 960 DT 的发布时间从原计划提前三个季度至 2027 年第一季度,并延续一年一代的芯片迭代节奏。彭博社报道的 16 万颗 950 DT 部署计划如果落地,华为将在相当长一段时间内扛起 DeepSeek 推理算力的主体。
黄仁勋不希望全球 AI 模型按照一套不同于美国的技术栈进行优化,而以 DeepSeek V4 为代表的中国开源模型,正在顶着压力前行。
DeepSeek 与华为的芯模协同已经在推理端兑现了首日支持、官方服务和超节点部署,同时,V4 的技术选择也在为更多替代方案留出空间。对 DeepSeek 而言,昇腾是当下最重要的合作伙伴,但或许并不是唯一的押注。
参考内容:
注:封面/首图由 AI 辅助生成
 发表于 昨天 23:13
|
查看: 8|
回复: 0


