2026年开年至今,AI领域最引人瞩目的现象级项目无疑是OpenClaw。它不仅以惊人的速度在GitHub上登顶,更是催生了一个奇特的新兴市场——OpenClaw上门安装服务。
这让人不禁回想起早年为电脑上门安装操作系统的时代。如今,围绕着这款开源AI智能体的部署服务,报价从几百元一路攀升至上万元,部分服务提供者甚至在短短数日内实现了可观的收入,被不少人戏称为2026年的第一个“技术淘金”风口。
随后,更有志愿者在深圳腾讯大厦外组织了公益装机活动,吸引了大量开发者与爱好者排队参与,场面一度非常火热。
随着OpenClaw的爆火,其安全性与可靠性也引发了官方关注。工业和信息化部网络安全威胁和漏洞信息共享平台发布提示,指出OpenClaw在默认或不当配置下可能存在较高安全风险,开发者需谨慎对待。
那么,对于已经决定使用OpenClaw的开发者而言,一个核心问题随之浮现:究竟选择哪个大语言模型作为其智能体的“大脑”,才能获得最佳的性能与性价比?
近期,一个名为PinchBench的开源AI Agent基准测试系统进入了大家的视野,并专门发布了针对OpenClaw的大语言模型排行榜。该榜单旨在通过一系列真实任务,客观评估不同模型在充当OpenClaw智能体核心时的表现。
从最新的榜单数据来看,在衡量任务完成能力的成功率(Success Rate) 排名中,国产模型表现亮眼。MiniMax的MiniMax-m2.1与Moonshot AI的Kimi-k2.5成功跻身前列,与Google的Gemini-3-flash-preview等国际顶级模型同处第一梯队。
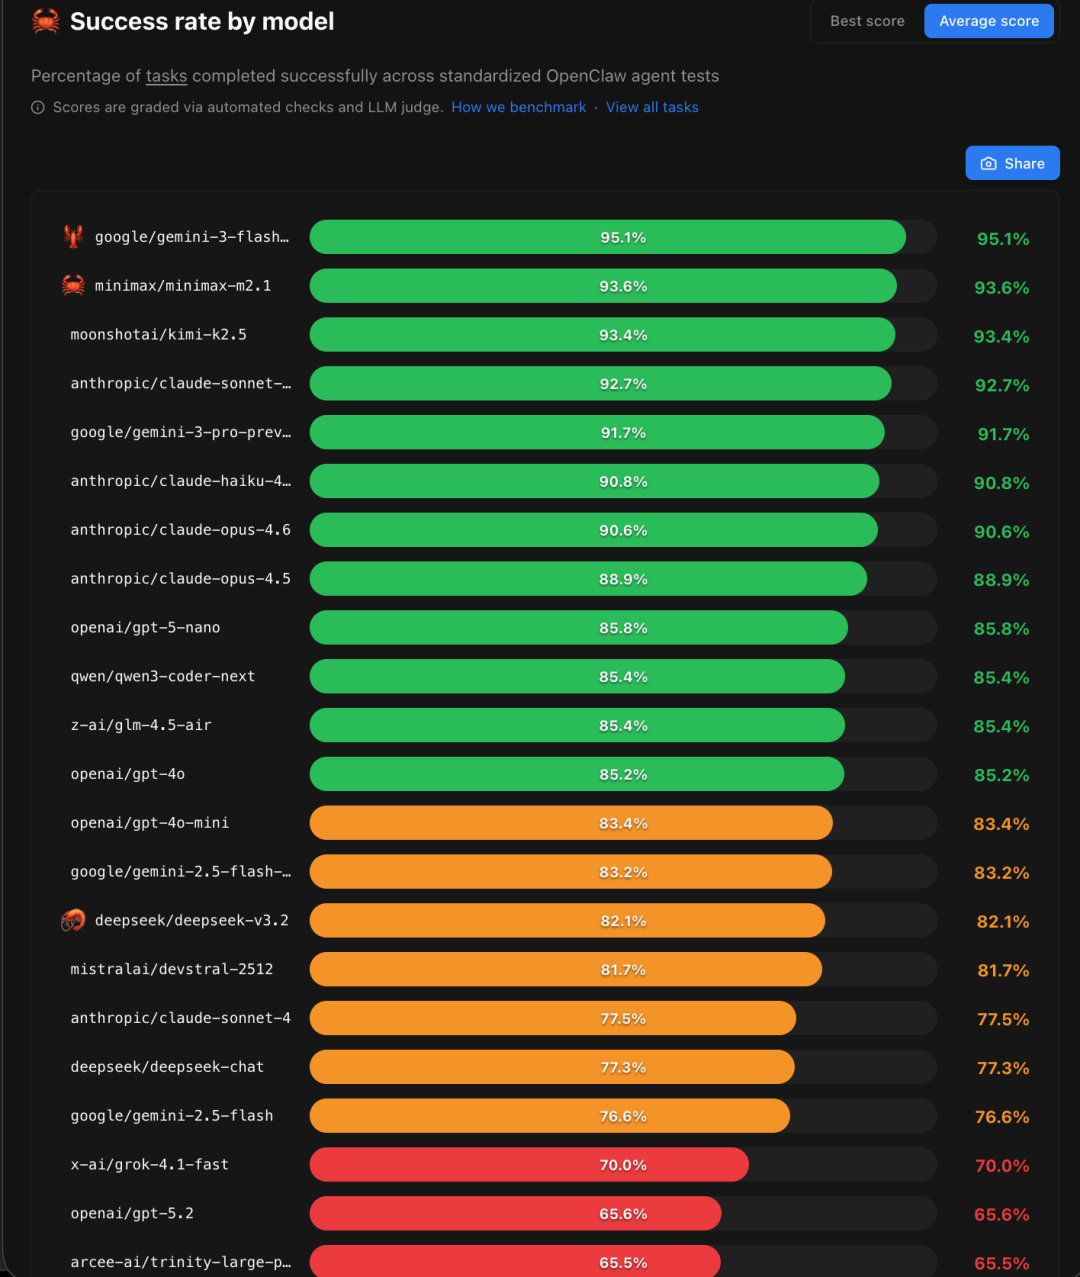
除了成功率,在实际应用中,模型的响应速度和推理成本同样关键。在速度(Speed) 榜单上,MiniMax的另一款模型MiniMax-m2.5位居榜首。而在成本(Cost) 方面,OpenAI的GPT-5-nano以极低的单次任务成本排名第一,国产模型MiniMax-m2.1也进入了成本效益的前列。
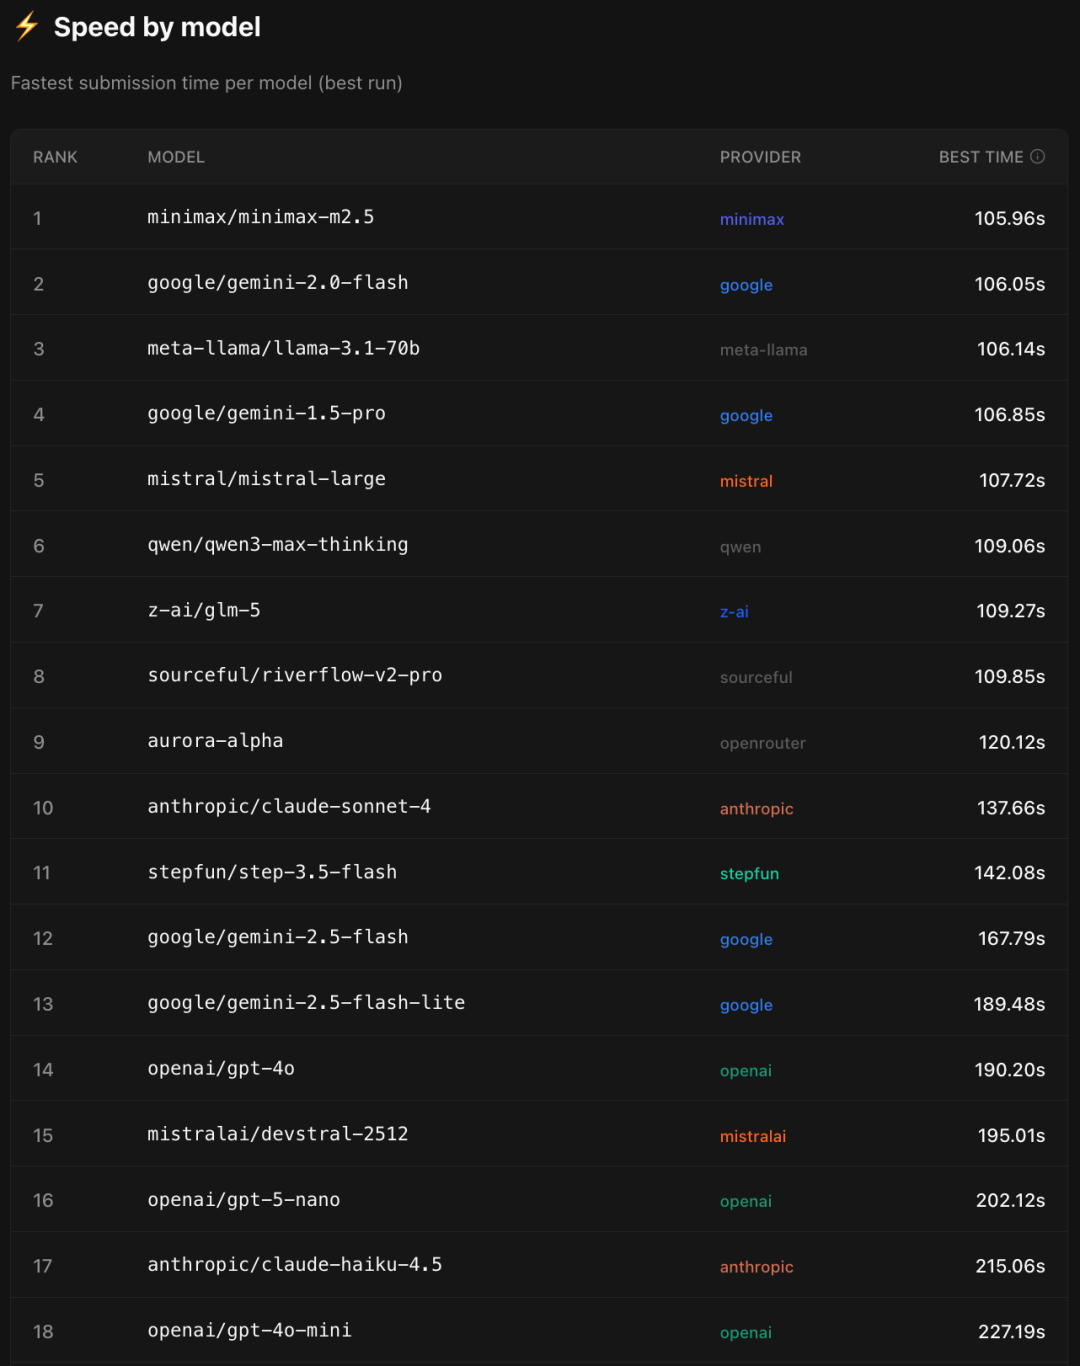
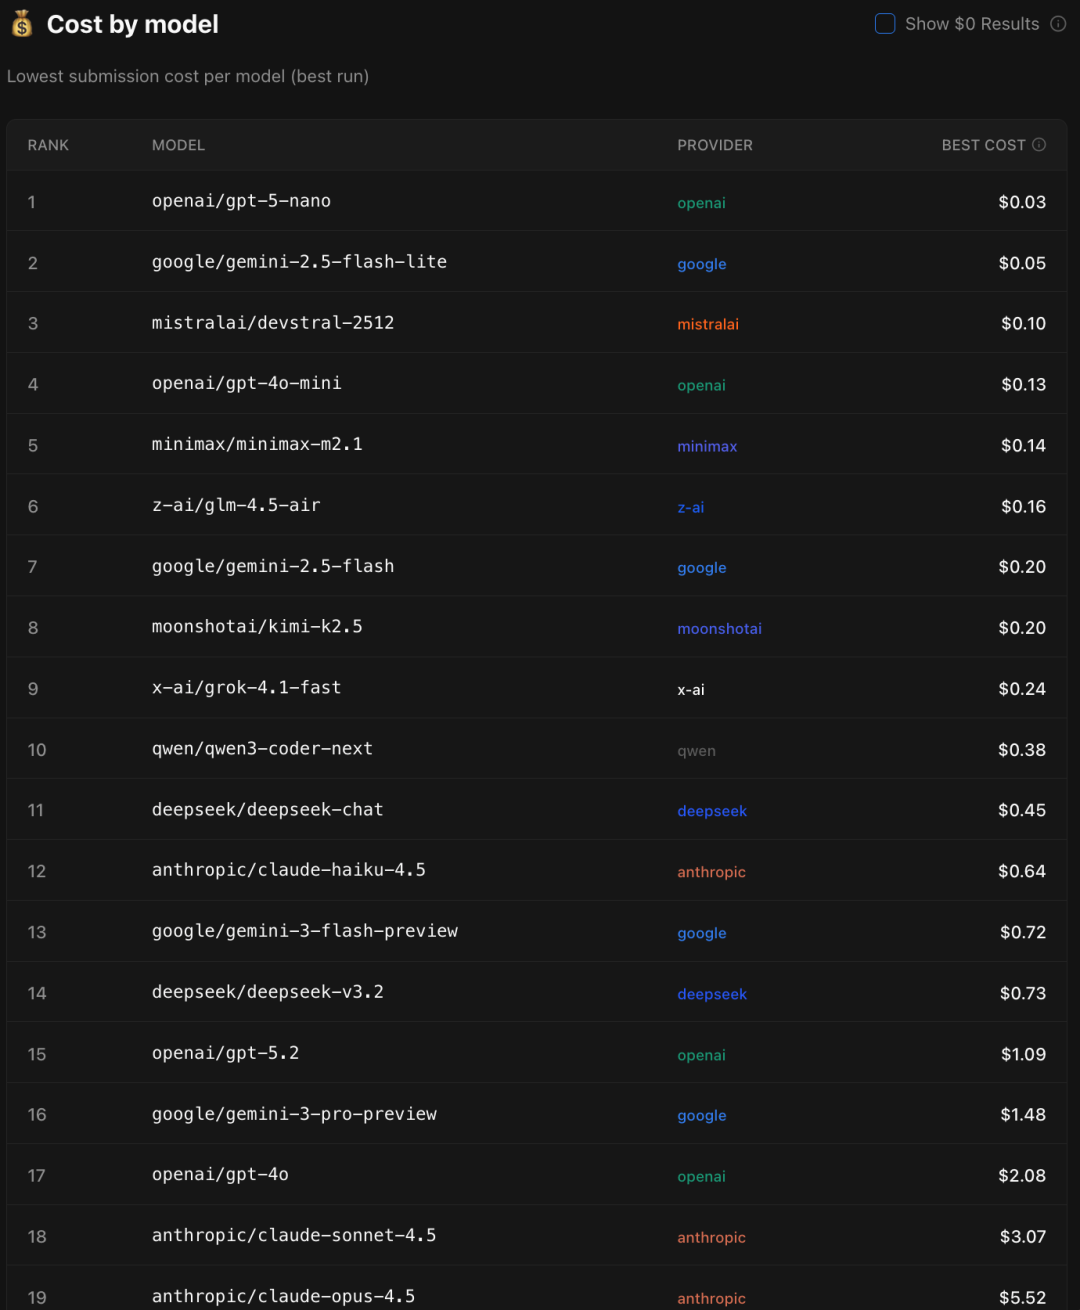
开发者可以访问 PinchBench 官方网站 (https://pinchbench.com/) 查看实时更新的完整排行榜。
PinchBench:如何测评AI Agent?
PinchBench并非简单的模拟测试。它是一个开源的AI Agent基准测试系统,其核心设计理念是让被测试的AI智能体去处理真实的、跨场景的任务,从而更贴近实际应用效果。
评测维度:
- 成功率(Success Rate):智能体成功完成给定任务的比例。
- 速度(Speed):智能体完成整套测试任务所需的最短时间。
- 成本(Cost):运行测试所消耗的模型API费用。
测试任务覆盖:
PinchBench内置了23个真实任务,涵盖多个日常生活与工作场景,具体分类与考核重点如下:
| 类别 |
典型任务示例 |
考核重点 |
| 生产力 |
日历调度、每日总结 |
时间解析、事件创建 |
| 研究 |
股票价格、会议信息、市场分析 |
网页搜索、数据提取、信息综合 |
| 写作 |
写博客、写邮件、人性化润色 |
语气控制、格式排版 |
| 编程 |
天气脚本、文件结构搭建 |
代码生成与文件操作 |
| 分析 |
Excel处理、PDF总结 |
数据处理、文档理解 |
| 邮件 |
收件箱分类、搜索过滤 |
邮件管理能力 |
| 记忆 |
上下文召回、知识管理 |
长时记忆能力 |
| 技能 |
ClawHub技能发现与集成 |
OpenClaw生态融合能力 |
每个任务的最终得分由 自动化脚本检查 和 LLM法官(通常使用Claude Opus) 共同评定,确保了评估的客观性与准确性。
快速上手PinchBench
如果你也想测试自己常用的模型,或者为开源社区贡献自己模型的基准数据,可以按照以下步骤快速开始。
环境要求:Python 3.10+、uv包管理器、一个正在运行的OpenClaw实例。
# 1. 克隆仓库
git clone https://github.com/pinchbench/skill.git
cd skill

# 2. 运行测试(支持任意模型)
./scripts/run.sh --model anthropic/claude-sonnet-4

# 或者指定特定任务套件进行测试
./scripts/run.sh --model openai/gpt-4o --suite task_01_calendar,task_02_stock
若想将自己的模型测试结果提交到PinchBench官方排行榜,只需先运行以下命令注册令牌,后续测试结果便会自动上传:
./scripts/run.sh --register
通过PinchBench这样严谨的基准测试,开发者能够基于真实数据,而不仅仅是宣传参数,来为OpenClaw智能体选择最合适的“大脑”。这对于推动AI Agent技术的实际应用落地至关重要。在云栈社区的开发者广场,也常有关于AI工具选型与实战经验的深度讨论。
 发表于 2026-3-10 10:52:36
|
查看: 279|
回复: 0
 /1


