背景
在高性能的服务架构设计中,缓存始终是一个不可或缺的环节。实际项目里,我们通常会把热点数据放进 Redis 或 Memcached 这类缓存中间件,只有当缓存未命中时才回源查询数据库。这样一来,既提升了访问速度,也减轻了数据库的读写压力。
但随着业务逐渐演进,单纯的远程缓存方案也开始暴露出瓶颈。某些场景下,仅仅依赖 Redis 这类远程缓存已经不够,还需要搭配 Guava Cache 或 Caffeine 等本地缓存来进一步缩短响应时间、提升服务性能。于是,本地缓存作为一级缓存、远程缓存作为二级缓存的两级缓存架构便应运而生。
先忽略并发等复杂因素,两级缓存的基本访问流程可以用下面这张图来表示:
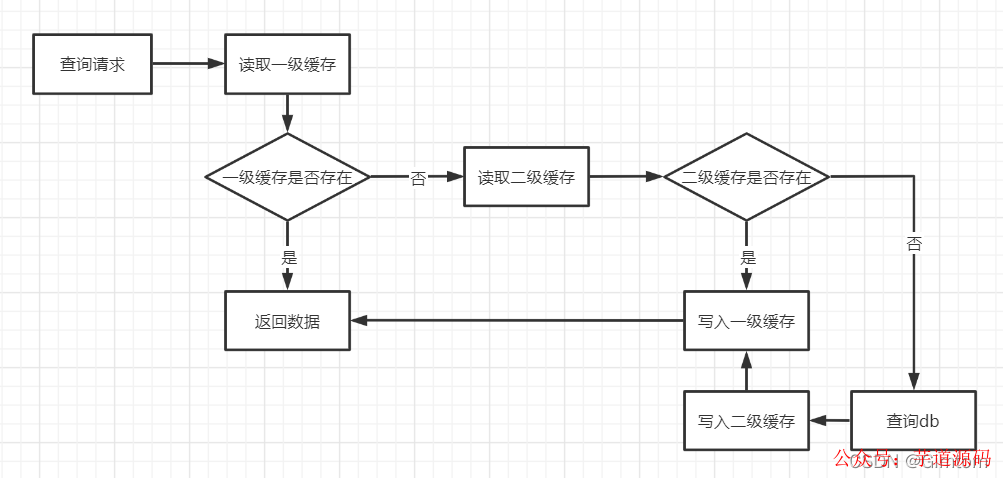
为什么要使用本地缓存
- 本地缓存直接基于进程内的内存,访问速度极快。对于变更频率低、实时性要求不高的数据,放进本地缓存能够显著提升读取效率。
- 使用本地缓存可以有效减少与 Redis 等远程缓存之间的数据交互,降低网络 I/O 开销以及网络通信带来的耗时。
设计一个本地缓存需要具备哪些功能
- 能够存储数据,并且支持读、写操作;
- 保证原子操作(线程安全),比如基于 ConcurrentHashMap;
- 支持设置缓存的最大容量限制;
- 超过最大限制时,有对应的淘汰策略,例如 LRU、LFU;
- 支持过期时间淘汰,如定时、懒式、定期等机制;
- 支持持久化;
- 提供统计监控能力。
本地缓存方案选型
1. 使用 ConcurrentHashMap 实现本地缓存
缓存的本质,其实就是内存中的一个 KV 数据结构,对应到 JDK 里就是线程安全的 ConcurrentHashMap。不过如果直接拿 ConcurrentHashMap 来实现缓存,还需要自行解决淘汰策略、容量上限、过期时间等问题。
优点是实现简单、无需引入第三方包,比较适合简单的业务场景。缺点是一旦需求变多,定制化开发的成本会明显上升,稳定性和可靠性也难以保障。因此,对于复杂场景,建议优先选择成熟的开源方案。
2. 基于 Guava Cache 实现本地缓存
Guava 是 Google 团队开源的 Java 核心增强库,包含了集合、并发原语、缓存、IO、反射等工具模块,性能和稳定性均有保障,应用范围相当广泛。Guava Cache 支持以下特性:
- 支持最大容量限制
- 支持两种过期删除策略(插入时间和访问时间)
- 支持简单的统计功能
- 基于 LRU 算法实现
使用方式如下:
<dependency>
    <groupId>com.google.guava</groupId>
    <artifactId>guava</artifactId>
    <version>31.1-jre</version>
</dependency>
@Slf4j
public class GuavaCacheTest {
    public static void main(String[] args) throws ExecutionException {
        Cache<String, String> cache = CacheBuilder.newBuilder()
                .initialCapacity(5)  // 初始容量
                .maximumSize(10)     // 最大缓存数,超出淘汰
                .expireAfterWrite(60, TimeUnit.SECONDS) // 过期时间
                .build();

        String orderId = String.valueOf(123456789);
        // 获取orderInfo,如果key不存在,callable中调用getInfo方法返回数据
        String orderInfo = cache.get(orderId, () -> getInfo(orderId));
        log.info("orderInfo = {}", orderInfo);

    }

    private static String getInfo(String orderId) {
        String info = "";
        // 先查询redis缓存
        log.info("get data from redis");

        // 当redis缓存不存在查db
        log.info("get data from mysql");
        info = String.format("{orderId=%s}", orderId);
        return info;
    }
}
3. Caffeine
Caffeine 是基于 Java 8 实现的新一代缓存工具,缓存性能几乎接近理论最优值。可以把它理解为 Guava Cache 的增强版,两者功能类似,但 Caffeine 采用了融合 LRU 与 LFU 优点的 W-TinyLFU 算法,因此性能上有明显优势。
使用方式如下:
<dependency>
    <groupId>com.github.ben-manes.caffeine</groupId>
    <artifactId>caffeine</artifactId>
    <version>2.9.3</version>
</dependency>
@Slf4j
public class CaffeineTest {
    public static void main(String[] args) {
        Cache<String, String> cache = Caffeine.newBuilder()
                .initialCapacity(5)
                // 超出时淘汰
                .maximumSize(10)
                //设置写缓存后n秒钟过期
                .expireAfterWrite(60, TimeUnit.SECONDS)
                //设置读写缓存后n秒钟过期,实际很少用到,类似于expireAfterWrite
                //.expireAfterAccess(17, TimeUnit.SECONDS)
                .build();

        String orderId = String.valueOf(123456789);
        String orderInfo = cache.get(orderId, key -> getInfo(key));
        System.out.println(orderInfo);
    }

    private static String getInfo(String orderId) {
        String info = "";
        // 先查询redis缓存
        log.info("get data from redis");

        // 当redis缓存不存在查db
        log.info("get data from mysql");
        info = String.format("{orderId=%s}", orderId);
        return info;
    }
}
4. Encache
Encache 是一个纯 Java 的进程内缓存框架,以快速、精干著称,同时也是 Hibernate 默认的 CacheProvider。与 Caffeine 和 Guava Cache 相比,Encache 的功能更丰富、扩展性更强:
- 支持多种缓存淘汰算法,包括 LRU、LFU 和 FIFO
- 缓存支持堆内存储、堆外存储、磁盘存储(支持持久化)三种方式
- 支持多种集群方案,解决多实例间的数据共享问题
使用方式如下:
<dependency>
    <groupId>org.ehcache</groupId>
    <artifactId>ehcache</artifactId>
    <version>3.9.7</version>
</dependency>
@Slf4j
public class EhcacheTest {
    private static final String ORDER_CACHE = "orderCache";
    public static void main(String[] args) {
        CacheManager cacheManager = CacheManagerBuilder.newCacheManagerBuilder()
                // 创建cache实例
                .withCache(ORDER_CACHE, CacheConfigurationBuilder
                        // 声明一个容量为20的堆内缓存
                        .newCacheConfigurationBuilder(String.class, String.class, ResourcePoolsBuilder.heap(20)))
                .build(true);
        // 获取cache实例
        Cache<String, String> cache = cacheManager.getCache(ORDER_CACHE, String.class, String.class);

        String orderId = String.valueOf(123456789);
        String orderInfo = cache.get(orderId);
        if (StrUtil.isBlank(orderInfo)) {
            orderInfo = getInfo(orderId);
            cache.put(orderId, orderInfo);
        }
        log.info("orderInfo = {}", orderInfo);
    }

    private static String getInfo(String orderId) {
        String info = "";
        // 先查询redis缓存
        log.info("get data from redis");

        // 当redis缓存不存在查db
        log.info("get data from mysql");
        info = String.format("{orderId=%s}", orderId);
        return info;
    }
}
本地缓存问题及解决
1. 缓存一致性
两级缓存与数据库之间的数据如何保持一致?一旦数据发生修改,除了更新数据库,本地缓存和远程缓存也应该同步更新,否则就很容易读到旧数据。
解决方案1:MQ
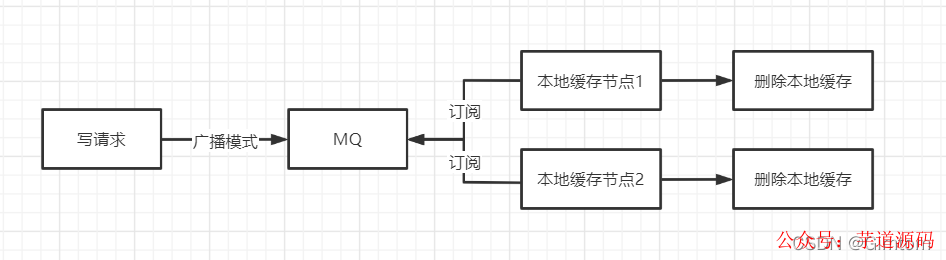
实际部署大多是集群环境,多个节点各自持有本地缓存。借助 MQ 的广播模式,当数据被修改时向 MQ 发送消息,各节点监听并消费消息后删除本地缓存,从而达成最终一致性。
解决方案2:Canal + MQ
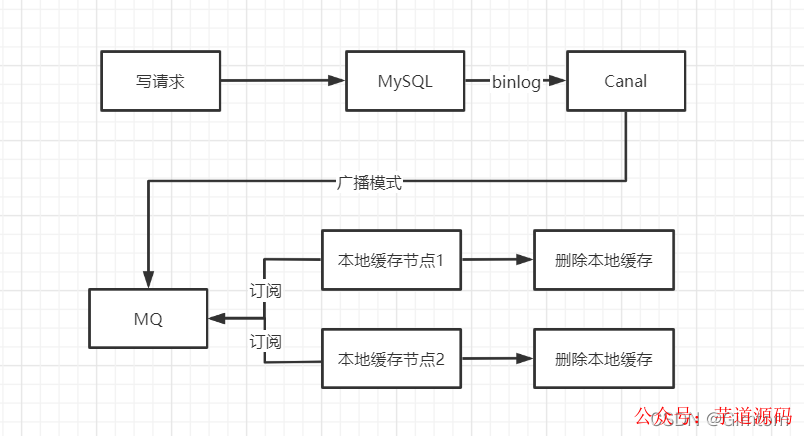
如果不想在业务代码中手动发送 MQ 消息,还可以采用近几年比较流行的方式:订阅数据库变更日志。Canal 订阅 MySQL 的 Binlog 日志,当数据发生变化时自动向 MQ 发送消息,进而实现本地缓存与数据库的一致性。
2. 如何提高本地缓存命中率
关于这一节,核心思路与通用的缓存命中率优化方法一致:合理设置过期时间、区分冷热数据、避免无效缓存写入等。
3. 本地缓存的技术选型问题
- 从易用性来看,Guava Cache、Caffeine 和 Encache 都提供了成熟的接入方案,使用起来都比较简单。
- 从功能性来看,Guava Cache 和 Caffeine 功能相近,均只支持堆内缓存;Encache 的功能则更为丰富。
- 从性能对比来看,Caffeine 表现最优,Guava Cache 次之,Encache 相对最差(下图是三者的性能对比结果)。
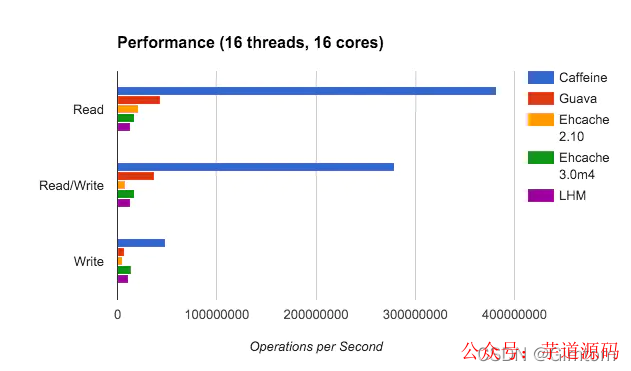
对于本地缓存的方案选择,我更推荐 Caffeine,性能优势相当明显。
虽然 Encache 功能更丰富,甚至提供了持久化和集群能力,但这些功能完全可以借助其他工具实现。在实际业务工程里,建议以 Caffeine 作为本地缓存,再配合 Redis 或 Memcached 作为分布式缓存,构建多级缓存体系,在性能和可靠性之间取得平衡。
 发表于 3 天前
|
查看: 16|
回复: 0


