今天是 2026年9月13日,星期日,北京,天气晴。
继续看技术进展。在之前的文章《再看本体如何增强 Agent 自进化?Agent 用于时序建模任务技术综述》( https://mp.weixin.qq.com/s/uHo-tw9E-heuxG8FvARp9A )中,我们讲了本体增强 Agent。
在《本体论遇上 RAG 本体增强生成是什么?对比 RAG、3 个不同所指及落地选型思路》( https://mp.weixin.qq.com/s/wubKTzzjeg1kwvcqmGhrMw )中,针对 OAG(Ontology-Augmented Generation,本体增强生成)做了一个总结性解读。它是 RAG 的一个变体,但从架构上说,它更是一种责任架构:用本体的强类型约束事实,用工具调用分离概率与确定性,用权限和审计包住行动,最终让“AI 参与业务决策”这件事从责任上变得可接受。
不过最近也在想,社区写零散博客的时期已经过去了,更应该进入写系列丛书的时期。这样能够从各个角度做更好的梳理,也是更有效的总结方式。
周末依旧不休息,迭代 18 个版本,最终形成《本体增强生成 OAG(Ontology-Augmented Generation)—知识、检索与推理的工程化路径》一书。这是一本技术工程参考读物,基于公开论文、标准与 开源 代码撰写,面向知识图谱、本体工程与大模型应用落地的工程人员,约 19.5 万字,75 章。
总的来说,这本书从论文角度、开源项目、案例角度、技术角度等,对从 RAG 过渡到 OAG 做了一次回顾。感兴趣的可以看看。
一、先看 OAG 的提出:从 RAG 到 OAG 的演进路线
RAG 我们其实讲过很多,OAG 到底是怎么一步步走到今天的?它和 Naive RAG、Advanced RAG、Modular RAG、Graph RAG、Agentic RAG 是什么关系?
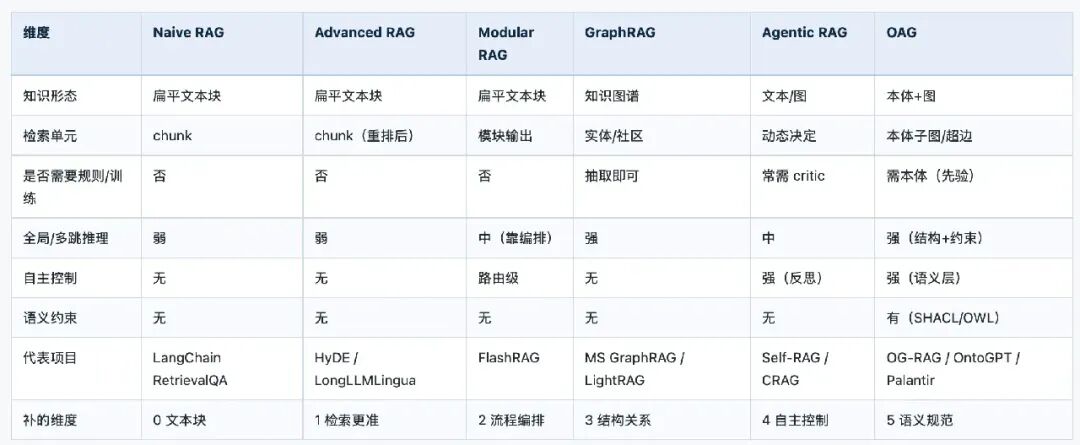
核心论点是:每一代 RAG 都不是凭空发明,而是在补上一代根本缺的那一个维度——从“文本块”到“文本块质量”,到“模块编排”,到“结构/关系”,到“自主控制”,最后到“语义规范”。OAG 不是第七种 RAG,而是把这五个维度的积累,收编到同一套“本体纪律”之下。
RAG 这个词 2020 年才被提出,到 2024–2025 年已经派生出 GraphRAG、Self-RAG、CRAG、Modular RAG、LightRAG、Agentic RAG、OG-RAG 等一大家子。它们不是命名竞赛,每个新名字背后,都是对上一代某个无法回避的痛点的回应。如果用“演进史观”而非“概念罗列”去读,会得到一条有因果的链:
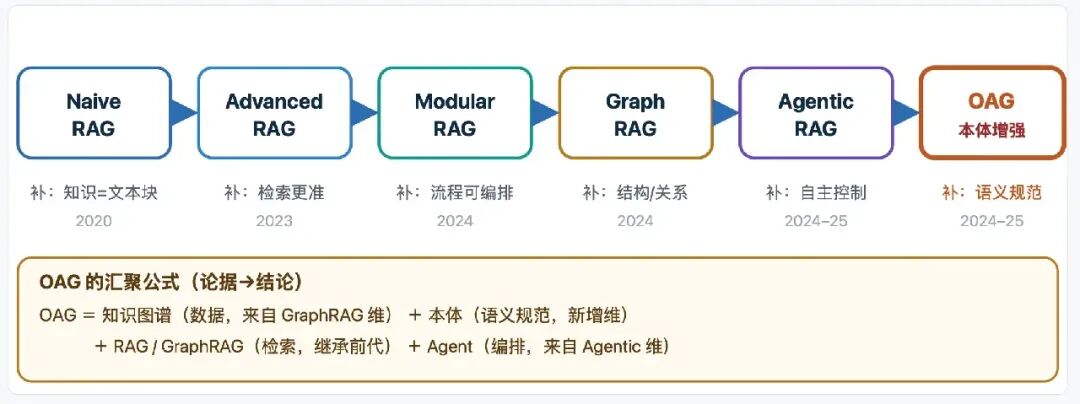
RAG 想用“外部知识”补足 LLM 的“参数化记忆”的不足。但“外部知识怎么组织、怎么检索、怎么被消费”这三件事,从 2020 到 2025 年经历了五轮范式跃迁。每一轮跃迁,都是在给“知识”补一个之前缺失的维度:
维度 0:知识=扁平文本块(Naive RAG)
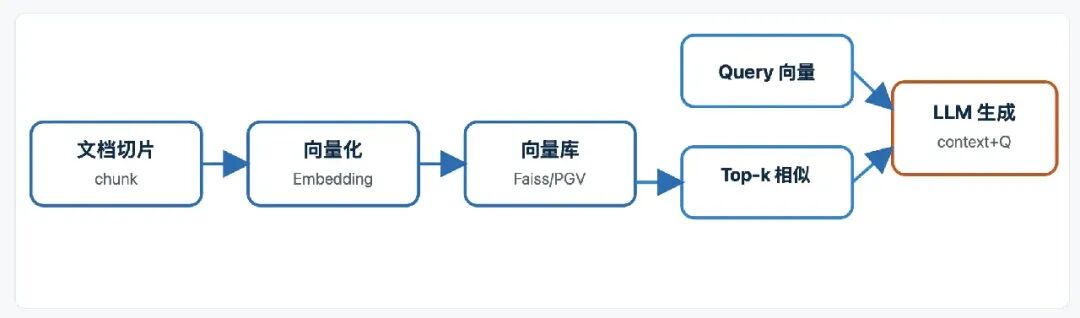
维度 1:文本块要“检索得准”(Advanced RAG 的 rerank/压缩)
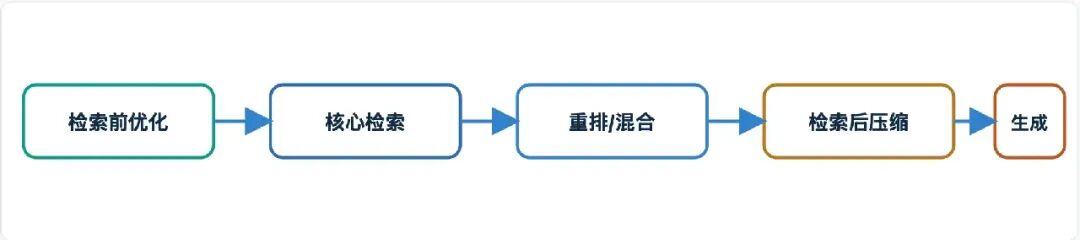
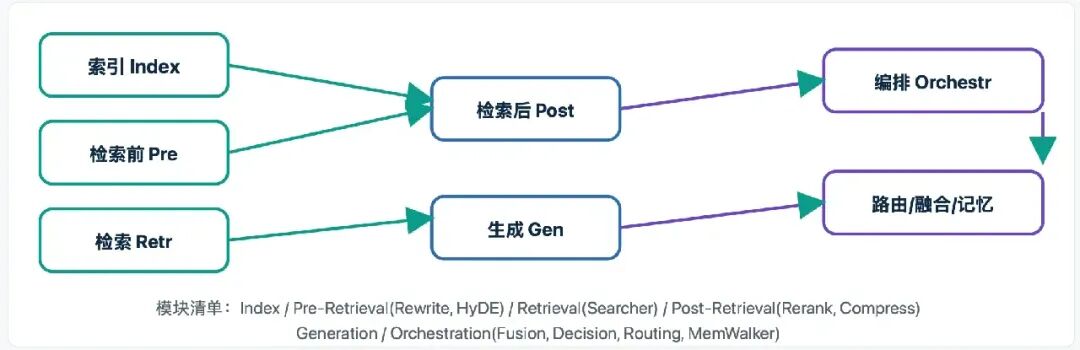
维度 2:检索流程要“可编排”(Modular RAG 的模块 DAG)
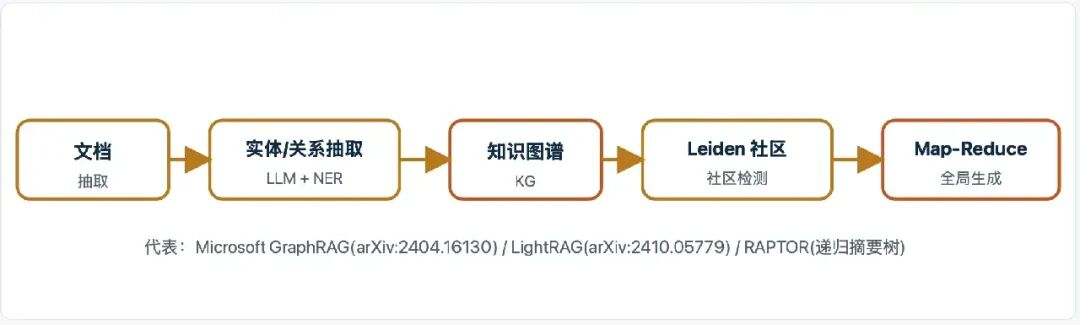
维度 3:知识要有“结构/关系”(GraphRAG 的知识图谱)
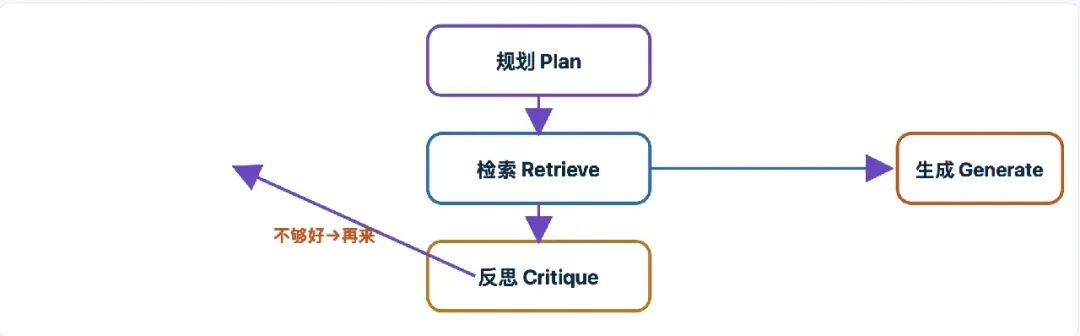
维度 4:检索要“自主决策”(Agentic RAG 的反思/路由)
维度 5:知识要“有语义规范”(OAG 的本体/Ontology)
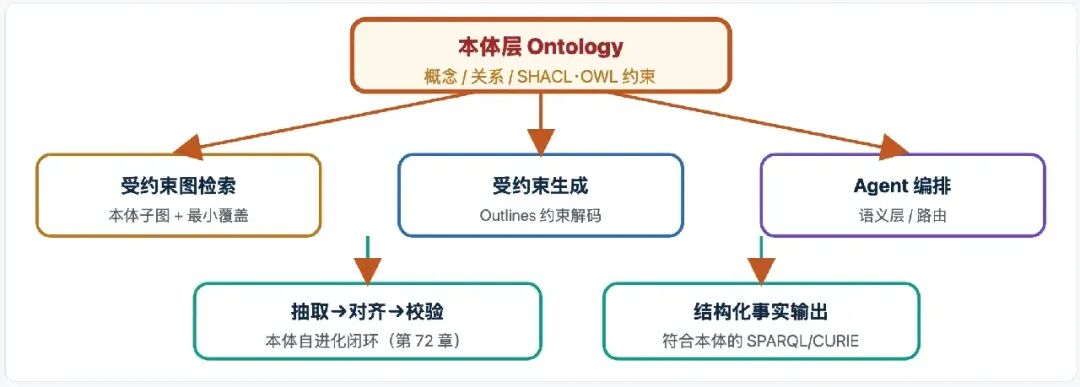
在这里,OAG(Ontology Augmented Generation,本体增强生成)用本体(Ontology)作为知识的规范模式层,它先定义好:领域里有哪些概念(类)、概念间有哪些关系、必须满足哪些约束/公理(SHACL、OWL)。检索与生成都在这套“本体纪律”下进行。
也就是说,OAG = 前五代的汇聚(论据→结论),几个继承:
继承 GraphRAG(维度 3):本体就是“带约束、带先验的图”——比从文本抽取的图更规范、跨域一致。
继承 Agentic RAG(维度 4):本体给 Agent 提供“语义层/操作系统 API”,Agent 在本体的规范上操作。
收编 RAG/Advanced/Modular(维度 0–2):块检索、重排、模块编排仍是 OAG 的底层能力,只是检索单元和生成约束被本体重塑。
新增维度 5(语义规范):检索只在任务相关的本体子图上;文本→概念靠 OAK grounding 回链本体;生成受 SHACL/OWL 约束;本体还能自进化。
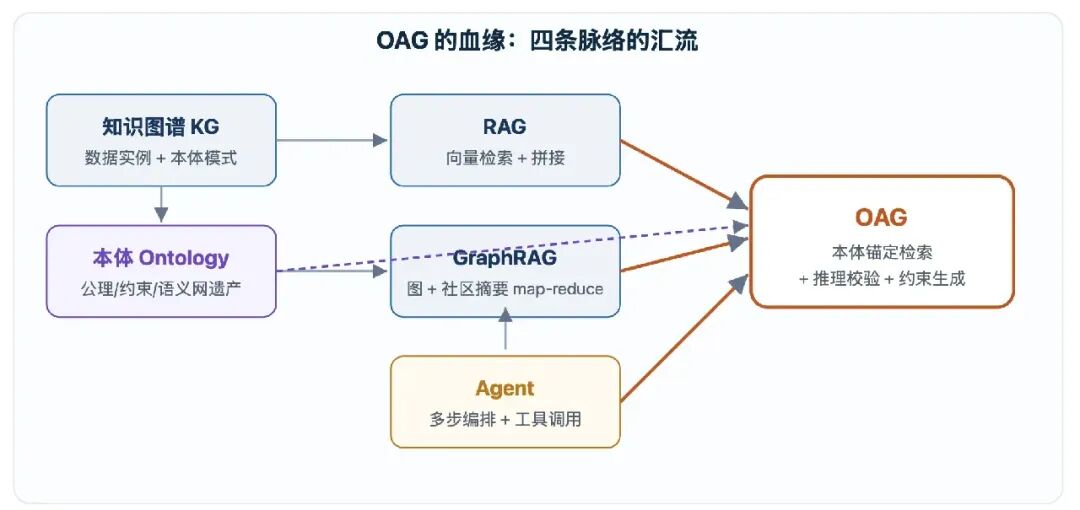
RAG 解决“知识时效/幻觉”,GraphRAG 解决“全局意义建构”,知识图谱/本体解决“结构化与可推理”,Agent 解决“多步编排”。OAG 解决的问题是它们都没解决的那个交叉点:在强结构、强规则、强溯源要求的专业领域,让 LLM 既懂领域语义、又能被公理约束、还能把答案逐条溯源回事实。 它不是替代谁,而是站在四者之上,把“本体”从配角推到了舞台中央。
所以,几个概念的对比,可以汇聚成如下一张表:
但是,随着发展,OAG(Ontology-Augmented Generation,本体增强生成)并不是一个统一的技术。它可以细分为三种实践,三者共享同一个洞察,但技术路径、成熟度、适用场景完全不同。把它们混为一谈,是当下所有关于 OAG 的讨论里最常见的错误。
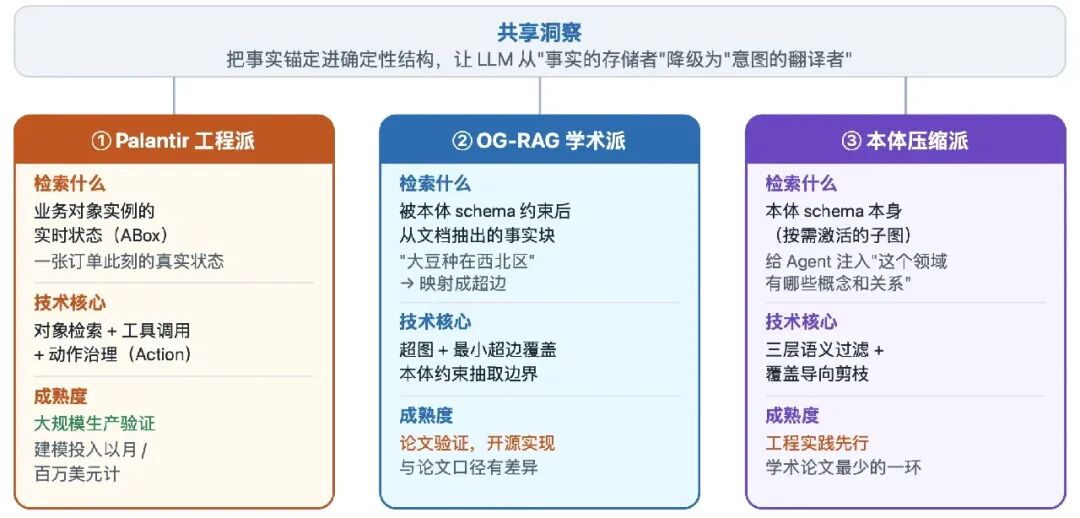
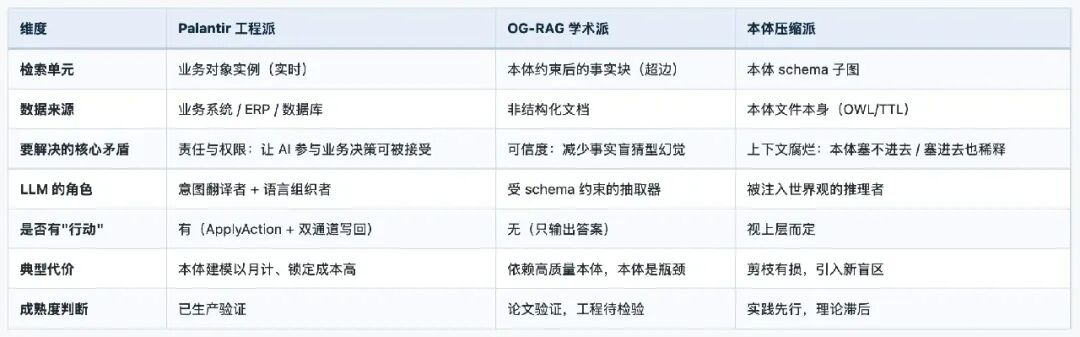
这也正如我们谈本体论时一样,应该区分概念,搞清楚具体所指。
二、OAG 什么时候应该上?上了一定好?
先看一个具体例子。在 OAG 路径下,LLM 被降级为意图翻译者,如下图所示:
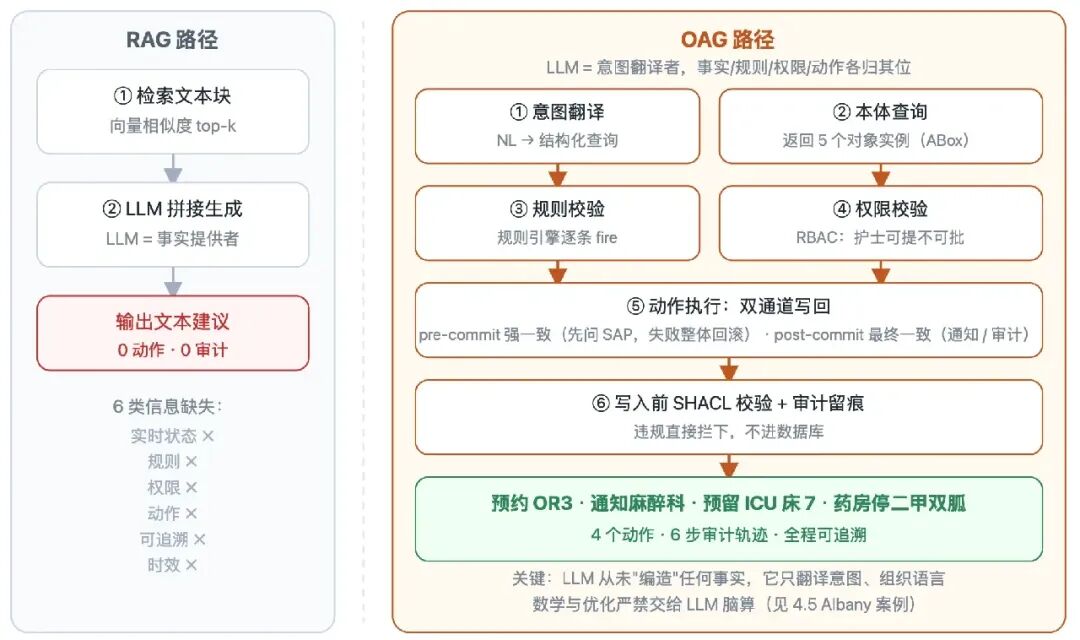
但是,做着做着,又会遇到一个问题:OAG 什么时候应该上?
答案是:OAG 不是普适解。它是一场交换,只有在特定条件下这笔交换才划算。
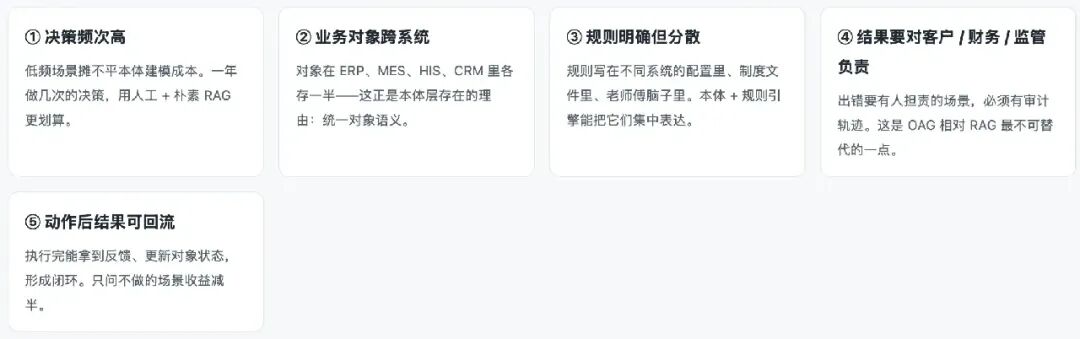
进一步总结,可以得到 OAG 适配度决策矩阵:右上象限才是主战场,左上象限是陷阱。
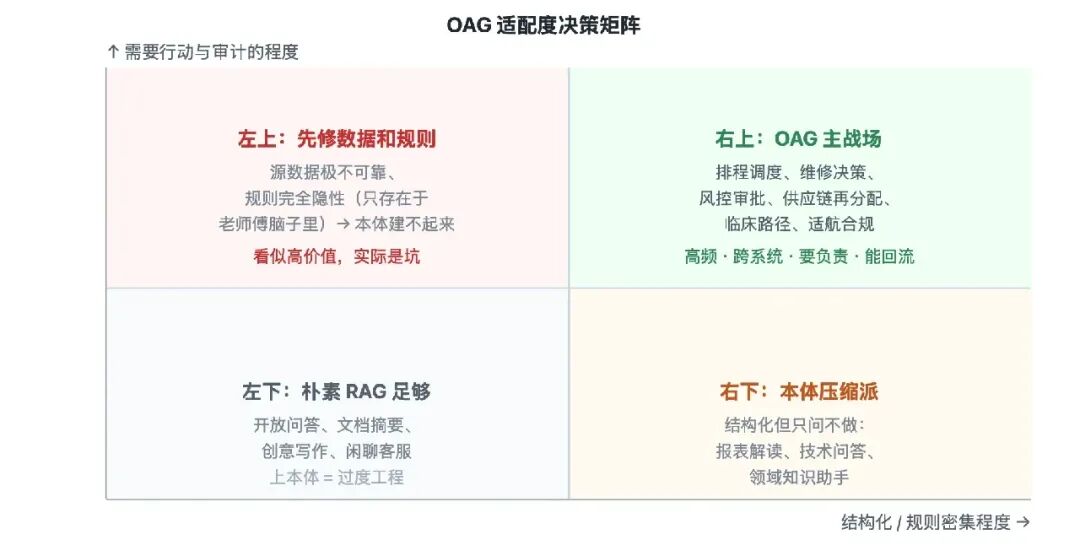
左上象限要单独警告:“看似高价值但源数据极不可靠、规则完全隐性的场景”最容易被误判为 OAG 的绝佳场景,因为业务价值高。但本体是对已达成共识的结构的编码——如果共识本身不存在,本体就成了把混乱固化成 schema,后续所有推理都建立在沙子上。这类场景应该先做数据治理和规则显性化,而不是先上 OAG。
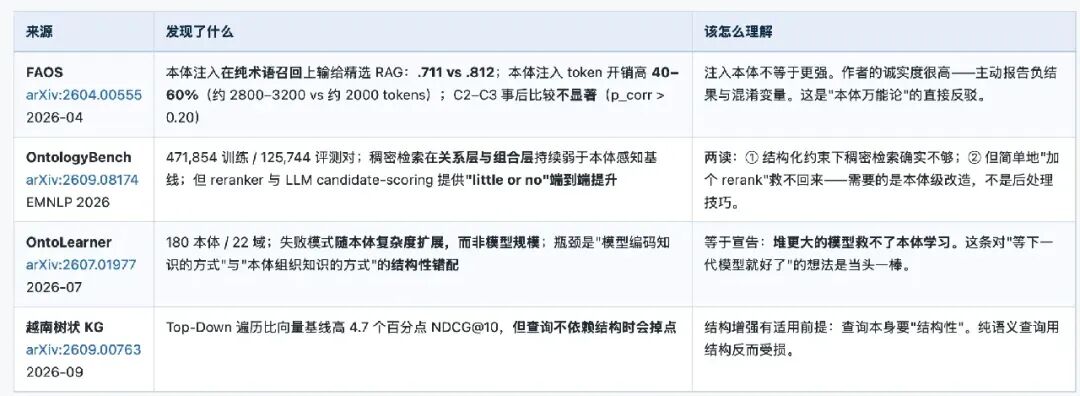
这一点其实是有证据的。2025–2026 年出现了一批主动报告负结果的工作,如下表所示,本体注入并非总是更优:
并且,在此之上,还有很多风险需要考虑,总结为四条:
其一,本体供应链问题。 OG-RAG 论文自认“主要瓶颈是高质量本体需要领域专家”;Palantir 项目前期建模投入以月/百万美元计。没有本体就没有 OAG,而本体构建与演化是纯人力密集环节,没有摩尔定律。
其二,本体演化与漂移。 业务一变,schema 就过时;过时的本体 + 实时的 LLM = 自信地输出过期世界观。压缩派实践者明确承认需要“本体变更后的自动回归测试”,但目前只是方向,不是成熟机制。
其三,世界假设的哲学裂缝。 企业内闭环场景中,封闭世界假设(CWA,缺数据即“否”)成立;一旦走向开放场景,开放世界假设(OWA,缺数据即“未知”)才正确。而主流 OAG 实现全部押注 CWA。假设错配时,系统会把“不知道”当成“不是”,这在风控场景是致命的。
其四,锁定与迁移成本。 本体承载运营现实后,数千逻辑函数依赖其上,换平台的成本随时间单调上升。这是能力,也是枷锁。
 发表于 15 小时前
|
查看: 23|
回复: 0


