前言
本地 AI 模型发展到现在,很多人肯定会好奇:它到底已经发展到什么程度了?
虽然每次新模型发布都会有跑分数据可以参考,但毕竟只是数字。就算分数很高,也不确定实际能不能真正满足开发需求。
最近在 Reddit 论坛上有一个案例,很适合拿来检验当前本地 AI 模型的实战能力。
一张 RTX 3090 + 开源模型,5 小时出一个游戏
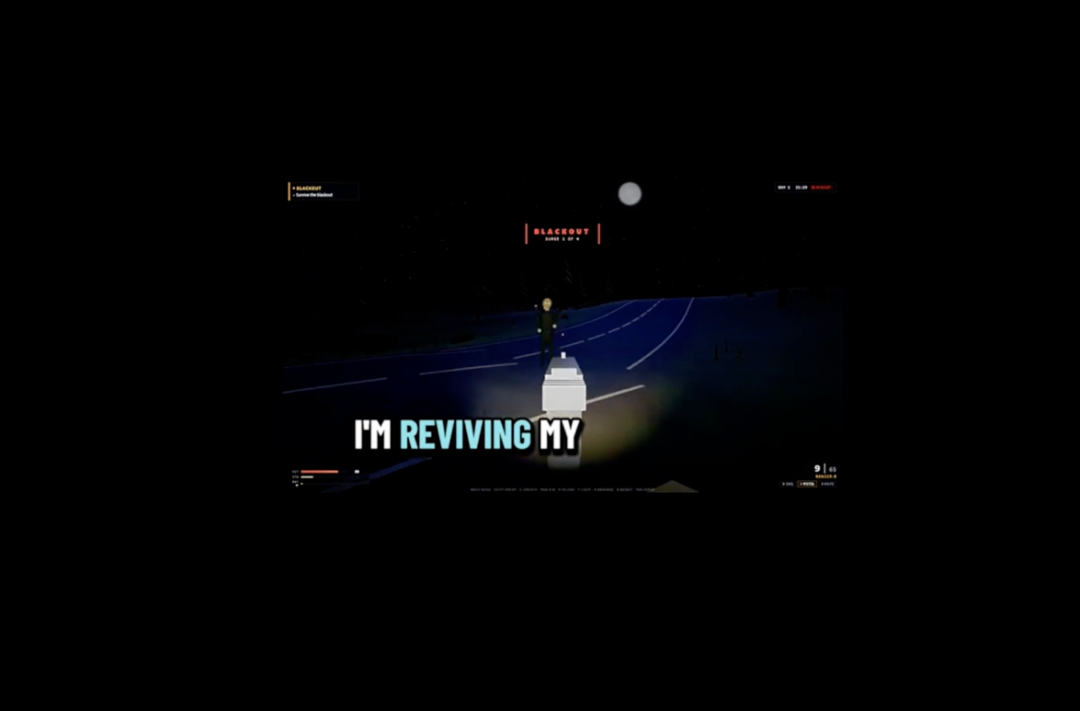
一位网友分享,他用一张 RTX 3090 显卡运行本地 Qwen3.8-27B,花了大约 5 个小时,就做出了一款可以玩的 3D 第一人称僵尸射击游戏。
这也说明一件事:一个人、一张老显卡,再加一个开源模型,不用花钱购买任何 API Token,现在已经能做到这种程度了。
一位 Reddit 网友 EcstaticDentist 最近在 r/LocalLLaMA 分享,他在自己的 RTX 3090 老游戏电脑上运行 Qwen3.8-27B 的 Q4KM 版本——也就是 4-bit 量化版本。
模型文件大小约 16.8GB,结果大约 5 小时就做出了一款第一人称僵尸射击游戏。而且游戏文件也非常小,只有 190MB。
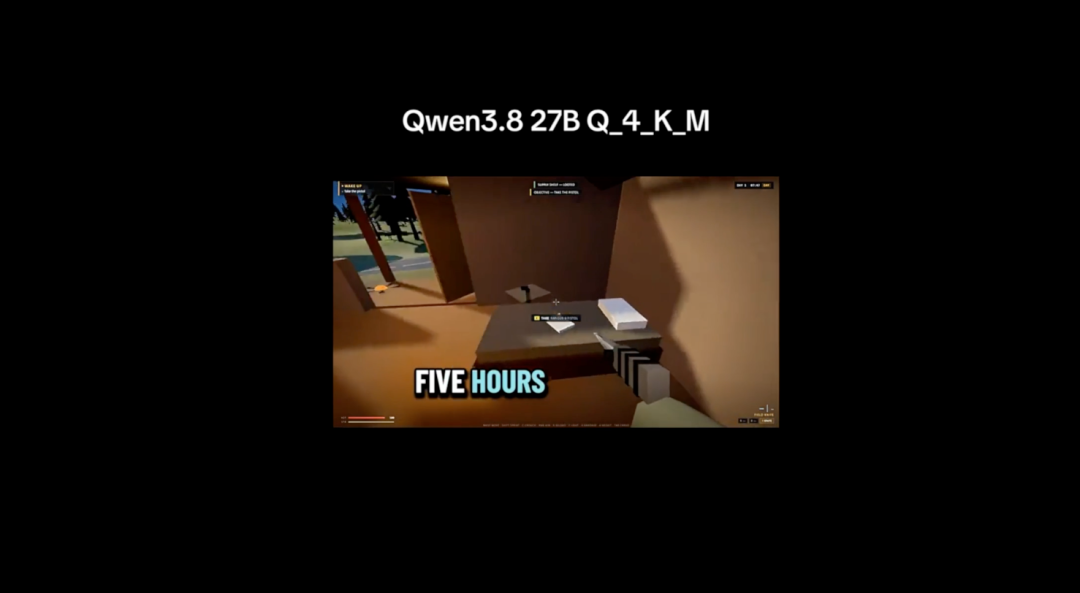
整个过程大约花了 5 小时,用了两套自己配置的代理式编程工具(agentic coding harness),跑的是同一个模型。显卡是 RTX 3090,并通过 MSI Afterburner 超频把性能拉高了大约 12%,使用的量化版本正是 Q4KM。
他表示,这纯粹就是为了好玩,主要是想让大家看看“Q4KM 版 Qwen3.8-27B 的性能和能力接近上限时,做出来的项目是什么样”。
之后他还打算把整个项目放到 GitHub 开源,甚至邀请大家“只用本地模型迭代”,一起继续修改。
不是一句 Prompt 就完事
当然,这款游戏并不是靠一个提示词就做完了。他在留言中补充,每一轮 session 大约需要一个小时,中间还会加入一些人工指导。
第一轮生成的版本问题很多,角色直接卡在整张地图下面,完全动不了。后面几轮才陆续把玩家碰撞、移动操作、光影这些问题一个个修好。
他还强调,整个游戏“完全靠强力提示词写出来”,没有手动修改代码。
提示词别自己写,让模型帮你写
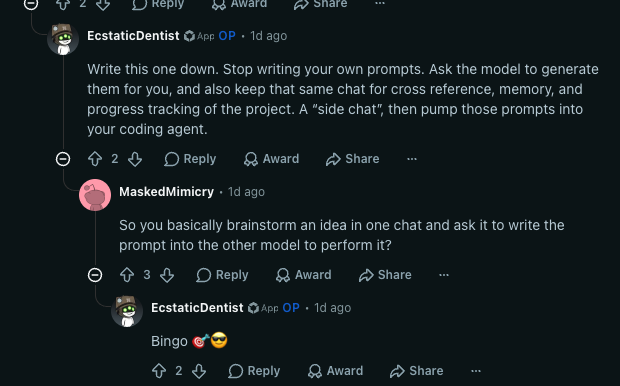
至于提示词怎么下,他还分享了一个挺反直觉的技巧:别自己写提示词,而是让模型帮忙写。
具体做法是另外开一个“侧边对话”,在里面和模型讨论想做什么,让模型生成完整的提示词。同时这个对话还可以用来记录项目进度、充当项目记忆。然后再把生成好的提示词交给编程代理执行。
简单来说,就是“一个对话负责当导演,另一个模型负责写程序,自己负责中间协调和测试”。
这个思路其实和现在很多人在用的工作流不谋而合:与其绞尽脑汁想一句完美 Prompt,不如让模型自己先整理需求、拆解任务。尤其是在需要调用 模型 API 做自动化链路的时候,前置的“需求对话”能明显减少后续返工。
量化版本差异实测
至于这款游戏到底用了什么引擎或框架,原作者并没有特别说明。从成品来看,推测可能是用 HTML、JavaScript 等网页技术做出来的。
也有网友认为很可能就是 JavaScript 作品——毕竟现在 LLM 写网页程序已经相当成熟了。相比之下,真正用来开发 Unity、Godot 或 Unreal Engine 项目的案例还是比较少。
留言里也有人分享了使用不同量化版本制作同一款小游戏的实测结果:
- Q3 版本大约思考了 1.5 小时,才做出一个很差的 Flappy Bird 仿作;
- Q4 大约 45 分钟;
- Q5 只需要 20 分钟,而且质量明显好很多;
- 到了 Q6,暂时就没再看到明显差异。
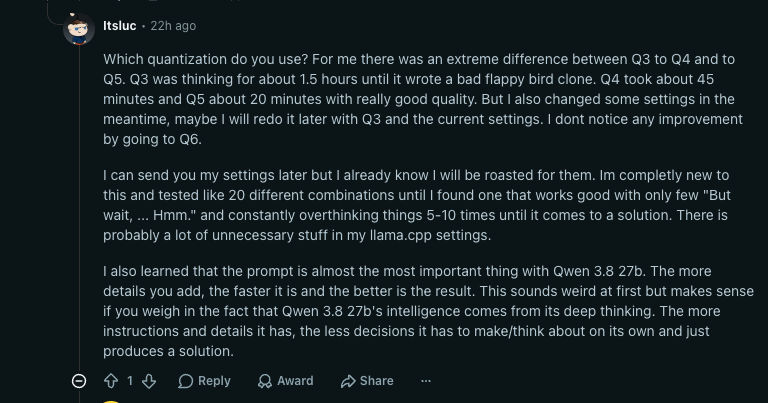
他还提到,Qwen3.8-27B 对提示词细节非常敏感,描述越完整,运行速度反而越快。这听起来有点反直觉,但如果考虑到 Qwen3.8-27B 的“智能”很大程度来自其深度思考过程,就好理解了:指令和细节越多,模型需要自行权衡的决策就越少,反而能更快地产出方案。
从跑分数字到真实做出一款能玩的游戏,这个案例算是给本地模型的能力边界提供了一个相当直观的参考。一个人、一张老卡、一个开源模型,不管最终成品有多粗糙,至少门槛已经降到了一个前所未有的位置。
 发表于 1 小时前
|
查看: 6|
回复: 0


