一个进程,同时是一个对象存储,也是一个 Iceberg REST Catalog。
AWS 把它卖到 30 万美元/年,MinIO 把它锁进企业版;国产 RustFS 却直接开源了。
这篇文章会把 S3 Table 的架构、原理、并发安全三件套一次性拆清楚。看完你甚至可以直接用 Docker + PySpark 跑通一个最小环境。
一、先回答 3 个问题:S3 Table 到底是什么?
- S3 Table 是什么? —— AWS 在 2024 年推出的一种「对象存储 + 表格式」融合服务,让 S3 直接对外讲 Apache Iceberg REST Catalog 协议。
- 它跟普通 S3 有什么区别? —— 普通 S3 只懂 put / get 对象,S3 Table 还懂表、懂 schema、懂快照、懂事务。
- 它跟 MinIO 的 Iceberg 支持有什么区别? —— MinIO 的 Iceberg REST Catalog 在企业版里;RustFS 直接开源,免费用 Apache 2.0 协议。
一句话:S3 Table = 对象的存储 + 数据湖的元数据 + 数据仓库的查询,三位一体。
二、整体架构:一个进程,两个协议
这是理解 S3 Table 最关键的一张图:
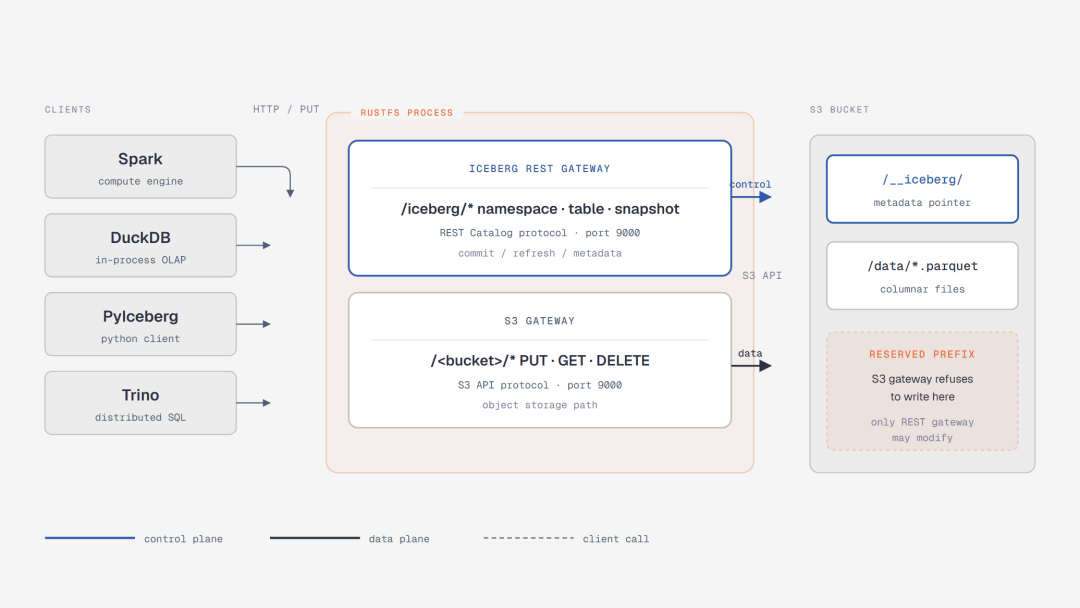
把图记清楚:
- 左侧:用户侧,Spark / DuckDB / PyIceberg / Trino 都可以。
- 中间:一个 RustFS 进程,同时开两个端口、说两种语言。
- 右侧:S3 桶 + 元数据指针 + Parquet 数据文件。
一个进程 = 一个对象存储 = 一个 Iceberg REST Catalog。
这件事在传统数据湖里,至少需要 HDFS + Hive Metastore + Spark + YARN + Zookeeper 五个进程协作。
三、控制面 vs 数据面:为什么一定要分开?
S3 Table 把读写拆成了两条独立通路:
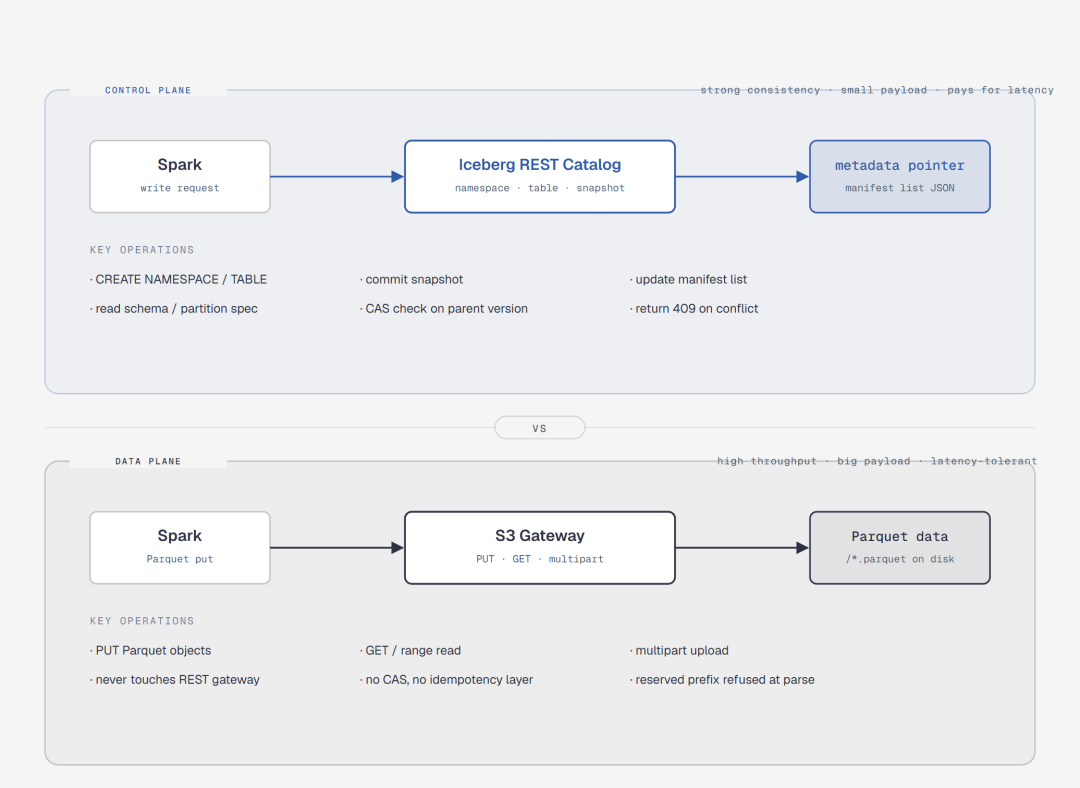
- 控制面(蓝色箭头):Spark 发「我要建一张表」或「提交一个快照 v3」 → Iceberg REST Catalog → 写元数据指针。
- 数据面(紫色箭头):Spark 把 Parquet 文件直接 put 到 S3 → RustFS 的 S3 网关 → 落盘。
为什么这么拆?
因为元数据要强一致(小、慢、贵),数据要高吞吐(大、快、便宜)。
强塞一起,系统就要么慢、要么贵、要么挂。
控制面的关键操作:
- 创建 namespace / 创建表 → 写元数据 JSON
- 提交快照(snapshot)→ 更新 manifest list
- 读取 schema / partition spec → 直接读元数据文件
数据面的关键操作:
- put / get Parquet 文件 → 走 S3 API
- 不经过 Iceberg REST → 性能拉满
四、并发安全三件套:CAS + 幂等键 + 保留前缀
数据湖最怕的不是写慢,而是两个引擎同时写、互相把对方的元数据覆盖掉。S3 Table 用三招解决:
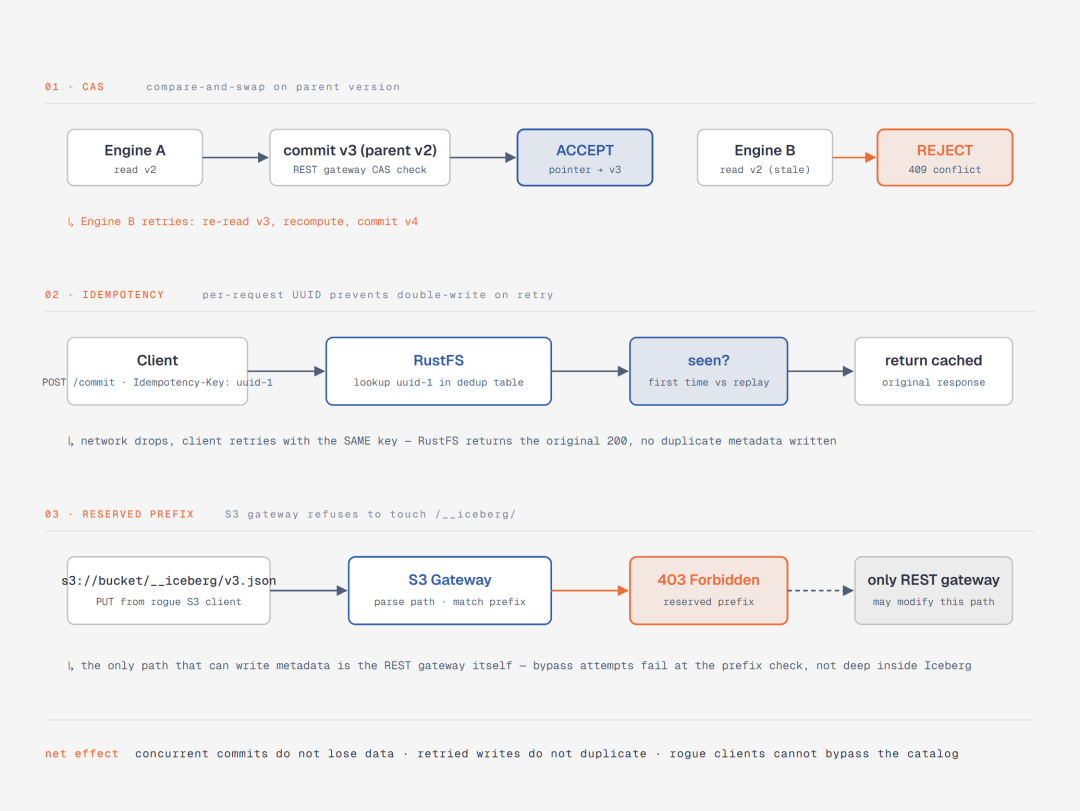
第一招:CAS(Compare-And-Swap)
引擎 A 提交 v3(基于 v2)→ 接受 → 元数据现在是 v3
引擎 B 也提交 v3(基于 v2)→ 拒绝 → 引擎 B 重新读最新版本 v3 → 再提交
类比 Git:
git pull
git push    # 别人已经 push 过,被拒绝
git pull
git push    # 这次成功
第二招:幂等键(Idempotency Key)
客户端每个写请求都贴一个唯一 ID(比如 UUID)。
RustFS 看 ID:哎这个我处理过了,直接返回成功结果,不重复写。
类比 HTTP:
POST /commit  Idempotency-Key: abc-123
# 网络抖动,客户端重试
POST /commit  Idempotency-Key: abc-123
# 服务端直接返回上次结果,不会写两次
第三招:保留前缀(Reserved Prefix)
元数据文件放在 s3://bucket/__iceberg/ 下,只有 Iceberg REST 网关能改。
S3 网关看见这个前缀,直接拒绝。
类比 Linux:
chmod 700 /etc/shadow
# 只有 root 能改,普通用户连看都别想
三招合起来的效果:
- 并发写入不会丢(CAS 兜底)
- 网络重试不会重(幂等键兜底)
- 恶意 S3 客户端不能绕过 Iceberg 偷偷写(保留前缀兜底)
五、对比:传统数据湖 vs S3 Table
直接看这张对比图:
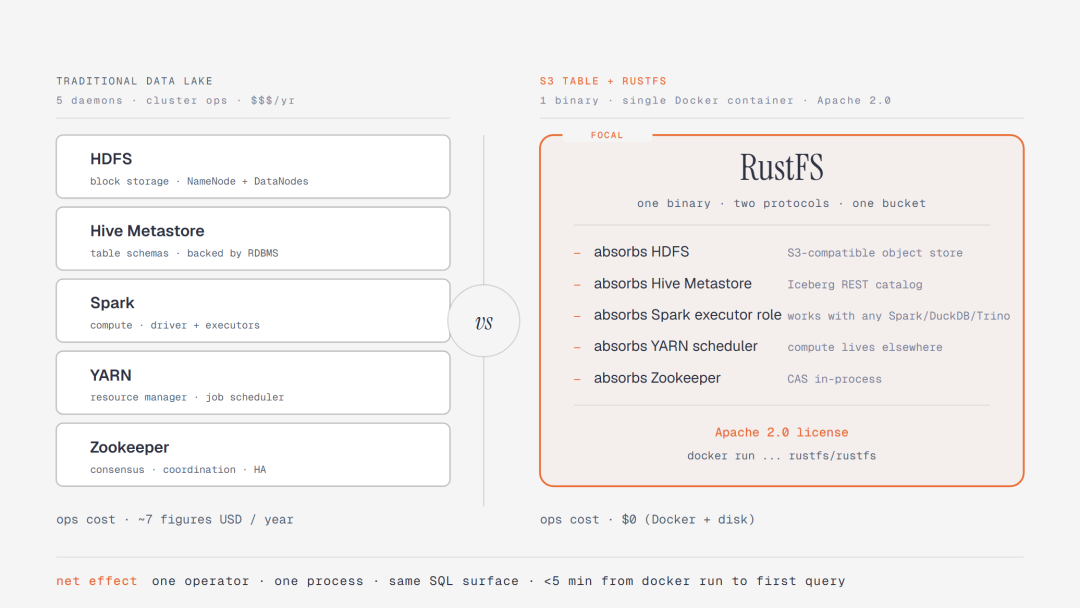
传统数据湖要 5 个组件:
- HDFS(存数据)
- Hive Metastore(存元数据)
- Spark(计算)
- YARN(调度)
- Zookeeper(一致性)
S3 Table 只要 1 个组件:RustFS。
把差异拆开看:
- 进程数:传统 5+ 个,S3 Table 1 个
- 协议:传统用 HDFS RPC + Thrift,S3 Table 用 S3 + Iceberg REST
- 一致性:传统靠 Zookeeper 协调,S3 Table CAS 自带
- 部署:传统要集群化运维,S3 Table 单进程 Docker
- 成本:商业版百万级,S3 Table Apache 2.0 免费
简单说:以前要一个小团队运维,现在一个人 5 分钟就能跑起来。
六、5 分钟跑起来:Docker + PySpark 体验 S3 Table
RustFS 官方给了完整脚本,直接 copy:
Step 1:启动 RustFS(带 S3 Table)
docker run -d \
  --name /workspace/rustfs \
  -p 9000:9000 \
  -p 9001:9001 \
  -v /workspace/rustfs/data:/data \
  rustfs/rustfs:latest
Step 2:PySpark 写一张表
from pyspark.sql import SparkSession

spark = SparkSession.builder \
    .appName("s3-table-demo") \
    .config("spark.sql.catalog.demo", "org.apache.iceberg.spark.SparkCatalog") \
    .config("spark.sql.catalog.demo.type", "rest") \
    .config("spark.sql.catalog.demo.uri", "http://localhost:9000/iceberg/") \
    .config("spark.sql.catalog.demo.warehouse", "s3://demo/") \
    .config("spark.sql.catalog.demo.s3.endpoint", "http://localhost:9000") \
    .config("spark.sql.catalog.demo.s3.access-key-id", "rustfsadmin") \
    .config("spark.sql.catalog.demo.s3.secret-access-key", "rustfsadmin") \
    .getOrCreate()

spark.sql("CREATE NAMESPACE demo.db")
spark.sql("""
    CREATE TABLE demo.db.users (
        id BIGINT,
        name STRING,
        age INT
    ) USING iceberg
""")

spark.sql("INSERT INTO demo.db.users VALUES (1, 'Python 小甲鱼', 18)")
print("写表成功,去 S3 桶里看 .parquet 和 metadata/ 目录")
Step 3:验证
- 访问 http://localhost:9001 看 WebUI
- 进
s3://demo/db/users/ 看 metadata/ 目录下的 version-hint.text
- 用 PyIceberg 直接读:
from pyiceberg.catalog import RestCatalog
cat = RestCatalog("demo", **{"uri": "http://localhost:9000/iceberg/"})
tbl = cat.load_table("demo.db.users")
print(tbl.scan().to_arrow())
整个过程从 docker run 到看到第一行数据,真实测试 5 分钟不到。
写在最后
S3 Table 这件事,AWS 当年拿出来的时候,整个数据湖圈都沸腾了。因为它真正解决了一个老大难问题:
对象存储和数据湖元数据,能不能不要分开两个系统?
答案本来是“不行”,现在 RustFS 用一个进程、两个协议,直接开源了出来。
如果你也在做数据湖、AI 训练集管理、向量数据库,S3 Table + RustFS 这一套,值得你花一个下午跑一跑。
 发表于 2 小时前
|
查看: 3|
回复: 0


