LinkedIn 最近披露了其 AI 驱动型职位搜索背后的训练基础设施,核心是一条多教师蒸馏流水线——把大型教师模型中的知识压缩进一个只有 6 亿参数的排序模型。真正的亮点并不在于蒸馏技术本身,而是一整套让蒸馏速度足以支撑快速迭代的系统工程,例如基于 SGLang 构建的定制框架,可以直接在训练循环里为教师模型提供推理服务。
要训练一个小语言模型(SLM)来改善点击、申请等相关性与互动指标,每个训练样本都免不了要查询一个甚至多个大型教师模型。问题来了:教师模型的在线服务会明显拖慢训练节奏。以 LinkedIn 为例,其排序系统每秒必须处理数十万次查询,延迟一旦上来,整个流程就会卡成瓶颈。许多搜索和推荐团队都卡在同一个坎上——如何从关键词驱动系统顺畅过渡到大语言模型监督的统一排序器。
LinkedIn 基于 SGLang 搭建了一套多教师蒸馏框架。框架能够加载并服务于不同规模的教师模型,同时管理张量并行与数据并行配置。训练期间,异步客户端向教师模型发起请求,处理返回结果,再把这些结果注入蒸馏损失。团队把这套流程称作在线多教师蒸馏。通过在多节点上部署教师模型的本地副本,蒸馏速度提升了 3 倍,同时延迟保持在较低水平,快速迭代由此成为可能。不过在线查询有服务开销,重复计算也是一种浪费。于是 LinkedIn 又引入离线多教师蒸馏:提前算好教师模型的输出,结果落盘到 HDFS 或 NFS,训练时直接读取,不再实时查询教师模型。
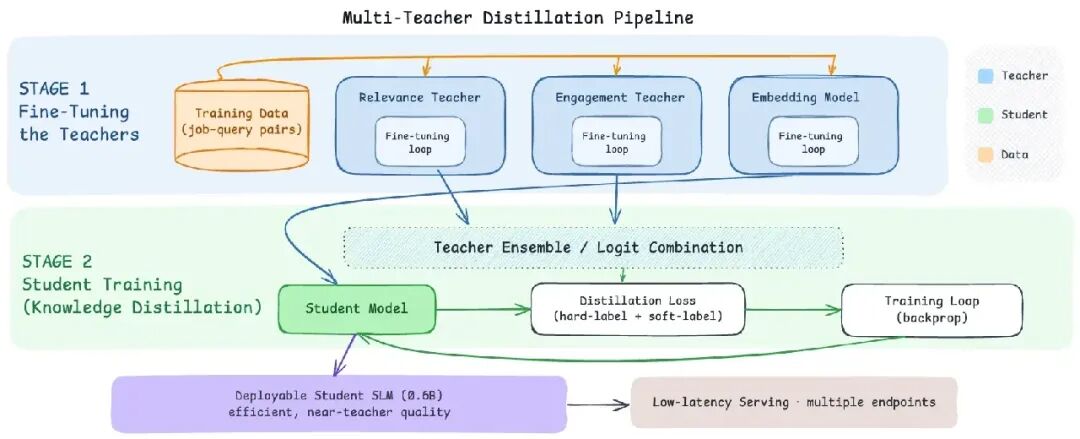
教师模型与学生模型训练的完整流水线
在线与离线组合拳之外,训练层还叠加了更广泛的优化技术栈:LiGer 降低内存占用,批次大小扩大到原来的 2 倍;多节点训练进一步实现最高 3.5 倍加速;FSDP2 再贡献约 20% 的性能增益;换用 H200 多节点集群后,额外再提升最高 30%。
团队还评估过 FP8 混合精度,结论很明确:对参数量低于 80 亿的模型来说,FP8 并不划算,类型转换的开销反而超过了计算上省下的时间。正是这些技术叠加在一起,才带来了约 8 倍的训练速度提升。
从模型效果看,这个 6 亿参数的学生模型确实带来了可观的搜索质量改善。其知识来自两个教师:一个 80 亿参数的相关性教师,以及一个 17 亿参数的互动教师。职位搜索的 NDCG@10 从 0.7583 提升到 0.9432,增幅约 24.48%。同一研究在推理侧还引入了结构化剪枝和上下文压缩,将单块 GPU 的排序吞吐量从每秒约 290 个条目提高到 2000 多个。
这套系统已经投入生产,为 LinkedIn 美国用户的自然语言职位搜索提供支持。它构建在开源大语言模型服务引擎 SGLang 之上——LinkedIn 此前就已在排序工作负载中押注 SGLang,而不是使用专有服务技术栈。LinkedIn 把这项工作当作一份实践指南,帮助团队在满足实时延迟要求的同时,实现接近交叉编码器质量的排序,并且无需为每个请求调用前沿大语言模型推理,从而避开高昂成本。
构建类似大语言模型监督型排序系统的团队,完全可以采用在线与离线相结合的教师模型服务方案。在教师模型选择仍频繁变化的早期阶段,先做在线查询;等教师模型稳定、查询量上来之后,再切到离线缓存。这些收益来源于多项技术的叠加,而非某一个技巧。LiGer、多节点数据并行、FSDP2 和新一代 GPU 都分别带来了适度的提升。另外,对于参数量低于 80 亿的模型,这些优化都不需要 FP8。对默认采用较低精度的团队来说,这个细节值得留意。
2026 年 6 月,Pinterest 发表了一篇相关文章《如何为 Pinterest 基础模型实现近线性的训练扩展能力》,介绍了多节点训练如何帮助构建更大的教师模型,随后再将这些模型的知识蒸馏到效率更高的学生模型中,用于 Homefeed 和 Related Pins 排序,实验周期从数周压缩到很短的时间。相比之下,LinkedIn 的贡献是创建了一个定制 SGLang 框架,使教师模型能够在训练期间接受实时查询。
Pinterest 侧重扩展训练框架,正在迁移到 Distributed Checkpoint,以支持多节点教师模型训练。最近的一项调查《2026 年蒸馏技术进展:哪些前沿模型正在使用它,又是如何使用的》则重点梳理了多教师蒸馏的进展,包括 NVIDIA Nemotron 3 Ultra、MiMo-V2-Flash 和 DeepSeek-V4,这些模型使用十个或更多专业教师模型进行密集的词元级监督。不过这种教师模型池的复杂度,超出了 LinkedIn 和 Pinterest 这类工业排序系统的需求——后者使用的是数量更少、面向特定任务的教师模型。
原文链接: https://www.infoq.com/news/2026/09/linkedin-ai-multi-teacher/ |  发表于 4 天前
|
查看: 1|
回复: 0


