这是「Go × AI 应用开发」系列第 8 篇:生产化。前 7 篇我们把怎么调通一个大模型、怎么让它调工具、怎么写最小 Agent、怎么做检索和 RAG、怎么接 MCP、怎么稳定吐 JSON 都跑通了。但能在笔记本上跑通,不等于能上线——这一篇讲「跑通之后、上线之前」必须补的四件事。
上个月我给一个内部 AI 功能做压测,逻辑明明是对的:发请求、拿回复、回填。结果一上并发,监控里每隔几分钟就跳出一堆 429 Too Many Requests,偶尔还夹着 500。更糟的是,服务没崩,但用户侧白等了十几秒——因为下游限流了,我的请求就在那儿干排队。等到月底看账单,某个没加成本核算的接口悄悄烧掉了我两周的额度。
那次之后,我给所有调大模型的客户端都补了四道保险:重试、限流、成本控制、可观测。下面把我本地实跑的代码和数据都摊开,你可以直接拿走改。
先把结论摆这儿,后面都是论据:
- 重试不是
for 循环套一层那么简单:只重试「可恢复的瞬时错误」(429/5xx/网络抖动),4xx 里除了 429 基本都别重试;退避必须带抖动;必须尊重服务端给的 Retry-After;必须限制总耗时而不是只限制次数。
- 限流不是免费午餐:它把上游的压力转成了你自己的排队延迟。限得太松打爆上游,限得太紧坑了自己,得拿真实数字说话。
- 不记账迟早被账单教育:
usage 字段就在响应里,不采就是盲飞;流式场景下还有个 include_usage 的坑。
- 没有结构化日志,你只是在祈祷:一次请求失败,你至少要能从日志里还原「哪次、第几轮、花了多少 token、重试了几回」。
下面四节,一节一保险,每段都附带我本地 go1.23.3 实跑的结果。
一、重试:哪些错该重,哪些错碰都别碰
OpenAI 官方文档对重试的建议很明确:429(限流)、5xx(服务端过载)、网络错误可以重试;计费类 429、401、403、404、400/422(你的请求体本身有问题)、413(超长,该砍 prompt 而不是重发)一律不要重试——重试也救不回来,只会白白消耗配额和延迟。
我一开始也犯过傻:把 resp.StatusCode != 200 全丢进重试循环,结果一个 400 被我重试了 5 次,配额当场见底。所以先写一张「白名单」:
// 只有可恢复的瞬时错误才重试
func shouldRetry(code int) bool {
switch code {
case http.StatusTooManyRequests, // 429 限流
http.StatusInternalServerError, // 500
http.StatusBadGateway,          // 502
http.StatusServiceUnavailable,  // 503
http.StatusGatewayTimeout:      // 504
return true
}
return false
}
然后是退避。指数退避大家都听过,但抖动(jitter)才是关键。没有抖动的话,一大批请求在同一时刻一起失败、一起退避、再一起重试,会制造「雷鸣羊群效应」(thundering herd),把上游重新打挂。我用的是 full jitter:在 [0, base*2^(n-1)] 里随机取一个值。
func (c *Client) backoff(attempt int) time.Duration {
base := float64(c.baseDelay)
d := base * math.Pow(2, float64(attempt-1)) // 指数:150ms, 300ms, 600ms...
if d > float64(c.maxDelay) {
d = float64(c.maxDelay) // 封顶,别退到天荒地老
}
d = d * c.rng.Float64() // full jitter:[0, d)
if d < 1 {
d = 1
}
return time.Duration(d)
}
还有两个容易漏的点:
- 尊重
Retry-After:429 响应头里常常带着 Retry-After: 0.5,意思是「至少等半秒」。这个值优先级高于你本地的退避,照做就行,别自作主张。
- 限总耗时,不限次数:只限制「最多重试 5 次」不够。如果每次退避撞上限 2 秒,5 次就是 10 秒白等。我额外加了一个
maxElapsed(比如 15 秒),超时直接放弃,把错误交还给调用方。
完整的重试循环长这样(这是能直接 go run 的版本):
func (c *Client) Chat(ctx context.Context, req ChatRequest) (ChatResponse, error) {
c.gate <- struct{}{} // 并发闸门,先占个槽
defer func() { <-c.gate }()

c.metrics.recordRequest()
var lastResp *http.Response
var lastErr error
start := time.Now()
traceID := newTraceID()
honoredRA := false

for attempt := 0; attempt < c.maxAttempts; attempt++ {
if attempt > 0 {
c.metrics.addRetry()
if !honoredRA { // 如果上一轮已经照 Retry-After 睡过了,这轮不再叠加退避
delay := c.backoff(attempt)
c.log.Warn("retry", "trace_id", traceID, "attempt", attempt+1,
"delay_ms", delay.Milliseconds(), "reason", reasonOf(lastResp, lastErr))
select {
case <-time.After(delay):
case <-ctx.Done():
return ChatResponse{}, ctx.Err()
    }
   }
  }
honoredRA = false

if err := c.limiter.Wait(ctx); err != nil { // 每次尝试都过限流
return ChatResponse{}, err
  }

resp, err := c.doOnce(ctx, req)
if err != nil {
lastErr = err
lastResp = nil
c.log.Error("request error", "trace_id", traceID, "attempt", attempt+1, "err", err.Error())
if time.Since(start) > c.maxElapsed {
return ChatResponse{}, fmt.Errorf("retry budget exhausted: %w", err)
   }
continue
  }
lastResp = resp

if resp.StatusCode == http.StatusOK {
var cr ChatResponse
_ = json.NewDecoder(resp.Body).Decode(&cr)
resp.Body.Close()
c.metrics.recordSuccess(cr.Usage.PromptTokens, cr.Usage.CompletionTokens)
return cr, nil
  }

resp.Body.Close()
if !shouldRetry(resp.StatusCode) { // 不可重试:立刻报错,绝不恋战
return ChatResponse{}, fmt.Errorf("non-retryable status %d", resp.StatusCode)
  }

if ra := resp.Header.Get("Retry-After"); ra != "" { // 429:优先照 Retry-After 睡
if secs, perr := strconv.Atoi(ra); perr == nil && secs >= 0 {
select {
case <-time.After(time.Duration(secs) * time.Second):
case <-ctx.Done():
return ChatResponse{}, ctx.Err()
    }
honoredRA = true
lastErr = fmt.Errorf("status 429")
if time.Since(start) > c.maxElapsed {
return ChatResponse{}, fmt.Errorf("retry budget exhausted: %w", lastErr)
    }
continue
   }
  }

lastErr = fmt.Errorf("status %d", resp.StatusCode)
if time.Since(start) > c.maxElapsed {
return ChatResponse{}, fmt.Errorf("retry budget exhausted: %w", lastErr)
  }
  }
return ChatResponse{}, fmt.Errorf("exhausted %d attempts: %w", c.maxAttempts, lastErr)
}
我本地用 httptest 起了个 mock,让前 3 次请求返回 500,其余正常。跑 30 个并发请求,结果是:
请求数=30 成功=30 失败=0 重试=3
3 次 500 全部被重试救了回来,没有一次是真的失败。我又单独测了 429 + Retry-After: 0 的场景,断言重试了 2 次后成功、usage 正常解析(5 token),断言通过;再测 400,确认一次都没重试,直接报错。这三个行为正好对应上面那张白名单。
一个 Agent 专属的坑:OpenAI 的核心 API(/v1/chat/completions)不支持 Idempotency-Key 头。也就是说,重试一个已经发出去的请求,你无法靠平台去重。在普通聊天里最坏不过是多生成一段文本;但在 Agent 循环里,模型可能已经吐了一个工具调用、你的执行器已经把它跑过了——重试这一轮会再跑一次工具,两笔扣款、两封邮件。所以幂等要在工具边界做(用 turn_id + 工具名 + 参数 算一个 key 去重),而不是在 API 调用层做。
二、限流:别把上游打爆,也别坑了自己
重试能救瞬时错误,但救不了「你一秒钟发 500 个请求」这种自己作的死。上线前得想清楚两件事:同时在飞多少个请求(并发),以及每秒发多少个(速率)。
并发我用最简单的信号量:一个带缓冲的 channel,发请求前 <- 占槽,结束 -> 放槽。速率我用令牌桶——这也是 golang.org/x/time/rate 背后的核心思路。下面这个手写版够用,生产上你直接换 x/time/rate 的 Limiter.Wait(ctx) 就行,API 几乎一样:
type RateLimiter struct {
mu sync.Mutex
tokens float64
max float64
refillPer time.Duration// 补充 1 个 token 需要的时间
last time.Time
}

func NewRateLimiter(rps int) *RateLimiter {
return &RateLimiter{
tokens:    float64(rps),
max:       float64(rps),
refillPer: time.Second/time.Duration(rps),
last:      time.Now(),
}
}

func (l *RateLimiter) Wait(ctx context.Context) error {
for {
l.mu.Lock()
now := time.Now()
elapsed := now.Sub(l.last)
l.tokens += elapsed.Seconds() / l.refillPer.Seconds() // 按时间补充令牌
if l.tokens > l.max {
l.tokens = l.max
  }
l.last = now
if l.tokens >= 1 {
l.tokens -= 1
l.mu.Unlock()
return nil
  }
wait := time.Duration((1-l.tokens) * float64(l.refillPer))
l.mu.Unlock()
select {
case <-time.After(wait):
case <-ctx.Done():
return ctx.Err()
  }
  }
}
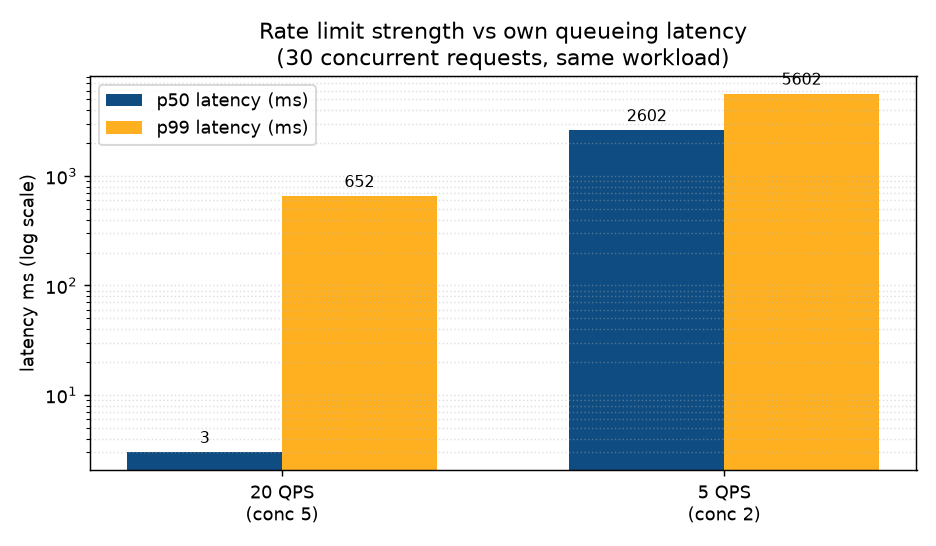
重点来了:限流是有代价的,而且这代价是你自己的延迟。我把同一个 30 并发的压测分别用 20 QPS 和 5 QPS 跑了一遍,延迟差了一整个数量级:
20 QPS / 并发 5 :  p50=3ms    p99=652ms   max=652ms
5  QPS / 并发 2 :  p50=2602ms  p99=5602ms  max=5602ms
20 QPS 时请求基本不被限流排队,p50 只有 3ms,那 652ms 的 p99 几乎全是重试退避贡献的;一旦压到 5 QPS,请求开始排队,p50 直接飙到 2.6 秒。这组数字给我的教训很具体:限流值不是拍脑袋定的,得先知道上游给你的真实配额(RPM/TPM),再留出余量,然后用压测看自己的延迟是否能接受。限得太紧,表面上是「保护上游」,实际上是把用户拖进加载圈。
三、成本控制:不记账迟早被账单教育
大模型的响应体里自带 usage,这是做成本核算最权威的数据源:
"usage": {
"prompt_tokens": 12,
"completion_tokens": 5,
"total_tokens": 17
}
三个字段都很直白:输入 token、输出 token、总和。注意输入和输出的单价通常不一样(输出贵得多),所以成本要分开算。我在 Metrics 里加两个原子计数器,每次成功就累加:
func (m *Metrics) recordSuccess(p, c int) {
atomic.AddInt64(&m.success, 1)
atomic.AddInt64(&m.promptTokens, int64(p))
atomic.AddInt64(&m.completionTokens, int64(c))
}

// 价格从配置读,千万别硬编码进代码
func (m *Metrics) costUSD(pricePrompt, priceCompletion float64) float64 {
p := float64(atomic.LoadInt64(&m.promptTokens))
c := float64(atomic.LoadInt64(&m.completionTokens))
return p/1e6*pricePrompt + c/1e6*priceCompletion
}
价格我故意做成参数传入,而不是写死在代码里——模型降价是常态,硬编码迟早过期。示例价我用了「输入 0.15 美元/百万 token、输出 0.60 美元/百万 token」,跑出来:
输入token=360  输出token=150  合计=510
估算成本(示例价 输入$0.15/M, 输出$0.60/M)=$0.000144
金额虽小,但这是 30 次请求的累计。真上生产,一天几十万次调用,不采 usage 你连「哪个接口在烧钱」都不知道。
流式(SSE)场景有个坑:默认不返回 usage。要显式在请求里带 stream_options: {include_usage: true},usage 才会出现在 [DONE] 之前的最后一个 chunk(且此时 choices 为空)。更麻烦的是——如果流中途断了,你大概率收不到那个 usage chunk。所以「没收到 usage」不等于「这次没花 token」,真要做精确计费,断流得按已收到的内容重新估算或补查。普通非流式请求没这个烦恼,这也是我更推荐先在非流式下把账记明白的原因。
四、可观测:没有日志你只是在祈祷
前三节保证了「能恢复、不崩、算得清」,但线上真出问题,你得能定位。我的做法是用 log/slog 打结构化日志,每条请求带一个 trace_id,关键事件都带上上下文:
c.log.Info("ok", "trace_id", traceID, "attempt", attempt+1,
"prompt_tokens", cr.Usage.PromptTokens,
"completion_tokens", cr.Usage.CompletionTokens,
"latency_ms", time.Since(start).Milliseconds())
一次请求从发起到结束,日志里能还原出:这个 trace_id 总共尝试了几轮、每轮为什么重试、花了多少 token、总延迟多少毫秒。重试和报错也都带同一个 trace_id,排障时一把捞出来就是完整时间线。
指标层面,Metrics 用原子计数维护:请求数、成功数、失败数、重试数、输入/输出 token。这是最朴素的实现,生产上可以无缝换成 expvar 或 Prometheus 的 Counter/Histogram,但计什么这件事不会变——你至少得知道「重试率」和「各接口的 token 消耗」,前者告诉你上游稳不稳定,后者告诉你钱花哪了。
把四件事串起来:一个能直接跑的例子
上面的片段拼起来就是一个最小可用的生产级客户端:shouldRetry 决定要不要重试 → backoff + Retry-After 决定等多久 → RateLimiter + 并发闸门决定发多快 → Metrics 顺便把账和日志都记了。我本地的压测(30 并发、mock 前 3 次返回 500)跑出来是这样:
请求数=30  成功=30  失败=0  重试=3
输入token=360  输出token=150  合计=510
估算成本(示例价 输入$0.15/M, 输出$0.60/M)=$0.000144
延迟 p50=3ms  p99=652ms  max=652ms
go test -bench 下,一次本地调用的开销是 46689 ns/op、12144 B/op、161 allocs/op——这是连 mock 的纯开销,真实网络 + LLM 推理比这慢几个数量级,所以客户端的包装成本基本可以忽略,瓶颈永远在模型和网络上。你该把钱和精力花在「重试策略对不对、限流值合不合理」上,而不是纠结这几万纳秒。
上生产前,我的核对清单
- 重试只覆盖 429/5xx/网络错误,4xx(除 429)直接失败
- 退避带 jitter,且尊重
Retry-After
- 同时限制「重试次数」和「总耗时」
- Agent 场景的幂等在工具边界做,不在 API 层做
- 并发闸门 + 速率限制都就位,限流值来自上游真实配额而非拍脑袋
- 每次成功都采集
usage,成本公式的价格从配置读
- 流式场景显式开
include_usage,并处理好断流丢 usage 的情况
- 每条请求带
trace_id,关键事件结构化落日志
我的取舍
这几道保险里,我最想强调限流值要拿数据调。很多人(包括早年的我)要么不限流裸奔,要么为了「安全」限得极紧,结果用户侧体验稀烂。20 QPS 和 5 QPS 那组实测数字我贴出来了,差异就是这么直白——它不是理论,是你用户的真实等待。
另外,重试和限流我都选择「手写而非引 SDK」。不是反对 SDK,OpenAI 官方 Go SDK 确实内置了重试,但它是黑盒、行为随版本变;自己写这 80 行,好处是所有分支你都看得懂、都测得过、出问题能改。等哪天真要接多家供应商、要做熔断和兜底模型,再上更重的封装也不迟。
总结
大模型 API 上生产,裸调 http.Post 等于没买保险就上路。本文用一份零依赖、go1.23.3 实跑通过的客户端,把重试、限流、成本、可观测四件事一次讲透,所有数字都是本地压测真跑出来的,不是「理论上应该可以」。
注:文中示例价格为说明成本公式之用,请按你实际使用的模型单价替换;所有运行数据均来自本机 go1.23.3 / Apple M4 / 本地 httptest mock,真实网络与云端模型延迟会更高,但相对关系一致。
 发表于 3 小时前
|
查看: 6|
回复: 0


