前言
很多苹果用户经常说 Mac 的统一内存很适合跑本地 AI 大模型,但似乎一直没人把“到底能跑多大的模型”讲清楚。
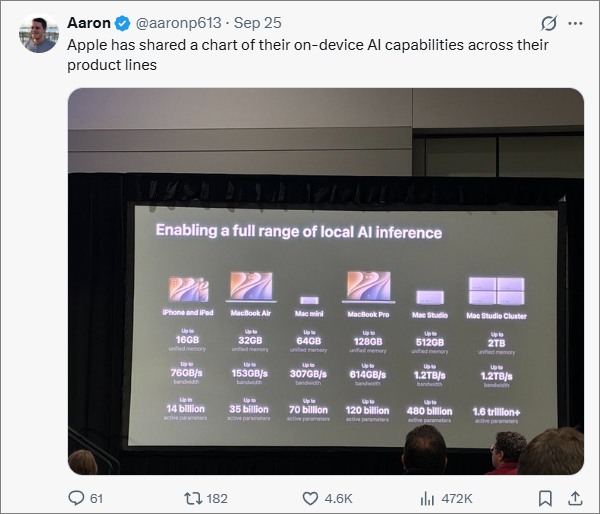
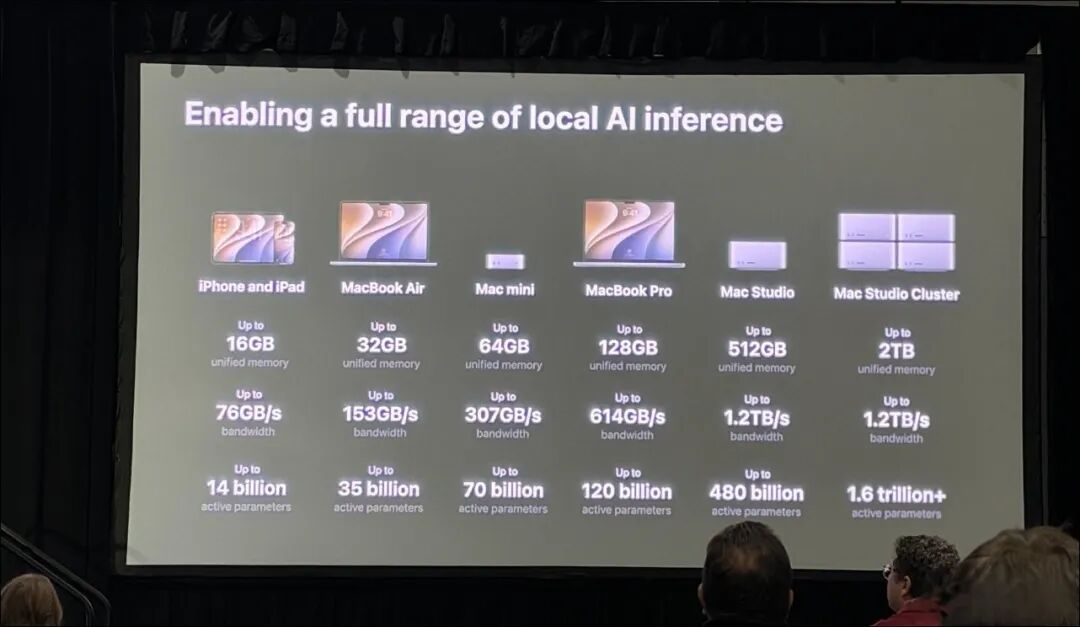
近日,Apple 直接把“哪台机器能跑多大的模型”做成了一张表,列出了从 iPhone、iPad 一直到 Mac Studio 集群的统一内存上限、内存带宽和可承载的模型规模,最高一档写着 1.6 万亿个激活参数。
详细介绍
表上一共列了六条产品线,每一栏都给出了内存、带宽和模型规模三个数字:
- iPhone 和 iPad:16GB 统一内存、76GB/s 带宽,最高 140 亿个激活参数
- MacBook Air:32GB、153GB/s,最高 350 亿个
- Mac mini:64GB、307GB/s,最高 700 亿个
- MacBook Pro:128GB、614GB/s,最高 1200 亿个
- Mac Studio:512GB、1.2TB/s,最高 4800 亿个
- Mac Studio 集群:2TB、1.2TB/s,1.6 万亿个以上
Mac mini 和 Mac Studio 的数字,Apple 自己写过。
根据 Apple 教育社区顾问工程师 James Garringer 撰写的一篇校园采购文章,文中明确写到:
M5 Pro 版 Mac mini 支持最高 700 亿个激活参数、307GB/s 带宽,可以在本机运行 Llama 3.3 70B 或 Qwen 3.6 35B,不需要调用云端 API;
M5 Ultra 版 Mac Studio 支持 4800 亿个激活参数、1.2TB/s,多台机器组成集群后,则可以提升到 1.6 万亿个激活参数。
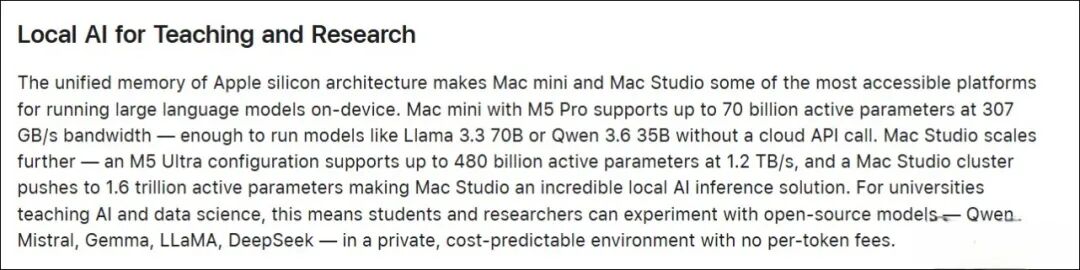
文章列出的使用场景主要是大学的 AI 和数据科学课程,学生和研究人员可以在私有环境里测试 Qwen、Mistral、Gemma、LLaMA、DeepSeek 等开源模型,不用按 token 计费。
表上 Mac mini 那一栏,对应的是 M5 Pro 配置。
2 纳米工艺的 M6 内置双 16 核神经网络引擎,GPU 每个核心都带神经网络加速器,统一内存最高 32GB、带宽最高 170GB/s;
想要 64GB 和 307GB/s,就得选择 M5 Pro 版本,也就是表上列出的这一档。
最近也入手了一台 Mac mini M6 32GB 版测试本地 AI(之后会出详细测试视频),先了解一下就好,原则上四万多的机器,实际体验也没有特别好。
手机这一档:76GB/s 的门槛
表上给 iPhone 和 iPad 开出的条件是 16GB 统一内存和 76GB/s 带宽,而 A20 Pro 的内存带宽已经达到 115.2GB/s,高于表上列出的数字。
所以这可能是以最低支持机型作为基准。
Mac Studio 的硬件底子
4800 亿这一档靠的是 M5 Ultra。这颗芯片通过 UltraFusion 连接四个芯粒,CPU 最高 36 核,GPU 最高 80 核,而且每个核心都内置神经网络加速器,神经网络引擎为 32 核,统一内存最高 512GB,内存带宽达到 1.2TB/s,比 M3 Ultra 高出 50%。
Apple 表示,其 AI 峰值算力可以达到 M3 Ultra 的 4.5 倍,在 LM Studio 中的提示词处理速度最高快 4 倍。这些数字全部来自 Apple 自己公布的测试结果,不是第三方实测。
1.6 万亿怎么凑出来:Thunderbolt 5 加上 RDMA
单台机器装不下的模型,就靠多台机器分摊。Apple 在 WWDC26 的“Explore distributed inference and training with MLX”议程中把整套架构讲得很清楚:
- 从 macOS 26.2 开始支持 Thunderbolt 5 上的 RDMA,数据可以直接从一台机器的内存写入另一台机器,省掉大部分 CPU 和操作系统的数据搬运成本;
- 再往上一层是 Apple 自家的开源集体通信库 JACCL,负责节点之间的数据交换和结果合并;
- 最上层才是开源框架 MLX,负责把模型拆开,再分配给各台机器。
Apple 的演示使用四台 M3 Ultra,以 270 亿参数的 Qwen 3.6 进行测试,集群的 token 生成速度接近单机的 3 倍;
微调 90 亿参数的 Qwen 3.5 时,单机大约每秒 180 个 token,集群大约 600 个。
Apple 在 Mac Studio 的官方说明中也用了类似说法,表示分布式 AI 推理性能相比单一系统最高可以达到 3 倍,同时也注明实际结果会根据模型大小和架构有所不同。
“激活参数”不是内存占用量
表上每一档的单位都是激活参数,这个词放到混合专家(MoE)模型里才比较容易理解。
MoE 模型由多个专家子网络组成,处理每个 token 时只会调用其中几个,总参数量包含所有专家,而激活参数量只计算当前实际调用的那一部分。
模型能不能跑起来,关键还是看总参数在指定量化精度下能不能塞进统一内存,同时还要给上下文窗口和操作系统留出空间;运行速度则更多和激活参数有关。
Apple 的演示里就有现成例子。开源模型 Kimi 2.6 的总参数量为 1 万亿,即使压到 8 位量化,仅权重就需要大约 1TB 内存,单台 M3 Ultra 装不下,四台才够。
表上那句 1.6 万亿,更适合理解成“这个内存规模能容纳多大的模型”,但它没有说明量化精度和上下文长度,也没有说明运行速度。
1200 亿这一档的对照组
表上 MacBook Pro 那一栏给的是 128GB 统一内存、614GB/s 和最高 1200 亿个激活参数。
这个组合与同样搭载 128GB 内存的 RTX Spark 笔记本处于同一级别,两边能够运行的模型规模比较接近。
选择机器的分界线因此不只是 GPU 核心数量,而是内存容量和带宽:统一内存让 CPU 和 GPU 共用同一个内存池,模型不用拆开再搬进显卡显存。
不过 Apple 因为不支持 CUDA 生态,在实际表现上还是会相对吃亏。
这张表回答的是内存够不够,并没有回答运行起来到底顺不顺。选择机器时,把模型、量化精度和上下文长度放在一起算,比单纯记住 14B 还是 480B 这些标签数字更有用。
Apple 这次至少把选购的起点讲清楚了:先确定模型,再回头选择内存。
不过苹果跑本地 AI 的优势是内存大,劣势则是生态问题,很多东西得靠开发者自己折腾,所以表现不会比 NVIDIA 更好。
但只要预算足够,基本都是“能跑”,不会出现连测试机会都没有的情况,关键还是看具体需求怎么选。
 发表于 3 天前
|
查看: 3|
回复: 0


