在服务器固件系统中,一条异常日志往往只是故障露出水面的“冰山一角”。真正的根因,可能隐藏在更早的调用链、更复杂的状态流转,甚至某个本应执行却没有执行的恢复路径中。
在 OSFC2026(Open Source Firmware Conference)的分享中,围绕 Agentic AI Software Debugging in OpenBMC 这个议题,字节跳动 STE 固件团队展示了一种面向 OpenBMC 软件调试的新思路:不是让大模型直接读取海量日志并“猜测根因”,而是先通过程序分析构建可验证的证据链,再让 AI Agent 在受约束的证据空间中完成根因解释、验证建议与修复方向生成。
如果说传统 AI 调试更像“让模型在日志里找答案”,那么这套方案更接近于“让程序证据先还原现场,再让 Agent 解释现场”。
一、背景与挑战:OpenBMC 调试为何难
OpenBMC 位于服务器管理控制链路的关键位置,承担传感器、硬件健康状态、系统事件、管理接口和恢复流程等基础能力。它不像上层业务系统那样离用户更近,但一旦发生异常,影响往往会传导到整机稳定性、运维效率乃至数据中心可靠性。
1.1 传统调试链路与核心痛点
在实际调试中,工程师面对的第一个问题通常不是“没有日志”,而是“日志太多”。系统运行过程中会产生大量服务日志、systemd journal、D-Bus 调用记录、传感器状态变化和错误提示。真正能指向根因的信号,往往分散在这些日志之间。
传统调试链路
- 从海量日志中筛选异常片段。
- 根据关键字搜索源码。
- 手动定位函数、调用者和被调用者。
- 结合经验判断异常路径和可能根因。
核心挑战
- 日志规模大、噪声高。
- 最后一条错误日志不一定是根因。
- 调用链追踪高度依赖经验。
- 文本相似不等于因果相关。

1.2 直接让 AI 读日志的局限
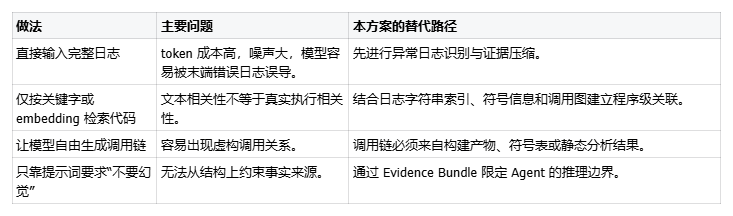
大模型具备强大的语言理解和归纳能力,但在软件调试场景中,如果直接把完整日志交给模型,很容易出现两个问题:一是上下文成本高,二是结论不可验证。
二、方案:基于证据链的 Agentic 调试架构
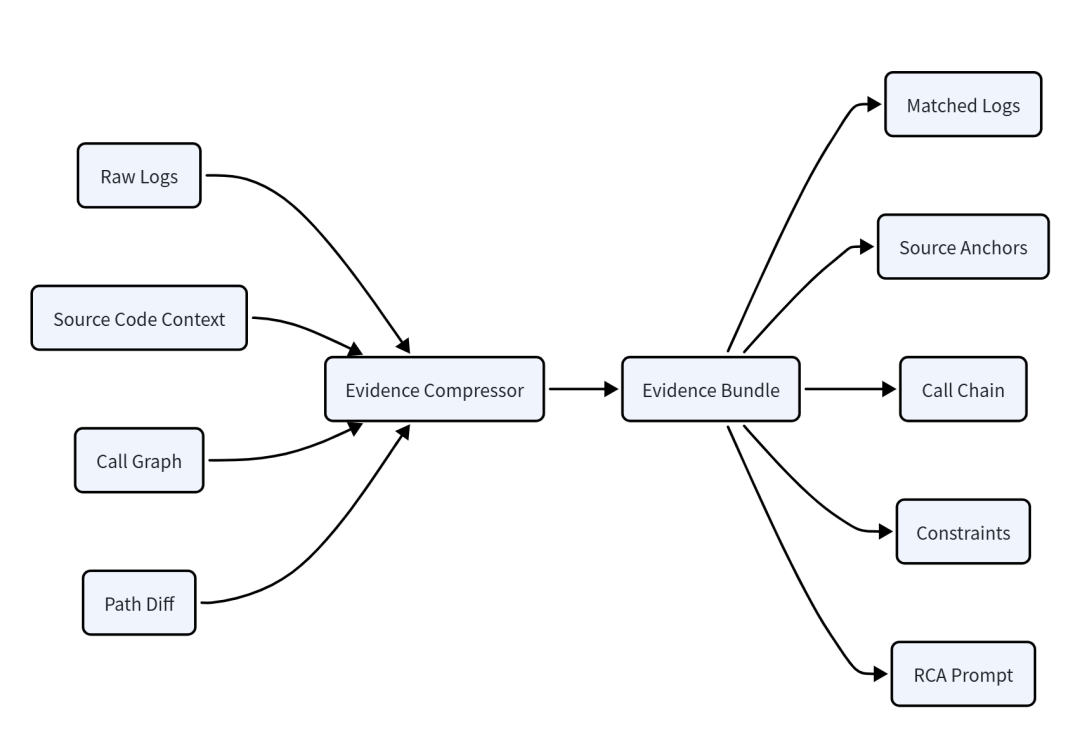
这套方案没有把 LLM 设计为“事实来源”,而是把它放在更合适的位置:证据解释器、假设组织者和行动建议生成器。 整体思路是:先用确定性的程序分析完成事实抽取、证据构建和上下文压缩,再让 Agent 在边界清晰的证据空间中完成解释和推理。
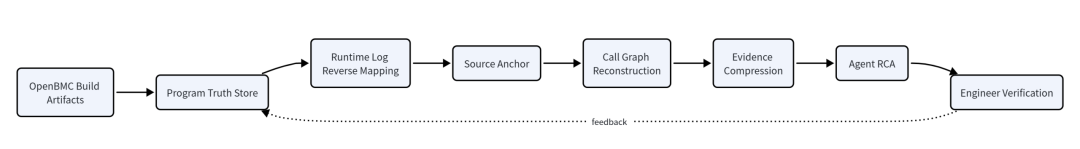
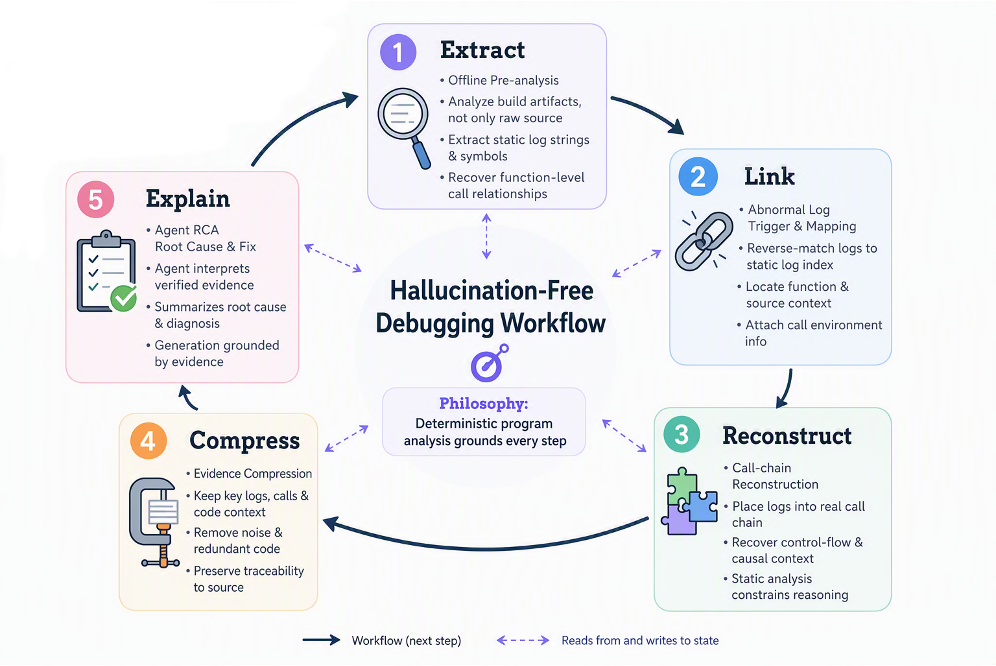
2.1 从日志到程序足迹
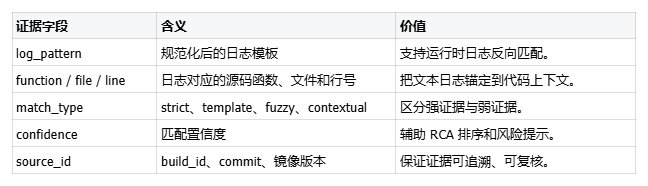
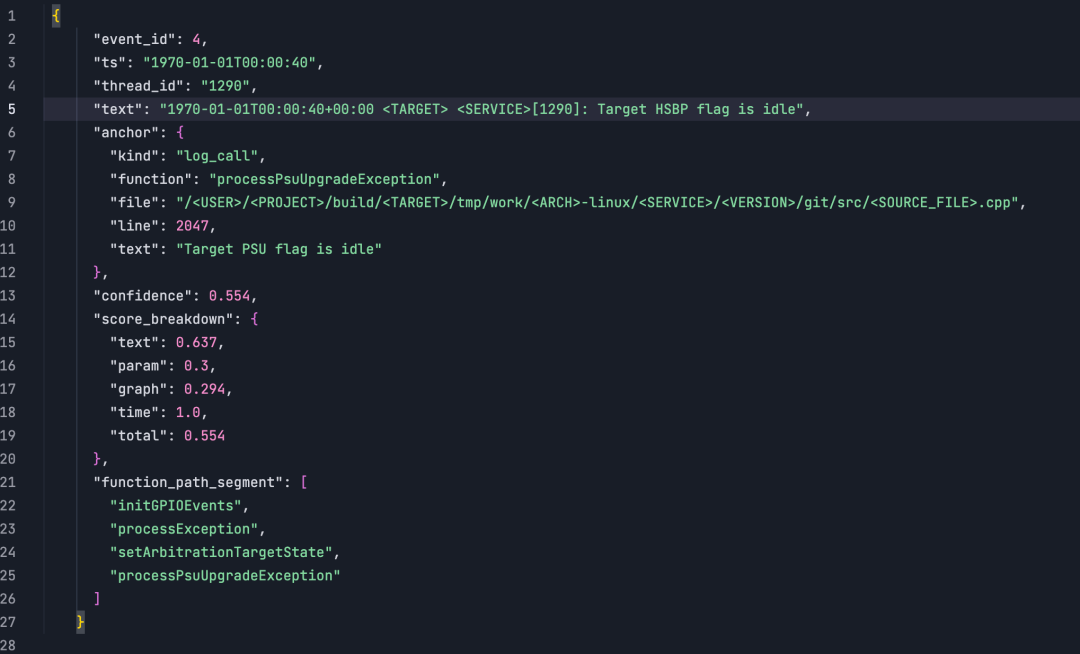
这套方案的关键突破之一,是将运行时日志从“文本线索”转换为“程序足迹”。
在传统调试中,工程师看到一条异常日志后,通常会复制关键字到代码仓库里搜索。但如果同一条日志字符串在多个位置出现,或者日志经过格式化、变量替换和运行时拼接,单纯文本搜索就可能定位不准。
设计关键点: 如果一条日志能被多个位置发出,系统不能直接选择文本最相似项,而应结合模块、时间顺序、相邻日志、服务上下文和调用图可达性共同评分。
2.2 调用图与路径重建:定位真正的分叉点
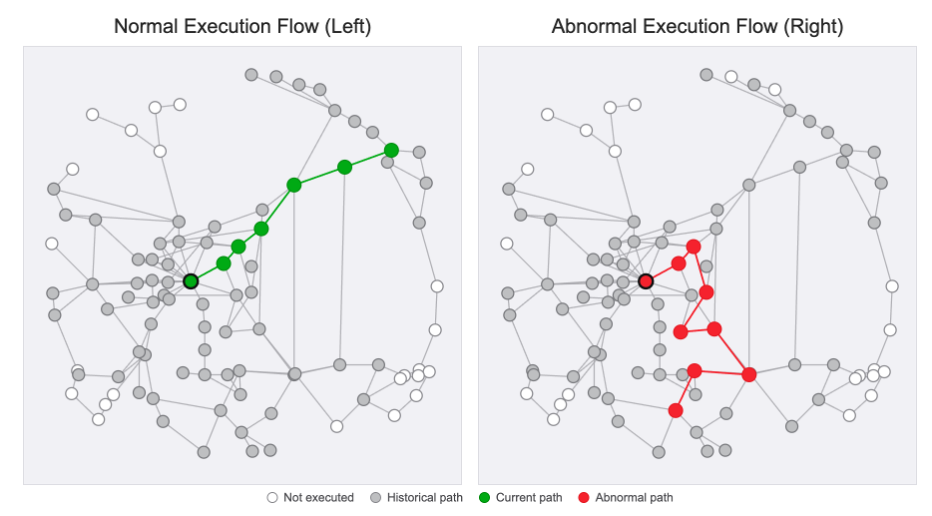
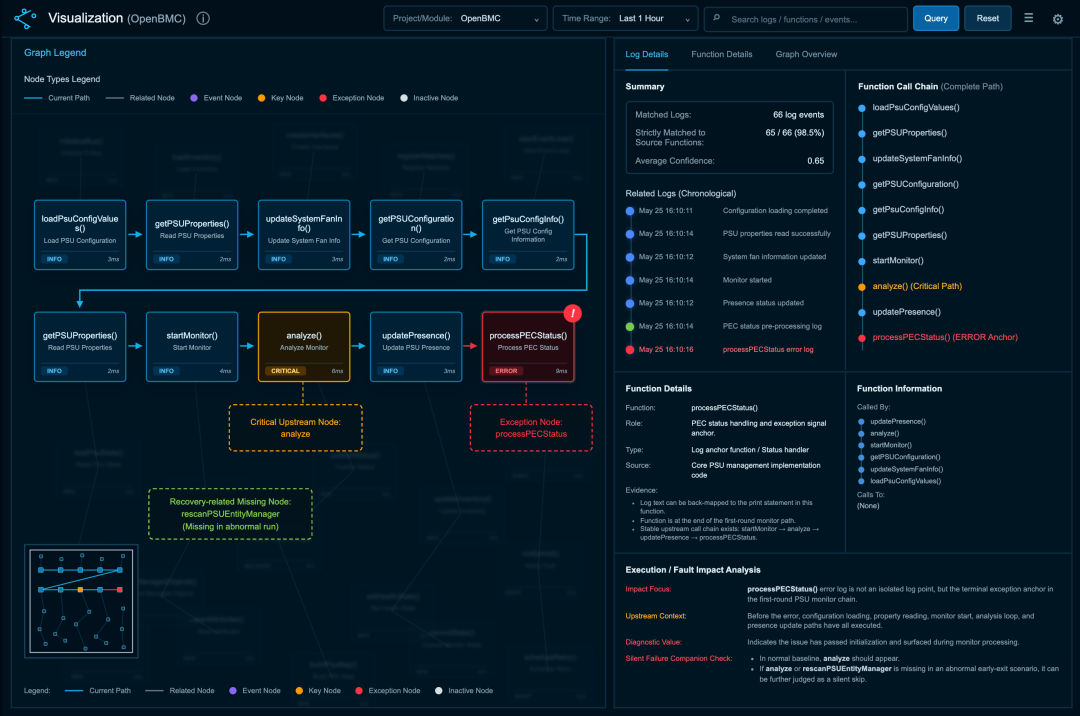
定位到源码锚点只是第一步。真正的根因分析还需要回答更关键的问题:异常为什么会走到这里?正常情况下又应该走向哪里?
为此,方案引入调用图和路径重建能力。系统会从异常日志对应的函数出发,沿真实调用关系向上游和下游扩展,识别调用链中的关键节点、异常节点、事件节点和可能缺失的恢复节点。
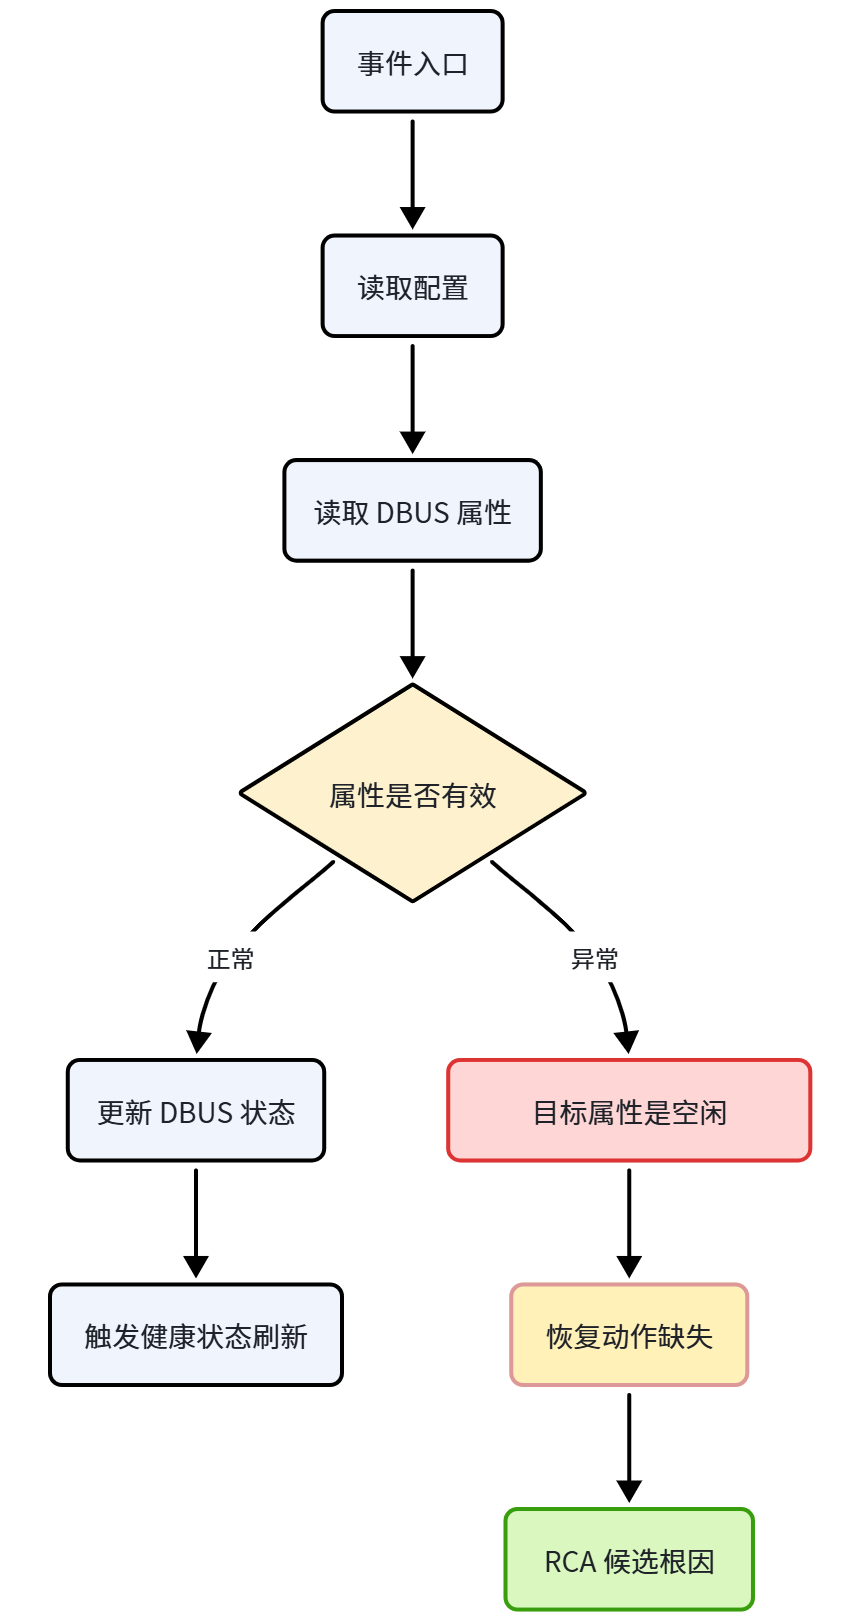
对于 OpenBMC 这类事件驱动系统,路径重建还需要考虑 D-Bus 调用、property 变化、signal、method call、systemd service 以及异步回调等因素。
方法差异: 系统不仅看“异常路径发生了什么”,还会对比“正常路径本应发生什么”。如果某个恢复动作没有执行、某个状态没有更新、某个 fallback 没有触发,这些路径差异就会成为比单条错误日志更有价值的根因线索。
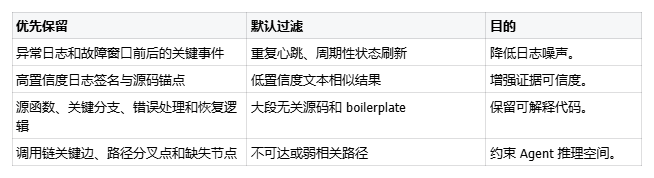
2.3 证据压缩:把关键信息装进 Agent 的上下文
在 AI 调试系统中,“给模型更多上下文”并不总是更好。对于 OpenBMC 这类复杂系统而言,完整日志和完整源码往往包含大量无关信息。直接堆叠上下文不仅成本高,还可能让模型被噪声误导。
因此,方案中的 Evidence Compressor 并不是普通摘要工具,而是一个面向因果价值的结构化裁剪模块。
2.4 Agent 的能力边界与 RCA 输出规范
在这套设计中,Agent 的能力边界被明确限定。Agent 可以解释证据链、组织根因假设、给出验证步骤和修复建议;但不能凭经验虚构不存在的函数调用关系,也不能在证据不足时输出确定性结论。
Agent 可以做
- 解释证据链中各节点之间的因果关系。
- 将日志、源码片段和调用链组织成可读 RCA。
- 对多个候选根因排序,并说明依据。
- 给出下一步验证建议。
- 在证据支持时提出修复方向。
Agent 不应该做
- 凭经验虚构不存在的函数调用关系。
- 把文本相似的日志直接当作根因证据。
- 在证据不足时输出确定性结论。
- 绕过源码锚点和调用图直接给出修复方案。
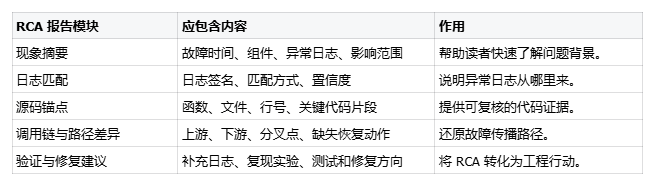
最终输出的 RCA 报告,也不应只是“可能是某某原因”这样的一句话,而应包括现象摘要、日志匹配、源码锚点、调用链、路径差异、根因假设、验证步骤和修复建议。每个关键结论都应能回溯到对应证据。如果证据不足,系统需要明确标注“不确定”以及后续需要补充采集的信息。
三、价值与收益
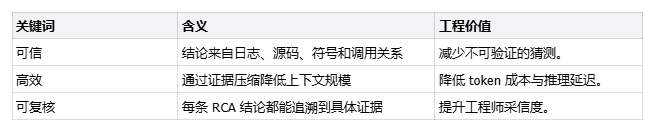
这套方案的核心价值,是回答了基础设施工程中的一个关键问题:AI 应该如何被可靠地使用?答案既不是让模型替代工程师,也不是让模型在海量日志中自由发挥,而是让确定性的程序分析先完成事实抽取与证据构建,再让 Agent 在受约束的证据空间中完成解释和推理。
四、总结与展望
随着 AI 算力基础设施快速演进,服务器固件正在从“隐藏在系统底层的基础组件”,走向决定数据中心可靠性和运维效率的关键能力层。OpenBMC 软件调试的智能化,正是这一趋势中的重要一环。
4.1 从 RCA 到闭环修复的演进路径
从长期看,这条路径还可以继续向闭环修复演进。
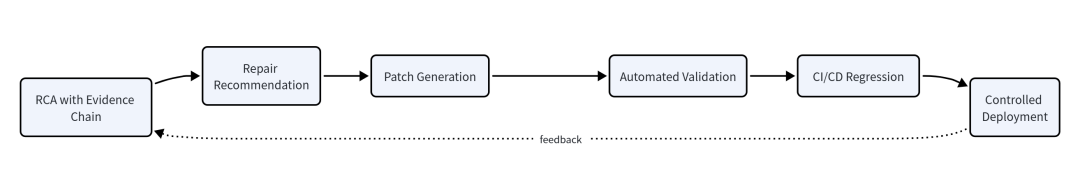
- RCA with Evidence Chain: 基于证据链输出可信根因分析。
- Repair Recommendation: 在证据支持下生成修复建议。
- Patch Generation: 结合代码上下文生成候选补丁。
- Automated Validation: 自动触发单测、仿真或复现实验。
- CI/CD Regression: 进入持续集成和回归验证流程。
- Controlled Deployment: 在可回滚、可观测前提下逐步部署。
4.2 后续方向
未来,字节跳动 STE 固件团队将继续探索 Agentic AI 在固件研发、调试、验证和运维中的工程化落地,让 AI 不只是“会回答问题”,而是真正成为基础设施研发流程中可信、可控、可审计的效率杠杆。如果你也在关注 AI 在基础设施领域的落地实践,欢迎到 云栈社区 一起交流。
 发表于 8 小时前
|
查看: 5|
回复: 0


