近日,OpenAI 创始人山姆·奥特曼高调宣布进军人形机器人,一脚踩进了特斯拉最看重的后院。消息一出,最先坐不住的应该是马斯克——他押注人形机器人多年,最清楚这意味着什么。这两个王一般的男人,梁子已经结了好几年,如今又添了一个新战场。不过,这一战的胜负远未分明,结局现在谁也无法判断。
但把镜头拉远一点就会发现,这远不只是两个男人的恩怨。从谷歌、OpenAI、马斯克,再到中国的阿里、字节,一批数字世界的 AI 巨头,正不约而同地做同一件事:把在数字世界里炼成的智能,装进汽车、装进机器人,去接管真实的物理世界。一场无声的合流正在发生。它们到底看到了什么?又会把这两个行业带向哪里?
AI巨头,密集入场
过去一年,物理AI从一个概念变成了大厂的行动清单。要看清这波入局,得先有个坐标——李想判断,自动驾驶是具身智能的上半场,具身智能是自动驾驶的下半场。眼下这批数字AI公司,有的先打上半场,有的直接落子下半场——起点不同,落点却都在同一张物理世界的牌桌上。
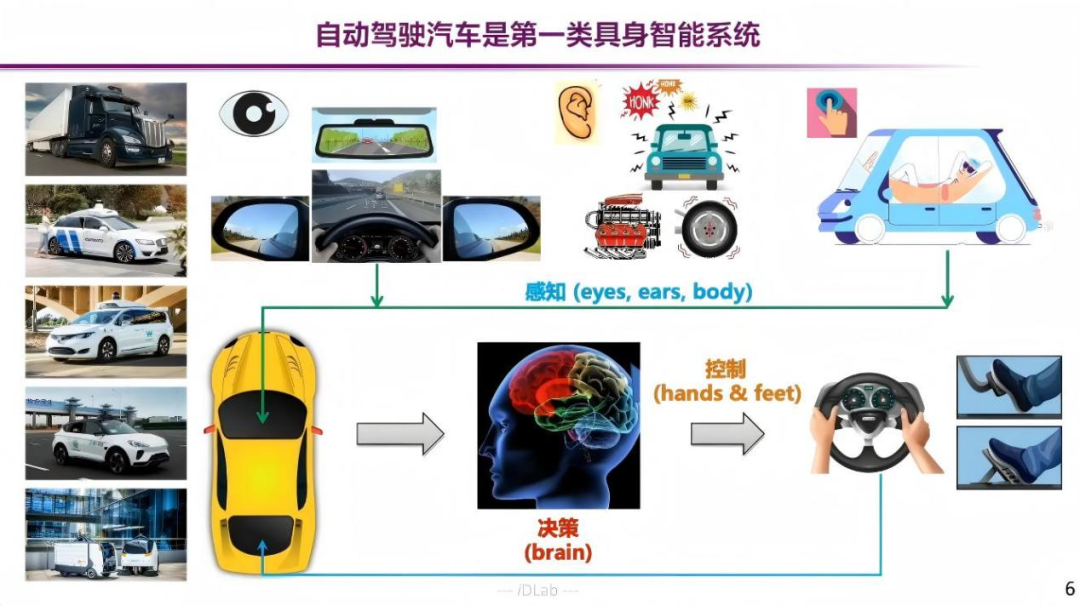
图片来源:清华大学
谷歌同时押注上下半场,而且已经做出了亮眼成绩。自动驾驶方面,Waymo 已经把 Robotaxi 做成了一门真生意:截至 2025 年底,约 2500 辆车跑在凤凰城、旧金山等美国多座城市,周订单超 40 万单,累计全自动驾驶里程超 2 亿公里。直到今天,它仍是这条路上走得最远的那个。
机器人/具身智能方面,谷歌的分量同样很重。2022 年的 RT-1 第一次把机器人的策略网络做成 Transformer,把语言指令和图像观测一起塞进同一个模型,输出直接是动作;一年后的 RT-2 更进一步,干脆把视觉语言模型整个搬来当策略骨架,把动作预测重构成视觉问答——VLA 这个架构范式就此定型。这套由谷歌开创的架构,此后两年几乎成了机器人大脑的通用语言,直到今年的 Gemini Robotics 仍在同一条线上迭代。
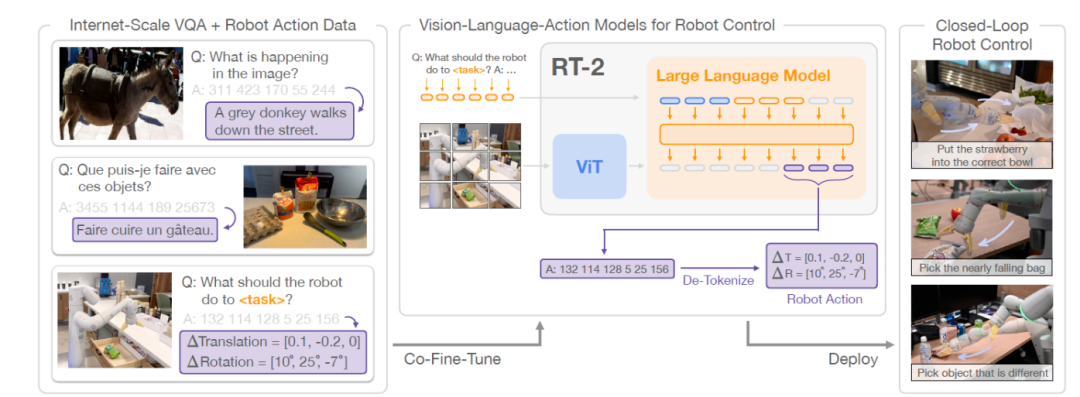
图片来源:谷歌
一家公司同时握住了自动驾驶的落地样本和机器人大脑的架构定义权。
OpenAI 和特斯拉则是既做模型又做本体的选手。尤其对 OpenAI 来说,模型在人形机器人中只是要素之一,其余全是没碰过的工程:本体、关节、驱动、制造与供应链。这条路难在本体最复杂、数据最贵、量产远未成熟;可它的容错性恰恰来自通用——专用机器人换个场景就作废,通用人形每多适应一个场景,能力就多沉淀一分。
再把视线转到国内。阿里巴巴系的蚂蚁灵波,给自己的定位只有五个字:给机器人做大脑。围绕这一句,它铺开了从透明物体深度感知、流式三维重建,到跨本体 VLA 和世界模型的一整套模型矩阵——最新的 LingBot-VLA 2.0,预训练数据达 6 万小时,覆盖 17 个品牌、20 种构型。
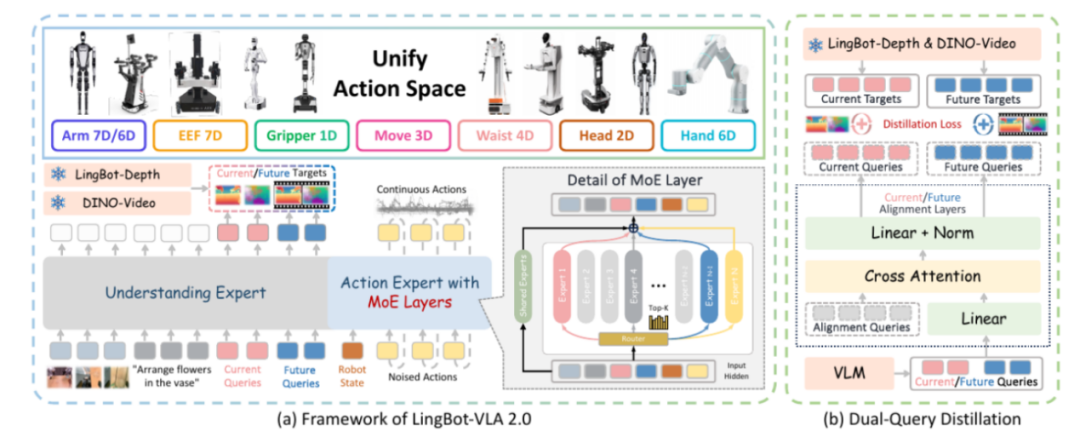
图片来源:蚂蚁灵波
字节则从自动驾驶切入:Seed 旗下的世界模型团队正在探索自动驾驶,拟布局无人物流。行业对这件事的解读几乎一致——自动驾驶不是终点,是字节通往具身智能的前一站。原因也很实在:具身智能最缺的是来自物理世界的真实数据,而汽车在真实道路上采集的环境数据与驾驶行为,同样富含物理规律,是它通往具身智能能借上力的东西。当然,驾驶数据和机器人操作数据终究不是一回事。
把这几家摊在一张图上看,除了特斯拉、OpenAI 选择了整机,其余几家的落点出奇一致:都不去碰本体。谷歌不造机器人,蚂蚁灵波把话说得很白——只供大脑;字节也是从模型侧切进去的。机械臂、减速器、关节、产线,这些又重又慢的活,没有一家数字公司愿意自己下场。它们落在物理世界的棋子,都压在了同一个位置上——理解这个世界,然后替它做决定。
不是跨界,是自然延伸
谷歌、OpenAI、阿里巴巴、字节,一批数字AI巨头先后落子物理AI,颇有跨界的嫌疑。守着大火的 AI Coding、Agent 不好吗,为什么非要来物理世界插上一脚?真进来,它们又有什么优势呢?
先看为什么。自 2022 年底 GPT 问世以来,数字AI靠 Scaling Law 一路推进:参数更多、数据更多、算力更多,能力就更强。但这条路正在变窄——它已经撞上数据、算力、能耗与可靠性的多重约束,放缓的迹象开始出现,而在对话、生图、Coding 这些纯数字任务上,进步空间也越来越少。与此同时,另一条路正在打开——数字智能正在突破虚拟边界,快速向有物理载体的具身智能演进,而走向物理世界,正是通往 AGI 的必经之路。对这批公司来说,物理世界不是新故事,是下一个还没被开垦的地方——AGI 这条路上,物理世界那一段还空着,谁先跑通,谁就有资格定义下一程。
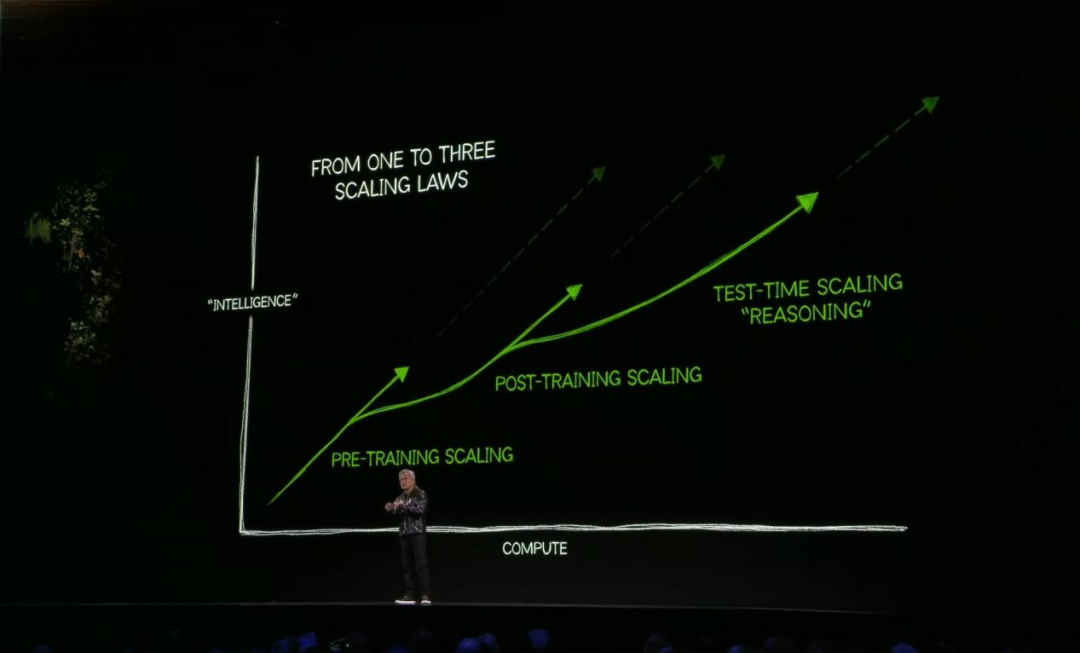
图片来源:英伟达
再看优势。Physical Intelligence 的团队把话说得很直白——机器人的核心瓶颈是"大脑"而非"躯体","你仍然受制于'机器人不够聪明'这一根本性挑战"。换句话说,眼下机器人做不好,不是因为它造得不够好,是因为它不够聪明。
而这批公司最不缺的,恰恰就是"聪明"。机器人要的那种"看懂世界"的常识来自数据,其中一大类——第一视角的视频——互联网上早已堆积如山,它们用海量数据预训练出的视觉语言模型,就能直接当机器人的常识底座。这层依赖早就存在:VLA 要靠更好的 VLM 基模,世界模型要靠更好的视频生成基模,基座模型的迭代节奏本就由大厂决定。谷歌的 RT-2 之所以能横扫当时的基线,做的不是搭新模块,而是直接基于 VLM、把适配压到最小;蚂蚁灵波把整套模型矩阵建在多模态基座之上;字节是从 Seed 世界模型切入自动驾驶的。它们手里握着的,本来就是那个底座。
所以这波入局,与其说是"跨界",不如说是把战场拉回自己的主场——物理世界最缺的是大脑,而大脑的底座一直握在它们手里。真正值得琢磨的不是它们为什么来,而是它们本来就在那儿。
自驾格局已定,具身才刚开局
这批数字 AI 巨头进来之后,会怎样改写物理AI行业的格局呢?
先看自动驾驶。这条路已经跑完了最难的一段:L3 已经站上落地的门槛——2025 年底工信部发出首批 L3 准入许可,行业普遍预计 L4 的窗口在 2028 年前后打开。方向没有悬念了,技术路线的分歧基本收敛,剩下的主要是安全、冗余和各种系统工程,都是苦活和累活。
这就决定了一件事:巨头进来,撼动不了原有的格局。不是它们不够强,而是这条赛道已经进入成熟期——技术路线在收敛,玩家也在收敛,Momenta 掌门人曹旭东甚至判断本土主要辅助驾驶玩家将收敛到三家左右。成熟意味着可发挥的空间变小、留给后来者的时间变少。更硬的一道门槛在产业侧:新供应商要挤进车企的体系,从车规流程认证、定点到量产装车,是动辄几年的周期,车规、安全、责任认定一样都压缩不了。所以,后来者更现实的选择是绕开正面战场:字节把方向放在了无人物流上,道理就在这里。
图片来源:Momenta
真正不一样的是具身智能。这里还处在极早期:拿人形机器人类比自动驾驶,大概还停在"L0",连本体形态都没收敛。Physical Intelligence 把机器人智能拆成三关——能力关已过,泛化关刚摸到门,性能关还在后面。路线也还在打架:蚂蚁灵波的沈宇军说得很直接,不能把数字世界的模型拿到具身数据上再训一遍就算完,具身需要自己的原生数据和原生架构——可"原生"长什么样,谁也说不准。位置同样没分完:谁做大脑、谁做本体、谁做整机,还在抢。规则和位置都没定,先发者来不及积累壁垒——数据飞轮没转、客户没锁定。于是它们手里那些在数字世界验证过的模型、算力和数据管线,在这里不是加分项,而是入场券——有机会自己上桌定规则。
写在最后
回头看,AI巨头们蜂拥进入物理AI领域是必然发生的顺理成章之举。至于如何影响现有的战局,自动驾驶那桌早就坐满了老玩家——L3 已经落地,头部们正在打扫战场,车规、流程一道都省不了,巨头再强也只是后来者;而具身智能那桌才刚发牌,规则没定、位置没分、标准空着,而它们手里那套在数字世界里滚过一遍的模型、算力和数据管线,在这张桌上不是加分项,是入场券。所以它们不是一群闯入者,而是一群原本就握着底座的人,恰好站在那扇刚打开的门前。门里的规矩还没来得及写——而这一次,执笔的人,大概率就是他们。
如果你也在关注大模型与物理世界的融合,云栈社区上聚集了不少正在折腾具身智能、VLA 和自动驾驶的开发者,不少实战经验都值得翻一翻。对模型 API 调用量大的朋友,也可以去看看 RouteFast.ai,接入主流大模型的中转方案,省去不少折腾。
 发表于 昨天 20:09
|
查看: 3|
回复: 0


