同时问过几个 AI 同一个问题的人,大概都有这种经历:一个讲得头头是道,另一个给出相反结论,第三家又补上前面都没提到的细节。看完反而更纠结:到底该信谁?于是开始复制答案、切换窗口,再让某个模型帮忙比较。问题还没解决,自己先当起了几个 AI 之间的传话员。今天要聊的 LLM Council,就是把这一整套流程做成了一个小工具。
项目简介
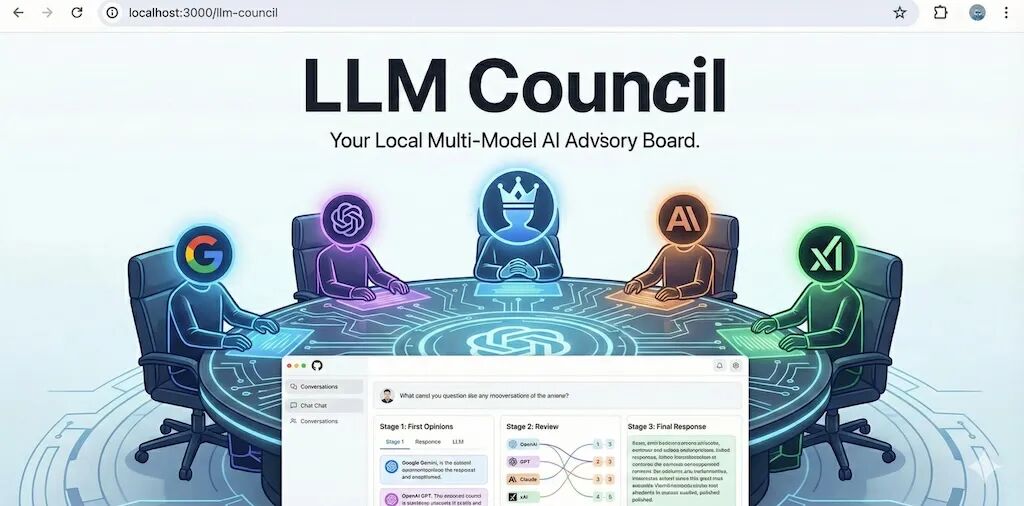
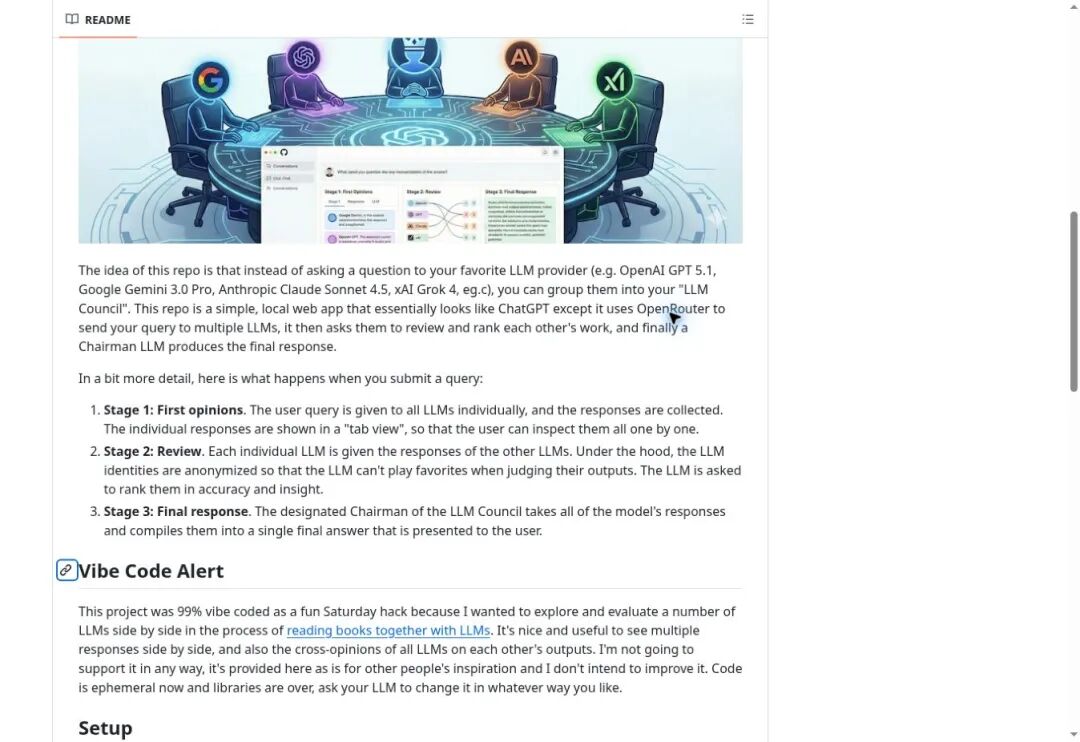
LLM Council 是 Karpathy 公开源码的一个本地网页应用。界面看起来像聊天工具,背后通过 OpenRouter 调用多个大模型。名字直译过来就是“大模型委员会”:你提交一个问题,几位“委员”先各自回答,再互相评审,最后由指定的“主席模型”汇总输出。它把多问几家、比较分歧、整理结论这三件事,合并到了一次提问里。
技术栈方面,前端使用 React,后端使用 Python 和 FastAPI,对话以 JSON 文件保存在本地,结构清楚,也方便继续修改。
先各答各的,保留不同思路
第一阶段,系统会把同一个问题分别发给配置好的模型,并行收集回答。页面用标签页展示各家结果,你可以逐个查看。有的回答擅长举例,有的更看重限制条件,也有的会给出不同的分析路径。比如研究一个技术方案时,可以同时问清楚适用场景、实现成本和潜在风险。先保留这些独立意见,进入下一步比较时,才有更充分的依据。
匿名“批作业”,还要说明理由
第二阶段最有意思:模型需要阅读已经收集到的答案,评价每份答案做得好和不好的地方,再给出排序。评审时,答案会被标记成 Response A、Response B 这类匿名标签,以弱化模型品牌的影响;展示时界面再映射回模型名称,方便对照。你能看到各家的评语、排序,以及汇总后的平均名次。它真正的价值,是把“哪里有分歧、为什么觉得这份更好”摆了出来。
当然,匿名评审不等于客观裁判。模型可能偏好某一种表达,也可能一起漏掉同一个事实。
最后请一位“主席”,把意见整理清楚
第三阶段,主席模型会拿到原始问题、各家的回答和评审结果,再综合成一份最终答案。这一步会参考答案间的共识与分歧,也会考虑评审意见,并非简单把排名第一的答案直接贴回来。整个流程跑完后,你既能读汇总稿,也能回看前面的回答和评价。遇到值得推敲的问题,可以顺着过程检查,而不是只盯着最后一句结论。
委员和主席,都可以自己换
模型配置在 backend/config.py 里。COUNCIL_MODELS 决定哪些模型参与回答和评审,CHAIRMAN_MODEL 决定由谁来做最终综合。你可以根据任务和预算调整组合。运行前也要检查模型标识是否仍能在 OpenRouter 使用,仓库示例中的版本不一定一直可调用。
当前实现主要围绕本次输入开展评审,保存历史记录并不意味着会自动把整段历史交给模型。提问时把背景、约束和希望比较的维度写完整,会更合适。
快速安装、使用
准备 Python 3.10 及以上版本、uv、Node.js 和 npm,然后下载项目并安装依赖:
git clone https://github.com/karpathy/llm-council.git
cd llm-council
uv sync
cd frontend
npm install
cd ..
在项目根目录创建 .env 文件,填入自己的 OpenRouter API Key:
OPENROUTER_API_KEY=你的密钥
接着分别打开两个终端。在项目根目录启动后端:
uv run python -m backend.main
另一个终端进入前端目录并启动:
cd frontend
npm run dev
浏览器打开 http://localhost:5173,就可以提交问题。建议先用一段背景完整、范围明确的提问试跑,更容易看出多模型比较的效果。
有两笔成本,要提前想清楚
一笔是调用费用。模型要先回答,再评审,最后还要综合,后续请求也会携带前面的长文本,通常比只问一个模型消耗更多。另一笔是等待时间。各阶段内部可以并行,但评审要等初稿,综合要等评审,完整流程仍然需要时间。
另外,本地运行的是网页和后端,推理请求会发往 OpenRouter 及所选模型服务,这并不是一套完全离线的模型系统。作者明确说过,这是一个周末实验项目,按现状提供,不承诺后续支持。把它当作个人探索和二次开发的起点,会更符合项目定位。
写在最后
LLM Council 最吸引人的地方,是让我们有机会看见多个模型怎样回答,又怎样挑出彼此的问题。读书时讨论观点、比较技术路线、审视方案,都可以试着用这种方式多看几个角度。如果你本来就习惯同一个问题问好几家,它能帮你省掉不少复制粘贴。至于最后该接受哪条判断,还是要结合材料自己拍板。
项目地址: https://github.com/karpathy/llm-council
 发表于 昨天 21:29
|
查看: 7|
回复: 0


