一个 GitHub 项目 REA 几天拿下 12 万星。它干的事一句话:让 AI Agent 不用看源码,就能逆向分析任意 App——微信、支付宝、抖音都已被纳入分析。软件没完蛋,但软件行业赖以生存的护城河,正在被这把“AI 逆向铲”一铲一铲地挖。
一、什么是 REA:挖护城河的那把铲子
REA,全称 Reverse Engineer Anything,开发者 ID 是 morluto。架构分三层:
- 最上层:Claude Code、Codex、Cursor 这类 AI 编程助手
- 中间层:REA 自己的 MCP服务器,把上面的自然语言指令翻译成对工具的调用
- 底层:Ghidra、Hopper、IDA Pro 这些做了几十年的逆向老兵,加上 Chrome DevTools、mitmproxy 这类抓包工具,总共 41 个,全部 CLI 化
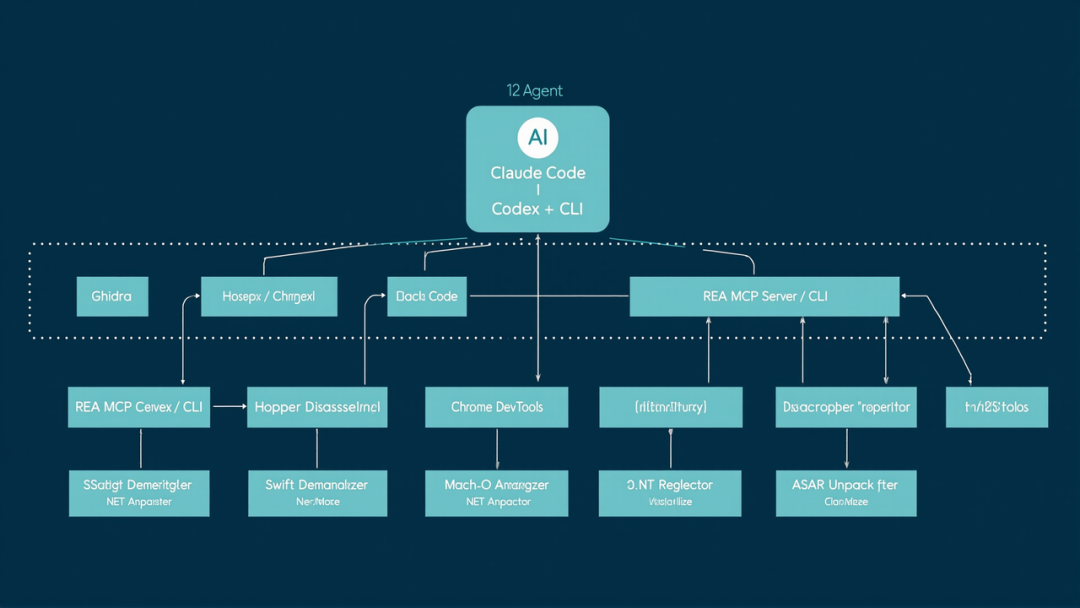
格式上,Mac / Windows / Linux 原生二进制、.NET、Electron、Android APK、iOS IPA、Web 应用,它都能处理。更重要的是,REA 默认在本地跑,二进制文件不上传,这和云端“一键扒站”是两条路线。
REA 团队在文档里写了几条边界:不自动还原原始源码、不承诺能完整克隆整个 App、每条结论都带证据链和局限说明。这是工具设计层面的克制,却挡不住它作为“AI 时代的逆向基础设施”这件事本身的分量。
二、护城河原本长什么样
要理解 REA 在挖什么,得先看清护城河原本是什么。
过去一款 App 的护城河,由三样东西垒起来:
第一层:技术门槛。逆向一款 App,得懂汇编、看得了 PE/ELF 文件结构、能和反调试死磕到底。Ghidra、Hopper 的 UI 本身就是为这个专业群体设计的。一个分析师想完整捋清一款中等复杂度应用的核心逻辑,没几周下不来。
第二层:时间成本。即使是最熟练的安全研究员,从二进制到能复现业务逻辑,分析周期也按周计。竞争对手想抄你,光“看懂”这一步就要几周——足够你跑出几个版本迭代。
第三层:复制保真度。这是最隐蔽的一层。人工逆向有“看得累”这个天然上限——一个分析师能耐心读完的代码量是有限的,遇到加壳、混淆、巨型函数体就会放弃。结果就是,对手抄你,往往只能抄个皮毛,核心细节照样抄不走。
这三层叠加,就是中小创新团队对抗大厂、原创产品对抗快速跟进者的全部本钱。它不高,但够用。
三、REA 怎么一铲一铲挖
REA 做的事,本质上是把上面那三层同步削薄。
挖第一层:技术门槛直接清零。你不需要懂汇编,也不需要懂 PE/ELF。你告诉 Claude Code“帮我看看微信支付那个加密签名怎么生成的”,剩下调度 Ghidra 反汇编、读协议字段、比对公开接口的活,Agent 自己干。
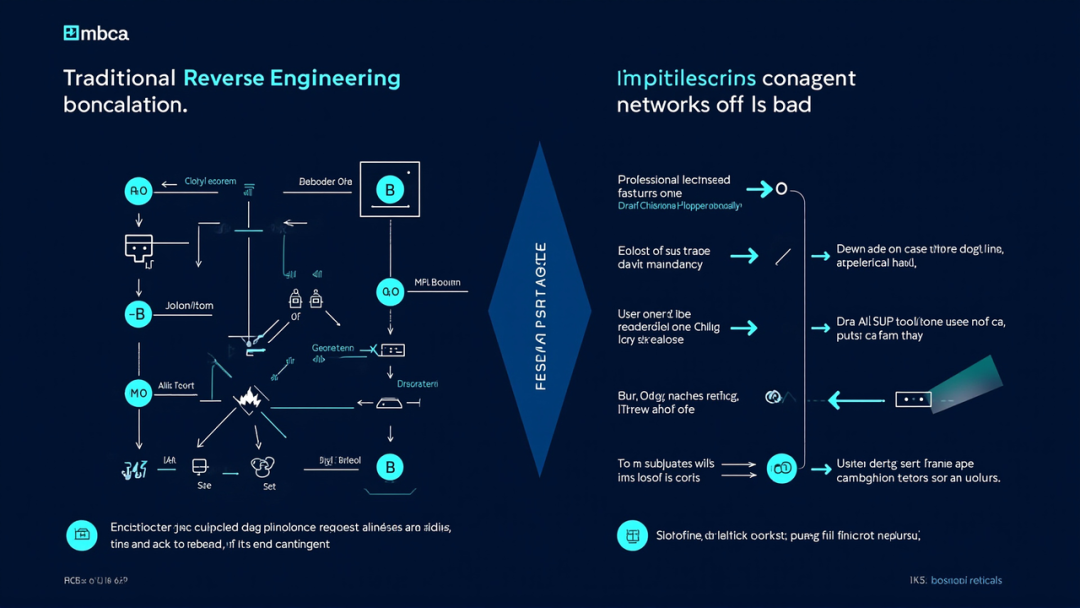
这张图把变化说清楚了:左边是专家在迷宫里手动操作几周,右边是 Agent 在三步直通车里自动跑完。Ghidra 还是那个 Ghidra,但会用它的人,从专家变成了所有配置了 Agent 的开发者。
挖第二层:时间从按周计变成按小时计。专业团队几周的分析周期,AI 几小时出报告。这不是“加速”,是质变。当一个原本按周计的成本被打到按小时计,市场格局会被重新洗牌——尤其是那些“靠时间差取胜”的微创新产品。
挖第三层:复制保真度大幅提高。这层最危险。人类分析师有“看得累”这个上限,AI Agent 没有。它可以把整个二进制的每个分支、每个调用、每个边界条件都走一遍。这种“全量扫描”能力,是人工分析从未拥有过的维度。结果是——以前只能抄到皮毛的对手,现在可能抄到八成真。
三层同步削薄之后,护城河没有消失,但它的“高度”和“宽度”都在肉眼可见地塌。
四、别以为护城河已经全挖完
但也别慌到立刻封盘所有项目。
当前可核查的案例只有 3 个:DX-Ball 游戏声像逻辑重建(3,205 个 x86 用例复现 63 个函数)、Notion Electron 版剪贴板桥接追踪、PC-98 游戏 TH94 子弹环计算恢复。前两个是结构清晰的 Electron 或单机游戏,第三个是 90 年代老古董。距离“一键克隆微信”这种量级,差距还相当明显。
更关键的是,剩下还有几块石头没被 REA 挖动:
- 强混淆与加壳。经过专业混淆的代码,控制流被刻意打乱,REA 拿到的反汇编结果会显著降级
- 服务端业务逻辑。现代 App 越来越多的核心逻辑(支付、风控、推荐)跑在服务端,客户端只是个壳,光逆向客户端拿不到核心
- 业务级反爬与风控。签名算法、行为指纹、设备指纹这些东西,即使被逆向出来,运行时也接不上服务端校验
所以护城河没被挖穿——但被挖薄了一大截。站在 2026 年这个时点看趋势,过去几年这道墙在肉眼可见地变矮。在还没彻底变平之前,整个软件行业的创新逻辑都需要重新算账。
五、护城河塌了,谁睡不着觉
大厂法务和合规负责人。你产品里那些藏在二进制里的“业务机密”——支付签名、推荐接口、风控规则——以前要花大力气逆向才能搞清,现在一条自然语言指令的事。更头疼的是法律:DMCA、《数字单一市场版权指令》、《计算机软件保护条例》都是按“人类行为主体”写的。当操作者变成 AI Agent,原告、被告、证据、管辖权、归责原则整套逻辑都得重搭。
中小软件团队的产品负责人。好消息:安全审计成本可能降一个数量级。坏消息:竞争对手也能用同样的方式扫你。你花了半年打磨的核心交互、独家的数据结构,在几天内会被对手的 Agent 提取出来。在以“微创新复制”为竞争底色的市场——印度、东南亚,包括国内某些赛道——这个影响会更直接。
投资人。REA 本身是 MIT 协议开源,不直接产生现金流,但催生的服务有想象空间:云厂商把 REA 能力打包成“AI 逆向审计”,安全公司集成进产品矩阵,“AI 合规咨询”帮企业评估自家产品暴露多少家底。过去几年 AI Coding 的爆点在“写代码”环节,REA 意味着“读代码”环节也开始被 AI 接管——这是从代码生成到软件解构的链路补全。
普通用户。你每天用的那些 App,可能比你想象的更容易被第三方看透。聊天记录、支付信息、行为轨迹的协议格式不再神秘,灰产和黑产拿到这些信息的门槛在显著降低。数据主权这件事,欧盟 GDPR、中国《个人信息保护法》都是按“数据由谁收集”来管。REA 的逻辑不一样——它不是去偷数据,而是去反推客户端的协议和存储结构,绕过了数据收集的环节。
六、结语:水位计还是警报器
护城河没被挖穿,但它的高度和宽度都在肉眼可见地塌。
这件事对软件行业意味着什么?创新者拿到的“先发优势”窗口期被显著压缩。过去仿制一款产品需要专业团队和几周时间;现在可能是一条自然语言指令加一个开源工具。在技术同质化竞争激烈的应用层,这层护城河原本就薄,REA 来了之后更薄。
对监管层来说,REA 的真正信号不是工具本身,而是法律对“非人类行为主体”的认知空白。知识产权法假设“人”是行为主体——原告、被告、证据、管辖权、归责原则整套逻辑都是按这个假设搭的。当 AI Agent 成为执行者,这套逻辑的每一环都需要重新设计。
水还在涨。REA 不是洪水,但它是一把尺——告诉你水面已经到了哪一格。
至于剩下的护城河够不够撑起下一轮创新周期,这取决于监管、企业、开发者社区接下来怎么回应。
版权声明:本文由华盟网原创发布,保留所有权利。
 发表于 14 小时前
|
查看: 1|
回复: 0


