微软在10月12日正式发布了面向大模型推理的 Maia 300 加速器,计划2027年投入生产部署。这颗芯片采用 TSMC N2P 计算 Die,配备 288GB HBM4,峰值内存带宽达到 18TB/s,单机架可容纳96颗加速器。
这些参数确实足够抢眼,但更值得深究的是它的内部架构。微软在这一代芯片上放弃了统一内存访问组织,转向跨 Chiplet 的 NUMA 架构,并借助软件控制的数据流架构(SDLA),将数据搬运的视野从片上 SRAM 一路扩展到机架级网络。
这背后的工程问题相当直白:当 AI 推理越来越受制于内存访问和通信开销时,单纯堆更多计算单元,未必能带来 Token 生成速度的同步提升。
微软 Azure Maia 300 加速器封装实物。来源:微软新闻中心
一、18TB/s 内存带宽,为何还要动内存架构?
AI 推理对内存的需求正在发生结构性变化。
Prefill 阶段要处理大量输入 Token,矩阵计算密集,计算吞吐量往往占据主导地位。但进入 Decode 阶段后,每生成一个 Token,都可能需要反复读取模型权重和已有的 KV Cache。上下文越长、并发会话越多,内存容量、带宽以及访问效率就越容易成为瓶颈。
Maia 300 配备了 8 组 HBM4,容量 288GB,带宽 18TB/s。与 Maia 200 相比,内存容量增加约 33%,带宽提升约 2.5 倍,而 FP4 峰值算力的增幅只有 36%—37%。这个比例已经很能说明设计取向:微软对内存带宽的扩张速度,明显快于计算吞吐量的扩张速度。
但 18TB/s 毕竟只是 HBM 接口的理论峰值。数据进入芯片后,还要经过内存控制器、片上网络、DMA 和本地缓存,才能最终到达执行计算的单元。如果每次运算都需要跨越较长的片上路径去取数,更多的 HBM 带宽并不会自动转化为更高的计算单元利用率。
二、从 UMA 到 NUMA:让数据靠近计算
NUMA,即非统一内存访问架构,原本是多路服务器 CPU 中相当常见的概念。
它的核心特征在于:不同计算单元访问不同内存区域时,延迟和带宽成本可能并不相同。如果软件无视这种差异,频繁发起远端访问,互连带宽就会被白白消耗掉。
Maia 300 把类似的局部性思想引入了加速器内部。微软将计算、内存控制器和 I/O 拆分为不同 Chiplet,让各个计算区域拥有邻近的内存资源。借助软件定义数据流架构 SDLA,程序可以显式地协调 DMA、局部 SRAM、HBM 以及 NoC 中的数据放置和移动。
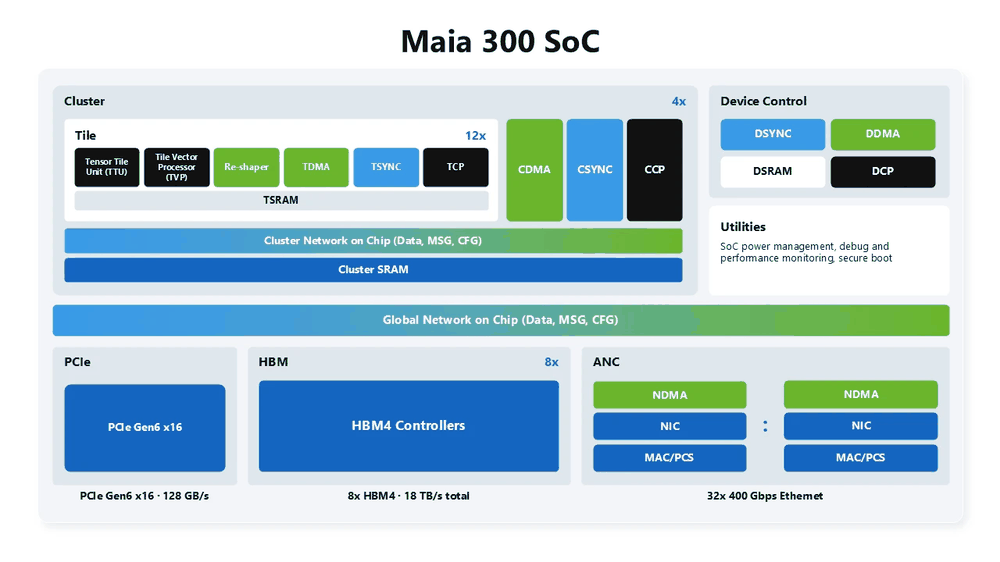
Maia 300 SoC 架构,计算 Tile、TSRAM、HBM4 控制器、全局片上网络与 ANC 网络控制器。来源:微软 Azure 官方博客
这意味着,编译器和运行时不仅要决定一个算子由哪个计算单元执行,还要考虑它的数据提前放在哪里、什么时候搬运、中间结果是否值得保留在片上。
举个例子:一段计算如果能复用本地 SRAM 中的数据,就不必每次都重新访问 HBM。DMA 还可以提前搬运下一批数据,让计算与传输尽可能重叠。
当然,NUMA 也会推高软件调度的复杂度。数据放置不合理时,远端访问照样会带来额外延迟和互连竞争。说到底,NUMA 本身不会凭空创造带宽,它提供的是让已有带宽被更有效利用的机会。
NUMA 本身不会创造带宽,它提供的是让已有带宽被更有效利用的机会。
三、为什么把计算、内存控制器和 I/O 拆成 Chiplet?
Maia 200 采用单片式 SoC,而 Maia 300 改用多 Chiplet 设计。计算部分使用 TSMC N2P 工艺,内存控制和 I/O 则由独立 Die 承担。
一个显而易见的原因是,不同电路对制造工艺的要求并不一致。张量计算单元需要大量晶体管,适合用先进工艺提升密度和能效;而高速 I/O 和内存接口受限于模拟电路、PHY、电压及封装连接等条件,未必能从最先进制程中获得同等收益。
把这些功能拆开,可以分别优化面积、工艺和成本,也为扩大 HBM 接口规模提供了更灵活的布局空间。
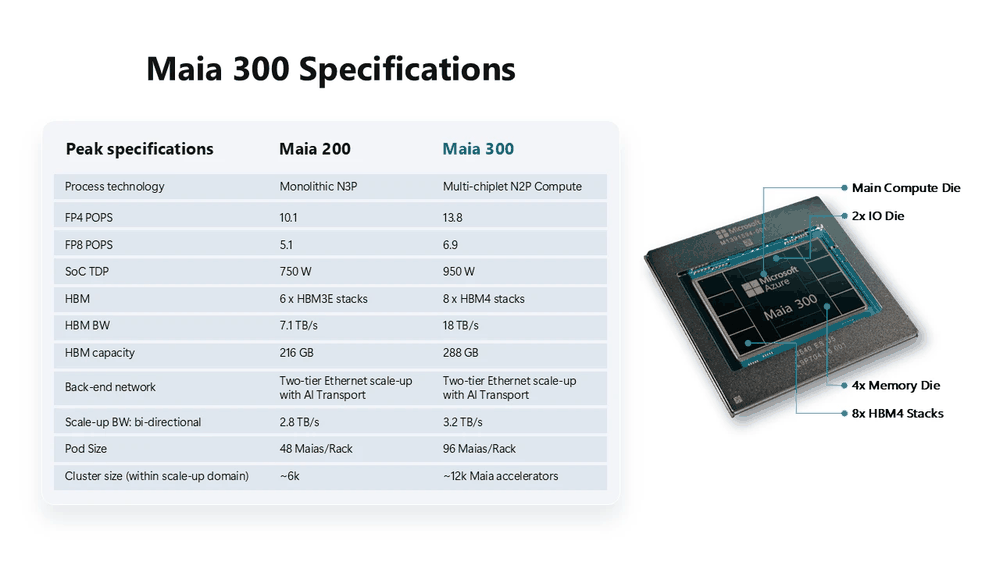
Maia 300 封装内包含 1 颗主计算 Die、2 颗 I/O Die、4 颗 Memory Die 与 8 组 HBM4 Stack,右侧为规格对照。来源:微软 Azure 官方博客
不过,Chiplet 并不意味着通信成本消失了。原来位于同一硅片上的模块,现在需要借助封装内互连来通信。跨 Die 访问会带来额外的物理距离、能耗与时序约束,内部数据流必须与封装结构协同设计。
这也是 Maia 300 采用 NUMA 的重要背景:当芯片从单片式设计转向多 Die,软件必须更清楚地知道数据究竟放在哪里。
四、从片上 NoC 到机架网络:数据流向外延伸
Maia 300 还有一项值得关注的变化:微软将 Scale-Up 网络视为 SDLA 的延伸。
单颗加速器内部,数据通过 SRAM、DMA、HBM 和 NoC 流动;多颗加速器协同推理时,模型张量、中间结果以及部分推理状态还需要在设备之间传输。
Maia 300 采用基于以太网的定制 AI 传输机制,单颗加速器配置 32 个 400Gb/s 网络端口。机架内部同时使用加速器之间的直接连接和交换路径,96 颗加速器组成一个 Pod;跨机架则通过第二级光交换网络扩展,最多连接 128 个机架、12,288 颗加速器。
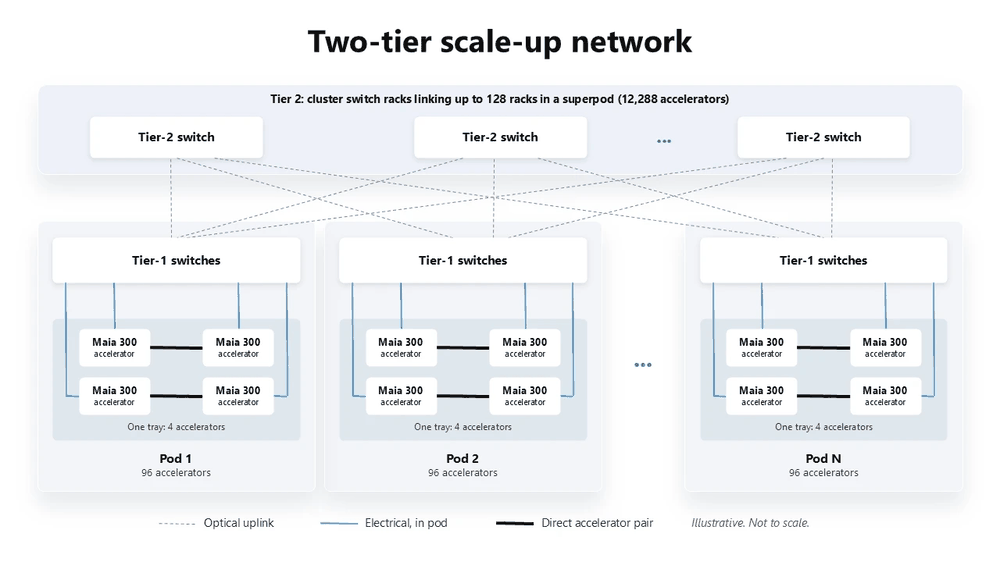
两级 Scale-Up 网络:机架内 Tier-1 交换组成 96 颗加速器的 Pod,Tier-2 光交换将最多 128 个机架连成 12,288 颗加速器的超级 Pod。来源:微软 Azure 官方博客
这套设计瞄准的是大模型分布式推理中持续增长的通信需求。比如张量并行需要在不同加速器之间交换部分计算结果;Prefill 和 Decode 分离部署时,推理状态也要跨设备迁移。通信路径越复杂,计算单元等待数据的概率就越高。
微软希望通过统一的数据流编程模型,让片上搬运和跨设备通信使用相互衔接的抽象,减少不必要的数据复制与 Host CPU 介入。
但这里需要区分两个概念:统一通信模型不等于统一访问延迟。 同一计算托盘、同一机架以及跨机架之间,仍然存在明显不同的物理距离、带宽竞争和网络延迟。所以软件必须同时理解计算拓扑与通信成本。
五、Maia 300 的性能提升,究竟来自哪里?
微软公布的 Maia 300 单机架配置为 96 颗加速器,功耗预算 167kW,合计 27.6TB HBM 容量和约 1.7PB/s 理论聚合内存带宽。
微软还宣称,相比 48 颗加速器的 Maia 200 机架,Maia 300 机架的 Token 吞吐量最高提升 7 倍,性能功耗比提升超过 2.5 倍。
这些数字值得关注,但不能直接解读为单颗芯片性能提升了 7 倍,毕竟新机架的加速器数量也翻了一倍。不同模型、批处理规模、上下文长度和延迟目标,都会影响实际的 Token 吞吐量。
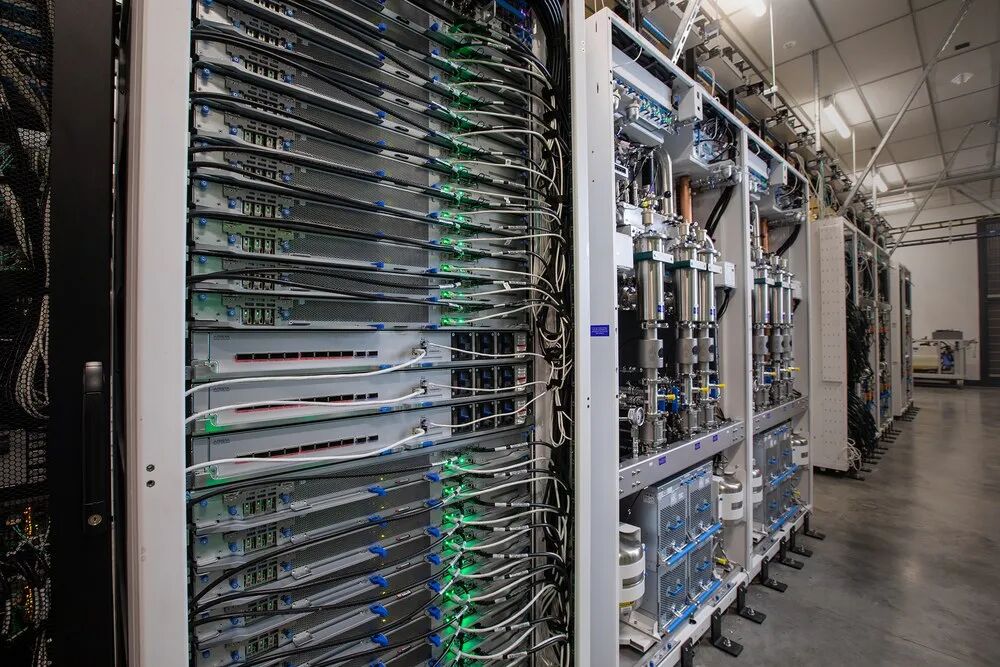
Maia 300 液冷机架与计算托盘(单机架 96 颗加速器分布于此)。来源:微软新闻中心
从公开架构来看,性能提升并非只来自 N2P 制程和计算单元升级,而是多种机制共同作用的结果:HBM4 提供更高带宽,NUMA 改善数据局部性,片上 SRAM 减少重复访问,低精度格式降低每个 Token 需要搬运的数据量,而 Scale-Up 网络则扩大了可协同执行的加速器规模。
这些机制之间存在明显的相互依赖。更大的 HBM 带宽需要足够高效的片上数据路径来承接,更多计算单元需要更好的数据复用策略,而更多加速器又会反过来加重跨设备通信的压力。如果数据流组织没有同步改善,任何一层的硬件升级都可能只是把瓶颈推到了下一层。
六、AI 芯片架构正在经历什么变化?
Maia 300 展示了一条值得半导体工程师关注的设计路线。过去讨论 AI 加速器性能,人们往往首先看计算单元数量、峰值 FLOPS 和制造工艺。如今,大模型推理对 HBM、片上 SRAM、Chiplet 互连和机架网络提出了越来越具体的要求。
Maia 300 把这些问题放在同一套数据流架构中统一处理。从 UMA 转向 NUMA,从单片 SoC 转向多 Chiplet,再到将 Scale-Up 网络纳入软件调度模型,背后是一致的设计目标:让数据尽可能在靠近计算的位置完成存储、转换和传输。
这并不意味着 NUMA 会成为所有 AI 芯片的标准答案。对于规模较小、数据访问规律简单的加速器,统一内存组织仍然能以更低的软件复杂度换取不错的收益。Chiplet 的封装成本、跨 Die 通信和 NUMA 调度开销,也需要通过具体工作负载来证明其价值。
但 Maia 300 至少说明了一件事:AI 推理芯片的竞争,正在从计算单元本身,进一步延伸到数据如何穿过整颗芯片、整个封装乃至整个机架。
 发表于 1 小时前
|
查看: 7|
回复: 0


