Qwen 这次可能要把大小模型一起端上来了。
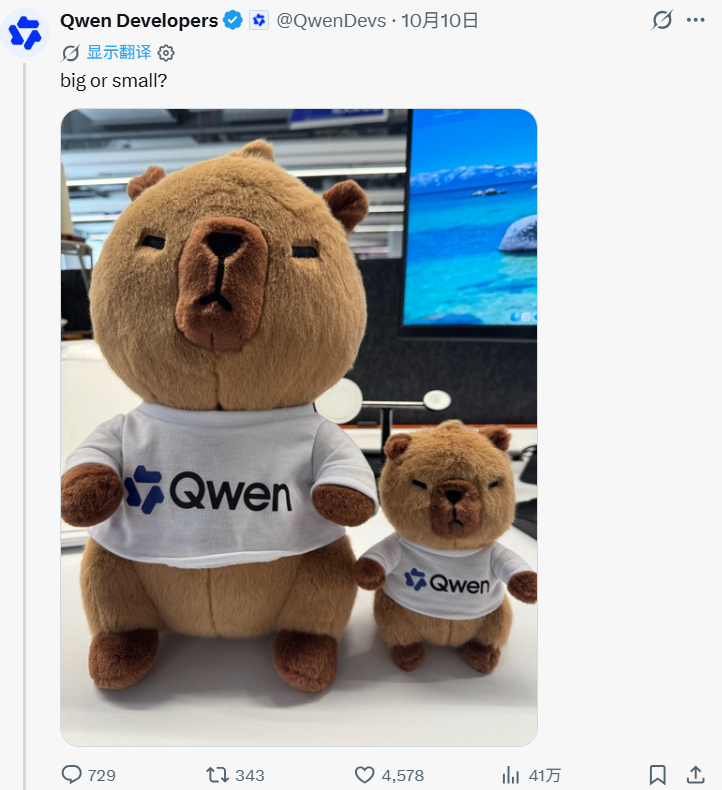
10月10日,Qwen 官方账号在 X(Twitter)上发布了一张水豚主题图片,配文询问:“big or small?”(大的还是小的?)
几个小时后,官方又回复:“alright guys, let's do both!”(好吧,大小都要!)
两条看似轻松的互动,很快引发了社区对 Qwen 新一代模型的猜测。结合随后出现的 Qwen4-27B 相关视觉物料,外界开始将目光投向两款模型:Qwen4-27B 与旗舰型号 Qwen4-Max。
目前,这些消息尚未得到官方确认,但两款型号各自的看点已经引发讨论。
Qwen4-27B 的看点在于本地部署。27B 参数规模为开发者提供了一个值得关注的选择,配合量化技术,有望适配更多硬件环境,用于本地推理、代码辅助等任务。
相比之下,Qwen4-Max 是否开放权重,可能是这次传闻中更值得关注的部分。如果旗舰型号也开放权重,开发者就有机会在自有基础设施上部署和适配更大规模的模型,进一步探索推理优化、私有化部署和复杂任务应用。
而在等待 Qwen4 消息的同时,Qwen 此前就已经公布过一款与下一代架构探索有关的开放权重模型。
今年8月,Qwen 推出 Qwen3.8-Flash-Next,作为探索下一代 Qwen4 架构的开放权重模型。
它仍属于 Qwen3.8 系列,并非正式的 Qwen4 版本,但也让开发者得以提前关注新架构的变化。
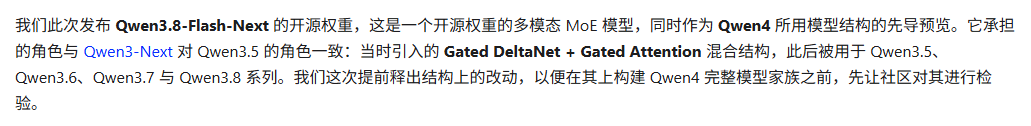
这款模型的技术变化集中在注意力机制、残差结构、Embedding 和训练优化等方面。在规模上,Qwen3.8-Flash-Next 的主模型参数量为 125B,每个 Token 激活约 6B 参数,另有 51B 的 N-gram Embedding 参数。官方公布的技术资料显示,该模型原生支持 262,144 Token 上下文,并可通过 YaRN 扩展至 100 万 Token。
到了9月,新任 LLM 负责人刘大一恒官宣了即将到来的 Qwen4 家族,涵盖 Qwen4-Max、Qwen4-Flash、Qwen4-Plus 和 Qwen4-27B 等多个型号。
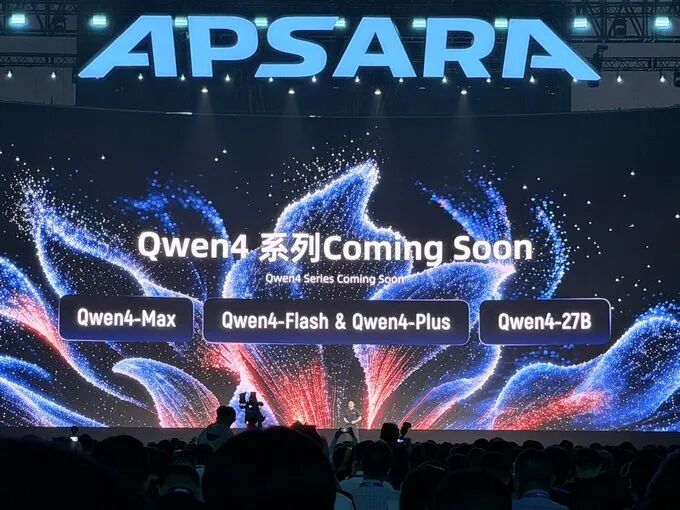
Qwen 团队还透露了更长远的训练计划,未来将训练参数规模达到 5T 至 10T 的模型。
与此同时,有传闻称 Qwen4 早期测试样本的表现已接近 Fable、Claude Opus 等模型,甚至有人将其与 GPT-6 进行比较。
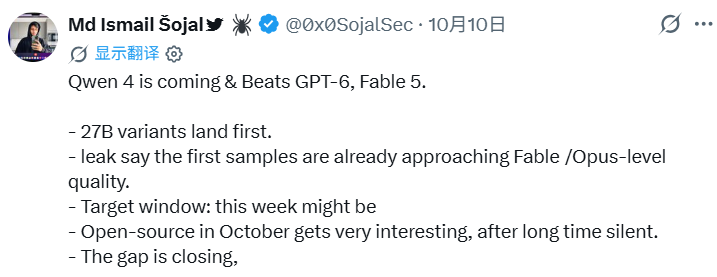
此次 Qwen 官方账号接连发布“big or small?”和“let's do both!”两条互动内容,又为这些猜测添了一把火。
眼下,Qwen 官推的“大小都要”已经给社区留下了足够的想象空间。Qwen4-27B 能否成为本地部署的新选择,Qwen4-Max 又会以什么形式开放,仍有待官方揭晓。
对于需要在大模型 API 与本地部署之间灵活切换的开发者,RouteFast.ai 提供了多模型中转方案,可以关注。
也欢迎在云栈社区继续关注 Qwen 系列开源动态。
 发表于 8 小时前
|
查看: 1|
回复: 0


