今天是2026年10月15日,我们来看WMT26翻译大模型冠军方案的最新进展。这次有两个模型值得关注:Lumen(Qwen‑MT‑Lumen) 与 Wayfinder。
值得注意的是,WMT26在评估侧做出了重大改动:彻底弃用BLEU/COMET等自动指标做官方排名,全部依靠全新cESA大规模对比式人工评测。这是一套动态评估机制,性能更好的模型会获得更多人工标注样本,从源头规避自动指标过拟合的风险。评测范式的变化值得持续跟进。
一、WMT26翻译大模型方案的实现思路
先给出三份核心资料:WMT26官方报告、Qwen-MT-Lumen论文、Wayfinder论文。下面分别拆解两个模型的技术路线。
1、Lumen(Qwen‑MT‑Lumen)
Lumen证明了这样一条路线:14B规模的开源模型,经过面向翻译任务的全套训练(持续预训练+SFT+在线偏好对齐+策略蒸馏),可以逼近闭源巨头的翻译能力,并且能兼顾复杂指令、JSON/HTML结构化翻译,适合私有化落地。
具体的四阶段训练流水线如下:
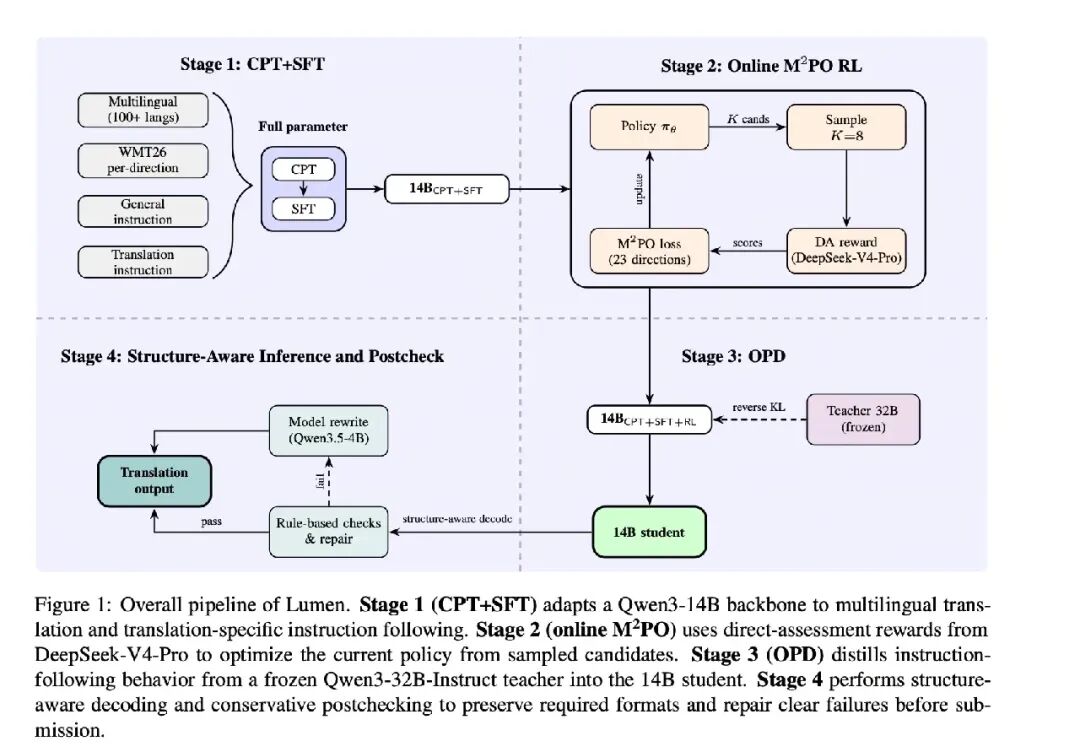
Stage1:CPT持续预训练+SFT监督微调
CPT持续预训练+SFT监督微调是整套方案的基础。
CPT阶段使用贴合WMT26任务领域(新闻、社交、软件、口语、事实核查、教育)的多语言语料做持续预训练,重点补强小语种与低资源语言能力。
SFT阶段混合双语平行翻译数据与翻译指令专用数据(风格正式/口语、术语表、JSON结构化输出)。大部分样本是普通翻译,小部分加入翻译约束指令,指令数据主要依靠LLM合成。
Stage2:Online‑M²PO在线多视角多对偏好优化(RL偏好对齐)
这个阶段主要提升翻译质量,对指令跟随的增益有限。
区别于离线固定偏好数据集,模型实时采样候选翻译,使用DeepSeek‑V4‑Pro作为LLM裁判打分,动态生成偏好样本做强化学习,重点提升翻译的忠实度与流畅度。
Stage3:On‑Policy Distillation在线策略蒸馏
这一阶段的教师模型是冻结的Qwen3‑32B‑Instruct,学生模型则是14B的Lumen。关键点在于:不是拿教师输出做静态数据集蒸馏,而是学生自己生成翻译轨迹,教师对学生生成的每一步token输出做监督,把大模型更强的指令遵循能力迁移过来。这正好解决了RL阶段模型翻译质量不错、但遵守格式与风格指令偏弱的短板。
Stage4:结构感知推理+选择性修复
这个阶段专门处理JSON、HTML结构化输入:只翻译文本内容,保留key、占位符与标签。
同时使用规则检查:长度异常、循环重复、脚本错误、源文本残留。轻微问题做确定性修复,严重问题调用Qwen3.5‑4B重写。普通正确译文不会改动,避免引入新错误。
2、Wayfinder
Wayfinder证明了Agent融合路线的上限:不需要训练新权重,通过多候选+匿名选择+严格的错误后校验,也可以拿到SOTA翻译效果。但代价是极高的推理成本,适合离线任务,不适合线上高并发场景。
这套方案同样是四阶段Agent流水线:
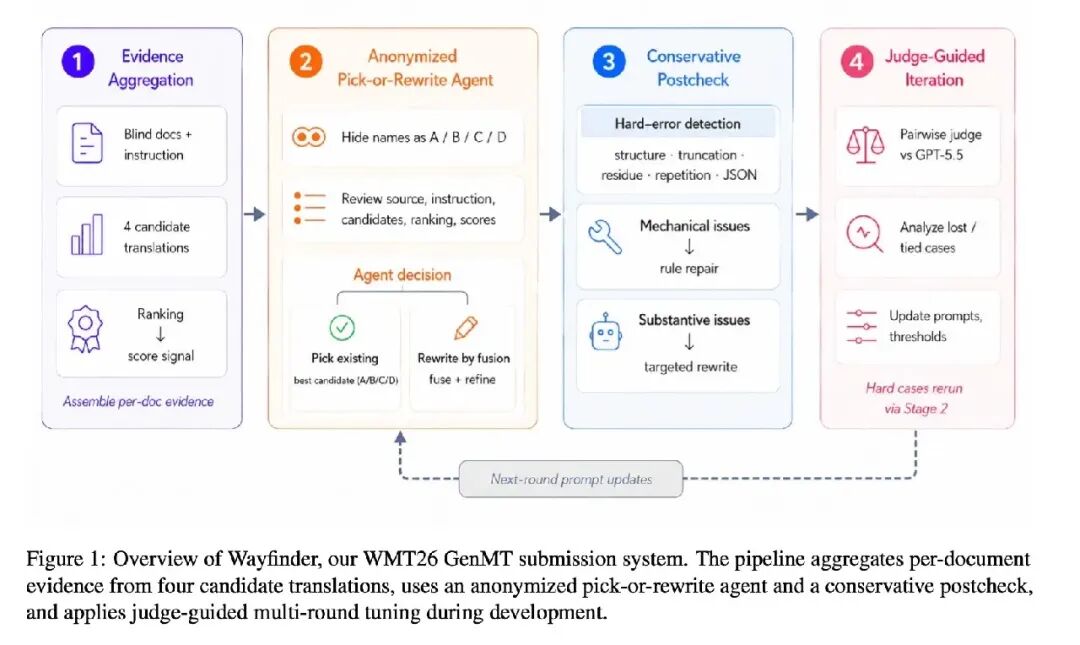
一阶段:证据聚合Evidence Aggregation
将源文档、翻译指令、元信息、4份候选翻译,加上DeepSeek‑V4‑Pro给出的统一打分排序结果,组装成每个文档的完整证据记录。
二阶段:匿名选择/改写Agent Anonymized Pick‑or‑Rewrite Agent
具体来说,将4个模型输出匿名标记为A/B/C/D,隐藏原始模型身份,防止Agent对某家模型产生固有偏见。
Agent面临二选一:pick 直接原样挑选最好的一份候选;或者 rewrite 融合多个候选做改写修正。整个过程严格遵循一套优先级评估标准:指令遵守>结构完整>忠实度>术语实体>语法>语体流畅度。
三阶段:保守后检查Conservative Postcheck
这一阶段只修复严重硬错误,禁止做通用润色改写。
检测项包括:截断、重复生成、JSON损坏、语种错乱、空输出。简单机械问题做确定性修复;实质性错误才调用修复Agent重写;没问题的译文完全不动。
四阶段:裁判引导迭代Judge‑Guided Iteration(仅开发调优阶段,非推理阶段)
开发阶段拿GPT‑5.5作为锚定基线,识别表现差的文档,迭代更新prompt和后处理规则,重跑困难样本,逐步优化整套Agent流程。
最后还需要再次强调:WMT26放弃自动指标、全部采用大规模对比人工评测cESA,代表机器翻译评估范式正在转向。自动指标容易被过拟合,而专项测试套件可以挖掘普通评测看不见的缺陷。这条评测侧的变化,可能比单个模型的方案更值得长期关注。
 发表于 半小时前
|
查看: 6|
回复: 0


