在云栈社区的技术讨论中,经常有同学问:MySQL 的自增 id 平时用得好好的,万一哪天真用完了会怎样?其实每种自增 id 都有自己的应用场景,达到上限后的表现也各不相同。这篇文章就来系统梳理一下。
MySQL 的自增 id 都定义了初始值,然后不断累加。虽然自然数没有上限,但计算机里表示数字的字节长度是有限的,存储自然就有上限。比如无符号整型(unsigned int)占 4 个字节,上限就是 2^32 - 1。那自增 id 用完,到底会发生什么?
表定义自增值 id
表定义的自增值达到上限后,再申请下一个 id 时,得到的值会保持不变。
mysql> create table t(id int unsigned auto_increment primary key) auto_increment=4294967295;
Query OK, 0 rows affected (0.01 sec)

mysql> insert into t values(null);
Query OK, 1 row affected (0.00 sec)

mysql> show create table t;
+-------+-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| Table | Create Table                                                                                                                                                                      |
+-------+-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| t     | CREATE TABLE `t` (
  `id` int unsigned NOT NULL AUTO_INCREMENT,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=4294967295 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci |
+-------+-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
1 row in set (0.00 sec)

-- 成功插入一行 4294967295
mysql> insert into t values(null);
ERROR 1062 (23000): Duplicate entry '4294967295' for key 't.PRIMARY'
第一个 insert 成功后,该表的 AUTO_INCREMENT 还是 4294967295,导致第二个 insert 又拿到相同的自增 id 值,再试图执行插入语句时,直接主键冲突。
2^32 - 1(4294967295)并不是一个特别大的数,一个频繁插入、删除数据的表是有可能用完的。所以建表时就需要考虑你的表是否有可能达到该上限,若有,就应创建成 8 字节的 bigint unsigned。
InnoDB 系统自增 row_id
如果你创建的 InnoDB 表没有指定主键,InnoDB 会自动创建一个不可见的、6 字节的 row_id。InnoDB 维护了一个全局的 dict_sys->row_id 值。
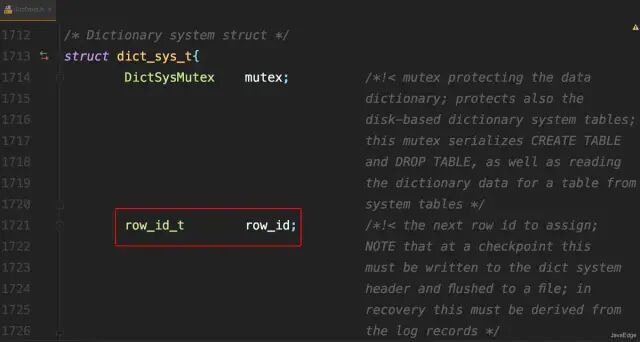
所有无主键的 InnoDB 表,每插入一行数据,都会将当前的 dict_sys->row_id 作为这行数据的 row_id,然后把 dict_sys->row_id 加 1。
代码实现时,row_id 是一个 8 字节的无符号长整型(bigint unsigned),但 InnoDB 在设计时给 row_id 只留了 6 个字节的空间。所以写到数据表里时只会保留最后 6 个字节,这就带来两个特征:
- row_id 写入表中的值范围,是从 0 到
2^48 - 1
- 当
dict_sys.row_id = 2^48 时,如果再有插入行为申请 row_id,拿到以后再取最后 6 个字节就是 0
也就是说,写入表的 row_id 从 0 到 2^48 - 1。达到上限后,下一个值就是 0,然后继续循环。
2^48 - 1 已经很大了,但如果一个 MySQL 实例活得足够久,还是有可能触及上限。
在 InnoDB 里,申请到 row_id=N 后,就会把这行数据写入表中;如果表中已经存在 row_id=N 的行,新写入的行就会覆盖原有的行。
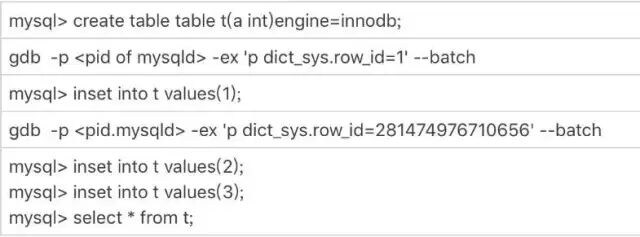
想验证这个结论,可以通过 gdb 修改系统的自增 row_id。用 gdb 只是为了便于复现问题,只能在测试环境使用。
row_id 用完的验证序列:
row_id 用完的效果验证:
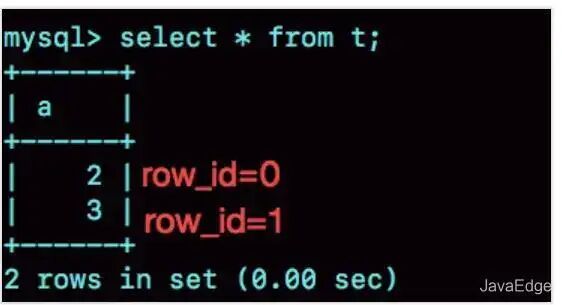
可以看到,在我用 gdb 将 dict_sys.row_id 设置为 2^48 之后,再插入 a=2 会出现在表 t 的第一行,因为该值的 row_id=0。
之后再插入 a=3,由于 row_id=1,就覆盖了之前 a=1 的行,因为 a=1 这一行的 row_id 也是 1。
所以建议在 InnoDB 表中主动创建自增主键:当表自增 id 到达上限后,再插入数据时会报主键冲突错误。
毕竟覆盖数据就意味着数据丢失,影响数据可靠性;而报主键冲突只是插入失败,影响可用性。一般来说,可靠性要优于可用性。
Xid
redo log 和 binlog 有个共同字段 Xid,用来对应事务。那 Xid 在 MySQL 内部是怎么生成的呢?
MySQL 内部维护了一个全局变量 global_query_id:
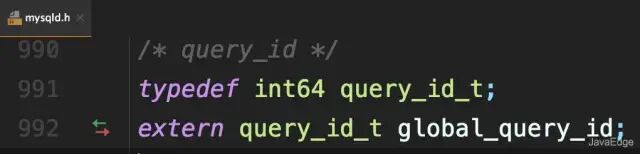
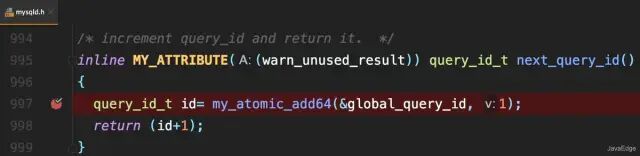
每次执行语句时,把它赋值给 query_id,然后给这个变量加 1:
如果当前语句是该事务执行的第一条语句,MySQL 还会同时把 query_id 赋值给该事务的 Xid:
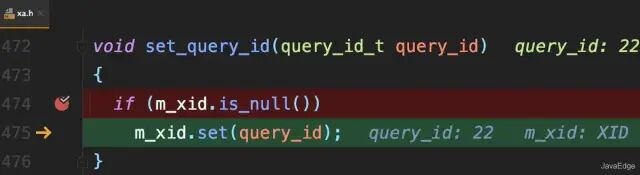
而 global_query_id 是一个纯内存变量,重启之后就清零了。所以同一个 DB 实例里,不同事务的 Xid 可能相同。
不过 MySQL 重启之后会重新生成新的 binlog 文件,这就保证了同一个 binlog 文件里的 Xid 唯一。
虽然 MySQL 重启不会导致同一个 binlog 里面出现两个相同 Xid,但如果 global_query_id 达到上限,就会继续从 0 开始计数。理论上还是可能出现同一个 binlog 里面出现相同 Xid。
因为 global_query_id 是 8 字节,上限是 2^64 - 1。要出现这种情况,需要满足:
- 执行一个事务,假设 Xid 是 A
- 接下来执行
2^64 次查询语句,让 global_query_id 回到 A——2^64 太大了,这种可能性只存在于理论中
- 再启动一个事务,这个事务的 Xid 也是 A
Innodb trx_id
Xid 由 server 层维护,InnoDB 内部使用 Xid,是为了关联 InnoDB 事务和 server。
但 InnoDB 自己的 trx_id,是另外维护的事务 id(transaction id)。
InnoDB 内部维护了一个 max_trx_id 全局变量,每次需要申请一个新的 trx_id 时,就获取 max_trx_id 的当前值,然后把 max_trx_id 加 1。
InnoDB 数据可见性的核心思想是:每一行数据都记录了更新它的 trx_id。当一个事务读到一行数据时,判断这行数据是否可见,就是通过事务的一致性视图与这行数据的 trx_id 做对比。
对于正在执行的事务,你可以从 information_schema.innodb_trx 表中看到事务的 trx_id。看下面这个案例:
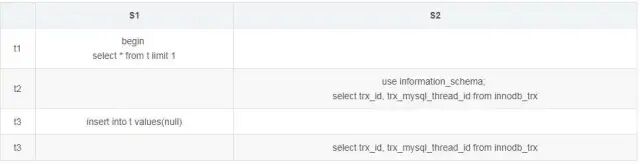
S2 的执行记录:
mysql> use information_schema;
Reading table information for completion of table and column names
You can turn off this feature to get a quicker startup with -A

Database changed

mysql> select trx_id, trx_mysql_thread_id from innodb_trx;
+-----------------+---------------------+
| trx_id          | trx_mysql_thread_id |
+-----------------+---------------------+
| 421972504382792 |                  70 |
+-----------------+---------------------+
1 row in set (0.00 sec)

mysql> select trx_id, trx_mysql_thread_id from innodb_trx;
+---------+---------------------+
| trx_id  | trx_mysql_thread_id |
+---------+---------------------+
| 1355623 |                  70 |
+---------+---------------------+
1 row in set (0.01 sec)
S2 从 innodb_trx 表里查出的这两个字段中,第二个字段 trx_mysql_thread_id 就是线程 id。显示线程 id,是为了说明这两次查询看到的事务对应的线程 id 都是 5,也就是 S1 所在线程。
t2 时显示的 trx_id 是一个很大的数;t4 时刻显示的 trx_id 是 1289,看上去是一个比较正常的数字。这是为什么?
t1 时,S1 还未涉及更新,是一个只读事务。对于只读事务,InnoDB 并不会分配 trx_id:
- t1 时,trx_id 的值就是 0。而这个很大的数,只是显示用
- 直到 S1 在 t3 时执行 insert,InnoDB 才真正分配 trx_id。所以 t4 时,S2 查到该 trx_id 的值就是 1289
除了明显的修改类语句,如果在 select 语句后面加上 for update,那也不是只读事务。
- update 和 delete 语句除了事务本身,还涉及标记删除旧数据,也就是要把数据放到 purge 队列里等待后续物理删除,这个操作也会把
max_trx_id+1,因此在一个事务中至少加 2
- InnoDB 的后台操作,比如表的索引信息统计这类操作,也会启动内部事务,因此你可能看到 trx_id 值并不是按照加 1 递增的
t2 时查到的很大数字是怎么来的?
每次查询时,由系统临时计算:
当前事务的trx变量的指针地址转成整数,再加上2^48
这样可以保证:
- 因为同一只读事务在执行期间,它的指针地址不会变,所以无论在 innodb_trx 还是在 innodb_locks 表里,同一个只读事务查出来的 trx_id 都会是一样的
- 如果有并行只读事务,每个事务的 trx 变量指针地址肯定不同。这样,不同并发只读事务查出来的 trx_id 就是不同的
为什么加 2^48?
保证只读事务显示的 trx_id 值比较大,正常情况下就会区别于读写事务的 id。但 trx_id 跟 row_id 的逻辑类似,定义为 8 个字节。
理论上还是可能出现一个读写事务与一个只读事务显示的 trx_id 相同。不过概率很低,也没什么实质危害,可以忽略。
为什么只读事务不分配 trx_id?
- 减小事务视图里活跃事务数组的大小。当前正在运行的只读事务不影响数据可见性判断。所以创建事务一致性视图时,InnoDB 只需要拷贝读写事务的 trx_id
- 减少 trx_id 的申请次数。执行一个普通的 select 语句也要对应一个只读事务,所以只读事务优化后,普通查询语句无需申请 trx_id,大大减少了并发事务申请 trx_id 的锁冲突
由于只读事务不分配 trx_id,trx_id 的增速显然会变慢。
但 max_trx_id 会持久化存储,重启也不会重置为 0。理论上,只要一个 MySQL 实例跑得够久,就可能出现 max_trx_id 达到 2^48 - 1,然后从 0 开始循环。
达到该状态后,MySQL 就会持续出现一个脏读 bug。
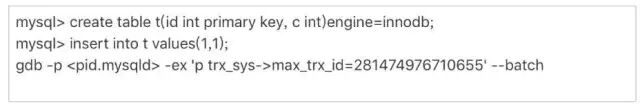
首先把当前的 max_trx_id 修改成 2^48 - 1(这里隔离级别是可重复读):
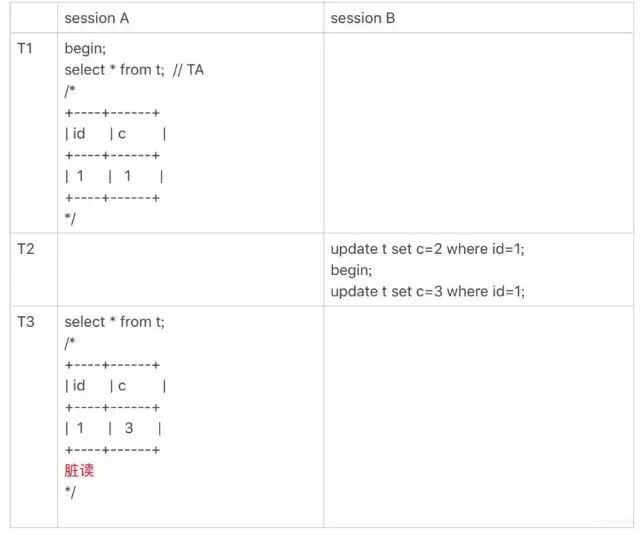
因为系统的 max_trx_id 被设置成 2^48 - 1,所以 session A 启动的事务 TA 的低水位就是 2^48 - 1。
t2 时:
- session B 执行第一条 update 语句的事务 id =
2^48 - 1
- 第二条事务 id 就是 0 了,这条 update 执行后生成的数据版本上的 trx_id=0
t3 时:
session A 执行 select 的可见性判断:c=3 这个数据版本的 trx_id(0),小于事务 TA 的低水位(2^48 - 1),所以认为该数据可见。
但这就产生了脏读。
由于低水位值会持续增加,而事务 id 从 0 开始计数,导致系统在该时刻后,所有查询都会出现脏读。
并且 MySQL 重启时 max_trx_id 也不会清 0,也就是说,即使重启 MySQL,这个 bug 仍然存在。那这个 bug 也只是存在于理论上吗?
假设一个 MySQL 实例的 TPS 是 50 万,持续运行,大约 17.8 年后就会出现该情况。从 MySQL 真正流行到现在,恐怕还没有实例跑过这个上限。不过,只要 MySQL 实例服务时间够长,就必然会撞上这个 bug。
这个分析也有助于加深对低水位和数据可见性机制的理解。
thread_id
系统保存了一个全局变量 thread_id_counter:
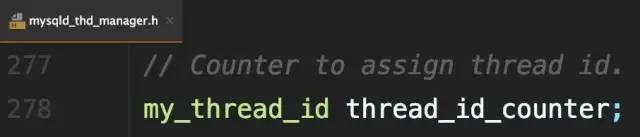
每新建一个连接,就将 thread_id_counter 赋值给这个新连接的线程变量 new_id。
thread_id_counter 定义为 4 个字节,因此达到 2^32 - 1 后,就会重置为 0,继续增加。
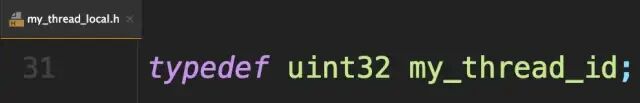
但你不会在 show processlist 中看到两个相同的 thread_id,因为 MySQL 使用了一个唯一数组:
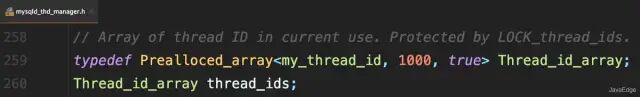
给新线程分配 thread_id 的逻辑如下:
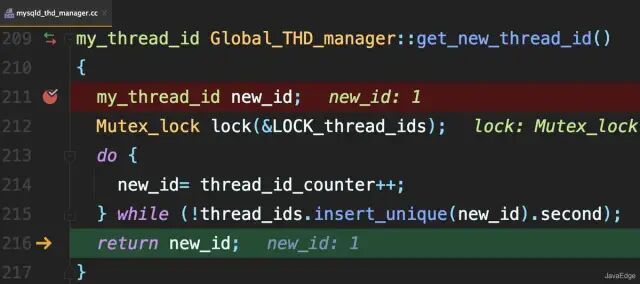
总结
每种自增 id 有各自的应用场景,达到上限后的表现也完全不同:
- 表的自增 id 达到上限后,再申请时它的值就不会改变,进而导致继续插入数据时报主键冲突错误
- row_id 达到上限后,则会归 0 再重新递增。如果出现相同的 row_id,后写的数据会覆盖之前的数据
- Xid 只需要不在同一个 binlog 文件中出现重复值即可。虽然理论上会出现重复值,但概率极小,可以忽略不计
- InnoDB 的
max_trx_id 递增值每次 MySQL 重启都会被保存起来,所以我们文章中提到的脏读例子是一个必现的 bug,好在留给我们的时间还很充裕
 发表于 10 小时前
|
查看: 8|
回复: 0


