今天我们来聊聊集成学习里的袋装法(Bagging)。先看概念:
从概念出发,Bagging(Bootstrap Aggregating) 通过对训练集进行有放回的自助采样(bootstrap)生成多个子数据集,训练多个“高方差”的基学习器(如决策树),再对它们的输出进行平均(回归)或投票(分类),以降低方差、提升泛化性能。
直观理解,就是用多个略有差异的模型(差异来自不同随机采样)看同一个问题,再把它们的意见综合起来。这样,单个模型的“噪声”会相互抵消,结果也更稳定。
核心原理
数据自助采样:对原始训练集 $D$,重复 $B$ 次,生成 $B$ 个有放回的样本集 $D_b$。
训练与聚合:
- 回归任务的预测为模型平均:$\hat{f}(x)=\frac{1}{B}\sum_{b=1}^{B}\hat{f}_b(x)$
- 分类任务的预测为多数投票(或概率平均再阈值化):$\hat{y}=\text{majority vote}_b\{\hat{f}_b(x)\}$
方差降低(核心原因):若各基学习器的误差方差为 $\sigma^2$、两两相关系数为 $\rho$,则平均后的方差为:
$$
\rho\sigma^2+\frac{1-\rho}{B}\sigma^2
$$
当 $\rho<1$ 时,增大 $B$ 可以显著降低方差;这就是 Bagging 对“高方差”模型(如决策树)特别有效的原因。
要注意,随机森林 是对 Bagging 的进一步改进:它在每个结点随机选择特征子集进行分裂,进一步降低基学习器之间的相关性 $\rho$。
Python 实现
该示例在一个带噪声的二维分类数据集上,绘制三类内容:
- 单棵决策树的分类边界:高方差、边界起伏大
- 多棵树的 Bagging 集成边界:多数投票后更平滑
- 多个基学习器各自的边界:半透明彩线,展示差异与集成后趋于稳定
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.colors import ListedColormap
from sklearn.datasets import make_moons
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import BaggingClassifier
from sklearn.metrics import accuracy_score

# 1) 生成一个带噪声的二维数据集
np.random.seed(42)
X, y = make_moons(n_samples=2400, noise=0.35, random_state=42)

# 2) 训练单棵树与 Bagging(多棵树)
single_tree = DecisionTreeClassifier(max_depth=None, random_state=42)
single_tree.fit(X, y)

bagging = BaggingClassifier(
    estimator=DecisionTreeClassifier(max_depth=None),
    n_estimators=25,
    max_samples=0.8,
    bootstrap=True,
    random_state=42
)
bagging.fit(X, y)

# 3) 网格用于画决策边界
h = 0.02
x_min, x_max = X[:, 0].min() - 1.0, X[:, 0].max() + 1.0
y_min, y_max = X[:, 1].min() - 1.0, X[:, 1].max() + 1.0
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
                     np.arange(y_min, y_max, h))
grid = np.c_[xx.ravel(), yy.ravel()]

# 概率用于绘制等值线(0.5 为决策边界)
Z_bag = bagging.predict_proba(grid)[:, 1].reshape(xx.shape)
Z_single = single_tree.predict_proba(grid)[:, 1].reshape(xx.shape)

# 4) 评估并打印(可选)
y_pred_single = single_tree.predict(X)
y_pred_bag = bagging.predict(X)
print("单棵树训练集准确率:", accuracy_score(y, y_pred_single))
print("Bagging训练集准确率:", accuracy_score(y, y_pred_bag))

# 5) 可视化
plt.figure(figsize=(8, 6), dpi=130)
plt.contourf(xx, yy, Z_bag, levels=20, cmap='Spectral', alpha=0.25)

# 训练数据散点
colors_points = ListedColormap(["#FF3B3B", "#0077FF"])
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=colors_points,
            edgecolor='white', s=50, linewidth=0.7)

# 单棵树的决策边界
cs_single = plt.contour(xx, yy, Z_single, levels=[0.5],
                        colors=["#FF00A6"], linewidths=2.5)
cs_single.collections[0].set_label("单棵树边界")

# Bagging 的决策边界
cs_bag = plt.contour(xx, yy, Z_bag, levels=[0.5],
                     colors=["#00E676"], linewidths=3.0)
cs_bag.collections[0].set_label("Bagging集成边界")

# 各基学习器的边界
cmap_lines = plt.get_cmap("rainbow")
for i, est in enumerate(bagging.estimators_):
    Zi = est.predict_proba(grid)[:, 1].reshape(xx.shape)
    color_i = cmap_lines(i / len(bagging.estimators_))
    # 只为第一条线加图例标签
    label_i = "各基学习器边界" if i == 0 else None
    plt.contour(xx, yy, Zi, levels=[0.5], colors=[color_i],
                linewidths=1.0, alpha=0.35, linestyles='--',
                label=label_i)

plt.title("Bagging(袋装法):通过自助采样+模型聚合实现边界平滑与方差降低", fontsize=12)
plt.xlim(x_min, x_max)
plt.ylim(y_min, y_max)
plt.legend(loc="upper left", frameon=True)
plt.tight_layout()
plt.show()
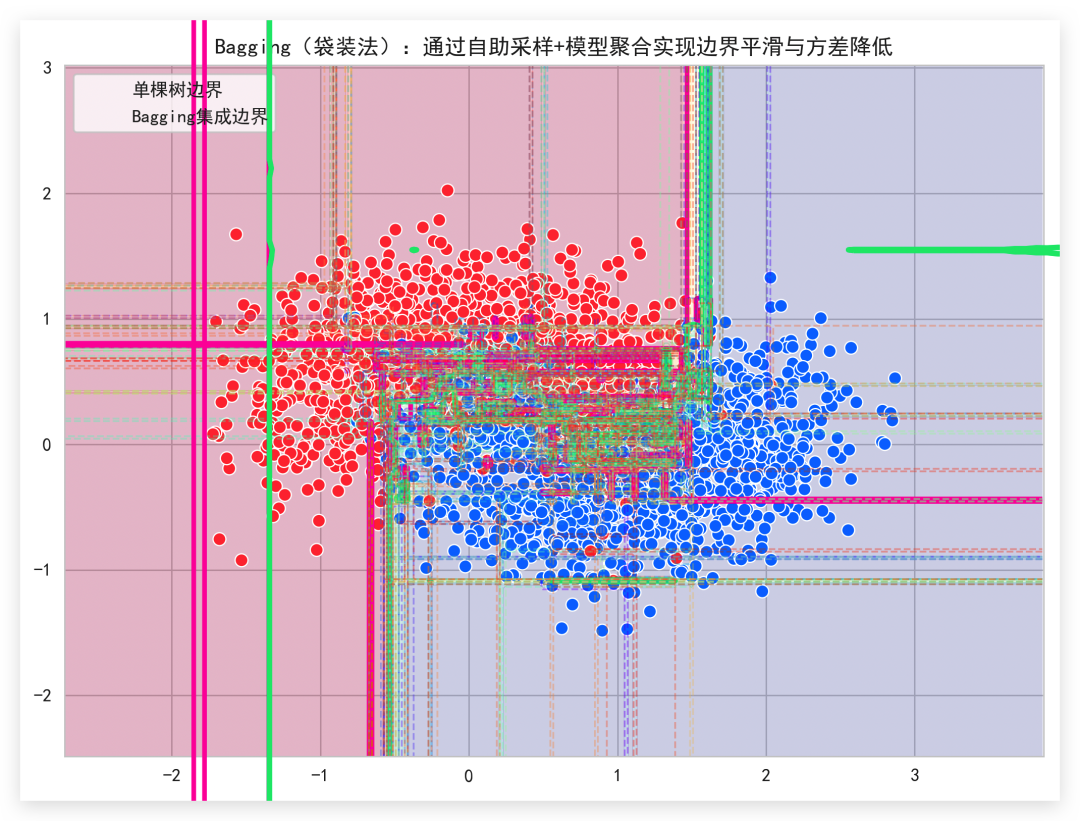
红色的“单棵树边界”起伏较大,容易受噪声影响,体现高方差;多色虚线展示不同自助样本训练出的多棵树各自边界,彼此并不一致。
绿色的“Bagging 集成边界”更平滑、更稳定,直观体现了通过平均/投票降低方差的原理。
如果想进一步把 Bagging、随机森林等集成学习内容串成体系,也可以到云栈社区查看机器学习课程与实战项目。
 发表于 昨天 22:02
|
查看: 8|
回复: 0


