大模型普遍受限于上下文窗口,会话一长就容易丢掉历史信息,不少智能代理甚至扛不住跨多天的连续任务。有没有办法不升级模型、不扩大窗口,也能让会话保持更久?billion-context 走的是另一条路线:把历史会话压得更薄,用较小的上下文空间承载数十亿 token 的会话内容。这样一来,长会话中断的痛点被绕开,AI 代理也获得了更持久的记忆能力。
简介
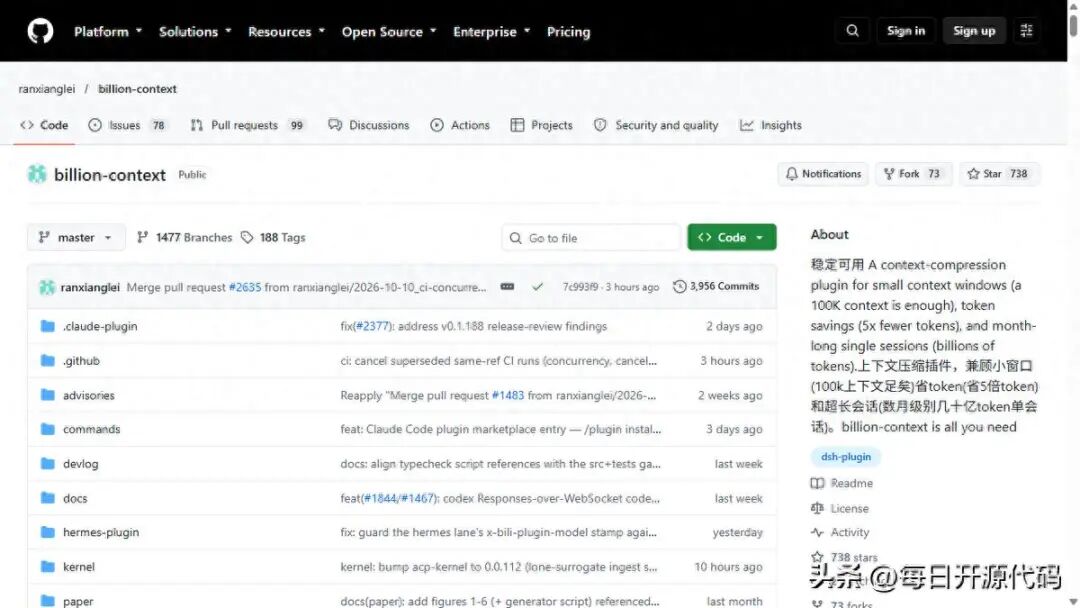
billion-context 是一款面向 AI Agent 的上下文压缩插件,仓库地址为 github.com/ranxianglei/billion-context,采用 MIT 许可证。
它基于 acp-kernel 压缩引擎构建,无运行时依赖,可以适配 pi、OpenCode、Claude Code 等多款主流智能代理工具。项目核心能力是对历史对话做分层摘要压缩,最高可实现约 5 倍的 token 缩减。它支持压缩块检索、解压恢复内容,同时会保护最新工作内容和关键消息不被压缩。模型可以自主决定压缩时机与范围,保留文件路径、决策记录等关键信息,维持长周期任务的连续性。
使用
项目可以通过包管理器快速安装,适合嵌入各类 AI Agent 流程。
加载插件后,AI 会自动调用 compress 工具,对指定区间的消息生成高保真摘要。需要查询历史信息时,调用 search_context 在压缩块内检索,不必全部解压。只有需要原始内容时,才执行 decompress 恢复完整文本。开发者还可以配置保护区间,让近期交互消息不参与压缩,在压缩效率和实时交互体验之间取一个平衡。
总结
billion-context 不依赖超大上下文模型,依靠压缩扩展会话容量,让普通窗口也能支撑长达数月的连续任务。它同时兼顾检索能力与信息保真,适配多种 AI 代理,降低了超长上下文应用的部署成本,是长会话 AI 开发中非常实用的开源工具。 |  发表于 1 小时前
|
查看: 12|
回复: 0


