AI 圈再次变天了。
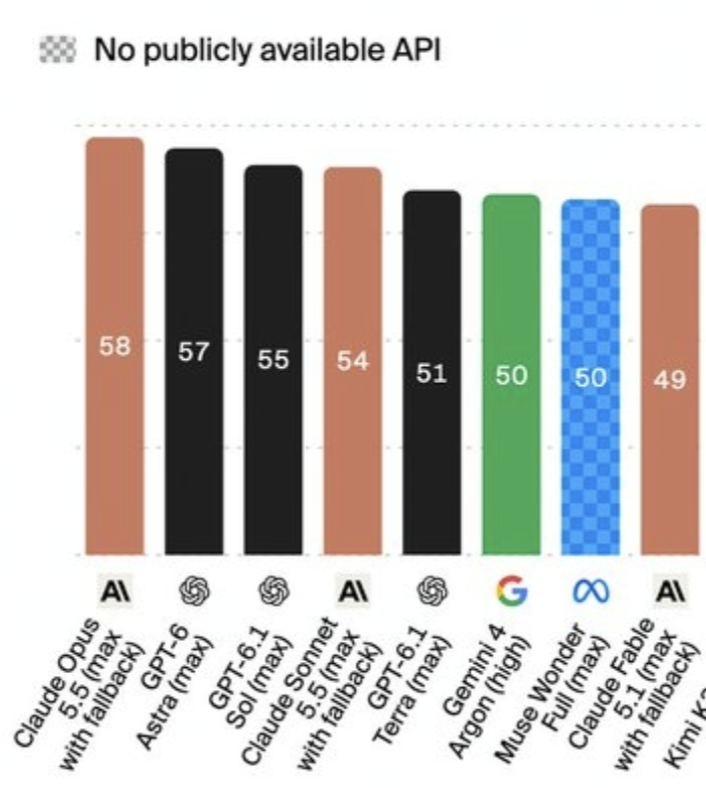
Artificial Analysis 刚更新了 Intelligence Index,正式推出 v5 版,Claude Opus 5.5 一举登顶,将 OpenAI 的 GPT-6 Astra 挤下神坛。
但没高兴多久,Gemini 4 Carbon 发布,超越 Claude Opus 5.5 夺魁!
而代号「Obsidian 3」的神秘模型意外浮出水面,所有线索都指向同一个名字:Anthropic 尚未发布的 Fable 5.5。
险胜 GPT-6!Opus 5.5 的冠军不到一夜
AI 榜单洗牌了。
Artificial Analysis 发布了最新的 Intelligence Index v5 榜单。这是目前业内含金量最高、最难啃的测试之一。
结果出人意料,但又在情理之中。
Claude Opus 5.5 以 58 分险胜,斩获第一。
GPT-6 Astra 以 57 分,屈居第二。
戏剧性的是,谷歌随之发布了 Gemini 4 Carbon,AA 综合得分 59。
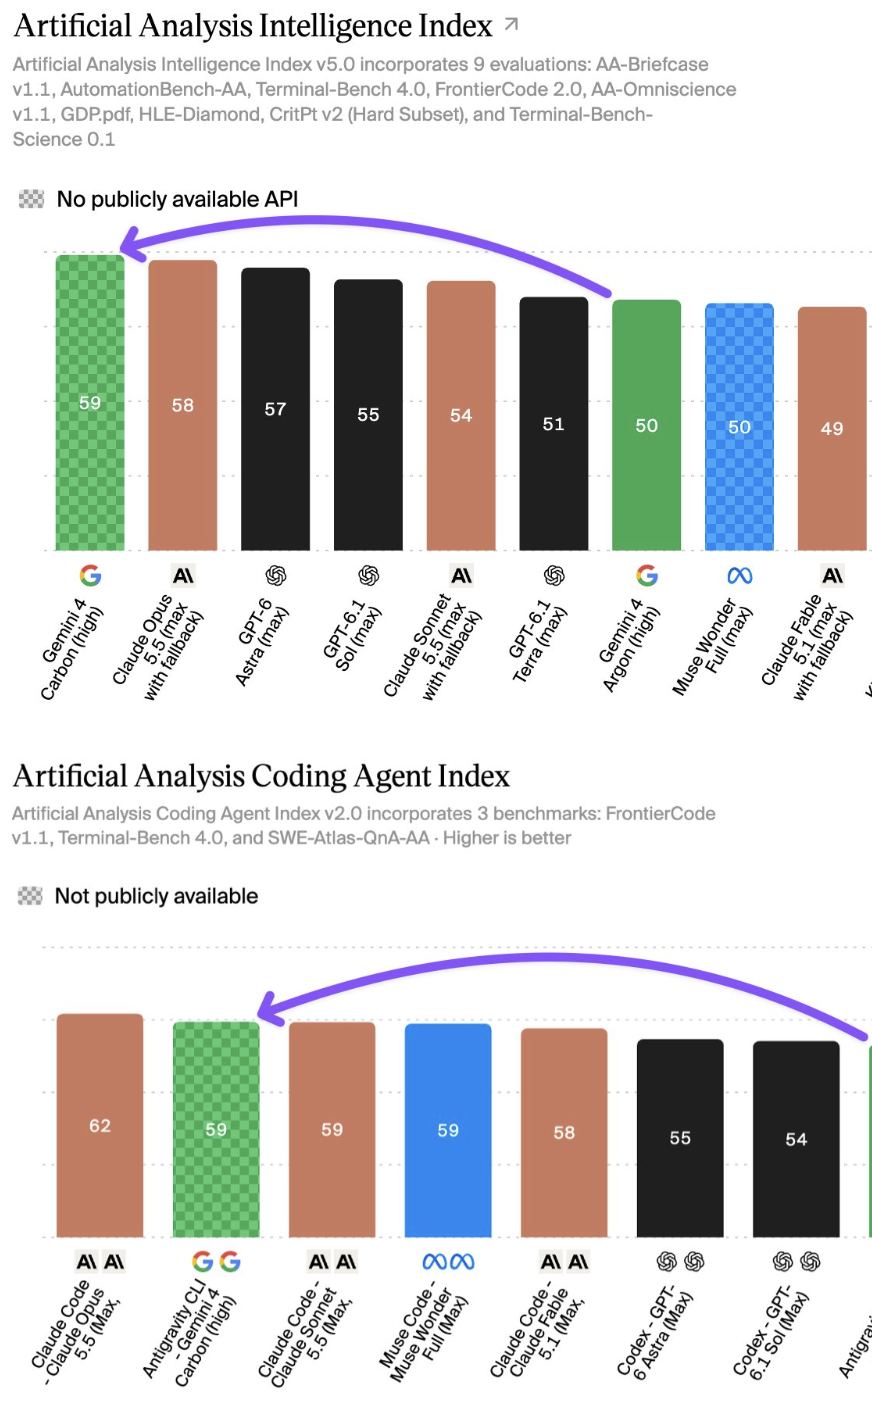
一分之差,AI 王座一夜之间两度易主。
但在编程智能体指数上,Anthropic 仍以 62 分领跑。
为什么这次 Anthropic 登顶编程智能体指数榜含金量极高?因为测试规则变了,变得极其苛刻。
私有数据权重飙升至 60%。
过去的 AI 测试,大家都在刷榜。模型把公开的 GitHub 代码库背得滚瓜烂熟,分数自然高。
这次不行了。官方直接把私有数据集的权重拉到了 60%。
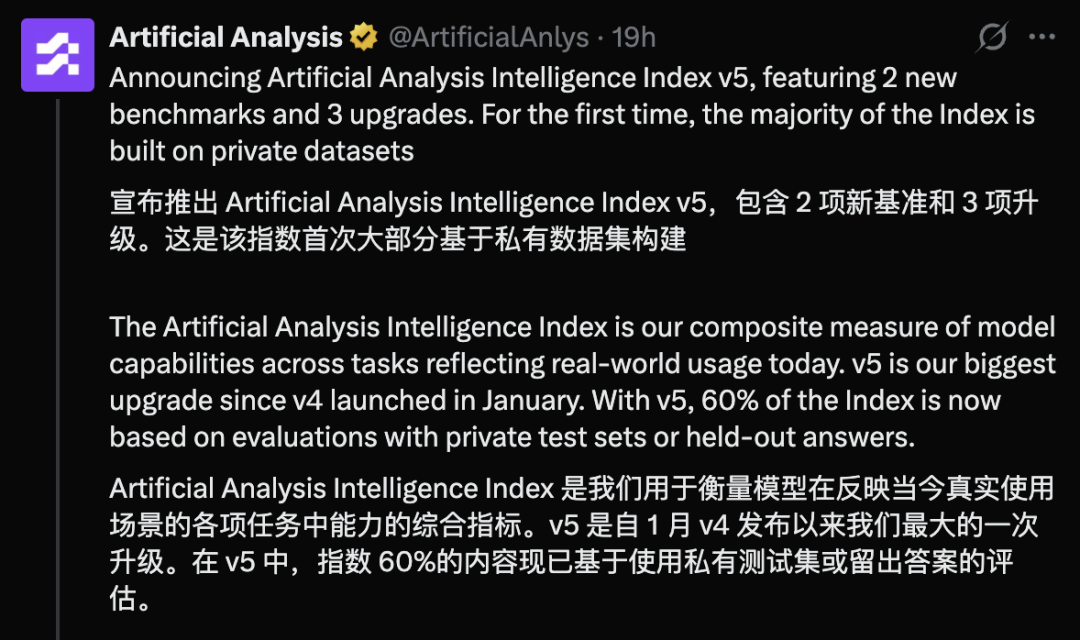
没有公开资料,没有历史作业。模型必须当场思考,当场解题。
靠「死记硬背」混日子的时代,结束了。
免疫学教授 Derya Unutmaz 评论称,新版本更合理。此前开源模型存在针对公开基准的过度优化(benchmaxxing),与 OpenAI、Anthropic 及 Gemini 前沿模型的能力差距被清晰拉开。
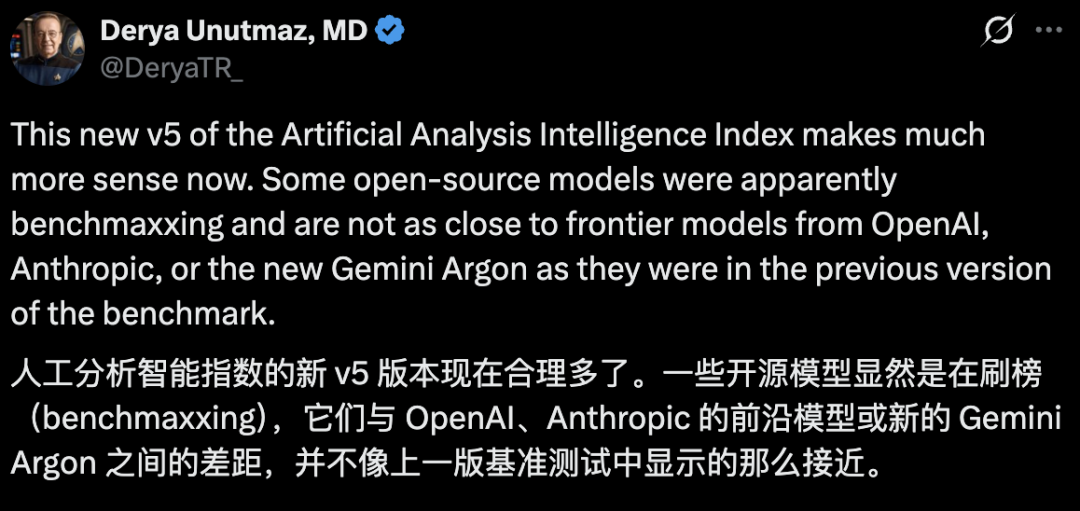
不过,这并不意味着两者差距扩大了,而是衡量方式发生了变化。
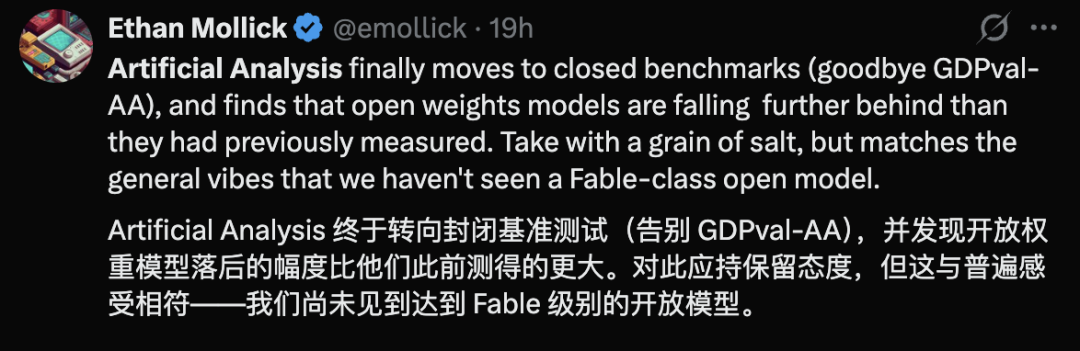
引入高难度科研工作流。
新增了代码与科研工作流等「地狱级」挑战。
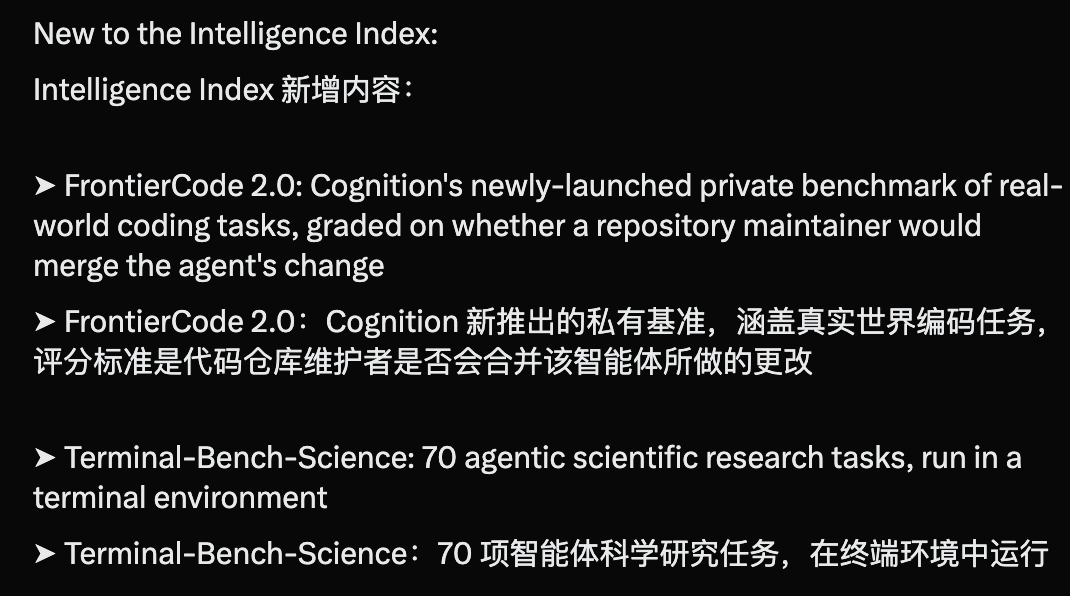
这不再是写个贪吃蛇代码那么简单,而是要求 AI 像真实的程序员和研究员一样,处理复杂的工程逻辑。
在这样的高压测试下,Opus 5.5 扛住了。它证明了 Anthropic 在复杂逻辑推理和真实场景落地上的实力。
数据暴雷!隐藏模型 Obsidian 3 究竟是谁?
Opus 5.5 登顶,只是前菜。
真正的硬核大瓜,藏在另一家机构的数据库里。
昨天,知名 AI 测试机构 Cognition 发布了其私有编程基准的最新版本:FrontierCode 2.0。
这是一个极其变态的测试:包含 132 项真实开源代码库中的任务。
评分标准简单粗暴:代码提交后,项目的维护者是否愿意合并(Merge)你的更改。
只要有一项阻断性检查未通过,直接计 0 分,没有任何同情分。为了防止数据污染,任务全程保密。
而且 Artificial Analysis 还要在 Stirrup 框架中每项任务跑三次,杜绝偶然性。
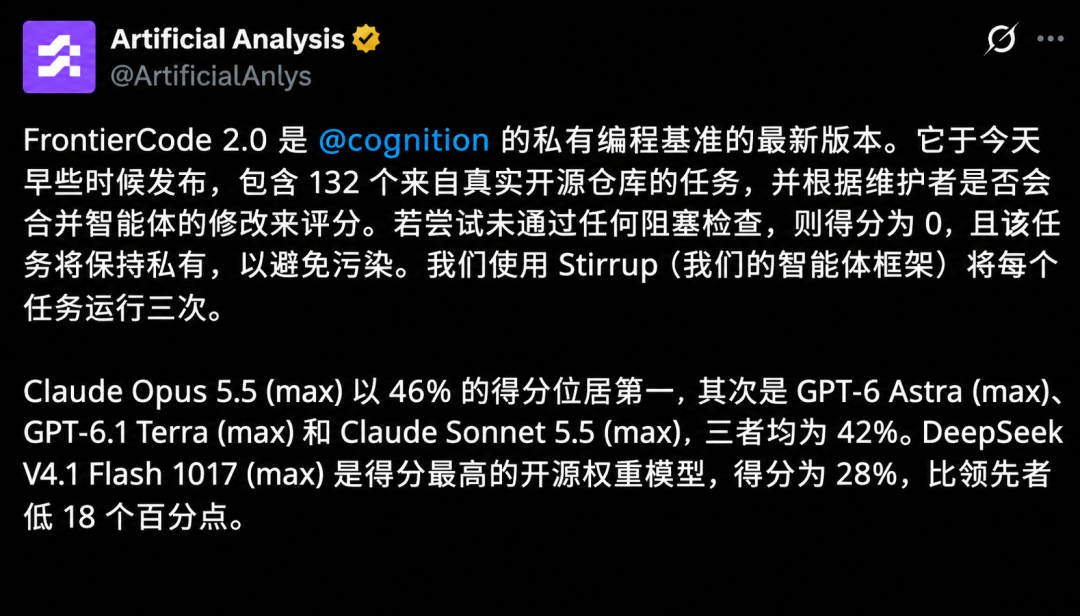
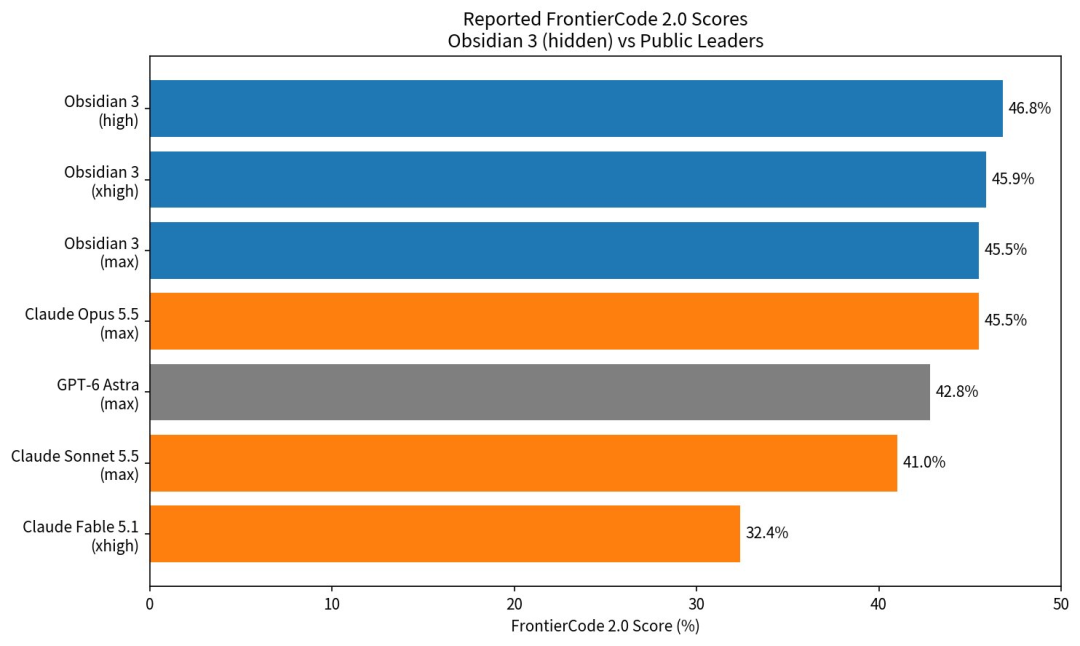
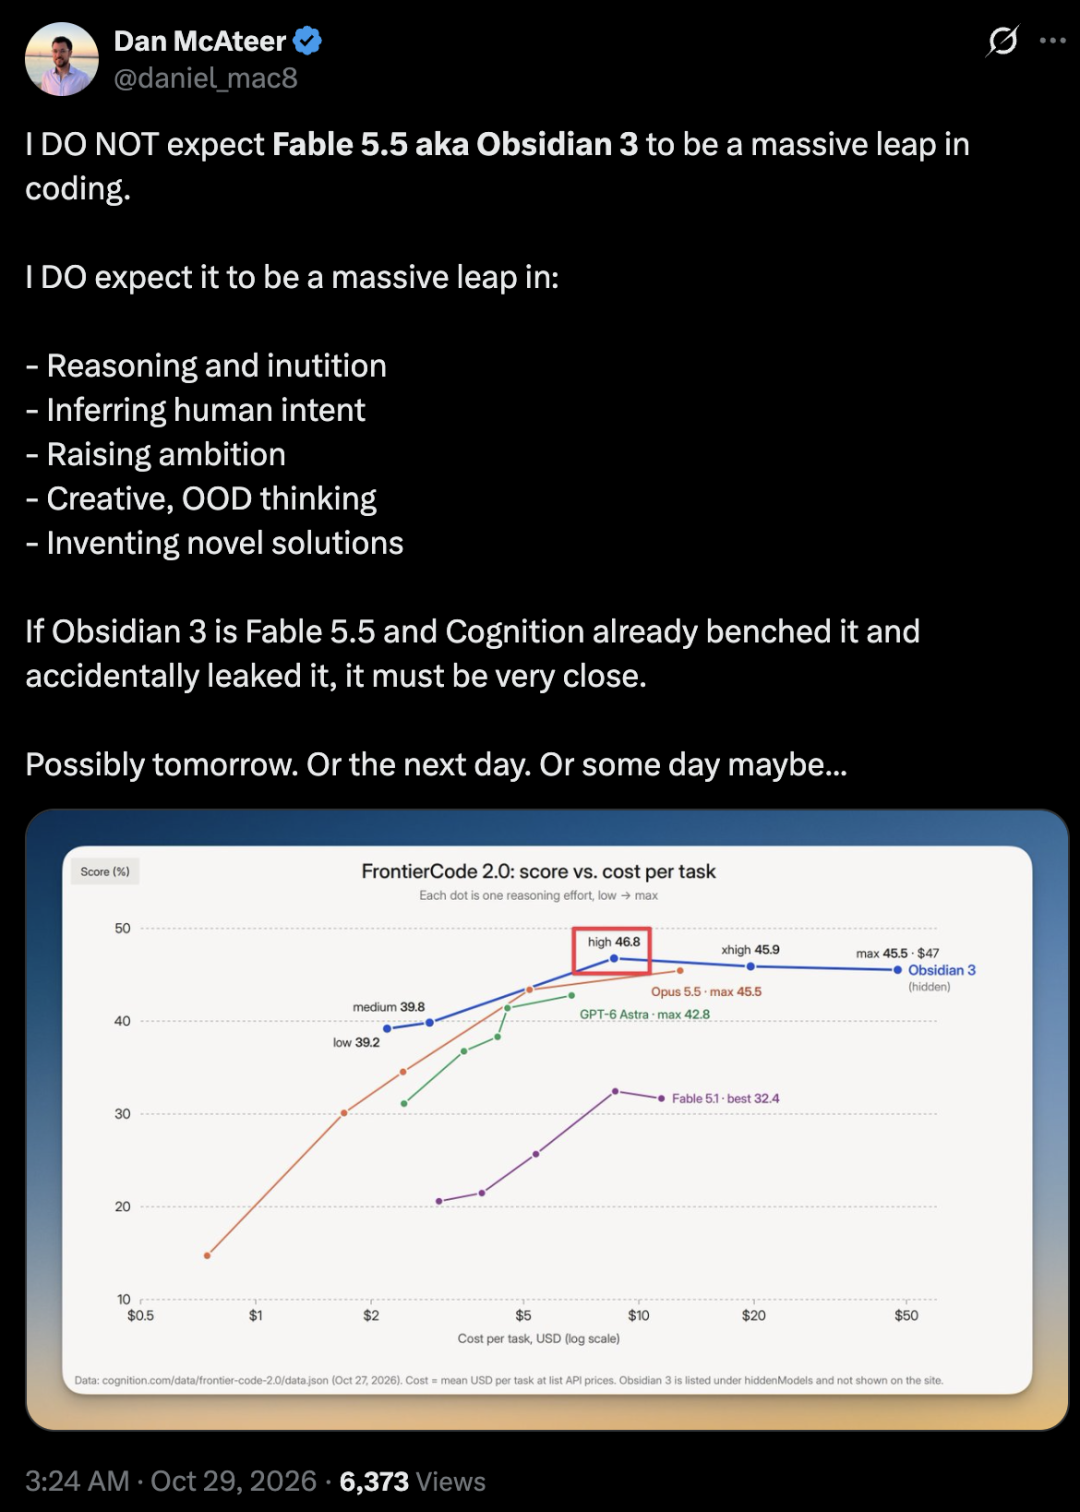
在这个榜单上,Claude Opus 5.5(max)以 46% 的成绩领跑全场。
GPT-6 Astra(max)、GPT-6.1 Terra(max)和 Claude Sonnet 5.5(max)紧随其后,全部死磕在 42%。
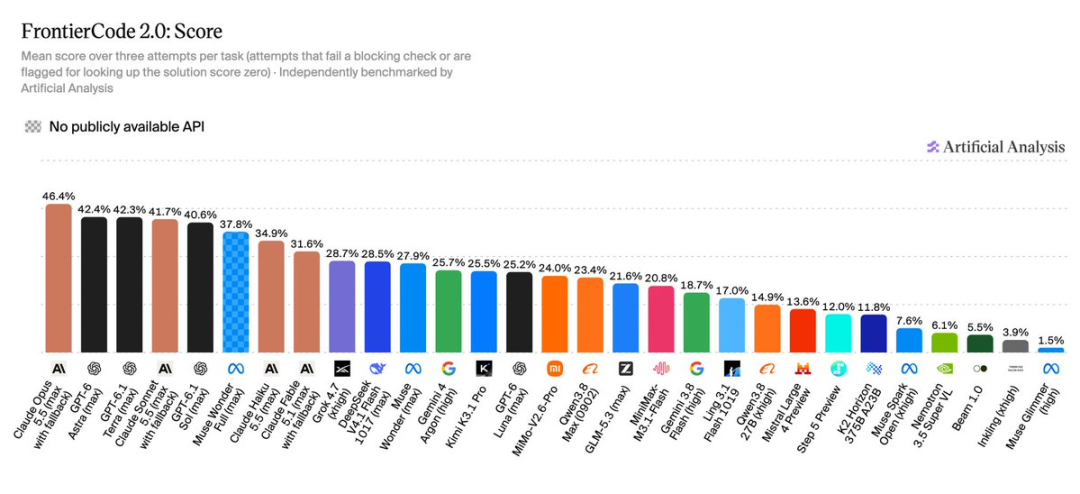
但有人扒开了官网的数据接口。在 data.json 的隐藏代码里,发现了一个隐藏模型 Obsidian 3。
数据令人倒吸一口凉气:
Obsidian 3,高推理模式得分 46.8%。
它硬生生把当前第一的 Opus 5.5(45.5%)踩在了脚下。
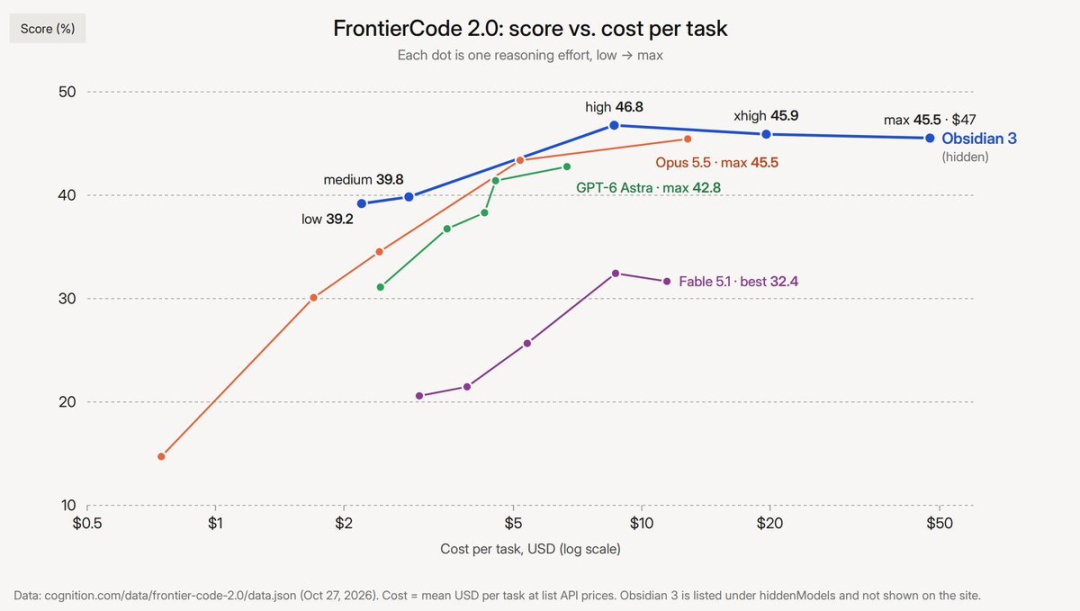
这个隐藏冠军,到底是谁?
社区的极客们迅速锁定了证据:测试框架。
Obsidian 3 运行在 claude-code 环境下。这是一个专属的测试框架,目前全世界只有六个 Claude 家族的模型在使用。
真相呼之欲出:这可能就是 Anthropic 尚未官宣的新一代大杀器——Fable 5.5。
悬念:挤牙膏还是憋大招?Fable 5.5 的成本谜团
争议却随之而来。
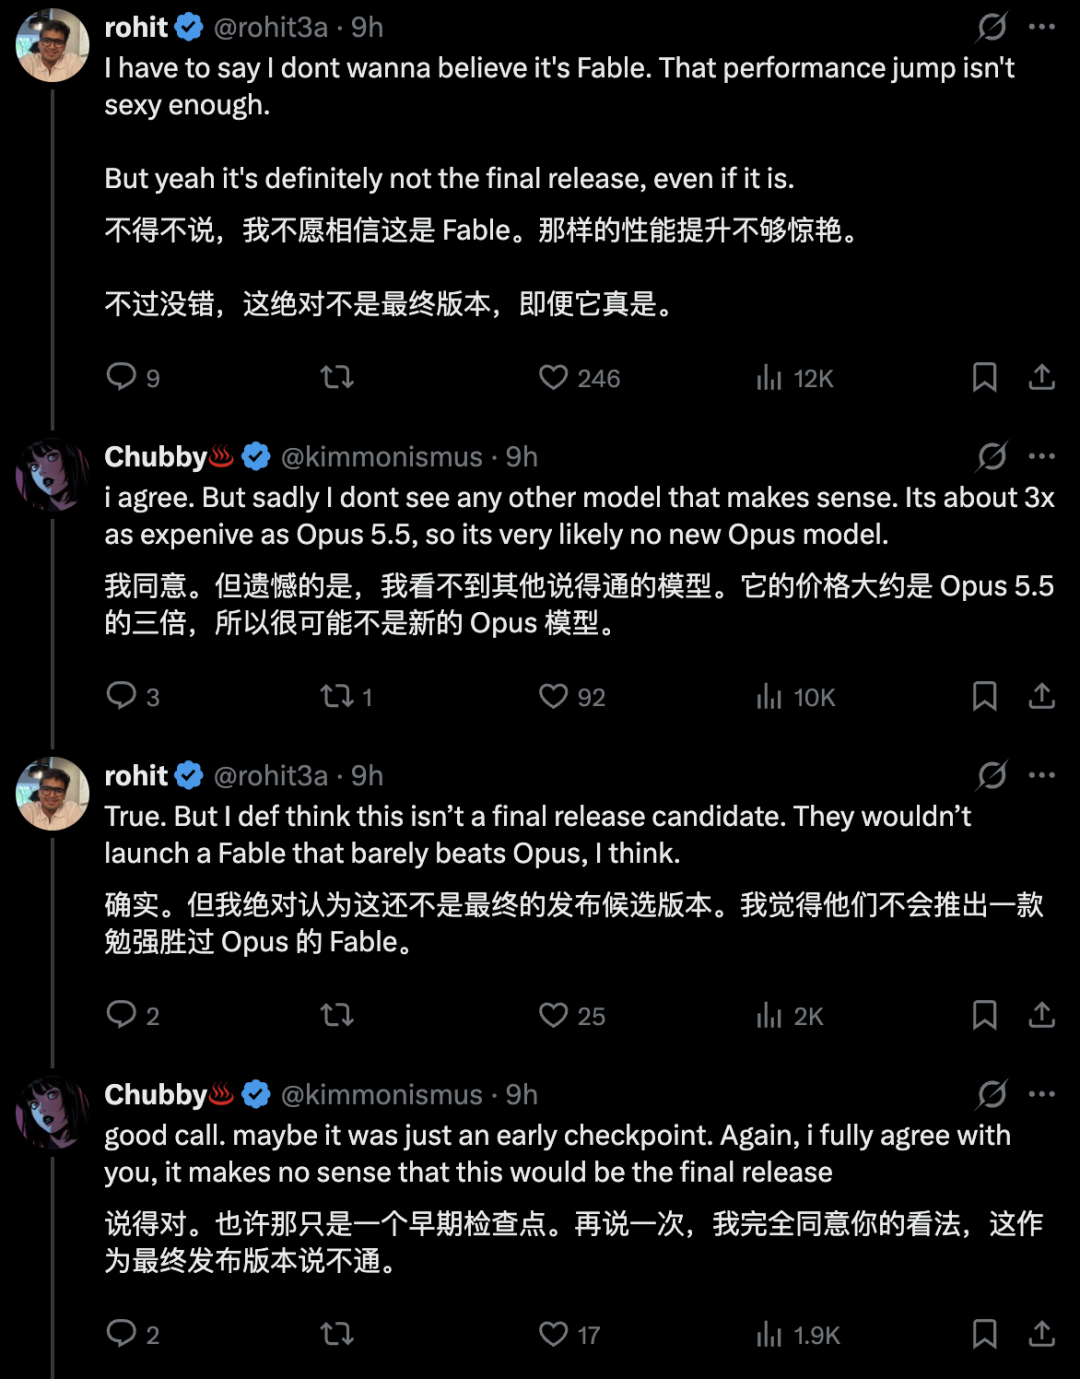
一部分人感到失望,直言这提升不够「性感」。
46.8% 对比 45.5%,仅仅提升了 1.3 个百分点。在最大(max)模式下,两者甚至持平,都是 45.5%。
更要命的是成本。
数据显示,在相同投入程度下,Obsidian 3 的成本约为 Opus 5.5 的 3.6 倍。在 high 模式下,单任务成本高达 8.62 美元;在某些极端的 max 模式下,单任务成本甚至飙升至约 47 美元。
跑一次任务,花掉三百多块人民币。这对多数开发者来说,是难以承受的数字。
这种定价颇有一种「AI 中的爱马仕」的奢华感,倒也间接排除了主打性价比的 Gemini。
「如果这就是 Fable 5.5,那看起来不够惊艳。」有开发者在 X 上抱怨。
而且你让它思考得越多,表现反而越差,感觉像是一个早期检查点,不太可能是最终的发布版。
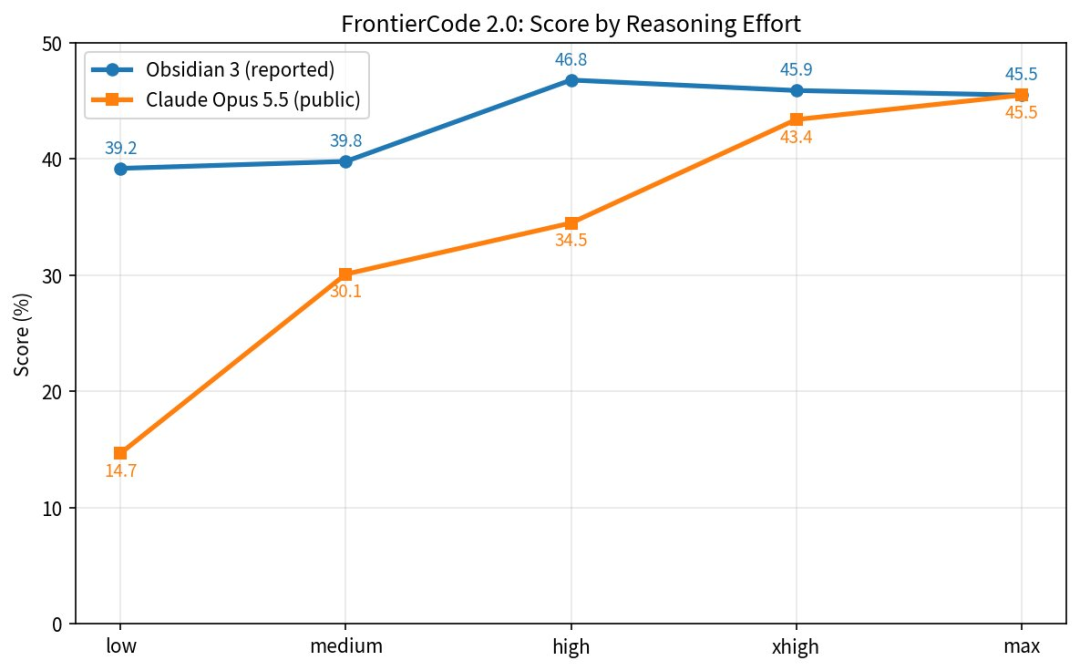
这更像是一个 checkpoint。
但也有人看到了不同的东西:
不要被编程得分骗了,Fable 5.5 的核心定位,从来不是一个只会写代码的「码农」。
业内人士指出,Obsidian 3 虽然在编程成功率上只是小幅领先,但其在「中高推理区间」表现极其稳定。
它真正的跃升,在别的地方:
- 推理与直觉。
- 推断人类的真实意图。
- 提升任务的抱负水平。
- 创造性的「分布外」思维。
- 发明前所未有的新颖解决方案。
在复杂的真实科研流中,解决一个「无人碰过」的新问题,比修 100 个已知的 Bug 要有价值得多。
此外,当前泄露的只是测试节点数据,极有可能并非 Fable 5.5 的最终发布版本。Anthropic 还在进行价格与性能的最终调优。
如果 Cognition 已经对其进行了基准测试并不慎泄露,说明一切已经准备就绪。
可能明天,可能后天,AI 界的又一次大地震,已经进入倒计时。
尾声:风暴前夕
这是一个充满戏剧性的时间节点。
Opus 5.5 险胜 GPT-6 Astra,证明了 Anthropic 在编程上的控制力。
Gemini 4 Carbon 反超 Opus 5.5,证明谷歌宝刀未老,尚能一战。
而隐藏冠军 Obsidian 3 的暴雷,预示着 Fable 5.5 已经上膛,随时准备扣动扳机。
AI 模型没有不败的神话,只有永远的内卷。
今天,Gemini 4 是第一。明天,Claude Fable 5.5 可能就会掀翻桌子。之后,OpenAI 的反击必将降临。
准备好吧,AI 模型发布的时间间隔可能会越来越短。
参考资料:
 发表于 1 小时前
|
查看: 5|
回复: 0
 /1


