说结论。Jev 不是“更大的 BERT”。它要解决的东西,其实是 BERT 那个年代就没有解决好的两件事:一件是标签会变,另一件是概率要可信。
做多 Agent 的人,大概都踩过这么一个坑。
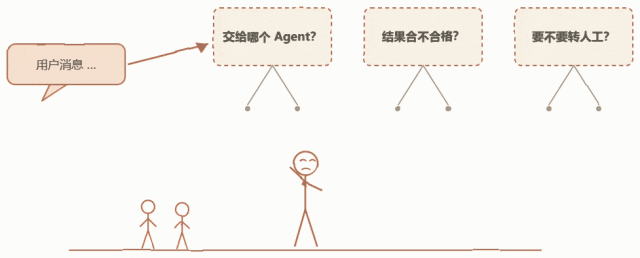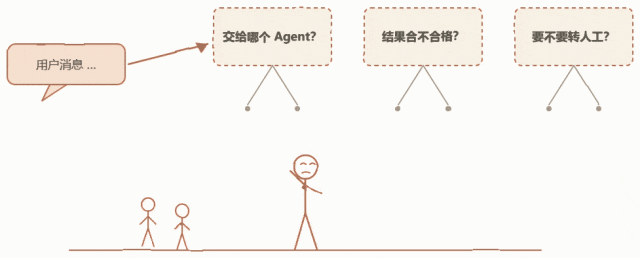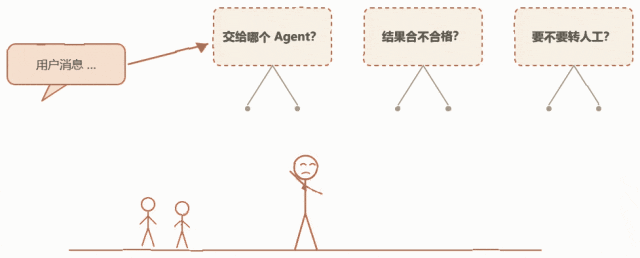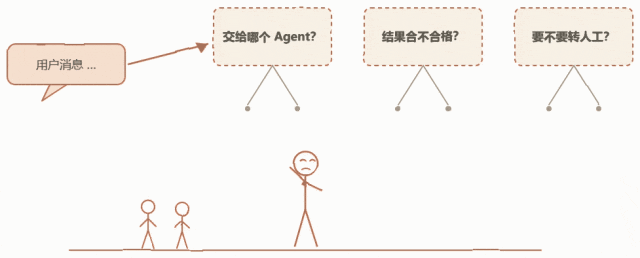
用户的一句话进来了,系统得先去判断一下,这句话该交给哪个 Agent 去处理。Agent 跑完了一步,还得去判断一下,这个结果合不合格、要不要重新跑一遍。碰到敏感内容的时候,还要再去判断一下,要不要转给人工。
你会发现,这些“判断”有一个共同点:答案都要从一个小集合里面去选一个出来。
于是有人就问了:这不就是意图分类吗?十年前 BERT 就能做的事情,为什么到了今天,又冒出来一个 Jev 这样的 Decision Model?
我把资料查了一圈,再结合一些小例子,说说我的理解。(文中的例子和数字,凡是标了“假设”的,都是为了把原理讲清楚而编的,不是什么真实的评测数据。)
一、先说 Jev 是什么
Jev 是 TypeSafe 发布的第一个公开可用的决策模型(decision model)。
它的用法很朴素:你给它一个问题,再给它一组允许的答案,它就从里面去选一个出来。选完了还会告诉你,有多大概率、有多确定。有人把它比喻成“选择题”,也有人管它叫“带类型的智能 if”。
关键的地方在于:它不会去生成一段话。它的输出是被你声明的 schema 限定住的。选项、分数、布尔值、概率,就这些东西。
打个比方吧。
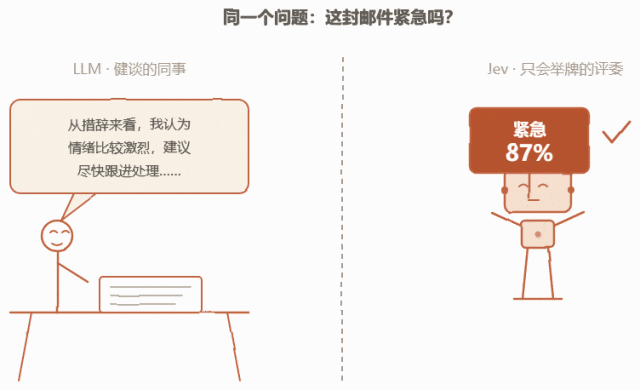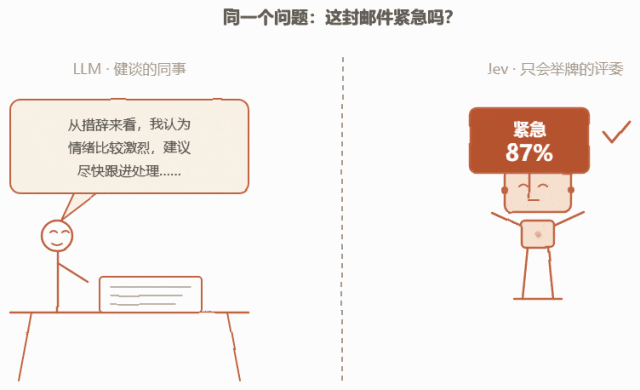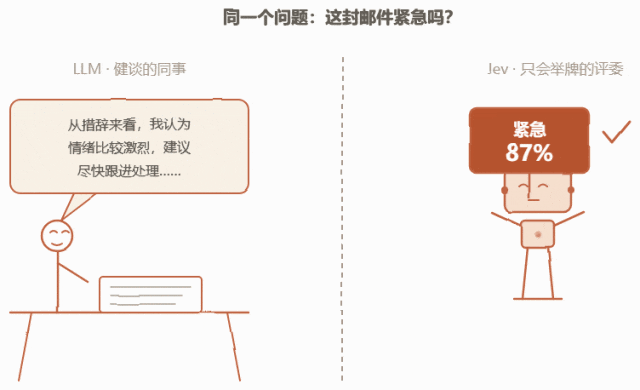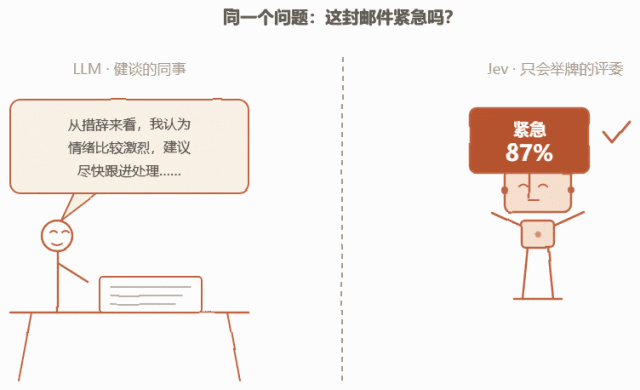
LLM 就像一个很健谈的同事。你问他“这封邮件紧急吗”,他会给你写一小段分析出来。
Jev 像什么呢?像一个只会举牌的评委。你问同样的问题,他直接举牌:“紧急,把握 87%”。
对于那种要把结果直接喂给代码的场景来说,后一种要省事得多。
二、多 Agent 里,路由到底在判断什么
很多人把路由就当成是“意图分类”,其实 Agent 系统里面的“小选择题”,远不止这一种。
比如路由:这个请求该给哪个 Agent、哪个模型?
再比如风险检查:这条内容有没有违规、该不该拦下来?
还有结果校验:上一步的输出合不合格?
然后是重试与升级:失败了,是重新试一次,还是换一个更强的模型,还是直接转人工?
最后还有重排:几个候选里面,哪一个最合适?
小例子:一个电商客服 Agent 系统
假设你手上有一套多 Agent 客服系统。用户发过来这么一条消息:
“我昨天买的耳机左耳没声音,而且你们客服态度太差了,我要投诉,不处理我就发微博。”
就这么一条消息,系统实际上要同时回答好几个问题:
| 问题 |
可能的答案 |
| 该交给哪个 Agent? |
售后 Agent / 投诉 Agent / 物流 Agent / 人工 |
| 情绪等级? |
平静 / 不满 / 愤怒 |
| 是否有舆情风险? |
是 / 否 |
| 是否需要人工介入? |
是 / 否 |
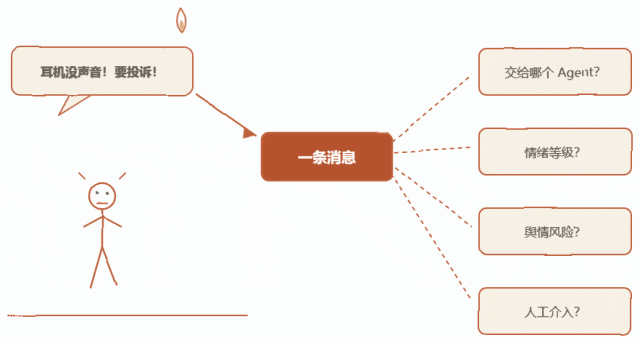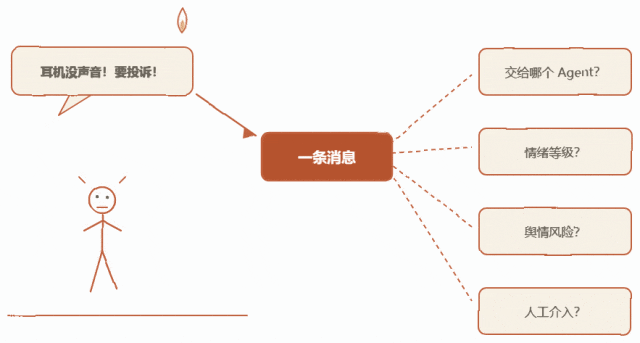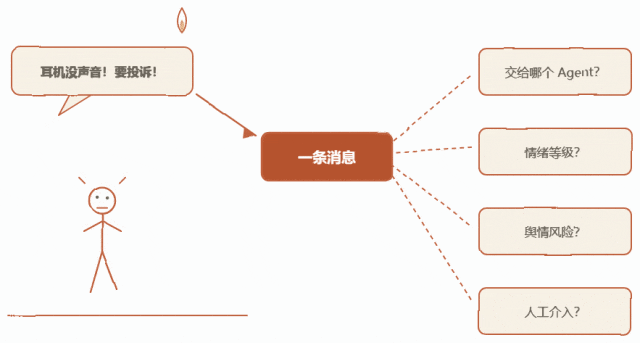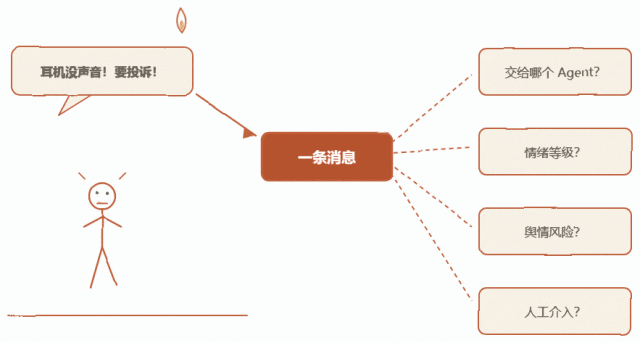
注意一下,这四个问题问的是同一段输入,答案也都是从小集合里选一个。如果你每个问题都去调用一次 LLM,让它写一段分析,那一条消息就要生成四段文字。而这种步骤,在一个任务里面可能出现几十次。开销累积起来是很快的。
三、BERT 时代的三个老毛病
BERT 做分类本身没有问题。但是放到今天的 Agent 场景里面,有几处明显就吃力了。
1. 标签是焊死的
BERT 分类器的类别,在训练的时候就定下来了。
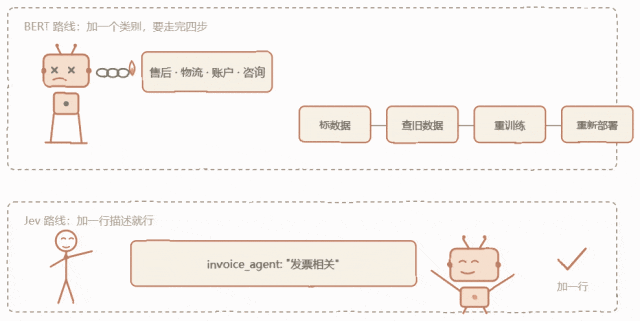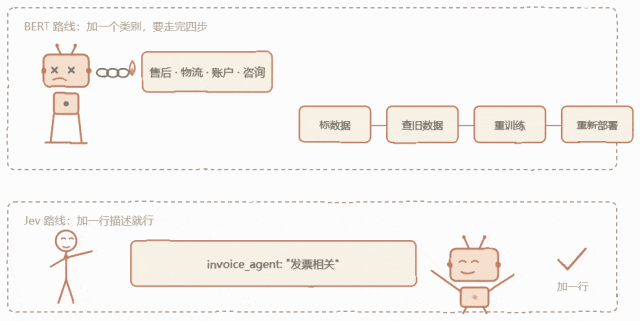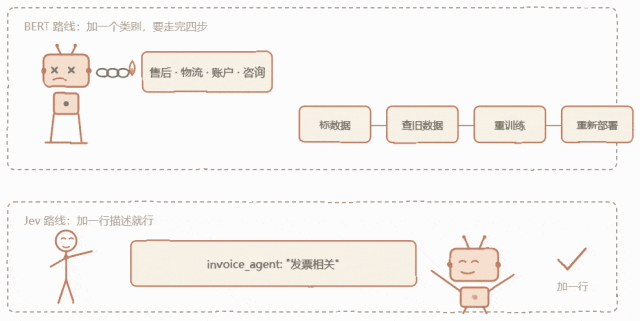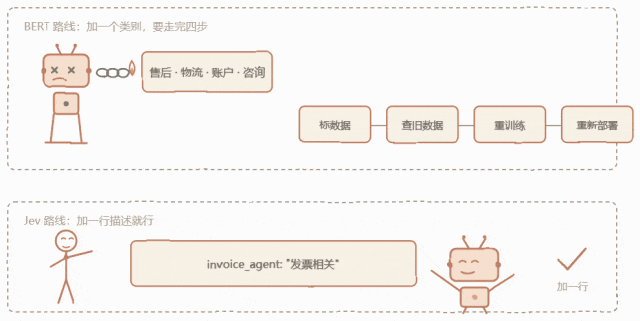
给你举个例子。你的客服系统上线的时候有 4 个 Agent:售后、物流、账户、咨询。然后运营跑来说:“我们要上线‘发票’业务,新增一个发票 Agent。”
BERT 路线下的流程大概是这样的:
第一步,去收集并标注“发票”相关的样本。第二步,因为担心新类别会影响老类别,还要回头去检查旧数据。第三步,重新训练、评估。第四步,重新部署上线。
在这一整套事情做完之前,用户要是问一句“我想开张发票”,分类器只能把它硬塞到某个老类别里面去——比如就被分到“咨询”去了。
而 Jev 的思路不一样。路由集合是在调用的时候传进去的,你要加一条路由,就是多写一行描述的事情。(当然,“能加”不等于“一定准”,后面会讲到,还是需要去验证的。)
2. 一个模型一个问题
再回到上面那条投诉消息。你要同时判断“去哪个 Agent、情绪等级、舆情风险、是否转人工”,BERT 路线通常是每个任务各训一个模型,或者一个头。数据、评估、部署,各维护一套。
3. 输入越来越不像“一句话”
路由器看到的输入,可能是下面这样的:
用户:我的订单怎么还没到?
Agent(物流):已为您查询,包裹在转运中心滞留。
工具返回:{"status": "exception", "reason": "address_invalid"}
用户:地址我昨天不是改过了吗??
这个时候要判断的东西,是“该不该从物流 Agent 切到账户/订单修改 Agent,还是转人工”。信息散落在多轮对话和一段 JSON 里面。这早就不是当年那种“一句话进来,一个标签出去”的设定了。
四、Jev 做对了什么
1)用自然语言描述问题和候选动作
这一条是最关键的。
路由集合是在调用的时候传进去的,每个选项带一句自然语言的描述。官方示例里面的路由集合,大概是这样的:
| 路由 |
描述 |
| deterministic_code |
确定性逻辑能处理 |
| fast_llm |
短文本生成,推理需求低 |
| reasoning_llm |
需要多步理解或综合 |
| human_review |
模糊、敏感或超出已声明范围 |
还是沿用客服那个场景。要新增“发票”业务的时候,你只需要在路由配置里面加一条:
invoice_agent: "用户询问开发票、发票抬头、发票补开或发票作废"
不需要重新标数据,也不需要重新训练。
这也是它和 BERT 最本质的区别。表面上大家都在做选择题,但是 Jev 的选项是可以动态传进去的。同一个模型,可以处理不同的决策任务。
2)一次问多个问题
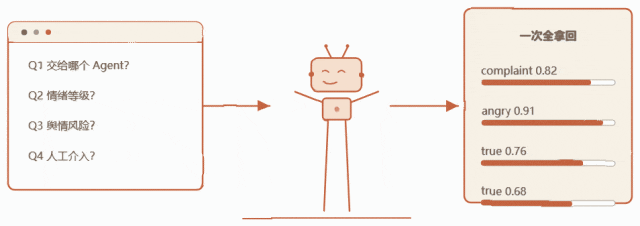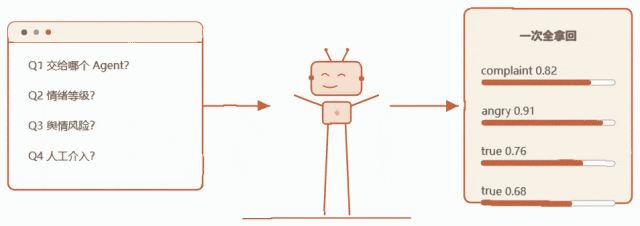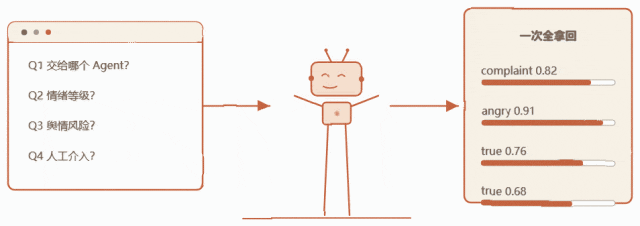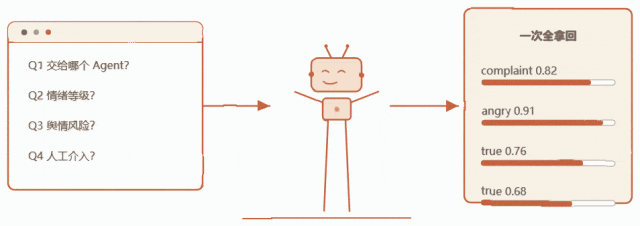
同一个输入,可以同时带上多个类型化的问题。选择、打分、布尔,都可以。然后一次把结果全部拿回来。
还是那条投诉消息。一次请求可以这样问:
输入:<用户消息 + 对话上下文>

问题 1(选择):交给哪个 Agent?  选项:after_sales / complaint / logistics / human
问题 2(选择):用户情绪等级?    选项:calm / unhappy / angry
问题 3(布尔):是否存在舆情风险?
问题 4(布尔):是否需要人工介入?
返回的可能是这样一个结构(示意):
问题 1:complaint,概率 0.82
问题 2:angry,概率 0.91
问题 3:true,概率 0.76
问题 4:true,概率 0.68
下游的代码拿到这个结构化结果,直接就进业务分支了。不用再去解析任何自然语言。
3)返回概率和置信度
它不只是告诉你“选了 B”,还会告诉你 B 的概率是多少、有多确定。这样一来,系统就可以去做阈值门控了。
举个例子。路由决策的处理策略可以这样来定:
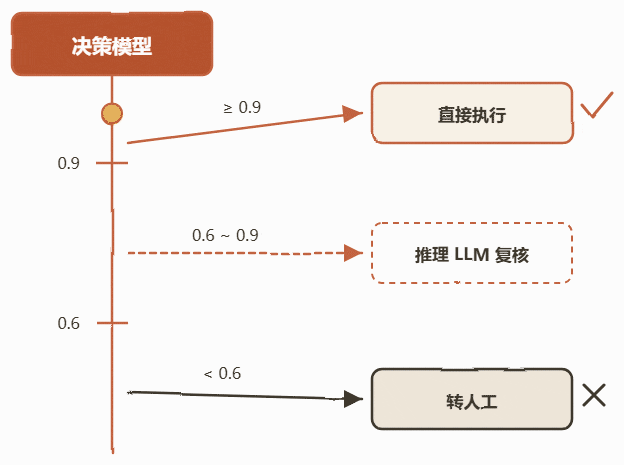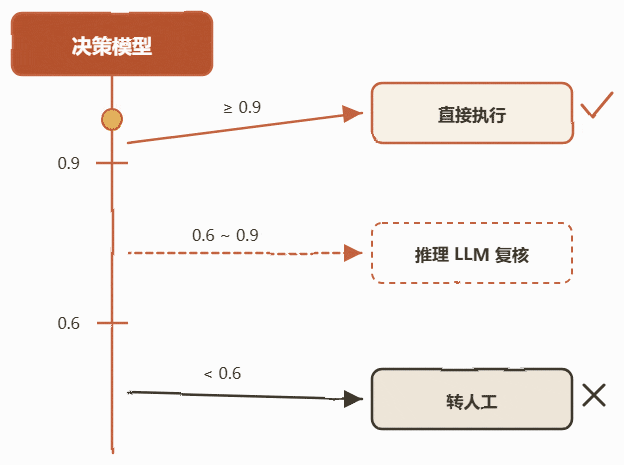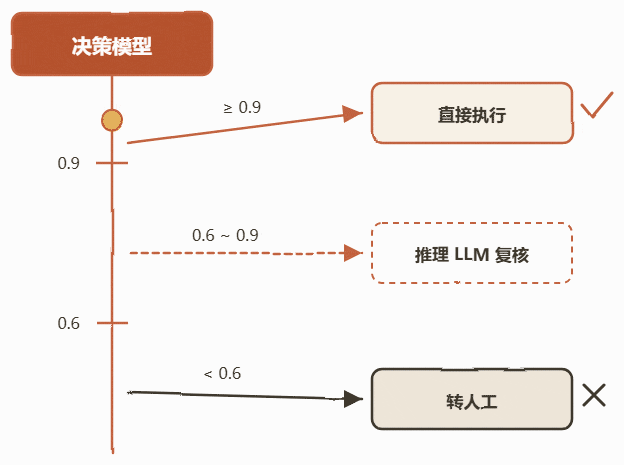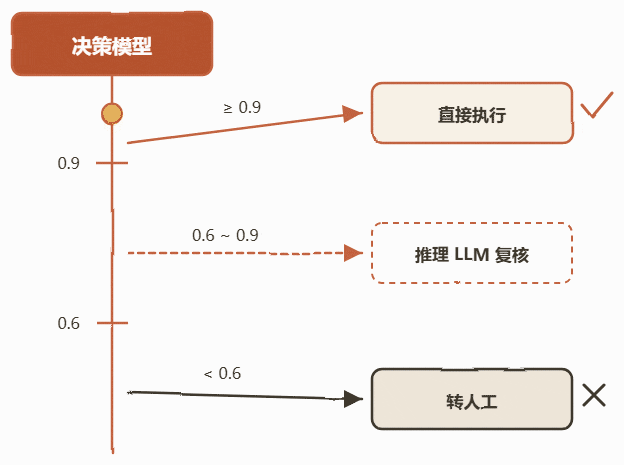
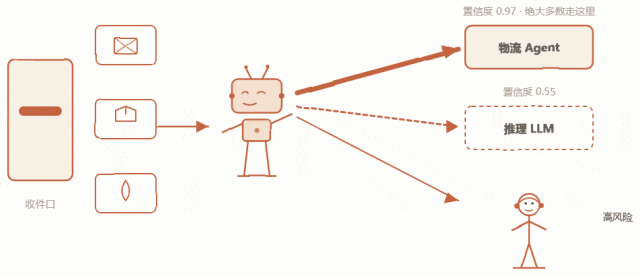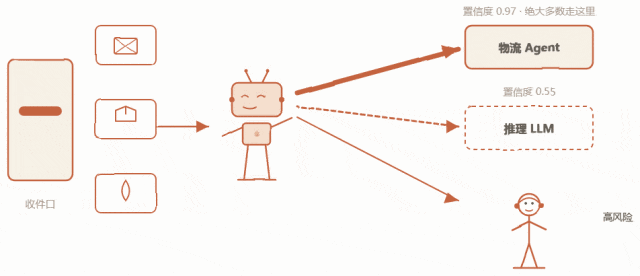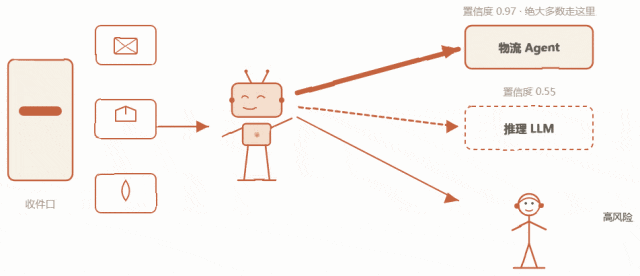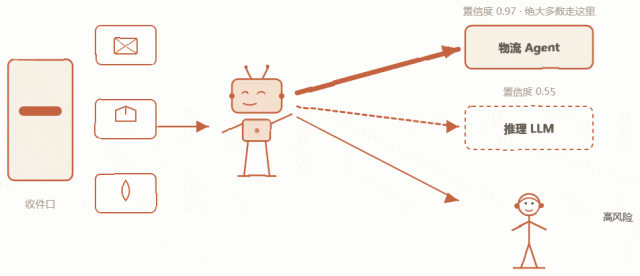
置信度大于等于 0.9 的,直接交给对应的 Agent。0.6 到 0.9 之间的,交给推理 LLM,再判断一次。低于 0.6 的,转人工。
对应到上面那条投诉消息,“是否需要人工”只有 0.68。说高不高,说低也不算低。这种样本就很适合交给更强的模型去复核一遍。或者因为带有舆情风险,直接就走人工通道。
五、为什么不直接让 LLM 来做路由?
可以是可以,但是不划算。
你让一个通用 LLM 去回答“这封邮件紧急吗”,它会给你一段话。这段话要花生成的时间和 token。你的代码还得去解析、去校验,才能真正拿来做判断。
假如你让 LLM 去判断情绪等级,它可能会这么回答:
“从用户的措辞来看,他表现出明显的不满,甚至带有威胁意味,我认为情绪属于较为激烈的程度……”
你的代码要从这段话里面把“angry”给抽出来。还得处理一种情况:它哪天突然不这么说了,回答你一句“比较激动”。这个就是“文字漂移出控制契约”的风险。
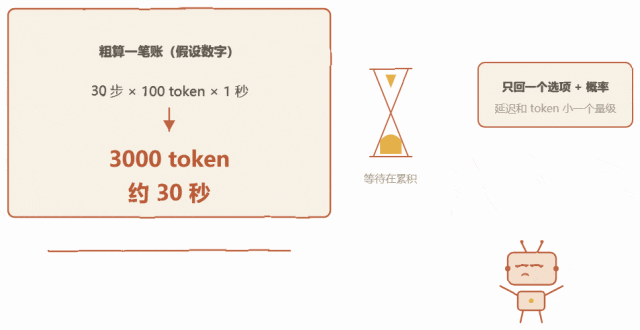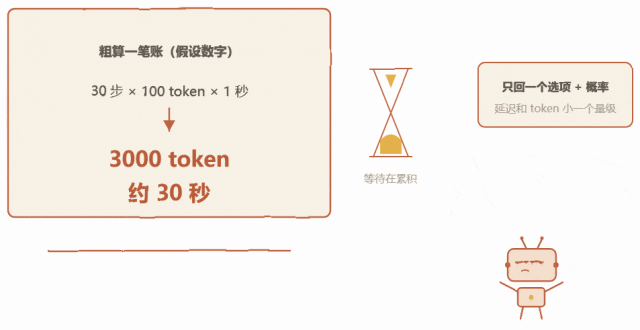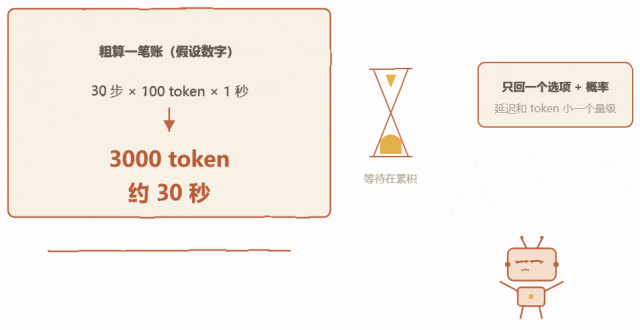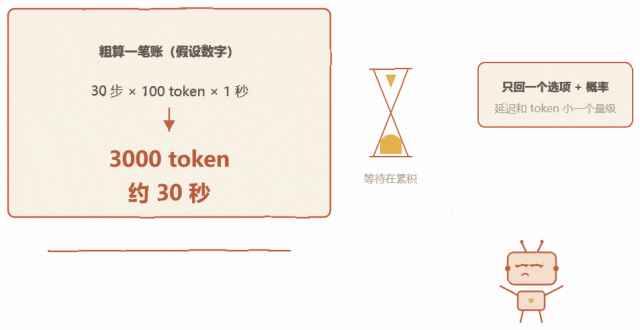
来粗算一笔账。数字全部是假设的,只是用来说明量级的思路。
假设一个任务平均有 30 个“选择题”步骤。再假设每次用 LLM 生成大概 100 个 token 的解释,才能得到答案,每次耗时 1 秒。那么光是这些决策步骤,就是 3000 个输出 token,还有大概 30 秒的累计等待。如果换成决策模型,每次只返回一个选项和概率,延迟和 token 都会小一个量级以上。
具体能省多少,这个要看你的模型、部署方式和请求规模。一定要拿你自己的数据去测。
有评测文章给过一个参考。决策步骤在关键路径上的时候,p50 延迟在 100ms 以内算很好,100 到 300ms 可以接受,超过 300ms 就得拿出相应的质量来说话了。那篇文章提到一个多问题请求在 Apple M5 上大概 495ms 的例子。这个数字来自个人评测,仅供参考,不同环境差异会很大。
六、真正的难点:概率准不准
这一点,我觉得是整件事情里面最值得聊的。
“模型选了什么”这个事情并不难。难的是它报的那个概率,可不可信。
如果模型说“我有 90% 把握”,那它在这类样本上,就应该真的能对 90% 左右。只有这样,你才敢去设一个阈值,让系统自动去执行。否则的话,置信度就只是一个好看的数字而已。
这个性质有一个名字,叫校准(calibration)。
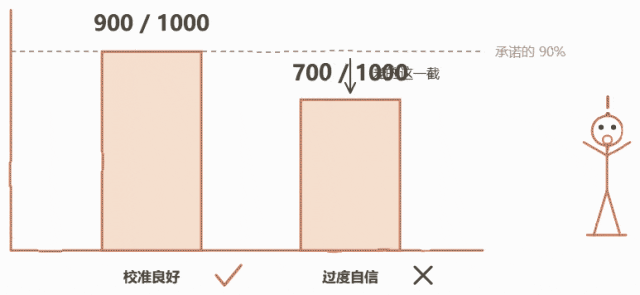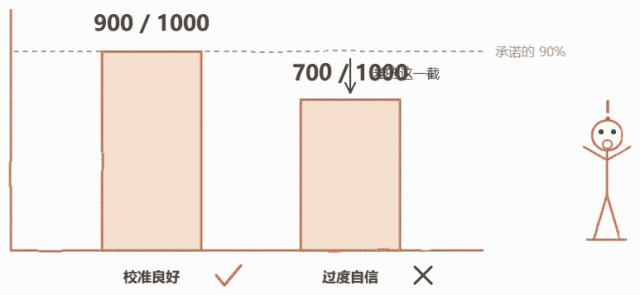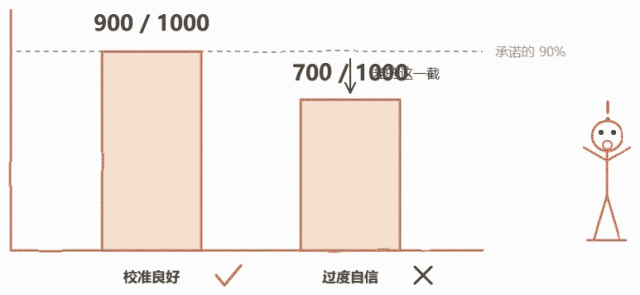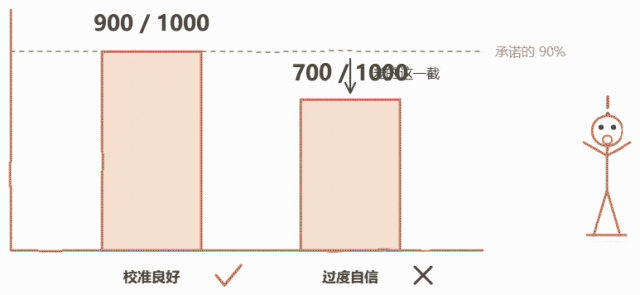
假设你拿 1000 条模型报“置信度 0.9”的样本去核对一下。
校准良好的情况是,这些样本里面大概有 900 条是对的。过度自信的情况是,实际只对了 700 条。
后面这种情况下,你把“置信度大于等于 0.9 就自动执行”当成安全线,实际上是在把大概 30% 的错误放进你的自动化流程里面。传统分类器的 softmax 分数,通常是没有校准好的。直接拿来当门槛用,是有风险的。
据介绍,Jev 提到了 RLCD 这类面向校准的训练思路,想做的事情,就是让“输出可信的概率”成为训练目标的一部分。(具体机制我没能够核实到原始细节,感兴趣的朋友,建议直接去看官方文档。)
不管你用不用 Jev,这一点都值得借鉴:让模型知道自己什么时候会错,比让它多对几个样本更重要。
七、落地:三层分工
在生产系统里面,更合理的架构,不是让一个大模型把所有事情都包办了,而是分层。
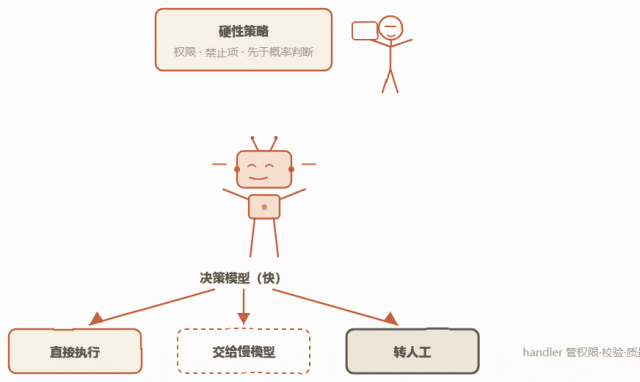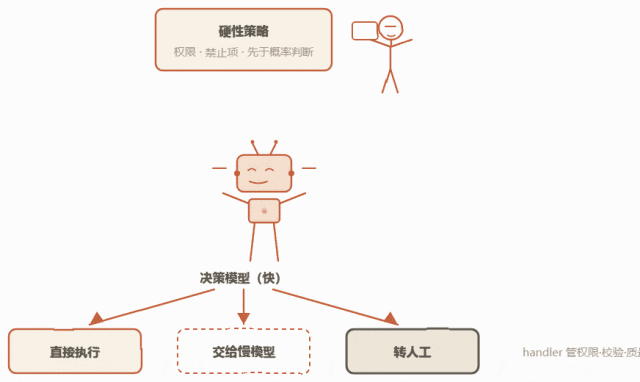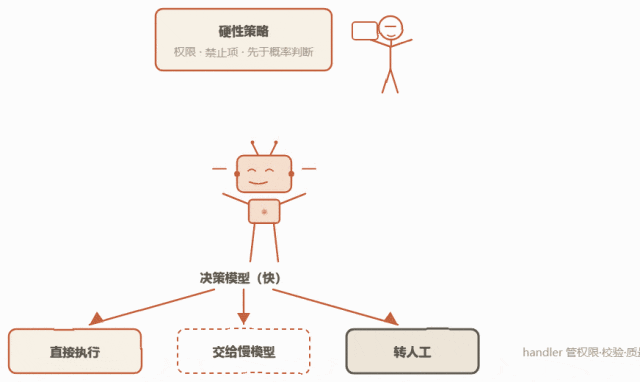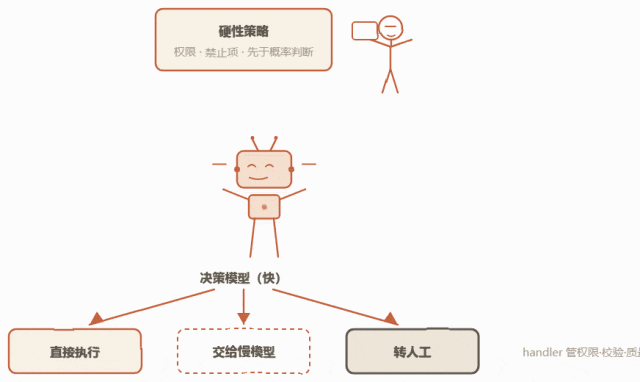
请求进来
  │
  ├─ 硬性策略(权限、禁止项)→ 写在代码里,先于一切概率判断
  │
  ├─ 决策模型(快)
  │     ├─ 高置信 + 简单 → 直接走对应 handler
  │     ├─ 低置信 / 疑难长尾 → 交给推理 LLM(慢)
  │     └─ 高风险 / 模糊 → 转人工
  │
  └─ handler 自己负责权限、校验和输出质量
用伪代码表达出来,就是这样:
if risk_class == "prohibited":      # 硬策略放在概率路由之前
    return reject()

decision = decide(                   # 示意,非真实 API
    state=request_state,
    question="该交给哪个 handler?",
    choices=ROUTES,
)

if decision.confidence >= THRESHOLD:
    return run_handler(decision.choice)
else:
    return escalate(request_state)   # 推理模型或人工
小例子:三条请求,三种走法
还是客服系统。同一时间进来了三条消息。
第一条,“查一下我的订单到哪了”。决策模型说:logistics,置信度 0.97。简单、高频、置信度高,直接走物流 Agent,不用去惊动任何大模型。
第二条,“我上周买的两件衣服,一件已经退了,另一件想换尺码,但优惠券是跨单用的,退款怎么算?”。决策模型说:after_sales,置信度 0.55。涉及多步推理,置信度低,交给推理 LLM 去处理。
第三条,“你们再不处理我就去消协投诉,顺便发到网上”。决策模型说:complaint,但是舆情风险为真。高风险,转人工。
绝大多数的请求,会落在第一种上面。所以整体的成本和延迟,就被大幅压下来了。少数疑难长尾,交给慢模型。真正敏感的,交给人。
有一个原则我是很认同的。决策模型只负责选 handler,handler 自己对权限、校验和输出质量负责。别把“模型选了”当成“可以放心执行了”。比如“退款”这种有副作用的操作,权限校验和金额计算,依然应该由代码来完成,而不是靠模型一句“同意退款”。
八、别神化决策模型
1. 它不能让业务后训练消失
零样本“看起来能用”,和“达到业务指标”之间,还有很长的一段路。要收集真实数据,要划清类别边界,要补困难样本,要建立拒识机制,还要在线上持续调优。决策模型把这些工作重新带回来了,而不是把它们取代掉了。
举个例子。你的路由里面有“售后”和“投诉”两个类别。业务方认为,“商品质量问题且用户语气不满”算售后,“对服务态度不满”才算投诉。这种内部的约定,通用模型零样本很难猜对。必须靠你自己的标注数据和困难样本,去把它对齐。
2. 上线前要做影子验证
先让它在 shadow mode 下面跑一段时间。线上依旧走原有的逻辑,决策模型只是在旁边“旁观并记录”它会怎么选。然后拿真实结果去对比。
跑了一个星期,你统计出来发现,模型在“退款相关”这一类上,报 0.9 以上置信度的样本,实际准确率只有 80%。那你就知道了,这一类的阈值得调高。或者先别让它自动处理。
3. 有界输出不等于不会错
输出被限定在你声明的范围里面,这只保证了“格式合法”,不保证“判断正确”。它还是有可能把投诉判成普通咨询。而且判错的时候,依然可能表现得很自信。
4. 并非所有场景都需要它
如果你的意图集合是固定的、数据也充足、很少变动,那微调一个 BERT 或者小模型,依然是够用的。而且更便宜、更可控。
对比一下这几种场景:
| 场景 |
更合适的选择 |
| 固定 5 个意图,历史标注数据几万条,半年不变 |
微调小模型 / BERT |
| 路由集合经常增减,每个 Agent 的职责描述会调整 |
决策模型 |
| 同一输入需要同时回答多个不同类型的问题 |
决策模型 |
| 输入是多轮对话 + 工具返回的 JSON |
决策模型(或更强的小模型) |
5. 目前缺少独立对比
我查到的材料,主要还是来自厂商和个人评测。没有看到公开的、独立的“Jev vs 微调 BERT”基准。所以“到底能准多少”这个事情,建议你拿自己的数据去测。
九、总结
回到最初的那个问题。BERT 能做意图分类,为什么还要 Jev?
BERT 解决的是固定标签下面的分类。Jev 想解决的,是标签动态变化、一个输入多个问题、输出带可信概率的“决策”。最终拼的东西仍然是:你自己的数据、校准阈值的能力,还有把“快模型 + 慢模型 + 人工”串起来的工程化落地。
决策模型不是用来取代大模型的。它的位置是——让大模型只在真正需要“说话”的时候说话。
你的 Agent 系统里面,有多少步其实只是在做选择题?数一数。那部分的开销,也许就是最值得去优化的地方。
 发表于 6 小时前
|
查看: 1|
回复: 0
 /1


