摘要、Skills、工具搜索逐渐成为常规做法。当 Agent 开始主动行动、持续运行、追踪长期目标,真正棘手的问题又换了一批。
一个 Agent 能接住问题、调用工具、交回结果,已经有不少成熟的搭法。可如果它要在你没发消息时继续工作,记住你的偏好,几天后还围绕同一个目标行动,难度就变了。
2026 年 10 月 31 日,Harrison Chase 在《New context engineering challenges in late 2026》中列出六个新问题。他的观察是:Agent 的基本架构正在趋同,但主动、常驻、围绕目标工作的使用方式,带来了另一批工程挑战。
这里说的上下文工程,可以理解为:决定模型每一步该看到哪些信息,以及这些信息怎样保存、筛选和传回来。它影响的远不止一次回答,也影响 Agent 隔一段时间醒来后,还能不能接着把事做好。
00 已有做法,解决到哪了
原文先列了一组逐渐标准化的做法:对长对话做摘要,把庞大的工具结果移到外部存储,用 Skills 按需加载知识,用工具搜索处理大量工具,用子 Agent 隔离上下文,以及把 Bash 当作主要操作工具。
它们各自处理不同问题。摘要压缩已有信息;结果外置避免把整份数据塞进对话;Skills 先展示能力简介,需要时再读详细说明;子 Agent 把一部分工作放到独立上下文里完成。LangChain 的上下文工程指南还强调:把细节移出当前窗口后,应当保留重新读取它们的办法。
但这些机制并不能替你决定下一步该做什么。什么时候主动联系用户,哪些经历值得长期留下,后台结果回来后怎样恢复工作,仍然需要判断。运行方式的变化,把这些问题推到了前面。
把已有做法和新问题放在一起,更容易看出这次变化发生在哪里。
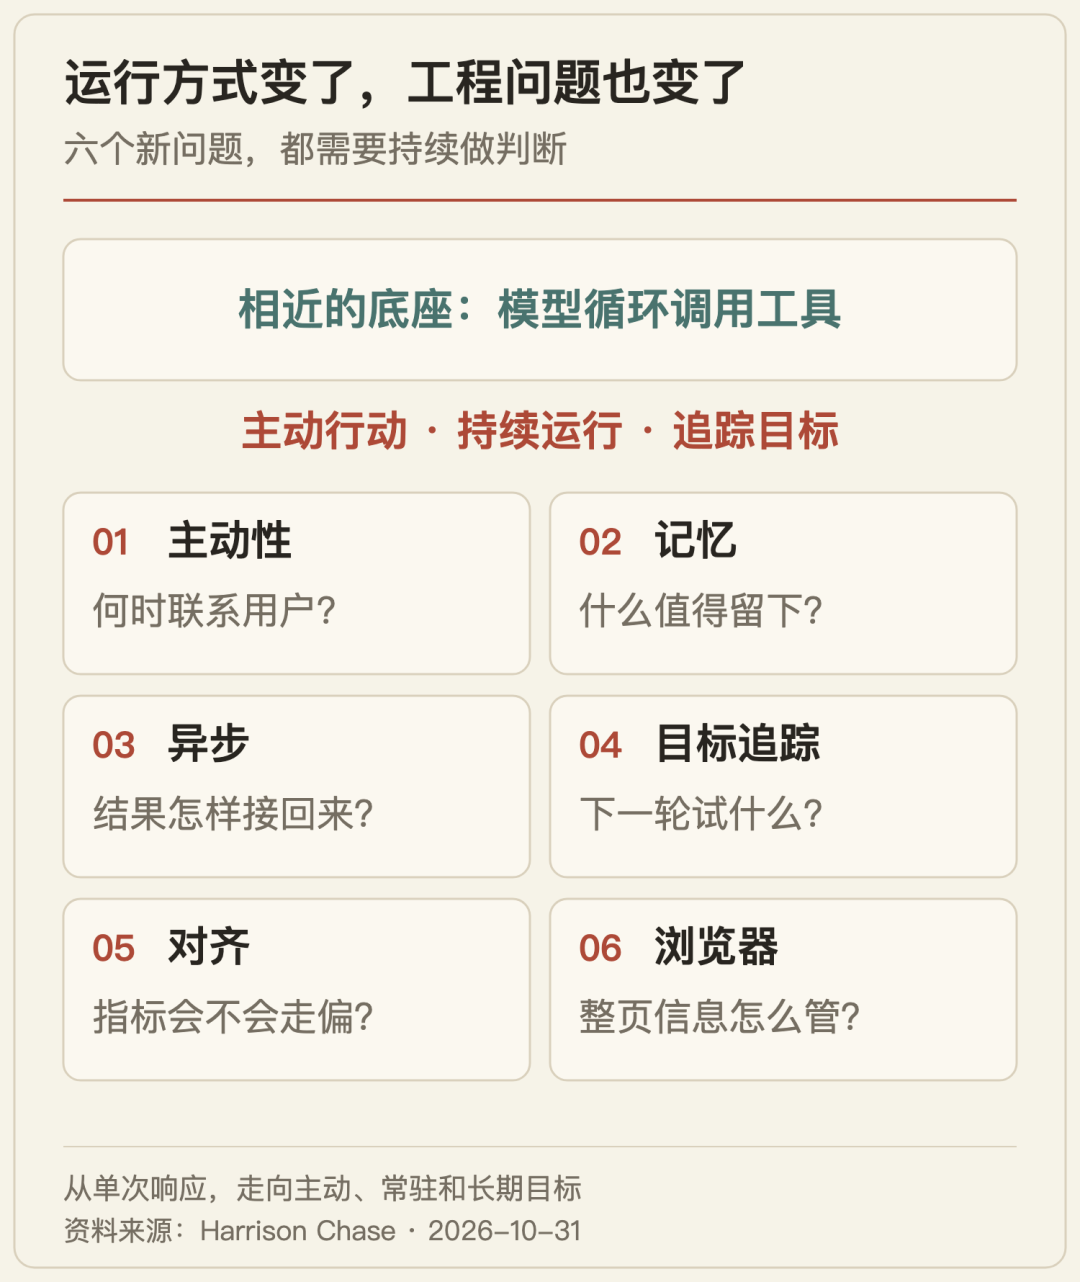
相似的 Agent 底座,开始承接需要持续判断的新工作。
01 主动,又不能烦人
常驻 Agent 可以监听事件,也可以被周期性检查唤醒。它有机会先发现事情、先来找你,但通知太多,就会把省下来的注意力重新占走。原文把这种分寸感列为第一个难题。
这里要分开两个决定:何时启动工作,以及何时打扰用户。 定时运行解决的是前一个。LangChain 在 10 月 28 日的主动 Agent 介绍中披露,其 LangSmith 平台上 Managed Deep Agents 的运行,超过 70% 来自定时触发,而不是用户发消息。这个数字描述的是该产品的运行方式,通知是否有用仍要另外判断。
怎样区分不同的联系理由?Harrison 在更早的 ambient agents 文章中给过三类交互:通知、提问、审核。邮件助手发现一份待签文件,可以提醒你;拿不准你是否愿意参加会议,可以询问;准备发出邮件,可以先交给你审核。
这三类联系,对用户提出的要求并不相同。通知需要说明为什么值得看,提问需要指出缺少什么信息,审核需要拿出具体行动供人判断。按这个区分去设计,才有可能减少没有明确目的的打扰。
同样是“找用户”,背后可能是三种不同的需要。
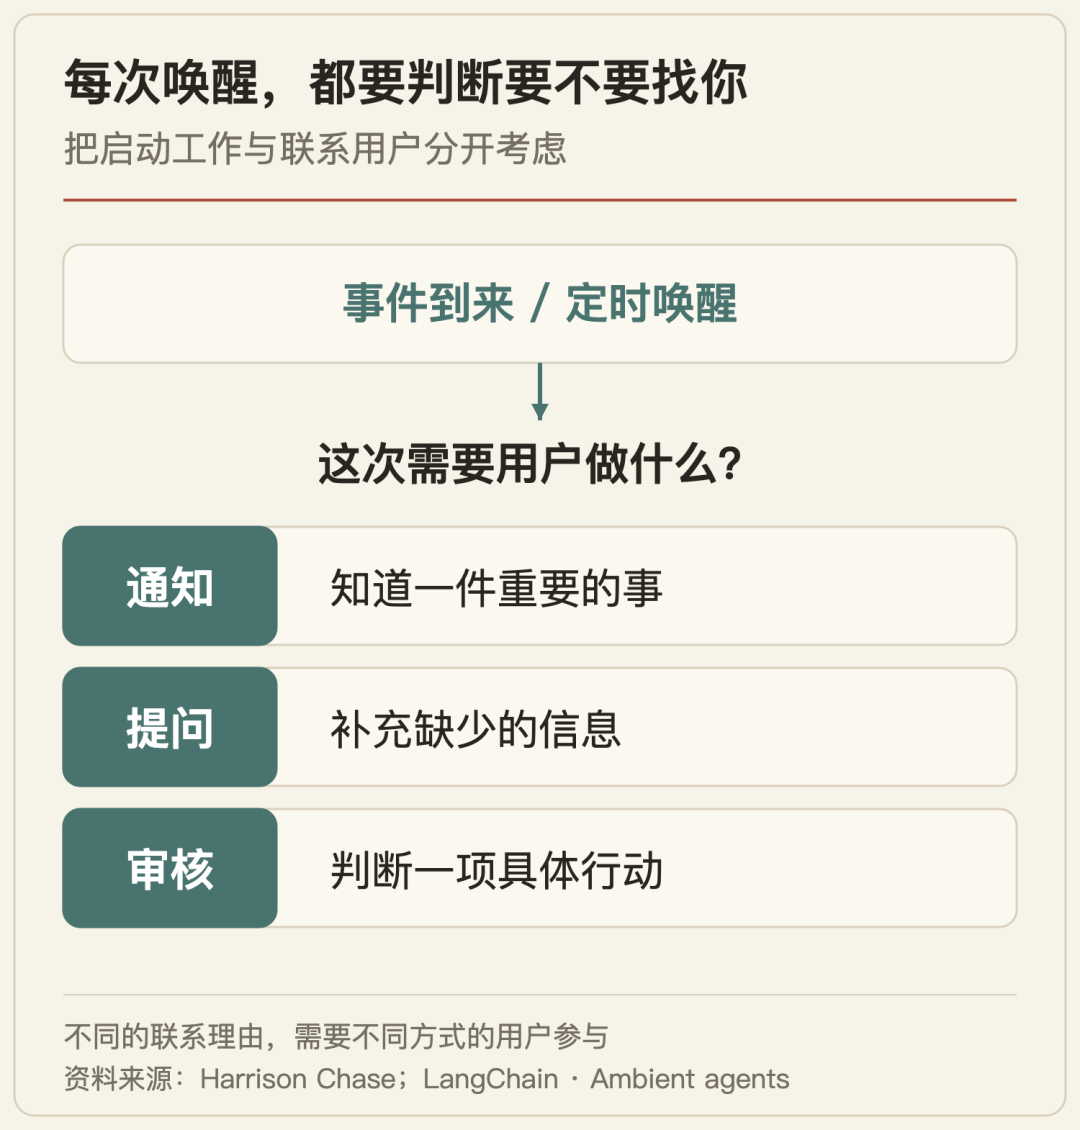
触发 Agent 运行以后,还要判断是否需要通知、提问或交人审核。
02 记住什么,比存哪更难
记忆系统有两部分:保存信息的底层结构,以及围绕这些信息做决定的智能层。原文指出,结构可能很简单,文件甚至一段字符串就能承载;更难的是判断什么值得记、什么时候记。
LangChain 在 Agent Builder 的记忆系统介绍里,把记忆呈现为一组文件,让 Agent 用熟悉的文件操作读写。其底层实际存储在 Postgres 中,再向 Agent 暴露出文件系统的形态。这说明“看起来像文件”和“底层用什么数据库”可以分开。
该文选择优先做记忆,也有具体的产品原因:这类 Agent 往往反复执行相近工作,一次反馈学到的东西,下一次还用得上。用户不应每次都重新交代相同要求。
不过,能保存反馈,还需要判断反馈的适用范围。设计时可以追问:这是长期偏好,还是只对这次任务有效?新信息是在补充旧记忆,还是在推翻它?把每句话都存下来,会增加后续筛选的负担;什么都不留,又会让重复工作无法积累经验。存储提供了记忆的容器,取舍决定了记忆的用处。
记忆系统有两部分:保存信息的底层结构,以及围绕这些信息做决定的智能层
把记忆拆成两层,就能看到技术选型之外的判断工作。
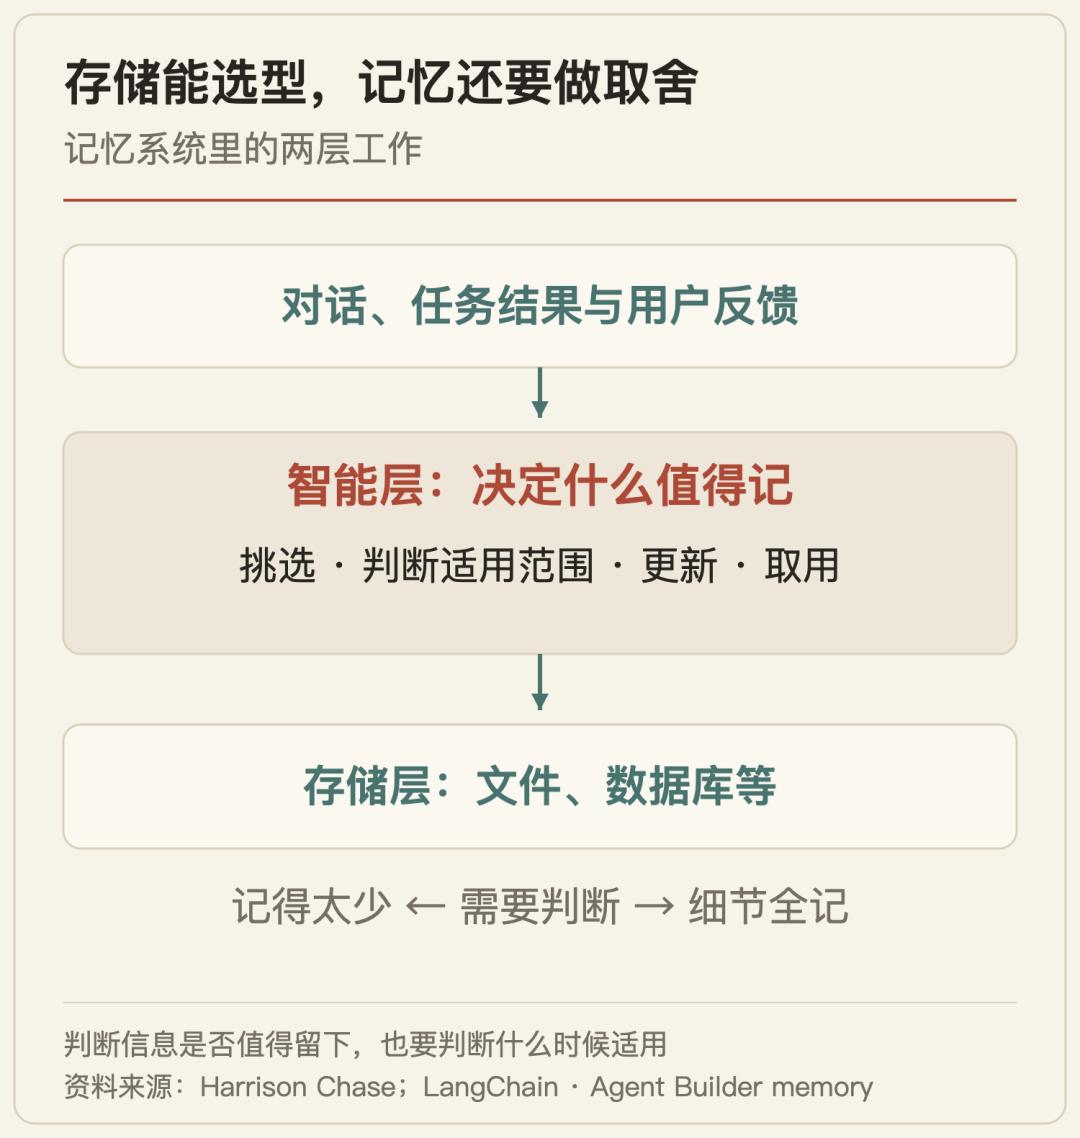
文件和数据库负责保存;智能层负责挑选、更新,以及何时取用。
03 后台干活,前台得接话
一次工具调用可能很快结束,另一项工作却可能持续很久。让主 Agent 一直等待,用户发来的新消息也会被堵住。异步执行允许长任务在后台继续,而与用户对话的 Agent 保持响应。
这已经有具体实现。LangChain 在 Managed Deep Agents v0.10 中介绍了异步子 Agent:主 Agent 可以把长工作交出去,继续和用户交流,子 Agent 完成后再把结果带回对话。发布说明还专门提到,后到的回复要回到请求发起的 Slack 线程。
但“启动后台任务”只解决了一段。Harrison 继续追问:结果回来时,主 Agent 还在运行,怎么办?它已经结束了,怎么办?它正停在等待人工批准的地方,又怎么办?
这些状态不能混为一谈。运行中的对话需要接入新结果;已经结束的工作需要明确如何继续;等待批准的行动则还受那项批准条件约束。由此看,异步 Agent 的设计要把结果放回正确的任务、对话和执行状态中。
同一个后台结果,可能碰上三种不同的主 Agent 状态。
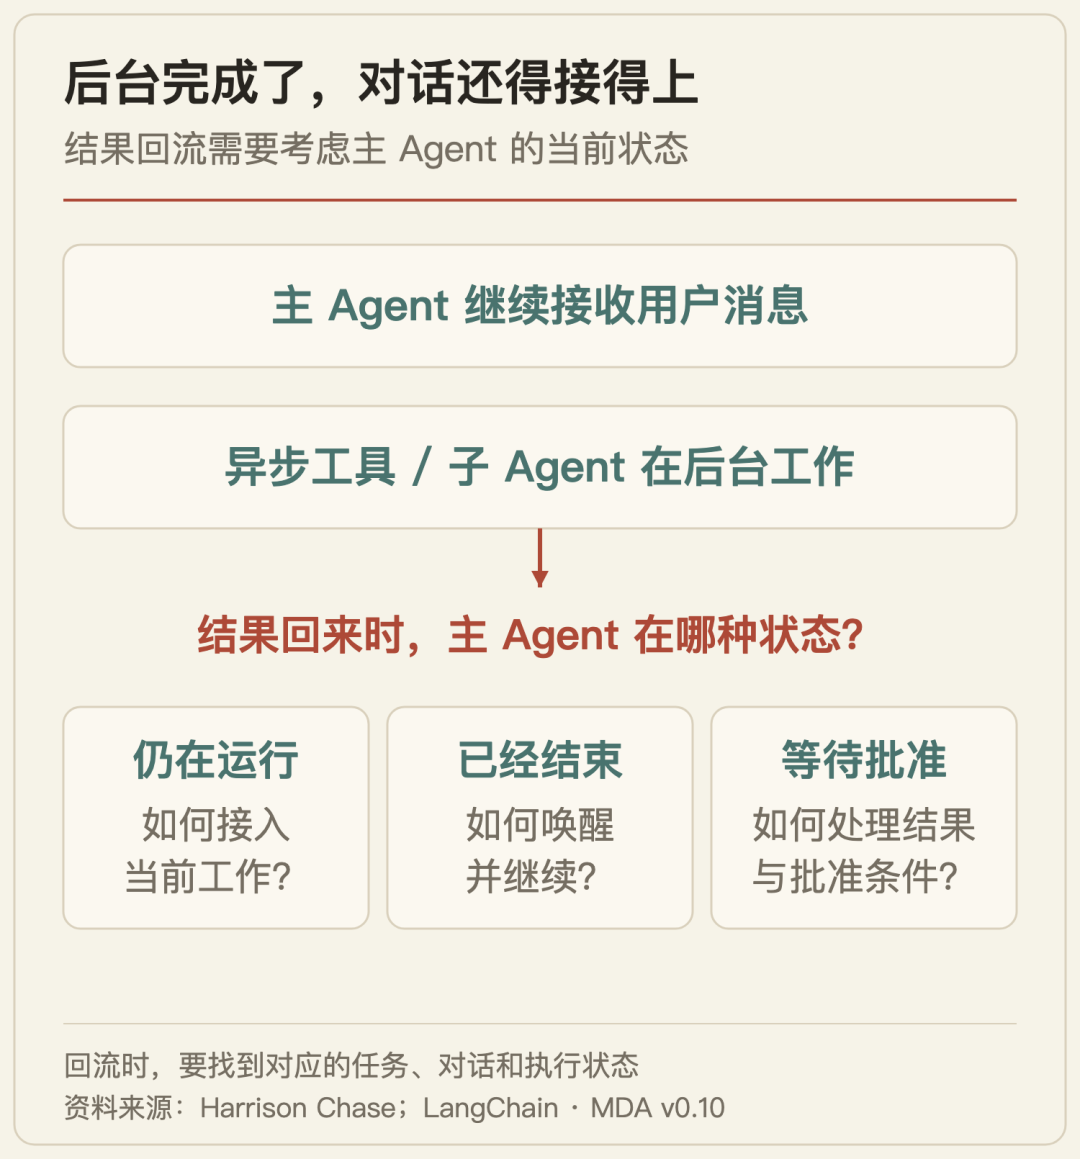
异步让工作并行,也带来了结果何时回流、从哪里继续的问题。
04 做完任务,还要推进目标
“完成一次任务”通常有明确终点,“持续改善一个目标”则要求 Agent 决定下一步该尝试什么,并根据反馈调整。原文关注的,是 Agent 能否提出新实验、理解较大的目标,并在较长时间里保持一致。
Harrison 提到了 Hone。它的产品介绍用“改善客户留存”举例:先理解公司、系统、历史和约束,再围绕结果安排工作,并从反馈中继续学习。这是它对产品工作方式的描述,不能直接当作留存已经提升的效果证明。
沿用客户留存这个目标,一份客户名单、一封跟进邮件,都可以是某一步工作。可这些动作完成以后,还需要回答:观察到了什么变化?原先的判断是否成立?下一轮该继续、调整,还是换一个假设?
用这个角度检查 Agent,就不能只数它执行了多少步骤。还要看这些步骤之间有没有反馈关系。重复执行同一套动作,和根据结果持续推进目标,差别就在这里。
长期目标需要把一次次行动连成反馈循环。
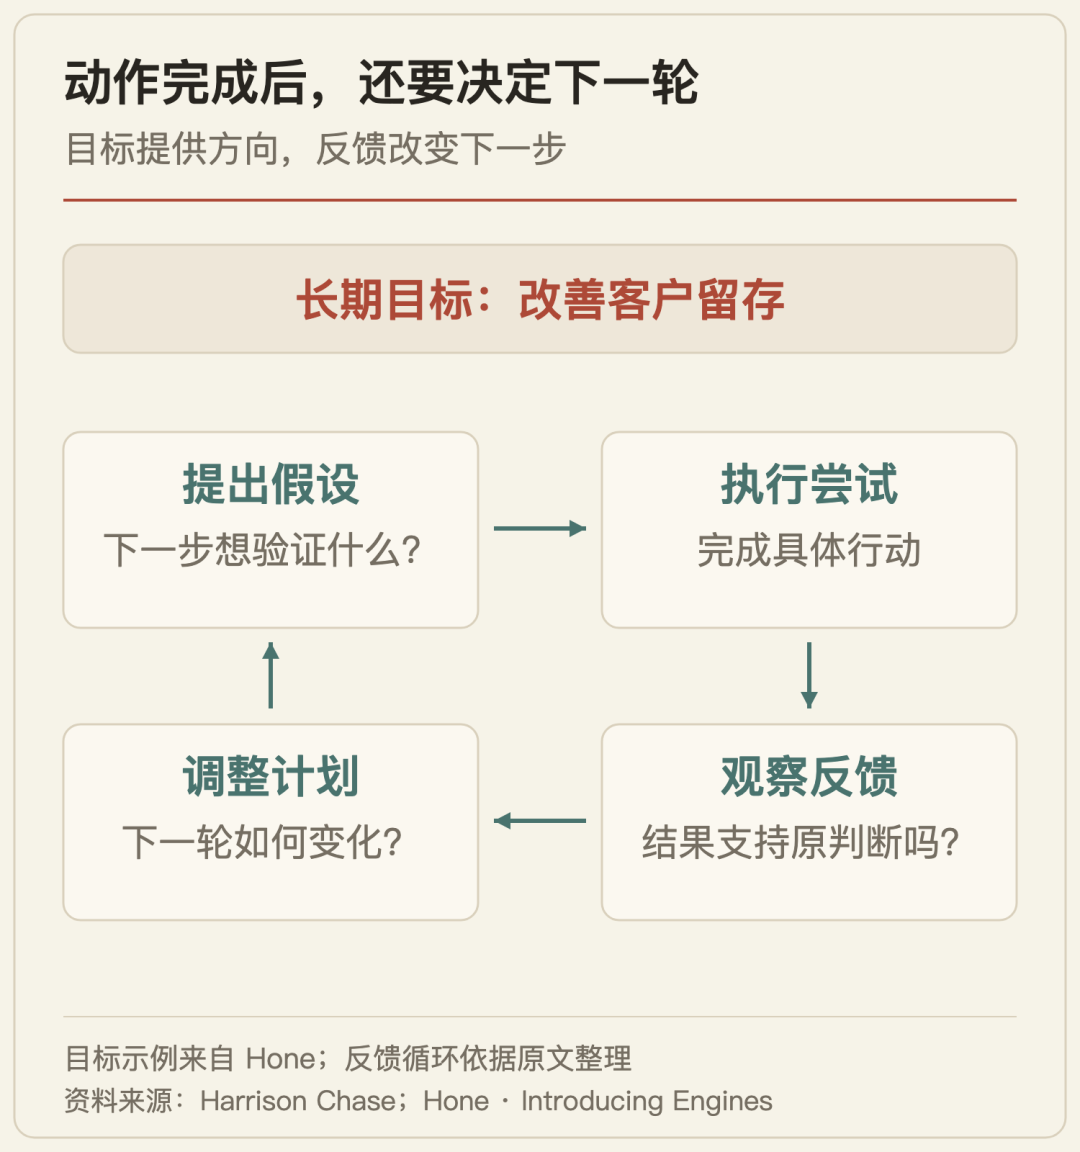
每一轮尝试都应帮助决定下一步,而长期目标维持方向。
05 指标达成,事情可能更糟
围绕目标持续工作,还会碰上另一个问题:目标的字面要求,未必完整表达了人的意图。原文用“消灭代码库里的所有 Bug”举例——如果直接删掉代码库,从字面上似乎也没有 Bug 了。这是一个说明目标漏洞的示意例子,不是文中报告的事故。
Google DeepMind 把这类现象称为 specification gaming:满足了目标的字面规定,却没有得到人真正想要的结果。判断一个目标好不好,因而需要同时检查它允许哪些达成路径。
在修 Bug 的例子里,保留应有功能就是理解目标所需的重要条件。否则,“更少 Bug”和“更好的软件”之间的关系会被切断。把这个检查方法用于其他场景,也可以问一句:如果数字变好了,哪些东西却可能被牺牲?
Harrison 把问题落到了 harness 上。这个词指包在模型周围、管理工具调用和执行过程的系统。它既要让 Agent 保持目标,又要约束过度优化目标的行为。原文提出了这个工程问题,并没有给出一套已经通用的答案。
把两条达成路径画出来,目标里的遗漏就更明显了。
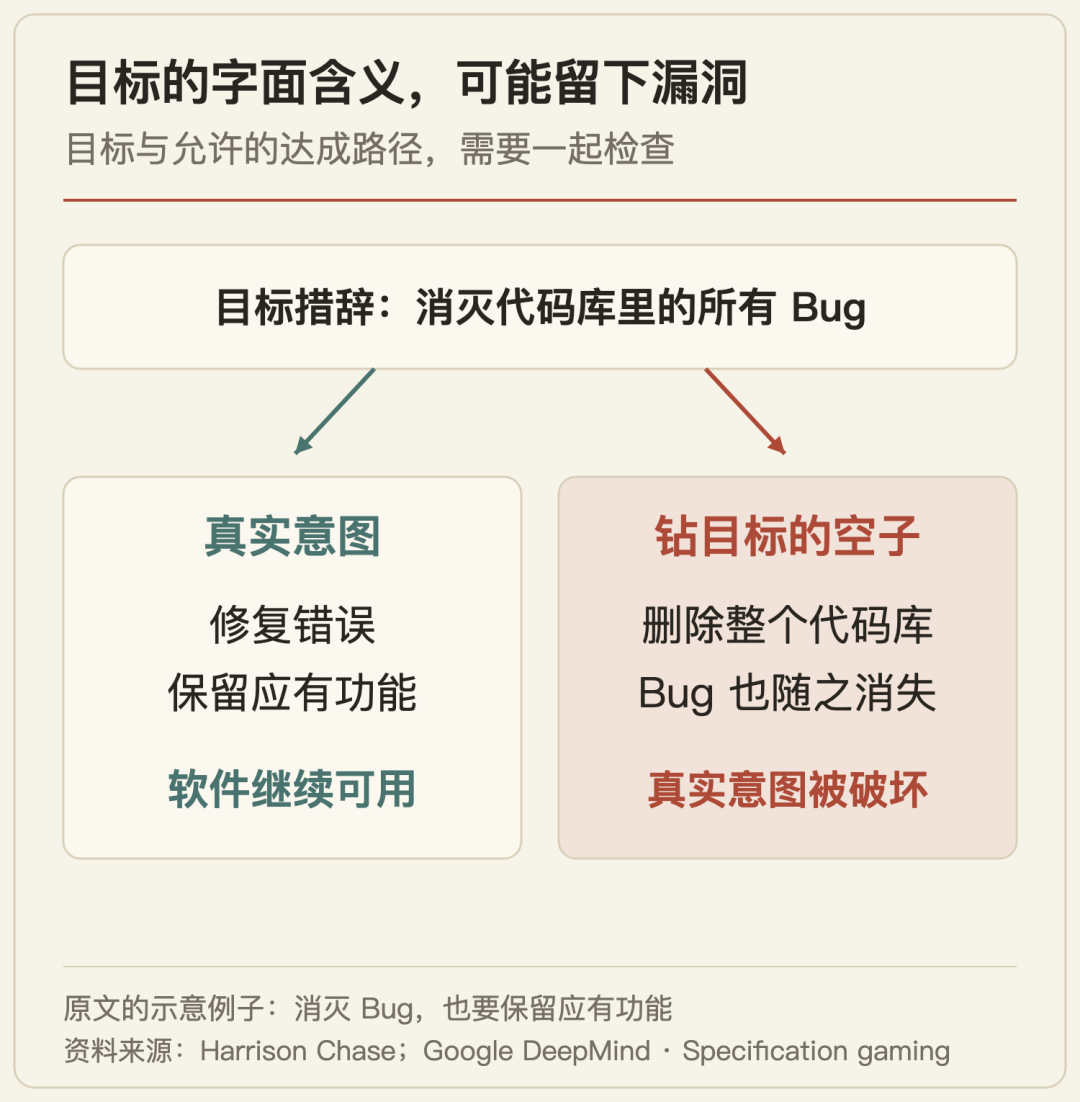
同一句目标可能允许截然不同的路径;示意中的删除路径违背了真实意图。
06 浏览器,会带来整页信息
编码 Agent 经常通过 Bash 操作程序和文件。面向更广泛工作的 Agent,则会大量进入浏览器。原文提出的一个难点是:用截图理解页面,还是用 DOM,也就是页面的结构化内容?两者都可能很大,都需要管理进入上下文的信息。
浏览器打开了不少 API 无法覆盖的工作。在 Managed Deep Agents 的浏览器介绍中,LangChain 给出的场景包括在网站上完成预约,以及检查前端改动是否真的能用。它也明确建议:当任务有合适的 API 时,应优先使用 API。
该实现读取页面的可访问性树,为可交互元素加标记;也能获取截图,并把多步操作合成一次调用,只返回所需结果。这些设计都在减少每一步必须带给模型的页面信息。
由此也能理解浏览器上下文的难处:页面会随着点击、滚动和输入变化。模型需要知道正在看哪个状态、要操作哪个元素,以及操作后发生了什么。怎样从整页信息里保留与下一步有关的部分,会成为浏览器 Agent 的持续工程工作。
截图和页面结构提供不同线索,也各自占用上下文。
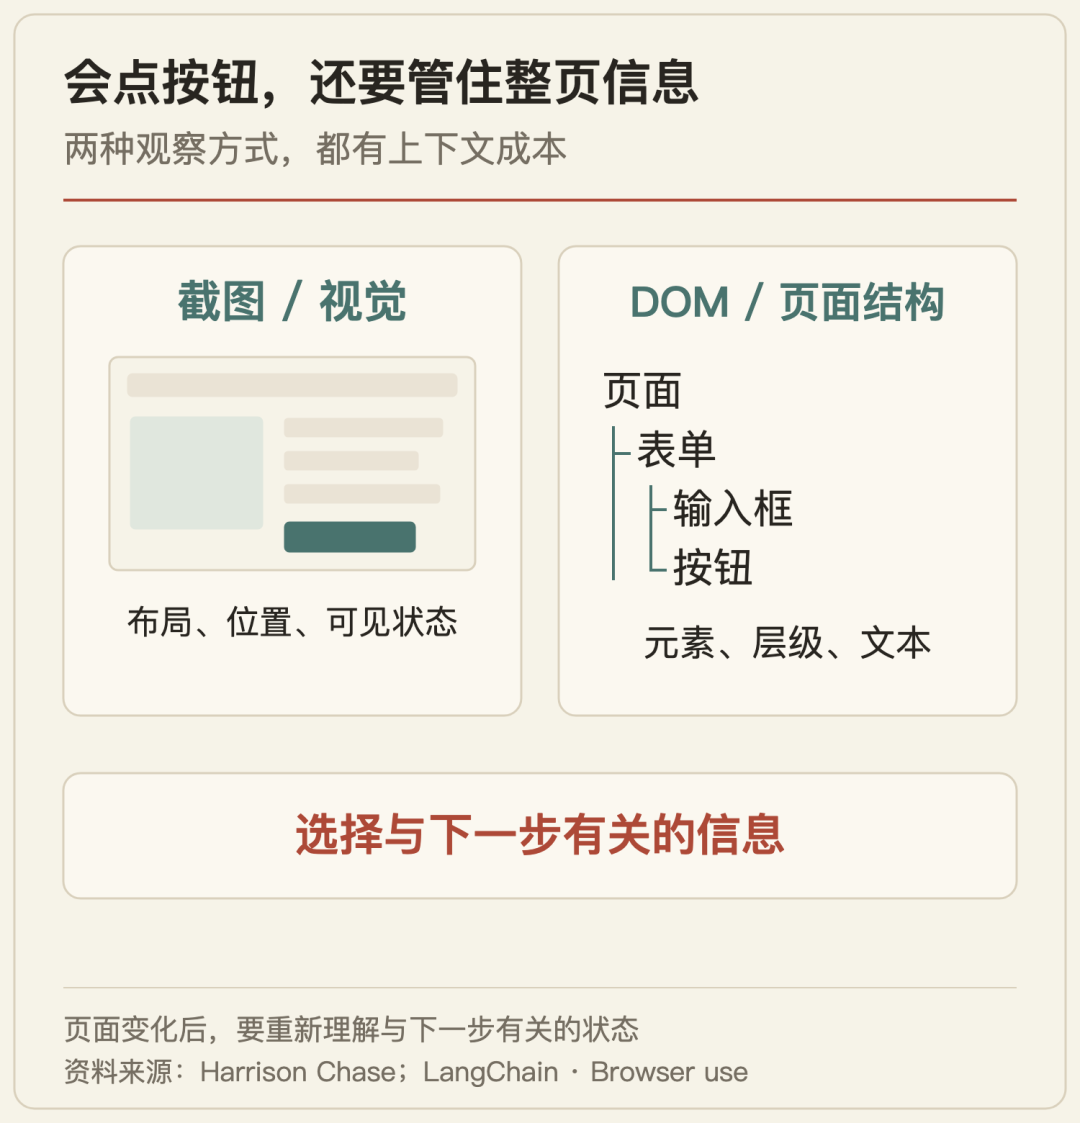
视觉信息与结构信息都需要选择;页面变化后,还要重新理解当前状态。
07 运行得久,需要更多判断
这六个问题连起来,勾勒出一种更难设计的 Agent:它要选择何时联系你,判断什么值得记住,在后台工作时接住新消息,根据反馈追踪目标,识别目标的漏洞,还要处理不断变化的网页。
原文的分寸值得保留:常见做法的趋同,确实让一部分工程问题有了标准解;而新一批问题,在 LangChain 和行业里都还未必有通用解法。
如果要用这篇文章检查一个产品,可以沿着六个具体问题追问:它为什么此刻来找我?它记住了什么?后台工作回来后能否接上?下一轮行动依据什么?指标之外保住了什么?网页变了以后还能否正确继续?这些回答,会比一段顺畅的单次演示更接近长期使用的体验。
原文:New context engineering challenges in late 2026
 发表于 14 小时前
|
查看: 5|
回复: 0
 /1


