原文地址: https://medium.com/@gaddamnaveen192/from-5-seconds-to-300ms-how-i-fix-database-performance-problems-in-production-b420aad63655
原文作者:Gaddam.Naveen
编译:闫虹志
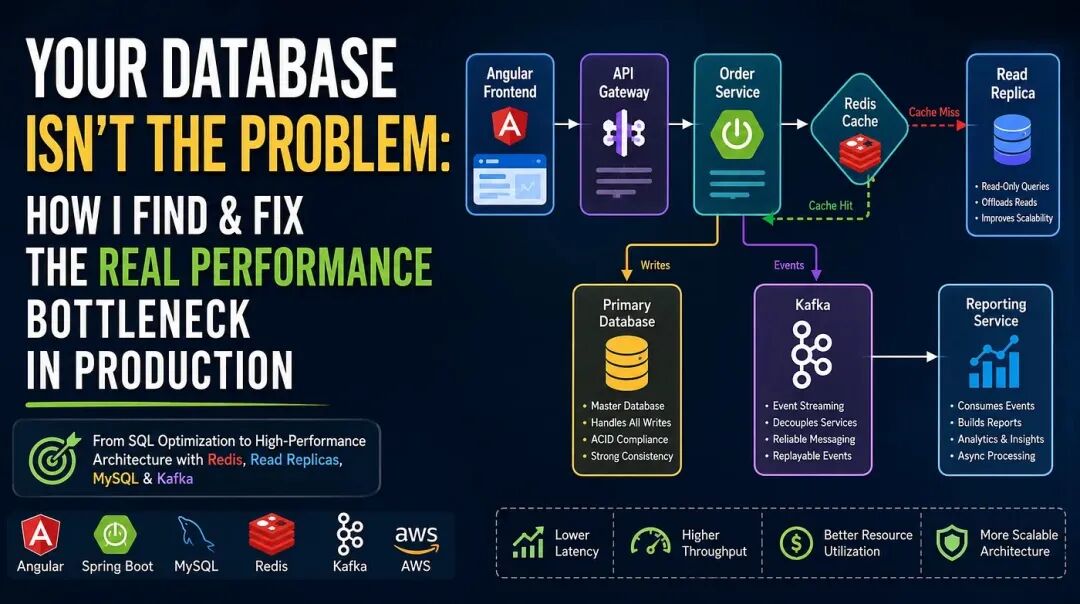
几个月前,凌晨 2 点,我被叫进了一个紧急作战室。一个通常能在约 400 毫秒内返回的 API 端点,突然需要 5 到 7 秒。前端团队被用户投诉轰炸。Slack 上最初的消息是:“Java 应用卡死了。”
我从事后端开发已经十多年了。以前,我犯的第一个错误就是认为应用代码是一切问题的根源。现在,我明白事实并非如此。多数情况下,当 Spring Boot 服务在负载下开始步履蹒跚时,CPU 其实处于空闲状态,线程都在等待,而真正的瓶颈正藏在 AWS VPC 的某个阴暗角落里:MySQL 数据库。
但我不会盲目地开始编写索引,也不会一遇到问题就搬出 Redis。我首先需要证据。
下面是我在生产环境中诊断、修复并验证数据库性能时采用的确切方法。
第一部分:如何在不靠猜测的情况下识别数据库瓶颈
在动一行 SQL 之前,我会先追踪请求路径。在微服务架构中,每一跳都可能累积延迟。
我们来拆解一次标准的 Spring Boot API 调用:
- 网络: 请求到达 Load Balancer 和 API Gateway 所需的时间。
- 应用逻辑: 在 Controller、Service 和 Repository 层花费的时间。
- 连接池: 等待 HikariCP 连接所花费的时间。
- 查询执行: MySQL 用于解析、规划和扫描的时间。
- 网络(再次): 将结果集传回所需的时间。
- 映射: Hibernate 将 ResultSet 映射为 Java 对象所花费的时间。
如果 Java 服务的 CPU 使用率很高,通常是映射问题(Hibernate 正在处理数百万行数据的繁重工作)或垃圾回收。但如果 CPU 使用率很低、响应时间却很长,那就是一个明显的信号:应用正在等待某个东西。通常,它等待的就是数据库。
我会在 Grafana 中查看以下指标:
- API 响应时间(P95/P99): 由外而内观察的标准指标。
- 数据库查询延迟: JDBC driver 或数据库端记录的时间。
- HikariCP 等待线程数: 这一点至关重要。如果
hikaricp.connections.pending 持续上升,我们变慢并不是因为查询本身很慢,而是因为拿不到运行查询所需的连接。
- 数据库 CPU 与应用 CPU: 如果数据库 CPU 已满载,而应用 CPU 只有 20%,那就是数据库问题。如果数据库 CPU 只有 5%,查询却要 5 秒,那么很可能遇到了锁等待或严重的 I/O 瓶颈。
- 检查行数与返回行数: 如果 MySQL 检查了 100 万行却只返回 10 行,这条查询做了大量不必要的工作。
区分问题的流程如下:
我会查看 trace(使用 Spring Cloud Sleuth 或 Micrometer)。如果 trace 显示 Service 层调用耗时 10 毫秒,而 Repository 调用耗时 3 秒,我就找到了瓶颈。如果 Repository 调用很快,但整个请求很慢,我就会检查连接池等待时间。问题几乎总是出在这两者之一。
第二部分:高层架构——修复系统,而不只是修复查询
有时是查询本身很糟糕。另一些时候,查询完全没有问题,但围绕它的架构却在试图让一条河流穿过一根吸管。在深入研究 EXPLAIN 之前,我会先检查这一层面。
读写分离
如果我们运行的是高流量订单管理系统,读取操作(查看订单状态)会远多于写入操作(创建订单)。如果 Primary DB 同时处理两者,写入会被持有锁的读取阻塞,读取也会被生成 undo log 的写入阻塞。
解决方案是使用 Read Replica:
- 写入: 发送到 Primary。
- 读取: 发送到 Replica(通过 Spring 的
@Transactional(readOnly = true) 路由或 AbstractRoutingDataSource)。
代价是复制延迟。如果用户创建订单后立即刷新页面查看,而这次读取落到了 Replica 上,他们可能会看到 404。对于“先写后读”的流程,我会强制 Repository 从 Primary 读取。这是为了保证一致性而付出的一点小代价。
缓存:一把双刃剑
Redis 是标准答案,但我见过由糟糕的缓存失效机制引起的生产事故,比慢数据库导致的还多。
Cache-Aside 模式是我的默认选择。当 API 调用到来时:
User -> API -> Redis -> Database
如果 Redis 中有数据,就直接返回;如果没有,则查询数据库、填充 Redis,然后返回结果。
- Redis 有帮助的场景: 读取频率高、写入频率低,例如产品目录和配置数据。
- Redis 有害的场景: 持续变化的数据。如果缓存用户余额,而余额每秒都在变化,那就是在玩火。
缓存击穿: 如果为一条极其热门的记录设置 5 分钟 TTL,那么在它到期的那一刻,5000 个并发请求都会发现缓存为空,并一窝蜂地涌向数据库。解决方法通常是在 TTL 上增加少量随机抖动;对于关键路径,则可以在填充缓存时加锁。
连接池:沉默的杀手
HikariCP 非常优秀,但我经常看到团队配置错误。它的默认最大连接池大小为 10。对小型服务而言,这或许足够;但在负载下,如果服务有 200 个线程、连接池却只有 10 个连接,就会有 190 个线程处于等待状态。
然而,把连接池大小增加到 100 并不能解决任何问题。MySQL 的内部线程数是有限的。如果我打开 100 个连接,同时发起 100 条繁重且消耗大量 CPU 的查询,数据库会因过度上下文切换而让一切陷入停滞。
我采用的经验法则是:如果一条查询耗时 10 毫秒,一个连接每秒就能处理 100 条查询;10 个连接则可以处理 1000 qps。如果连接池耗尽,通常意味着查询耗时过长(例如 1 秒),而不是需要更多连接。先修复查询,再确定连接池大小。
微服务的倍增效应
用户在 Angular 前端单击一次,会触发对 Order Service 的 API 调用。Order Service 调用 Payment Service,Payment Service 再向 Inventory Service 验证。
- 1 个用户请求 -> 3 次服务调用 -> 9 条数据库查询
如果有 1000 名用户在线,那么每个“逻辑”请求就会产生 9000 条查询。我总会关注扇出。有时,解决方法是合并两个服务,或用异步 Kafka 事件取代同步 REST 调用。并不是每个服务都需要同步访问数据库才能返回响应。
第三部分:底层数据库优化(深入探究)
如果架构合理、连接池也很健康,我就会卷起袖子,开始研究 SQL。
3.1 识别慢查询
我会为 MySQL 启用 Slow Query Log,并设置合理的阈值,例如 long_query_time=1 秒。但这里有一个陷阱:最慢的查询不一定就是问题所在。
查询 A:耗时 5 秒,每小时运行 10 次(总负载:50 秒/小时)。
查询 B:耗时 100 毫秒,每小时运行 50000 次(总负载:83 分钟/小时)。
真正拖垮数据库的是查询 B,但它可能永远不会出现在“最慢的 10 条查询”报告中。因此,我会优先寻找高频查询。
接下来,自然要使用 EXPLAIN——通过它,我们可以准确了解 MySQL 如何执行查询。
3.2 EXPLAIN ANALYZE
发现可疑查询后,我不会猜测。我会运行 EXPLAIN;如果使用 MySQL 8 或更高版本,则最好运行 EXPLAIN ANALYZE。然后查看执行计划。
我会检查输出中的以下字段:
type:在大型表上,ALL(全表扫描)是一个危险信号。index(全索引扫描)通常也好不到哪里去。rows:优化器认为需要检查多少行。filtered:经过 WHERE 子句处理后,剩余行所占的百分比。Extra:如果看到 Using temporary 或 Using filesort,说明数据库正在内存或磁盘中执行繁重处理。
一个真实示例:
我最近检查过一条耗时 2 秒的查询。EXPLAIN 显示 rows=2,000,000,但 filtered=1.0。优化器为了返回 20 行,扫描了 200 万行。这就是索引问题。
3.3 索引:B-Tree 的艺术
索引是一种有序数据结构(通常是 B+Tree),让数据库能够以 O(log n) 而不是 O(n) 的时间复杂度找到一行数据。
但索引并不是免费的。每次执行 INSERT、UPDATE 和 DELETE,都必须同时更新表和索引。给一个写入频繁的表添加 10 个索引,会摧毁写入吞吐量。
复合索引
这是我见过错误最多的地方。请看下面这条查询:
SELECT *
FROM orders
WHERE customer_id = 100 AND status = 'SHIPPED'
ORDER BY created_at DESC
LIMIT 20;
正确的索引是 idx_customer_status_created (customer_id, status, created_at)。
为什么?
B-Tree 从左到右对数据排序。如果为 (customer_id, status, created_at) 建立索引,数据库就能直接跳转到 customer_id = 100,再沿 status 分支查找。由于 created_at 在索引中也已经排好序,因此数据库无须另行排序就能满足 ORDER BY。这就是一个“覆盖”索引或“最优”索引。
如果我分别为 customer_id、status 和 created_at 创建三个索引,MySQL 很可能只会使用其中一个(选择性最高的那个),然后手动筛选其余条件,有可能因此扫描数千行。
如果索引建立在 (A, B, C) 上,它适用于:
WHERE A = ?
WHERE A = ? AND B = ?
WHERE A = ? AND B = ? AND C = ?
但它无法高效地单独用于 WHERE B = ?。
3.4 糟糕的索引示例
如果我看到 WHERE 子句对列应用了函数,就知道索引已经失效。
-- 不佳:由于使用了 LOWER(),email 上的索引无法生效
SELECT * FROM users WHERE LOWER(email) = 'test@test.com';

-- 良好:在应用中将 email 存储为小写,或使用生成列
SELECT * FROM users WHERE email = 'test@test.com';

-- 不佳:由于进行了算术运算,id 上的索引无法生效
SELECT * FROM users WHERE id + 10 = 100;

-- 良好
SELECT * FROM users WHERE id = 90;
如果数据库必须先计算一个表达式才能找到值,就无法使用索引。
3.5 查询优化:改写查询
有时,问题在于查询的结构不正确。
- *`SELECT
:** 我会避免在生产环境中使用它。如果只需要customer_id和status,选择全部字段会把通常存储在页外的TEXT/BLOB` 列也包括进来,从而产生额外的磁盘 I/O。这也会破坏覆盖索引。
- 大型
IN 子句: WHERE id IN (1, 2, 3, … , 5000)。这有时会让优化器无所适从。我通常会改为与临时表执行 JOIN,或把查询拆成多个批次。
- 相关子查询: 外层查询的每一行都可能触发一次相关子查询。使用带
GROUP BY 的 JOIN 通常更快。
- 深度
OFFSET: 见下文。
3.6 N+1 问题
这是最常见的 JPA/Hibernate 错误。如果我获取 100 个订单,并在循环中调用 order.getCustomer().getName(),Hibernate 就会运行 101 条查询。
List<Order> orders = orderRepository.findAll(); // 查询 1
for (Order order : orders) {
    order.getCustomer().getName(); // 查询 2、3、4……101
}
解决方法是 JOIN FETCH:
@Query("SELECT o FROM Order o JOIN FETCH o.customer")
List<Order> findAll();
需要警惕的是:对集合使用 JOIN FETCH(例如,在获取 Orders 的同时获取 OrderItems)可能导致结果集规模因笛卡尔积而爆炸式增长。如果一个 Order 有 10 个 item,那么同时获取 Orders 和 Items 时,每个 Order 会返回 10 行。Hibernate 会对其去重,但 MySQL 仍然要通过网络发送所有这些数据。对于集合,我更倾向于使用 DTO projection 或 @BatchSize。
3.7 分页
如果前端有一个“前往第 100 页”按钮,SQL LIMIT 10 OFFSET 100000 就会迫使 MySQL 获取 100010 行、丢弃前 100000 行,再返回最后 10 行。这样的成本极其高昂。
Keyset Pagination 是更好的方式。
不要使用:
SELECT * FROM orders LIMIT 10 OFFSET 100000;
我会使用:
SELECT * FROM orders
WHERE id > 100000
ORDER BY id
LIMIT 10;
这样可以直接跳转到相应 ID,并且只读取 10 行,扩展性非常好。代价是无法直接跳到“第 100 页”,而必须按顺序滚动。
3.8 事务与锁
一条查询单独运行时可能很快,但在并发环境下会因为锁等待而变慢。
我最近调试过一个问题:一条 SELECT 只在特定时段耗时 10 秒。最终发现,原因是一个每晚运行的批处理任务开启了长事务:
BEGIN;
UPDATE orders SET status = 'PROCESSING' WHERE customer_id = 123;
-- ……由于调用外部 API,等待 5 分钟……
COMMIT;
由于该事务持有行锁长达 5 分钟,其他所有试图读写该客户订单的服务都被阻塞在队列中。
解决方法是尽可能缩短事务。绝不要在 @Transactional 块中进行 HTTP 调用或发送电子邮件。
第四部分:高性能系统的底层设计
我们来为一个订单管理系统设计数据层。它具有以下特点:
- 读取流量高(用户查看状态)。
- 写入流量中等(用户提交订单)。
- 按 Customer ID、Status 和 Date 搜索。
架构:
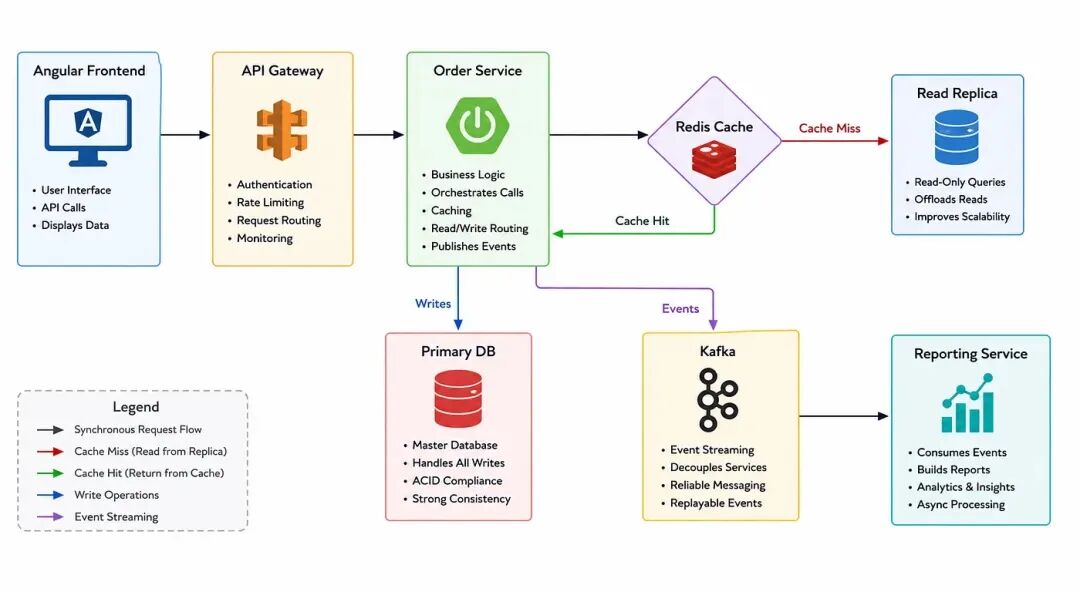
数据访问策略如下:
- 高频读取: 缓存在 Redis 中(TTL 为 60 秒)。如果缓存为空,则从 Read Replica 读取。
- 写事务: 直接发送到 Primary DB。事务必须简短。
- 报表/繁重分析: 不允许 Reporting Service 访问主数据库。我们把订单数据推送到 Kafka,由 Reporting Service 消费数据,并在自己的 schema(或 OLAP store)中聚合。
Schema 与索引:
我们让 orders 保持规范化。我们不会把所有数据反规范化到一个巨大的 JSON blob 中,但会在 orders 表中复制 customer_name。为什么?因为在订单详情页面读取客户姓名是一种高频读取,而姓名并不会变化。对于这条特定的读取路径,我们可以避免与 customers 表执行 join。它以存储空间为代价提高了速度,这就是反规范化。
索引:
idx_orders_customer_id (customer_id, created_at):用于“My Orders”列表。idx_orders_status_date (status, created_at):用于管理面板中的“Shipped Orders”列表。
第五部分:一个真实的生产优化案例
问题:端点 GET /api/orders/customer/12345 发生超时。
原始查询(由 Hibernate 生成):
SELECT o.*, c.*, oi.*
FROM orders o
LEFT JOIN customers c ON o.customer_id = c.id
LEFT JOIN order_items oi ON o.id = oi.order_id
WHERE o.customer_id = 12345
ORDER BY o.created_at DESC;
该表包含 2000 万条订单,而这位客户有 50000 个订单。
调查结果:
EXPLAIN: type=ALL。数据库忽略了 customer_id 上一个旧的单列索引,因为它估计与 order_items 执行 join 后,需要返回 400000 行。- 真正的问题: 与
order_items 的 JOIN 发生在 LIMIT 之前。MySQL 对数千个 item 进行排序和 join,却只是为了返回前 10 个订单。
解决方案:
改写查询: 我拆分了查询。首先,获取订单:
SELECT id, total, created_at
FROM orders
WHERE customer_id = 12345
ORDER BY created_at DESC
LIMIT 10;
这条查询可以完美利用索引,并瞬间返回 10 行。
批量获取: 然后,获取这 10 个订单中的 item:
SELECT * FROM order_items WHERE order_id IN (101, 102, 103...);
这会使用 order_items 的 Primary Key。
改进索引: 我为 orders 表添加了复合索引 (customer_id, created_at)。
验证结果:
- 优化前: P95 = 2.8 秒,数据库 CPU 满载。
- 优化后: P95 = 220 毫秒,数据库 CPU 降至 30%。
为什么这样做有效?
因为我不再要求数据库对数十万行执行复杂的多表 join,而是让它执行两次非常简单且使用索引的查找。数据库可以分别优化每次查询,再由应用逻辑把结果拼接起来。有时,经过最佳优化的查询实际上是两条简单查询。
第六部分:我不会做什么
- 到处添加索引: 索引会拖慢写入。我只针对特定的查询模式添加索引。
- 盲目扩大连接池: 如果连接池耗尽,就意味着数据库已经饱和。添加更多连接只会增加上下文切换,让情况变得更糟。
- 在修复 SQL 之前引入 Redis: 如果 SQL 正在执行全表扫描,Redis 只会让填充缓存变得更慢,并掩盖真正的问题,直到为时已晚。
- 过早引入分片: 分片会带来巨大的运维复杂性。在需要分片之前,垂直扩展、分区和 Read Replica 可以支撑很长一段路。如果能避免分片,我就会避免。
- 无谓地使用微服务: 每一次网络跳转都会增加延迟,每个服务也会为数据库增加一个连接池。有时,模块化单体架构速度更快,也更容易维护。
第七部分:实用的生产环境检查清单
当一个由数据库支持的 API 变慢时,我会按以下顺序检查:
- API 延迟: 时间花在了哪里?查看 trace。
- 连接池: 是否有线程在等待连接?
- 数据库 CPU/I/O: 数据库是不堪重负,还是无所事事?
- 查询频率: 哪些查询运行得最频繁?
- Slow Query Log: 哪些查询占用的总时间最长?
EXPLAIN ANALYZE: 查询是否在做无谓的工作?- 锁: 是否存在争用或阻塞?
- N+1 查询: ORM 是否生成了过多 SQL?
- 缓存命中率: Redis 是否真的带来了帮助?
- 负载测试: 推送到生产环境之前,先模拟流量。
- 生产验证: 部署后检查指标。
 发表于 28 分钟前
|
查看: 3|
回复: 0
 /1


