VMP(Virtual Machine Protection,虚拟机保护)简单说就是把 .so 中的关键代码转换成自定义的虚拟指令,交给程序内置的虚拟机执行,以此来增加逆向分析的难度。这里的 VMP 泛指代码虚拟化保护。
程序在正常情况下的执行顺序是:ARM64 原生指令 → CPU 直接执行。
经过虚拟化保护后,将关键代码转换成自定义字节码,再将字节码交由内置的解释器进行读取并且执行,结果保持不变。
简单来说,就是将原本走直线的路径改成了多绕几圈。
实现后的解释器效果可以参考下图(图片来自某加固厂商)。
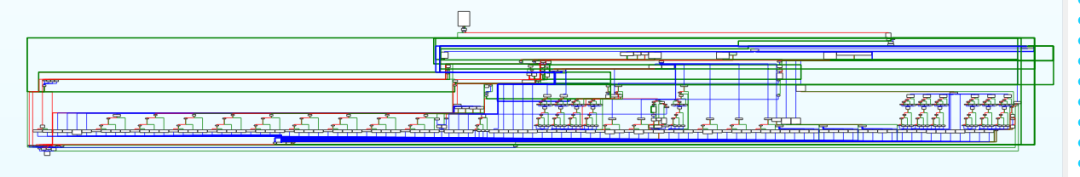
本文的目标就是自己手动实现一个可以在安卓 APP 上运行的 mini 版本,以此来提升对虚拟化保护的理解。
被保护函数
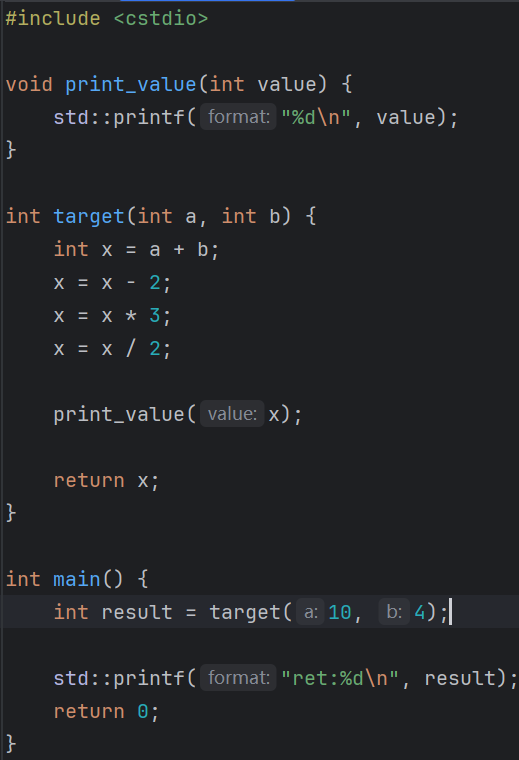
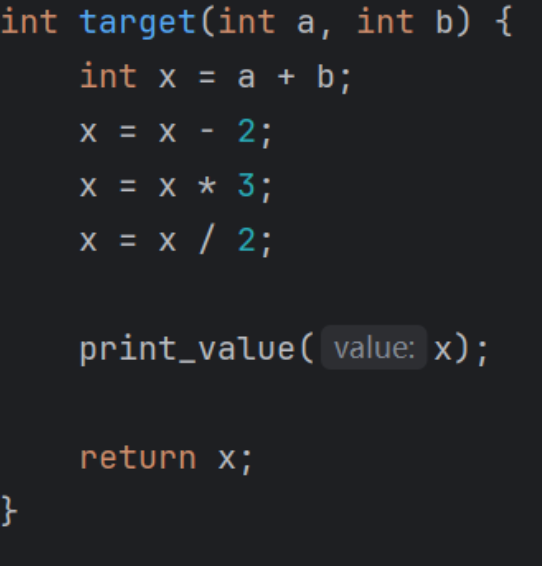
下面这个就是将要受到保护的函数,可以很清晰地看出整体逻辑非常简单:对 a、b 两个参数进行加减乘除运算后,将结果交由 print_value 函数打印日志。
运行后的结果长这样:
虚拟化保护实现
存储位置
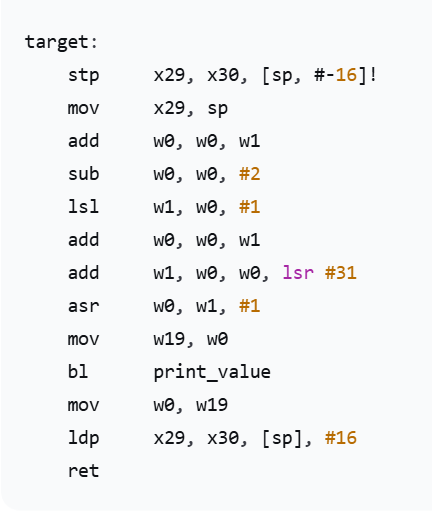
target 函数经由编译器编译后的汇编大概长这样:
但是现在我想换一种组织方式去实现。
要实现这种方案,我需要一份数据来描述要执行的计算步骤,还需要一段执行程序:读取这份数据,按照里面描述的步骤进行计算。
简单来说,就是希望 x = a + b 不再只是一个固定写在 target 里的 C++ 操作,而是可以通过一份数据表达出来。
假设要给另外一段程序发送一条计算要求,让它完成这句:
x = a + b
这条要求至少需要说明:做什么操作(加法)、第一个数从哪里取(从 a 取)、第二个数从哪里取(从 b 取)、计算结果存放在哪里(放到 x)。
如果不知道这些,执行者就不知道该算什么、用什么算、算完存哪里。
当然也可以直接在数据里写 a、b、x。设计完后指令长这样:
ADD x a b
但是还需要再做一个按名字查找的表来保存值:
名字       值
"a"        10
"b"        4
"x"        0
执行器读取这条指令时,根据 "a" 查出 10,根据 "b" 查出 4,相加得到 14,再把名字 "x" 对应的值更新为 14。
这条路线是成立的,只是需要处理字符串以及名字与值的查找。所以无论用名字还是数字,都得自己规定:执行器去哪里取这些值。
既然已经知道执行器需要拿到 a、b,还需要一个地方保存结果 x,一个很普通的办法就是数组:
int values[3] = {};
然后做一个约定:
values[0]:保存 a 的值
values[1]:保存 b 的值
values[2]:保存 x 的值
再把入参放进去:
values[0] = a;
values[1] = b;
此时,例如调用 target(10, 4),数组就是:
下标       保存的值
 0            10
 1             4
 2             0
于是这里不需要再实现字符串查找,直接用数组下标就行。
虚拟寄存器
现在已经有了 int values[3]。执行器会用这些位置保存输入和中间结果。如果规定:
R0 表示 values[0]
R1 表示 values[1]
R2 表示 values[2]
就可以把 values[2] = values[0] + values[1]; 写成一种方便阅读的表示:R2 = R0 + R1。
这里的虚拟寄存器并非每个虚拟机都是同一种实现,也可以使用前面提到的按名字保存值的表、操作数栈等其他存储方式。
操作数
原来由 a、b、x 承担的存储工作,现在可以由三个数组元素承担。但是还没有实现由数据描述计算步骤,因为 values[2] = values[0] + values[1] 仍然把加法和操作的位置都写死在了 C++ 代码里。
#include <cstdio>

int target(int a, int b) {
    int values[3] = {};

    values[0] = a;
    values[1] = b;

    values[2] = values[0] + values[1];

    return values[2];
}

int main() {
    std::printf("%d\n", target(10, 4));
    return 0;
}
现在先把 values[2] = values[0] + values[1] 里的三个下标拿出来,保存成一份数据:
unsigned char instruction[] = {2, 0, 1};
这里的顺序按照下面的约定排序:
第 0 项:结果位置
第 1 项:左边来源
第 2 项:右边来源
所以 {2, 0, 1} 的意思就是:结果放在位置 2,左边从位置 0 取值,右边从位置 1 取值。
这里还要区分两个数组:
| 数组 |
保存什么 |
values |
运算中的实际数值,例如 10、4、14 |
instruction |
如何选择这些位置的说明,例如 2、0、1 |
代码长这样:
int target(int a, int b) {
    int values[3] = {};

    values[0] = a;
    values[1] = b;

    // [结果位置, 左边来源, 右边来源]
    unsigned char instruction[] = {2, 0, 1};

    int dst = instruction[0];
    int lhs = instruction[1];
    int rhs = instruction[2];

    values[dst] = values[lhs] + values[rhs];

    return values[2];
}
现在实现的是由数据决定操作数来自哪里,以及结果写到哪里。但还没有做到由数据决定做什么运算,因为:
values[dst] = values[lhs] + values[rhs];
这里的 + 仍然写死了。如果要下一步做减法,不可能再去写一个只会减法的执行器。需要在说明数据里再放一个字段,交代清楚执行器这次执行到底是加还是减。
操作码
还是最朴素的方式,约定:
1 表示加法
2 表示减法
这两个数字没有特殊含义,既不是 CPU 规定的,也不是 C++ 规定的。换成 17 表示加法、29 表示减法 同样可以。只要写数据的人和读取数据的执行器遵守同一份约定就行。
给原来的格式增加一个字段。原来是 [结果位置, 左边来源, 右边来源],现在变为:
[操作码, 结果位置, 左边来源, 右边来源]
于是 unsigned char instruction[] = {1, 2, 0, 1}; 表示 values[2] = values[0] + values[1];,而 unsigned char instruction[] = {2, 2, 0, 1}; 表示 values[2] = values[0] - values[1];。
现在有了操作码,读取部分可以写成:
int op  = instruction[0];
int dst = instruction[1];
int lhs = instruction[2];
int rhs = instruction[3];
还需要解决怎么根据不同的操作码做不同的事情。现在操作码是 int op = instruction[0];,最普通的 if 判断就能实现:
if (op == 1) {
    values[dst] = values[lhs] + values[rhs];
} else if (op == 2) {
    values[dst] = values[lhs] - values[rhs];
}
但是用 1、2 这种名称来记录对应关系不太直观,可以起个别名:
enum Opcode : unsigned char {
    ADD = 1,
    SUB = 2
};
现在就可以写成:
unsigned char instruction[] = {ADD, 2, 0, 1};
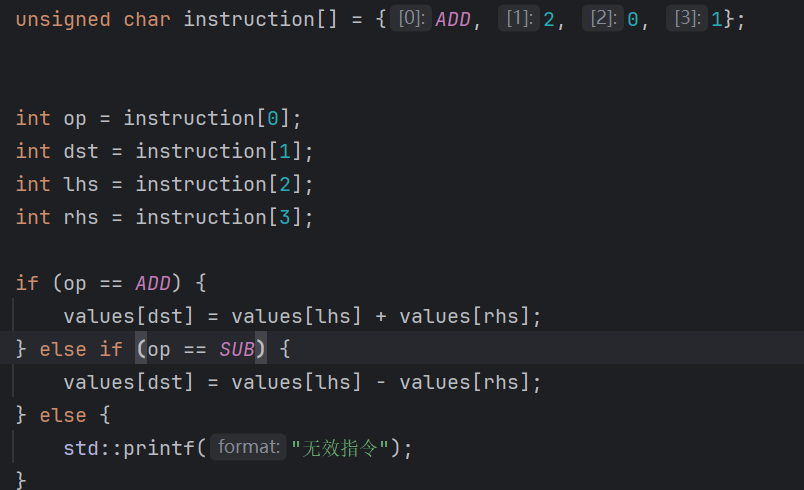
现在就拥有一条完整的、能够被执行器理解的指令(操作码、结果位置、左边来源、右边来源)。
但是目前还是只能执行一条。在原函数中需要先加、再减、再乘、再除,这就产生了一个新问题:如果把多条指令接在同一个数组里面,执行器怎么知道当前读到哪条了,以及下一条从哪里开始?
PC
在前面我们只能描述 int x = a + b;,现在操作码已经定义好了,可以新增一点:
int x = a + b;
x = x - b;
第一步表示为:
values[2] = values[0] + values[1];
ADD, 2, 0, 1
第二步表示为:
values[2] = values[2] - values[1];
SUB, 2, 2, 1
接下来,一个直接的想法就是把两条指令依次放进同一个数组:
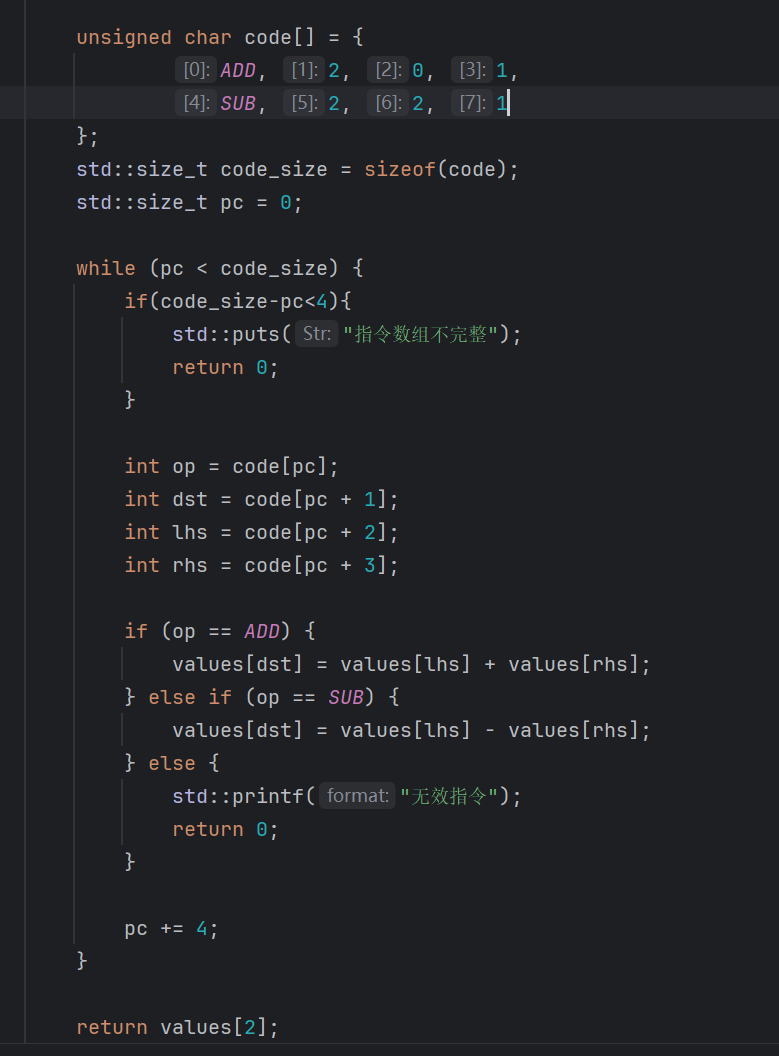
unsigned char code[] = {
    ADD, 2, 0, 1,
    SUB, 2, 2, 1
};
这里从 instruction 改名为 code,是因为它现在保存了一组指令,不再只是一条。
程序运行时知道前四个元素是一条指令,是因为我们做了约定:每条指令固定占据四个元素。这里的每个元素类型是 unsigned char,占一个 C++ 字节,因此也可以说每条指令占据四个字节。
先不用循环,用笨办法写一下。目前执行一条指令时,我们这样读取:
int op  = code[0];
int dst = code[1];
int lhs = code[2];
int rhs = code[3];
如果要读第二条,很容易想到:
int op  = code[4];
int dst = code[5];
int lhs = code[6];
int rhs = code[7];
这里就有规律了:第一条的起点是 0,第二条的起点是 4,如果有第三条起点就是 8,以此类推。
因为每条指令占据四个字节,所以每执行完一条,下一条的起点就向后移动四个字节。我们不需要为每一条指令复制一套读取代码,只需要让读取起点发生变化。把当前读取起点保存成一个变量:
std::size_t offset = 0;
offset 就是偏移量。在这里它表示当前这条指令的开头距离 code 数组开头有多少个字节。读取指令可以改成:
int op  = code[offset];
int dst = code[offset + 1];
int lhs = code[offset + 2];
int rhs = code[offset + 3];
当 offset = 0 时,读的是 code[0]、code[1]、code[2]、code[3];当 offset = 4 时,读的是 code[4]、code[5]、code[6]、code[7]。读取代码没有变,但它能通过起点变化读取不同的指令。
可以把它改名为:
std::size_t pc = 0;
此 pc 非彼 pc,在当前设计中,它只是字节码数组中的一个偏移量。之所以叫虚拟 PC,是因为在当前这套规则里,它负责跟踪虚拟指令的位置。
所以现在的执行顺序变成了:
从 PC 指向的位置读取一条指令
执行这条指令
PC + 4,指向下一条
对应代码:
int op  = code[pc];
int dst = code[pc + 1];
int lhs = code[pc + 2];
int rhs = code[pc + 3];

// 执行……

pc += 4;
因此:
开始时 pc = 0
执行第一条
pc 变成 4

执行第二条
pc 变成 8
可以通过 std::size_t code_size = sizeof(code); 得到整个数组的字节数(也就是 8),用来做终止条件:
while (pc < code_size) {
    // 读取
    // 执行
    // pc += 4
}
只要没有走到数组末尾,就继续处理下一条指令。
新指令
原函数前两步是:
int x = a + b;
x = x - 2;
第一步目前已经会表达,但是第二步里有一个常量。根据前面定义的规则,没办法对这个常量进行计算。
要解决也很简单:为这个常量准备一个存储位置,然后从这个位置取值,就可以参与运算了。最简单的办法就是直接 values[3] = 2,然后:
values[2] = values[2] - values[3];
就能完成 x = x - 2;。
但是之前的目标是尽量让具体计算步骤由指令数据描述。往一个位置放入常量也可以由指令描述。这里增加一种操作:把指令中直接给出的数值写入指定位置,例如把数值 2 写入位置 3。这个指令起名叫做 LOADI,数值直接写在指令里面,不需要根据位置编号再去别的地方读取。
新指令格式可以规定为:
[LOADI, 目标位置, 直接给出的数值, 暂时不用]
例如:
LOADI, 3, 2, 0
表示 values[3] = 2;。因为给 LOADI 的第三个字段规定的含义是直接数值,而不是来源位置。数据里的一个字节到底表示位置还是数值,是由指令格式决定的,不是数字自己决定的。
最后一个放 0 是因为每条指令固定占据四个字节,而 LOADI 只需要三个字段,需要多放一个作为填充。
在之前只有三个有效位置,现在想要使用位置 3,就必须新增一个元素,最开始的约定也需要改变:
int values[4] = {};
位置 0:保存 a
位置 1:保存 b
位置 2:保存中间结果 x
位置 3:暂时保存计算需要的常量
先给新操作分配一个编号:
enum Opcode : unsigned char {
    ADD   = 1,
    SUB   = 2,
    LOADI = 3
};
然后增加一种判断即可。但是需要先把变量名调整一下。对于加减法,dst、lhs、rhs 这些名字很贴切;但对于 LOADI 来说,第三个字段不是左边来源而是一个常量,第四个字段也不是右边来源而是未使用字段。因此用中性的名称更不容易误解:
int op = code[pc];
int p1 = code[pc + 1];
int p2 = code[pc + 2];
int p3 = code[pc + 3];
p1、p2、p3 就是参数一、参数二、参数三。代码可以写成这样:
#include <cstddef>
#include <cstdio>

enum Opcode : unsigned char {
    ADD   = 1,
    SUB   = 2,
    LOADI = 3
};

int target(int a, int b) {
    int values[4] = {};

    values[0] = a;
    values[1] = b;

    unsigned char code[] = {
        ADD,   2, 0, 1,
        LOADI, 3, 2, 0,
        SUB,   2, 2, 3
    };

    std::size_t code_size = sizeof(code);
    std::size_t pc = 0;

    while (pc < code_size) {
        if (code_size - pc < 4) {
            std::puts("指令数据不完整");
            return 0;
        }

        int op = code[pc];
        int p1 = code[pc + 1];
        int p2 = code[pc + 2];
        int p3 = code[pc + 3];

        if (op == ADD) {
            values[p1] = values[p2] + values[p3];
        } else if (op == SUB) {
            values[p1] = values[p2] - values[p3];
        } else if (op == LOADI) {
            values[p1] = p2;
        } else {
            std::puts("无法识别的操作码");
            return 0;
        }

        pc += 4;
    }

    return values[2];
}

int main() {
    std::printf("结果:%d\n", target(10, 4));
    return 0;
}
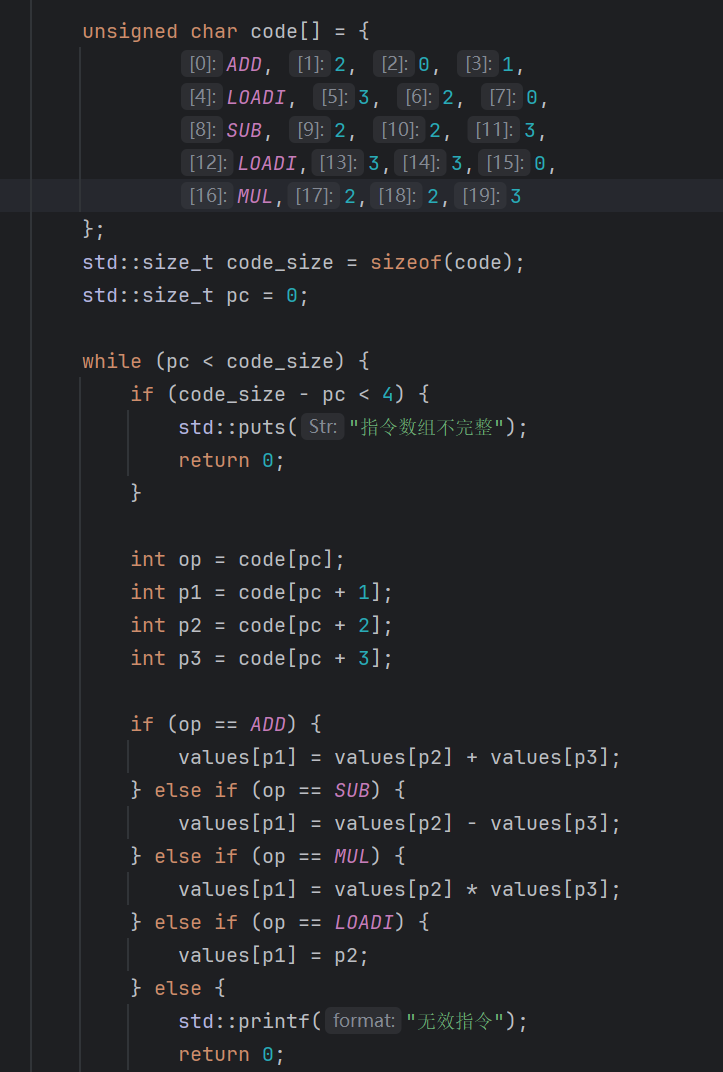
补齐乘法、除法操作码
结构跟加减法一样:
[操作码,结果,左边来源,右边来源]
这里规定 MUL 是 multiplication(乘法),DIV 是 division(除法):
enum Opcode : unsigned char {
    ADD   = 1,
    SUB   = 2,
    LOADI = 3,
    MUL   = 4,
    DIV   = 5
};
同样的,解释器也需要去做适配实现。先做乘法的实现,乘法的左侧是结果,右边是常量:
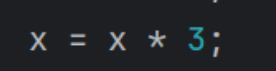
values[p1] = values[p2] * values[p3];
结果也没问题:

接下来是除法的实现。相较于乘法,除法在解释器的实现中需要判断除数是否为 0,其他都一样:
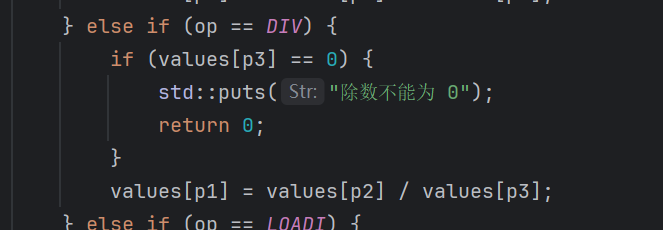
} else if (op == DIV) {
    if (values[p3] == 0) {
        std::puts("除数不能为 0");
        return 0;
    }
    values[p1] = values[p2] / values[p3];
}
到这里就实现了源程序的运算部分,只剩下一个 print_value(x); 没有处理了。
函数调用
经过前面的计算后,最终的运算结果保存在 values[2] 中。如果只想要把结果打印出来,可以直接写 print_value(values[2]);。这是一条完全正常的 C++ 函数调用,可以正常运行。那为什么还要新增指令?因为直接把它写在循环后面,就意味着无论指令数组里描述的是什么过程,执行器都会在最后固定打印位置 2 的值。
但是我们想要的是:计算过程需要打印的时候,就在指令数据里写明在这里打印,执行器读到它的时候才进行打印。比如以后可能需要"算一步、打印一次、再算一步、再打印一次"这种顺序,如果把打印固定写在循环外,就表达不了这种灵活性。所以要把什么时候打印、打印哪个位置的值交给指令数据控制。
打印函数只需要一个整数参数:
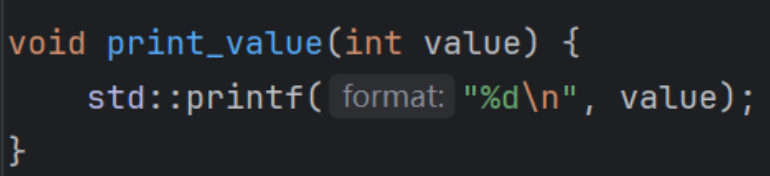
而当前使用的存储方式是 values[位置编号],因此只需要在指令里说明要把哪个位置保存的值交给打印函数。给这个操作起一个名称叫 PRINT:
enum Opcode : unsigned char {
    ADD   = 1,
    SUB   = 2,
    LOADI = 3,
    MUL   = 4,
    DIV   = 5,
    PRINT = 6
};
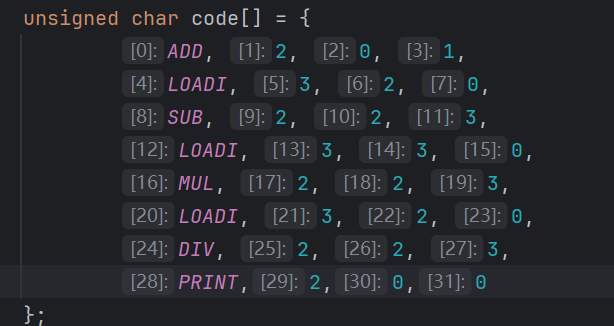
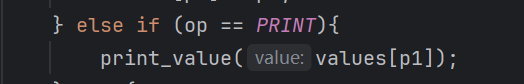
PRINT 专门表示调用指定的那个 print_value 函数。之前约定每条指令四个字节:[操作码, 参数1, 参数2, 参数3]。打印只需要一个位置编号,因此规定:
[PRINT, 来源位置, 未使用, 未使用]
例如 PRINT, 2, 0, 0 表示从位置 2 取出值交给 print_value,后面两个 0 依旧是填充作用。
RET 指令
当前运算完毕是通过 return values[2]; 固定写在这里,并没有交由指令控制:

这里的实现与前面的 PRINT 差不多,定义 [RET, 来源位置, 未使用, 未使用],然后再去解释器内实现:
} else if (op == RET) {
    return values[p1];
}
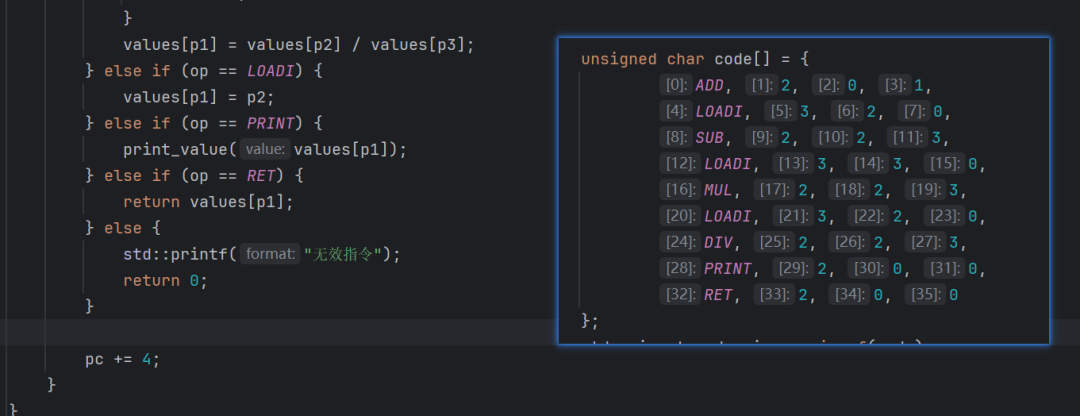
到这里原函数的行为已经全部能由指令描述。不过当前 target 里仍然混着两类东西:这个函数专属的指令数据,以及所有这些指令都可以共用的执行逻辑。
vm_execute
这里需要拆开:
target:
提供这次要执行的指令,以及输入参数。

vm_execute:
提供存储位置,读取指令,按照规则执行。
vm_execute 都需要什么参数?首先肯定是 code(指令),其次是指令的长度,最后是两个输入值 a 和 b。因此函数需要接受四项:
指令数据的位置
指令数据的长度
输入 a
输入 b
它执行结束后还需要将结果返回,因此返回类型还是 int。函数声明可以写成:
int vm_execute(
    const unsigned char* code,
    std::size_t code_size,
    int a,
    int b
);
调用方式:
vm_execute(code, sizeof(code), a, b);
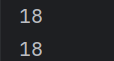
最终的实现就是这个样子的,运行后的结果依旧保持不变:
#include <cstdio>
#include <cstddef>

enum Opcode : unsigned char {
    ADD = 1,
    SUB = 2,
    LOADI = 3,
    MUL = 4,
    DIV = 5,
    PRINT = 6,
    RET = 7
};

void print_value(int value) {
    std::printf("%d\n", value);
}

int vm_execute(
    const unsigned char* code,
    std::size_t code_size,
    int a,
    int b
) {
    int values[4] = {};

    values[0] = a;
    values[1] = b;

    std::size_t pc = 0;

    while (pc < code_size) {
        if (code_size - pc < 4) {
            std::puts("指令数据不完整");
            return 0;
        }

        int op = code[pc];
        int p1 = code[pc + 1];
        int p2 = code[pc + 2];
        int p3 = code[pc + 3];

        if (op == ADD) {
            values[p1] = values[p2] + values[p3];
        } else if (op == SUB) {
            values[p1] = values[p2] - values[p3];
        } else if (op == LOADI) {
            values[p1] = p2;
        } else if (op == MUL) {
            values[p1] = values[p2] * values[p3];
        } else if (op == DIV) {
            if (values[p3] == 0) {
                std::puts("除数不能为 0");
                return 0;
            }
            values[p1] = values[p2] / values[p3];
        } else if (op == PRINT) {
            print_value(values[p1]);
        } else if (op == RET) {
            return values[p1];
        } else {
            std::puts("无法识别的操作码");
            return 0;
        }

        pc += 4;
    }

    std::puts("指令数据缺少 RET");
    return 0;
}

int target(int a, int b) {
    const unsigned char code[] = {
        ADD,   2, 0, 1,
        LOADI, 3, 2, 0,
        SUB,   2, 2, 3,
        LOADI, 3, 3, 0,
        MUL,   2, 2, 3,
        LOADI, 3, 2, 0,
        DIV,   2, 2, 3,
        PRINT, 2, 0, 0,
        RET,   2, 0, 0
    };

    return vm_execute(code, sizeof(code), a, b);
}

int main() {
    std::printf("%d\n", target(10, 4));
    return 0;
}
双重保护
原函数:
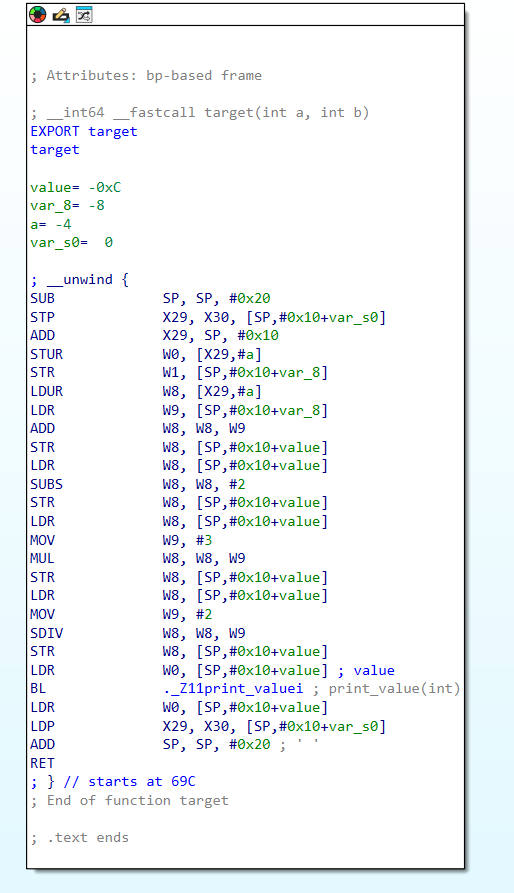
虚拟化后:
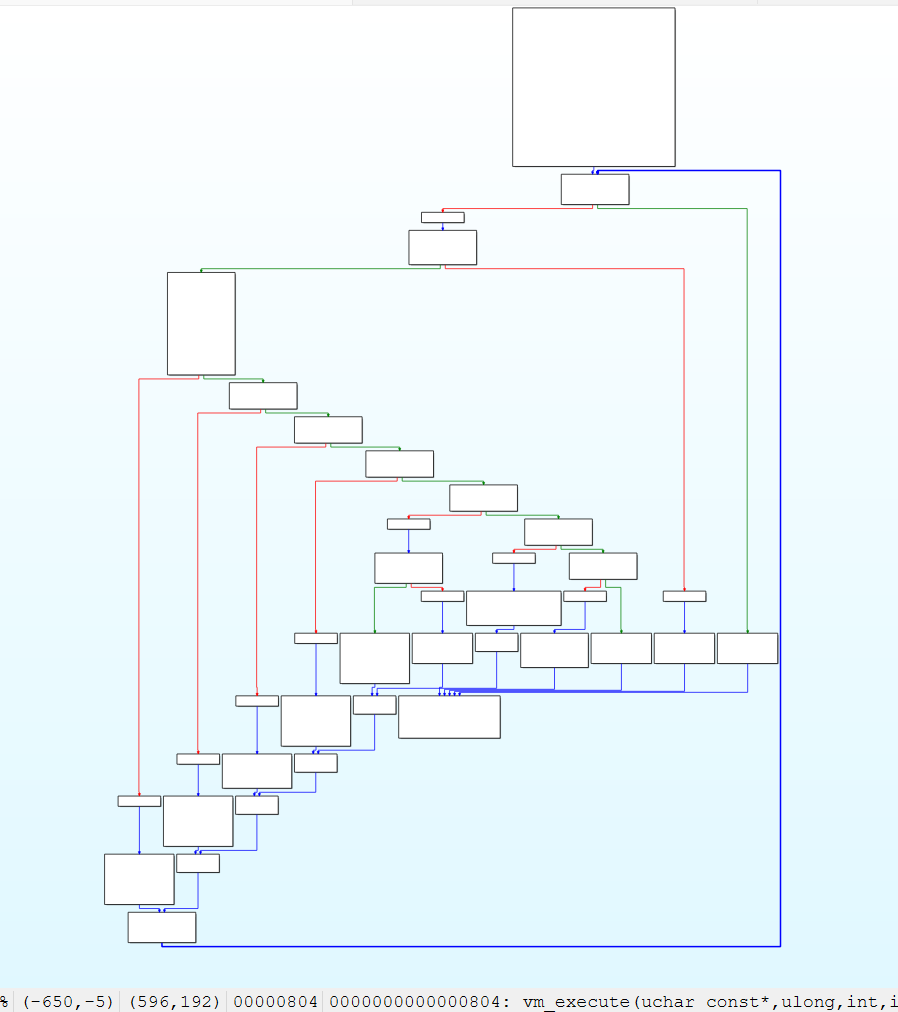
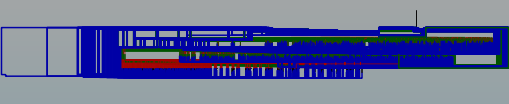
再配合上简单的 OLLVM,可以实现这个效果:

混淆拉满后长这样。不过这种程度大部分时候也遇不到,实际中常见的是上面那种:
至此我们就实现了一个 mini 版本的 VMP(Virtual Machine Protection,虚拟机保护),距离真正的商用版完成度可能不到百分之十。不过作为理解虚拟化保护原理的起点已经足够,更多逆向工程与代码虚拟化相关的实践内容,也欢迎在云栈社区与同好继续探讨。
 发表于 3 小时前
|
查看: 1|
回复: 0
 /1


