「Go 服务生产化实战」第 5 篇。上一篇写多租户数据隔离,这篇写后台任务和定时任务。
一个比较典型的生产场景是这样的:一张日报表,跑一次要 40 秒,接口直接算会超时,于是挪到后台队列里,前端先返回「正在生成」。上线第二天,运营说数字翻了一倍。
查下来代码没错,SQL 没错,任务也确实只提交了一次。错的是那个默认假设:「提交一次 = 执行一次」。
这类问题值得把后台任务这块重新梳理一遍。结论先说:worker pool 不是难点,那部分我在并发系列里已经讲过(errgroup + semaphore + 信号量限流)。真正难的是「执行了两次」和「执行到一半人没了」这两件事,而它们都不是队列能替你解决的。
一、先把「只执行一次」这个假设拆掉
队列的投递语义只有三种:最多一次、至少一次、恰好一次。
前两种实现简单,第三种在分布式里要付的代价极大(需要生产者和消费者共享事务状态,或者靠两阶段提交)。所以工程上的默认答案是至少一次(at-least-once)。
AWS SQS 官方文档里关于 visibility timeout 的那页写得很直白:
Standard queues – The visibility timeout in standard queues prevents multiple consumers from processing the same message at the same time. However, because of the at-least-once delivery model, Amazon SQS doesn't guarantee that a message won't be delivered more than once within the visibility timeout period.
翻译过来:可见性超时只能防止「同一个消费者同时处理」,防不了「同一条消息被处理第二次」。
Kafka 也一样。它的消费位点是 offset,不是逐条 ack。进程在处理完第 100 条之后、提交 offset 之前挂掉,重启后从第 100 条重新开始,那一条就执行了两遍。这是 offset 机制的必然结果,不是配置问题。
所以后台任务系统的正确目标不是「保证不重复」,而是:
重复执行是常态,让重复执行无害才是设计目标。
这就是「幂等」这个词在工程里的真实分量。它不是面试题,它是队列语义的直接推论。
二、最小 Demo:一个数据库任务队列
要复现这些问题,不需要 Kafka 和 Redis。一张表就够,因为绝大多数中小项目后台任务就是「数据库表 + 轮询」。
CREATE TABLE jobs (
  id           INTEGER PRIMARY KEY AUTOINCREMENT,
  kind         TEXT NOT NULL,
  payload      TEXT NOT NULL,
  status       TEXT NOT NULL,              -- pending / running / done / failed
  attempts     INTEGER NOT NULL DEFAULT 0,
  lease_until  INTEGER NOT NULL DEFAULT 0, -- 租约到期时间(unix 毫秒)
  worker       TEXT NOT NULL DEFAULT '',
  created_at   INTEGER NOT NULL,
  updated_at   INTEGER NOT NULL
);
CREATE INDEX idx_jobs_status_id ON jobs(status, id);
CREATE INDEX idx_jobs_lease     ON jobs(status, lease_until);
「领任务」这件事,很多人下意识写成两步:
-- 第一步:找一条待处理的
SELECT id FROM jobs WHERE status = 'pending' ORDER BY id LIMIT 1;
-- 第二步:干完活再标记
UPDATE jobs SET status = 'done' WHERE id = ?;
这两条语句之间,什么都没有挡。八个 worker 同时跑,八个都会 SELECT 到同一行。
正确的写法是把「挑出来」和「占住」压成一条语句,靠数据库对单行写的串行化来拿原子性:
UPDATE jobs
SET status = 'running', worker = ?, lease_until = ?, attempts = attempts + 1, updated_at = ?
WHERE id = (SELECT id FROM jobs WHERE status = 'pending' ORDER BY id LIMIT 1)
AND status = 'pending'
RETURNING id, attempts, payload;
RETURNING 是 SQLite 3.35+ 和 PostgreSQL 都支持的(MySQL 要靠 SELECT ... FOR UPDATE 或影响行数判断)。PostgreSQL 还有更贴近队列语义的写法:
SELECT id FROM jobs
WHERE status = 'pending'
ORDER BY id
LIMIT 1
FOR UPDATE SKIP LOCKED;
SKIP LOCKED 让被别的事务锁住的行直接跳过,多个消费者并行领任务不互相等锁。这是 PostgreSQL 9.5 之后把数据库当队列用的标准姿势。
把它包成一个 worker,大概长这样(这是本文所有实验的那份代码,go 1.27.0 下跑过;除了 math/rand/v2 需要 1.22+,其余 API 在 1.22 之后都能用):
package main

import (
    "context"
    "database/sql"
    "errors"
    "log/slog"
    "time"
)

type Job struct {
    ID       int64
    Attempts int
    Payload  string
}

type Worker struct {
    db     *sql.DB
    name   string
    lease  time.Duration // 租约,必须大于任务 p99 耗时
    poll   time.Duration
    handle func(context.Context, Job) error
}

// claim 把「挑一条」和「占住」压成一条语句,靠单行写的串行化拿原子性。
func (w *Worker) claim() (Job, bool, error) {
    now := time.Now()
    var j Job
    err := w.db.QueryRow(`
        UPDATE jobs
           SET status='running', worker=?, lease_until=?, attempts=attempts+1, updated_at=?
         WHERE id = (SELECT id FROM jobs WHERE status='pending' ORDER BY id LIMIT 1)
           AND status='pending'
        RETURNING id, attempts, payload`,
        w.name, now.Add(w.lease).UnixMilli(), now.UnixMilli(),
    ).Scan(&j.ID, &j.Attempts, &j.Payload)
    if errors.Is(err, sql.ErrNoRows) {
        return Job{}, false, nil // 队列空了
    }
    if err != nil {
        return Job{}, false, err
    }
    return j, true, nil
}

// Run 领一条跑一条;ctx 一取消就停止领新任务(在跑的还是要跑完)。
func (w *Worker) Run(ctx context.Context) {
    for ctx.Err() == nil {
        j, ok, err := w.claim()
        if err != nil {
            slog.Error("claim failed", "worker", w.name, "err", err)
            time.Sleep(w.poll)
            continue
        }
        if !ok {
            select {
            case <-ctx.Done():
                return
            case <-time.After(w.poll):
            }
            continue
        }
        w.exec(ctx, j)
    }
}

func (w *Worker) exec(ctx context.Context, j Job) {
    hbCtx, stop := context.WithCancel(ctx)
    defer stop()
    go w.heartbeat(hbCtx, j.ID) // 长任务靠它续命

    if err := w.handle(ctx, j); err != nil {
        w.release(j)
        return
    }
    w.finish(j)
}

// heartbeat 续租。租约的三分之一续一次,留出两次容错。
func (w *Worker) heartbeat(ctx context.Context, id int64) {
    t := time.NewTicker(w.lease / 3)
    defer t.Stop()
    for {
        select {
        case <-ctx.Done():
            return
        case <-t.C:
            w.db.Exec(`UPDATE jobs SET lease_until=?
                WHERE id=? AND status='running' AND worker=?`,
                time.Now().Add(w.lease).UnixMilli(), id, w.name)
        }
    }
}

// finish 带 fencing token:任务已被别人领走时,这次结果直接丢弃。
func (w *Worker) finish(j Job) {
    res, err := w.db.Exec(`UPDATE jobs SET status='done', updated_at=?
        WHERE id=? AND status='running' AND worker=?`,
        time.Now().UnixMilli(), j.ID, w.name)
    if err != nil {
        slog.Error("finish failed", "id", j.ID, "err", err)
        return
    }
    if n, _ := res.RowsAffected(); n == 0 {
        slog.Warn("lease lost before finish", "id", j.ID, "worker", w.name)
    }
}

func (w *Worker) release(j Job) {
    w.db.Exec(`UPDATE jobs SET status='pending', worker='', updated_at=?
        WHERE id=? AND worker=?`, time.Now().UnixMilli(), j.ID, w.name)
}
这 100 行里有三个地方是「不写就会出事」的:claim 的单条语句、heartbeat 的续租、finish 的 AND worker=?。后面几节逐个说明它们各自防的是什么。
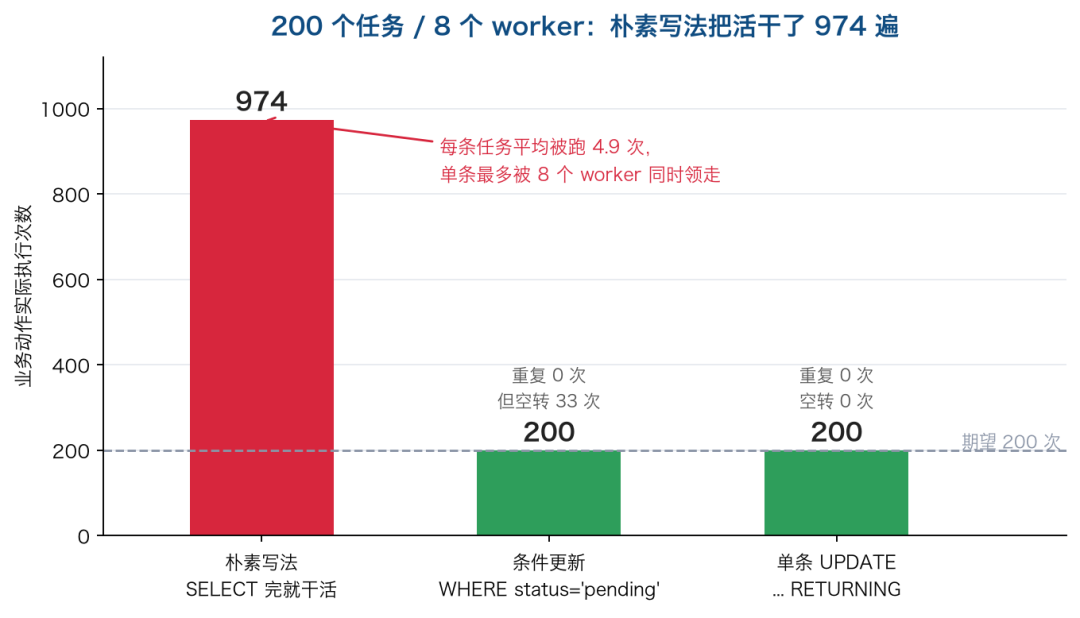
三、跑一下:200 个任务,活了 974 遍
我在本机搭了个实验:200 个任务、8 个 worker、每个任务干 2 毫秒的活,三种「领任务」写法各跑一遍,用一个内存计数器代表业务动作(现实中它就是「发一条通知」「扣一次款」「生成一份日报」)。
环境是 go 1.27.0(GOTOOLCHAIN=auto 自动拉的工具链,本机默认是 1.23.3),SQLite 3.53.4(modernc.org/sqlite 纯 Go 驱动,不需要 CGO)。
| 写法 |
业务执行次数 |
重复次数 |
单任务最多跑几次 |
抢空次数 |
SQL 条数 |
耗时 |
| 先 SELECT 再 UPDATE |
974 |
774 |
8 |
0 |
1956 |
504ms |
| 条件更新(WHERE status='pending') |
200 |
0 |
1 |
33 |
682 |
146ms |
| 单条 UPDATE ... RETURNING |
200 |
0 |
1 |
0 |
408 |
113ms |
200 个任务被执行了 974 次,平均每条跑 4.9 遍,单条最多被 8 个 worker 同时领走——8 就是 worker 总数,也就是说开头那一瞬间,所有 worker 都在干同一件事。
这个数字看起来夸张,但它精确地对应着一个真实的账务事故:如果这个任务是「按订单扣一次款」,这 200 单每一单都被至少扣了两次,其中绝大多数被扣了 4 遍以上。
条件更新那一栏有个细节值得看:重复 0 次,但抢空了 33 次。因为两个 worker 都 SELECT 到了 id=1,一个 UPDATE 成功,另一个 RowsAffected()=0,得回去重新领。这 33 次空转就是代价,占全部领取尝试的 14%。
第三条反而更快(113ms,SQL 条数还少 40%),因为它省掉了「SELECT 一次 + 落空重来一次」。原子性更好的写法通常也是更快的写法,这两件事在这里不冲突。
四、「失败」好处理,「卡住」才难
失败好办:error != nil,标记重试,加个 attempts。
难的是进程直接没了。kill -9、OOM、机器重启,都不会给你机会写「我失败了」这一行。任务就永远停在 running 上。
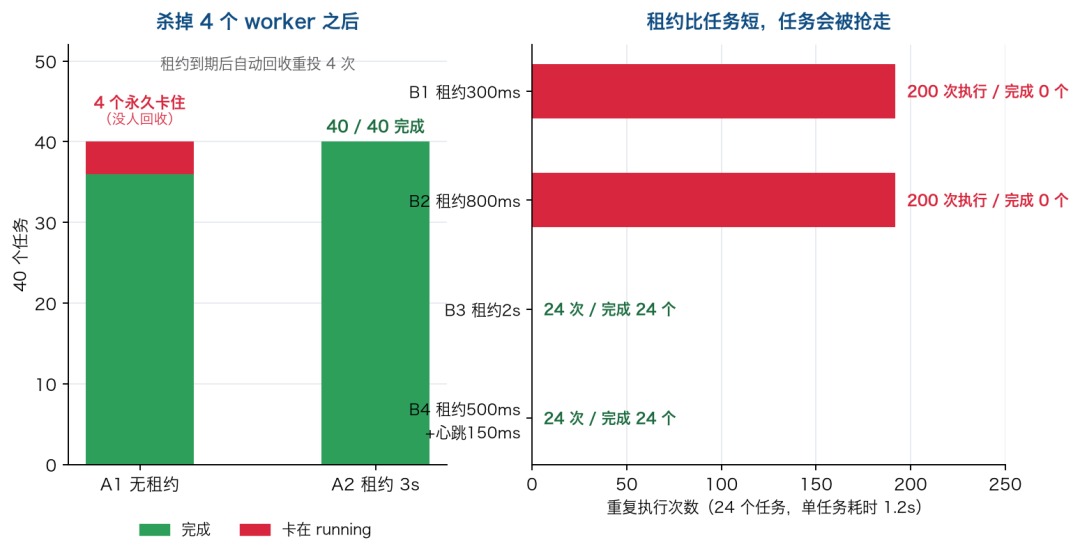
我做了两组实验。A 组:40 个任务、8 个 worker、单任务 150ms,在 200ms 时杀掉 4 个 worker(模拟 kill -9,手上的任务直接中断,什么收尾都不做)。
| 场景 |
任务数 |
执行次数 |
重复 |
完成 |
卡在 running |
耗时 |
| A1 无租约 |
40 |
36 |
0 |
36 |
4 |
6.03s(等超时) |
| A2 有租约 3s |
40 |
40 |
0 |
40 |
0 |
3.39s |
| B1 任务 1.2s / 租约 300ms |
24 |
200 |
192 |
0 |
24 |
30s(等超时) |
| B2 任务 1.2s / 租约 800ms |
24 |
200 |
192 |
0 |
24 |
30s(等超时) |
| B3 任务 1.2s / 租约 2s |
24 |
24 |
0 |
24 |
0 |
3.67s |
| B4 租约 500ms + 心跳 150ms |
24 |
24 |
0 |
24 |
0 |
3.67s |
A1 就是「没人管」的样子:4 个任务永远停在 running,谁也不知道它们该不该重跑。系统看上去一切正常,队列里没有积压,只是那 4 条数据永远不出现。
修法只有一个结构:租约(lease)+ 回收器(reaper)。
- 领任务的时候写一个
lease_until = now + 3s;
- 后台跑一个循环,把
status='running' AND lease_until < now 的任务放回 pending;
- 干完活提交结果时,必须带上
WHERE id=? AND worker=?,这样「已经被别人领走」的情况会被挡住(这叫 fencing token,防止旧的持有者把新持有者的结果覆盖掉)。
A2 就是加了租约之后:4 个任务在 3 秒后被回收重投,40 个全部完成,代价是那 4 个任务等了 3 秒。
第二组实验是我没想到的
B 组是「租约比任务耗时短」,我原本以为结果是「偶尔会重复一次」。实际跑出来是任务永远跑不完。
24 个任务、单任务 1.2 秒、8 个 worker、租约 300ms:30 秒内被领了 200 次,done 是 0。原因很简单:
- worker 领到任务,开始跑,需要 1.2 秒;
- 300ms 后租约到期,回收器把它放回 pending;
- 另一个空闲的 worker 立刻领走,再跑 1.2 秒;
- 第一个 worker 跑完回来写
WHERE worker='w0',发现任务已经不归它了,RowsAffected=0,白干。
循环往复,谁都没法提交结果。这不是「重复执行」,这是活锁。
租约 800ms 也是同样的结果(只要小于 1.2 秒),B3 的 2 秒就一切正常。所以租约时长不是随便填的:
租约必须大于任务的 p99 耗时。 如果任务耗时不可预测,就必须加心跳续租。
B4 就是心跳版:每 150ms 续一次租,租约还是 500ms(远小于 1.2 秒的任务耗时),结果是 0 重复、24 个全完成。心跳和 SQS 的 ChangeMessageVisibility 是同一个设计:
如果处理时间会超过初始超时,就用 ChangeMessageVisibility 延长。visibility timeout 的默认值是 30 秒,单条消息从首次接收算起最多可以延长到 12 小时。
这几个数字很有参考价值:SQS 默认只给你 30 秒,说明它默认你的任务是「短任务」;12 小时的上限说明「长任务靠心跳续命」是被官方承认的模式。
顺便提醒一个容易漏的细节:attempts 计数配合租约之后,一次「租约误判」也会消耗一次重试次数。如果你的 max_attempts 设成 3,同时又踩了租约过短,那 24 个任务会在几十秒内全部进死信队列——你会以为是任务本身有问题,其实是租约配错了。
五、幂等:5 次投递,余额少了 500
有了租约,任务不会卡死了,但「至少一次」的重复依然存在。这一节是整篇的重点。
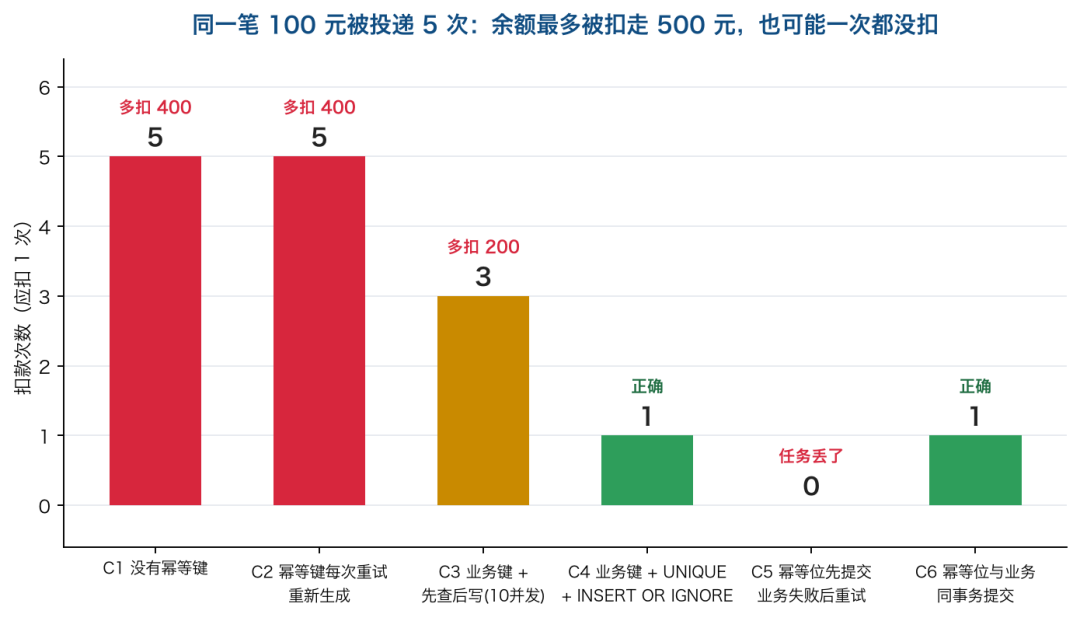
实验对象是一笔 100 元的扣款,被投递 5 次,账户初始余额 10000。六种写法:
| 写法 |
扣款次数 |
余额 |
幂等表行数 |
结果 |
| C1 没有幂等键 |
5 |
9500 |
0 |
多扣 400 |
| C2 幂等键每次重试都重新生成 |
5 |
9500 |
0 |
多扣 400 |
| C3 业务键 + 先查后写(10 并发) |
3 |
9700 |
0 |
多扣 200 |
| C4 业务键 + UNIQUE + INSERT OR IGNORE |
1 |
9900 |
1 |
正确 |
| C5 幂等位先提交,业务失败后重试 |
0 |
10000 |
1 |
任务丢了 |
| C6 幂等位与业务同事务提交 |
1 |
9900 |
1 |
正确 |
C1 不用解释。C2 值得说,因为它是最隐蔽的一种「假幂等」:
// 错:幂等键是「这次投递」的标识
key := uuid.New().String()
每次重试都生成新 uuid,幂等表里就是 5 条不同的记录,看起来「每次都成功插入」,实际上什么都没防住。这个坑通常在两个地方出现:重试逻辑写在生产方(每次重投生成新消息 ID),或者中间件把 message ID 重新生成了。
幂等键必须来自业务事实:订单号 + 动作 + 业务时间窗口,而不是这次投递的身份。
C3 是另一个高频错误:先查后写。10 个并发进来,有 3 个查的时候都没查到,然后都插入了。查和写之间没有原子性,这个窗口在本地可能是微秒级,在生产里被 GC 停顿、网络抖动一放大就是灾难。
C4 是正确姿势的核心:把「只允许一次」这件事交给数据库的唯一约束,而不是交给你的 if 判断。INSERT OR IGNORE(PostgreSQL 是 ON CONFLICT DO NOTHING)的 RowsAffected 就是天然的互斥信号:
res, err := tx.ExecContext(ctx,
    `INSERT OR IGNORE INTO idem(idem_key, status) VALUES(?, 'pending')`, key)
if err != nil {
    return err
}
if n, _ := res.RowsAffected(); n == 0 {
    return nil // 这件事已经有人办过(或正在办),跳过业务动作
}
C5 才是真正可怕的那个
C5 我先提交幂等占位行,再调用下游扣款,下游超时失败。重试的时候 RowsAffected=0,代码认为「已经处理过」,直接跳过。
结果:扣款 0 次,幂等表 1 行,队列显示任务「成功」。任务彻底丢了,而且所有监控都是绿的。
这是幂等设计里最容易翻车的地方——幂等占位和业务动作必须原子。C6 就是修好的版本:
func (w *Worker) handlePayment(ctx context.Context, j Job) error {
    tx, err := w.db.BeginTx(ctx, nil)
    if err != nil {
        return err
    }
    defer tx.Rollback() // 没走到 Commit 就自动回滚

    // 幂等键来自业务事实,不是这次投递的 uuid
    key := j.Payload // 例如 "order-1001:pay"

    res, err := tx.ExecContext(ctx,
        `INSERT OR IGNORE INTO idem(idem_key, status) VALUES(?, 'pending')`, key)
    if err != nil {
        return err
    }
    if n, _ := res.RowsAffected(); n == 0 {
        return tx.Commit() // 已处理过,直接结束
    }

    if err := charge(ctx, tx, key); err != nil {
        return err // 回滚:幂等位跟着一起回滚,下次还能重来
    }
    if _, err := tx.ExecContext(ctx,
        `UPDATE idem SET status='done' WHERE idem_key=?`, key); err != nil {
        return err
    }
    return tx.Commit()
}
charge 就是你的业务写入(实验里它是「扣余额 + 记流水」两条 SQL),关键是它必须接收 tx,不能在内部自己开事务——自己开事务就跑到幂等事务之外去了,C5 那个坑会重新出现。
这里有个现实约束要说清楚:只有当幂等表和业务数据在同一个库、同一个事务里,这个方案才成立。 如果扣款是调外部支付网关,事务包不住外部调用,那就只能退化成「状态机 + 补偿」:幂等行先记 pending,调用成功记 done,超时就靠对账去查真实结果。这时候幂等行不是「防重复」的锁,而是「待核对」的工单。
同理,如果业务动作是发消息、发邮件这种不可回滚的副作用,也只能靠「幂等键传给下游,让下游去重」。幂等这件事,最终要么落在数据库约束上,要么落在下游的去重表上,没有第三种可能。
六、定时任务:3 个副本就是 3 倍的量
后台任务是「有活儿就干」,定时任务是「到点就干」。多副本部署下,它的问题更直接。
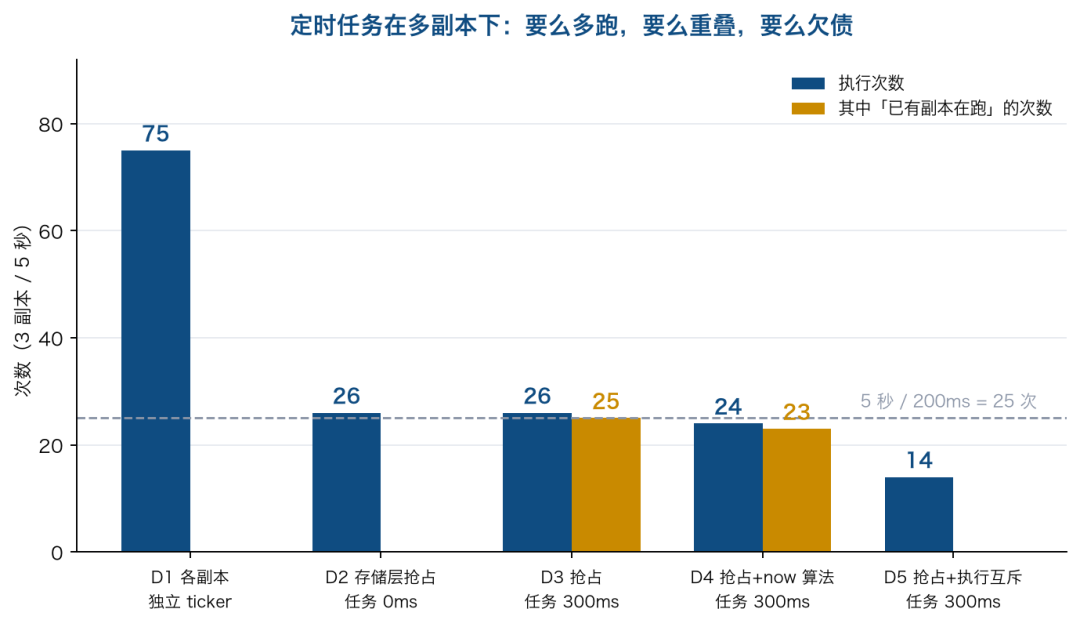
实验:3 个副本共享一张调度表,任务间隔 200ms,跑 5 秒,理论应该执行 25 次。
| 场景 |
执行次数 |
每副本分布 |
其中「已有副本在跑」 |
结束时积压 |
| D1 各副本独立 ticker |
75 |
[25 25 25] |
0 |
— |
| D2 存储层抢占,任务 0ms |
26 |
[5 8 13] |
0 |
0 |
| D3 抢占,任务 300ms > 间隔 |
26 |
[11 7 8] |
25 |
106ms |
| D4 抢占 + next 从 now 算 |
24 |
[8 6 10] |
23 |
102ms |
| D5 抢占 + 执行互斥 |
14 |
[2 4 8] |
0 |
2203ms |
D1 是最常见的写法,每个副本里各写一个 time.Ticker:
// 错:三个副本 = 三倍的量
go func() {
    t := time.NewTicker(200 * time.Millisecond)
    for range t.C {
        runDailyReport()
    }
}()
75 次,正好三倍。这个 bug 的可怕之处在于它不会报错。日报只是数字变大,对账只是重复推送,缓存只是多刷新几次。等你发现的时候,可能已经跑了一个月。
修法是把「到点了没有」的判断放进存储层,用一条 UPDATE 抢:
UPDATE cron_tasks
SET next_run_at = next_run_at + interval_ms,
    running_until = ?,
    runs = runs + 1,
    last_run_by = ?
WHERE name = ?
AND next_run_at <= ? -- 到点了
AND running_until <= ? -- 并且没人在跑
RowsAffected = 1 的那个副本负责执行。D2 就回到了 26 次,接近理论值。
但抢占只解决了一半问题
看 D3 那一栏:执行次数 26,看着很正常。可我同时统计了「领到任务时已经有副本在跑」的次数——26 次执行里有 25 次是重叠的。
原因:抢占保证的是「这一次触发只有一个副本拿到」,它管不了「上一次触发还没跑完」。任务耗时 300ms 大于间隔 200ms 时,第 2 次触发会在第 1 次还没结束时开始,两个副本同时跑同一个定时任务。
这在很多场景下是致命的:日历调度任务算重复了、库存快照互相覆盖、导出文件互相踩。
D5 加了 running_until 这一条,重叠降到 0,但代价是 5 秒只跑了 14 次,结束时积压 2203ms——欠了 11 次没跑。任务耗时本来就超过间隔,物理上跑不了 25 次,你只能在两种坏结果里挑一个:
- 允许重叠:任务都执行了,但可能同时有两个在跑(需要任务本身能并发安全);
- 禁止重叠:不重叠,但触发会丢失或推迟(需要业务能接受「跳过」或「补跑」)。
这就是定时任务规模化的真正难点。工程上的解法不是调参数,而是改结构:
- 把长定时任务改成「定时入队 + 队列消费」:定时器只负责每 200ms 往队列里塞一条任务,执行交给后台 worker,重叠问题就变成了 worker 的并发度问题(可以精确控制,还能观测积压);
- 按业务实体分片:每个租户一个 key,
name = 'daily-report:' + tenant,不同租户互不阻塞,同一个租户严格串行。
第二种写法在前面几篇那个多租户订单服务骨架上就是默认做法——每个租户一个调度 key,因为租户之间本来就没有执行顺序关系。
七、重试:指数退避解决次数,jitter 解决同时
重试策略经常被简化成一句「加重试就完了」。我让 1000 个任务同时失败,最多重试 4 次,看它们打在下游身上的形状。
| 策略 |
总尝试 |
重试单秒峰值 |
100ms 内峰值 |
有重试的秒数 |
最后一波 |
| F1 固定 1s |
4000 |
1000 |
1000 |
3 |
第 3 秒 |
| F2 指数 1s/2s/4s,无抖动 |
4000 |
1000 |
1000 |
3 |
第 7 秒 |
| F3 指数 + full jitter |
4000 |
615 |
81 |
6 |
第 6.5 秒 |
F1 和 F2 的「100ms 内峰值」都是 1000:不管间隔是固定的 1 秒还是指数递增,同一批任务永远同一步调,到点就一起回来。下游原本只是短暂抖动,被这 1000 个并发重试直接打死。
F3 用 full jitter(delay = rand(0, base)),100ms 内的峰值从 1000 降到 81,降了 12 倍。
// 指数 + full jitter,Go 1.22 起用 math/rand/v2
base := time.Second << (attempt - 1)
delay := time.Duration(rand.Int64N(int64(base)))
所以我更倾向于这个判断:指数退避解决的是「重试次数」,jitter 解决的是「重试同时性」。只做前者,等于把 1000 并发从每秒一次摊成每 2 秒一次,仍然是 1000 并发。
退避还有两个配套约束,容易漏:
- 要有上限:
base 翻倍很快,第 10 次就是 512 秒,用户等不起。通常封顶 30 秒到 5 分钟。
- 要有总时限:退避到超过业务的 SLA 就该进死信队列,而不是无限重试。凌晨三点的任务重试到早上八点,业务意义已经没了。
八、优雅退出:多等 45 毫秒,省 8 次重跑
有了租约,进程退出其实也能「自愈」——租约到期,任务被回收重投。但那 8 个正在跑的任务等于白干,而且它们的副作用可能已经发生了一半(比如已经调了下游接口,只是还没写回结果)。
200 个任务、8 个 worker、单任务 50ms,在 150ms 时收到 SIGTERM:
| 退出方式 |
完成次数 |
被掐断 |
需重跑 |
退出耗时 |
| V1 直接 cancel ctx |
16 |
8 |
8 |
0ms |
| V2 停领新任务 + 等手上做完 |
24 |
0 |
0 |
45ms |
| V3 等了,只等 40ms |
23 |
0 |
1 |
42ms |
多花 45 毫秒,多完成 8 个任务,少 8 次重跑。这个买卖在任何系统里都划算。
这里有个很多人会踩的点:context 取消不等于任务取消。V1 之所以只完成 16 个,是因为我把 ctx 直接传给了业务,ctx 一取消业务就返回。现实中大部分业务代码根本不理 ctx(一个 db.Exec 内部循环、一次 time.Sleep 的重试),取消信号传进去也不起作用,进程照旧被 kill。
所以退出的正确顺序是三步,缺一不可:
// 1. 停止领新任务(先关闸,别让新活儿进来)
close(stopClaim)

// 2. 等手上这些做完,但要有上限
done := make(chan struct{})
go func() { wg.Wait(); close(done) }()
select {
case <-done:
case <-time.After(10 * time.Second): // 超过上限就走第 3 步
}

// 3. 兜底取消,交给租约回收
cancel()
第 2 步的上限值要和租约时长对齐:等待上限必须小于租约时长,否则你还在等,任务已经被别人重跑了。
九、轮询间隔:省下的 QPS 和时间换来的延迟
数据库当队列,绕不开一个问题:多久问一次。
| 轮询间隔 |
延迟 p50 |
延迟 p99 |
空闲时查询/秒 |
3 副本合计 |
| 10ms |
5.5ms |
12.4ms |
99 |
300 |
| 50ms |
16.4ms |
47.8ms |
20 |
60 |
| 200ms |
134.6ms |
193.5ms |
5 |
15 |
| 500ms |
310.9ms |
495.7ms |
2 |
6 |
| 1s |
510ms |
941.1ms |
1 |
3 |
延迟基本就是间隔的一半到一倍,这是数学决定的,没有优化空间。真正要算的是另一头:空转的查询成本。
10ms 轮询、3 副本,就是 300 次/秒的空 SELECT。这个量对 SQLite 无所谓,对线上 MySQL 可能就是一条不该有的慢查询来源,尤其是当它和业务查询抢同一个连接池时。
我倾向于 200ms 到 500ms:延迟 0.2 到 0.5 秒对「后台任务」这个定位完全可接受(用户已经在等「正在生成」了),空转成本降到 3 到 15 QPS。
顺便量了一下单条 claim 的成本:
BenchmarkClaimAtomic-10    29219 ns/op    735 B/op    22 allocs/op
BenchmarkChanRecv-10       2.658 ns/op      0 B/op     0 allocs/op
一次数据库领取(含 WAL 提交)29.2 微秒、22 次分配,比从内存 channel 收一条贵 1 万倍。这个量级差说明:数据库队列适合「每秒几十到几百个任务」,不适合「每秒十万条消息」。超过这个量级就该上 Redis 或 Kafka,而不是继续在数据库里加索引。
批量领取是个常见优化,但我实测下来没有想象中美好:处理 200 个任务,一次领 1 条是 408 条 SQL / 157ms,一次领 20 条是 218 条 SQL / 168ms。
| 每次领取 |
SQL 条数 |
耗时(3 次运行) |
| 1 条 |
408 |
233ms / 157ms / 181ms |
| 20 条 |
218 |
142ms / 168ms / 206ms |
SQL 条数少了 47%,耗时没有稳定收益。原因很简单:本地 SQLite 的往返几乎免费,而 2ms 的业务耗时才是大头。「减少 SQL 条数」不是性能结论,得看每次往返值多少钱——如果每次往返是跨机房的 0.5ms,少 190 次往返就是 95ms,这时候批量才有意义。
十、上生产前的检查清单
我把上面这些整理成一张表,自查的时候一条条对:
| 检查项 |
不合格的后果 |
怎么改 |
| 领任务是不是两条语句 |
重复执行,量级可达 N 倍 |
单条 UPDATE ... RETURNING 或 SKIP LOCKED |
| 有没有租约(lease) |
进程被 kill 后任务永久卡住 |
加 lease_until + 回收器 |
| 租约是否大于任务 p99 |
任务被抢走,活锁,永远跑不完 |
按 p99 设,或加心跳续租 |
| 提交结果有没有 fencing |
旧持有者覆盖新结果 |
WHERE id=? AND worker=? |
| 有没有幂等键 |
重复扣款、重复通知 |
业务事实生成 key,不是 uuid |
| 幂等靠约束还是靠 if |
并发下依然重复 |
UNIQUE + INSERT OR IGNORE |
| 幂等位和业务是否同事务 |
任务静默丢失 |
同库同事务,或改状态机 + 对账 |
| 重试有没有退避和 jitter |
打挂下游 |
指数退避 + full jitter + 上限 |
| 有没有 attempts 上限和死信 |
毒任务无限重试 |
超过 N 次进死信表,报警 |
| 定时任务有没有抢占 |
N 个副本跑 N 倍 |
存储层原子抢占 |
| 定时任务会不会重叠 |
同一任务并发执行 |
running_until 或改「定时入队」 |
| 退出有没有等 in-flight |
每次发布丢一批任务 |
停闸 → 等(<租约)→ 取消 |
| 有没有积压监控 |
队列堵了没人知道 |
pending 数量和最老任务年龄 |
最后一条特别重要:队列的唯一健康指标是「最老 pending 任务的年龄」,不是 pending 数量。数量 1000 但都是刚进来的,很正常;数量 10 但最老的一条等了 2 小时,说明有任务卡死了。
十一、我的三个判断
写完这些实验,我把原来的认知改了三处。
第一,后台任务的复杂度不在并发,在状态机。
worker pool 那部分(限制并发数、errgroup 收错误、semaphore 控速)确实容易写,但那只占整个系统的两成代码。剩下八成是状态流转:pending 多久算超时、running 什么时候该回收、failed 重试几次、什么情况进死信、幂等位和业务结果怎么保持一致。这些才是线上事故的来源。
第二,租约是一个必须显式做的取舍,不是配置项。
它一头是「双跑风险」,一头是「故障恢复时延」。租约 3 秒,进程挂了任务 3 秒后才有人接手;租约 30 秒,就是要停 30 秒才能恢复。设成小于任务耗时会直接活锁。所以我现在的习惯是写死在配置里并且加注释说明依据,而不是留一个「看着调」的默认值。
第三,定时任务应该尽量退化成后台任务。
这一条可能有点反直觉。定时任务的价值是「周期性产生任务」,它的执行部分其实不需要和「到点」绑在一起。一旦拆成「定时器只负责入队」,重叠、并发、限流、重试、可观测性这五个问题全都变成后台任务的问题,而那一套我已经有了。剩给定时器的事情只有一件:准点。准点这件事,用一条 UPDATE ... WHERE next_run_at <= now 就够了。
总结
三句话:
- 队列只保证「至少一次」,所以幂等不是可选项,是设计的起点。幂等键要来自业务事实,靠数据库唯一约束去判,别靠 if。
- 比「失败」更常见的是「卡住」。租约 + 回收器 + fencing token 是唯一能自愈的结构,而租约时长必须在「双跑」和「恢复时延」之间显式选一个。
- 定时任务的第一个坑不是 cron 表达式,是多副本。进程内 ticker 乘以副本数,而它不会报错。
代码都能跑,实验都在本机实测(go 1.27.0 + SQLite 3.53.4,Apple M4 / 10 核)。绝对耗时不要直接搬到你的 MySQL 上——SQLite 的写延迟比跨网络的 MySQL 低一个量级,但重复次数、活锁、幂等这些结构性结论和你用什么数据库无关。
你的后台任务现在是「数据库表 + 轮询」还是「独立消息队列(Redis / Kafka / RabbitMQ)」?
下一篇是「Go 服务生产化实战」第 6 篇:对外 Webhook 推送。签名怎么算(不是 HMAC 一盖就完事)、重试怎么不把客户打挂、去重靠什么、对方没响应怎么观测。这块比后台任务更极端,因为你在打别人的服务器,对方挂了你也得扛。
 发表于 3 小时前
|
查看: 2|
回复: 0
 /1


