假设你需要测试应用在低带宽条件下的表现。你创建了一对 veth 接口来模拟网络链路,希望把出口速率限制在 64 Kbit/s,同时观察队列满载时的丢包行为。传统的 tc 配置或用户态代理虽然可行,但对于快速验证来说显得有些笨重。
Linux 6.16 带来了一种新选择:BPF qdisc。你不再需要去配置现有的调度器,而是可以直接用 eBPF 实现一个完整的排队规则。本教程构建一个 FIFO 限速器,演示 qdisc 的完整生命周期:注册为 root qdisc、在入队和出队过程中管理报文所有权、计算发送时间、使用 watchdog 定时器调度下次出队、以及在移除时清理资源。
本示例适用于 veth、TAP 或 IFB 这类受控接口,你拥有完全控制权,可以安心进行报文调度实验。
完整源码:https://github.com/eunomia-bpf/bpf-developer-tutorial/tree/main/src/53-egress-pacer
为什么需要 BPF Qdisc
要理解 BPF qdisc 改变了什么,不妨先和三种常见做法做个对照。
内置调度器是固定算法。 tc 提供了 TBF(令牌桶过滤器)、HTB(分层令牌桶)等多种选项,但这些都是内核中预定义的行为。如果你需要自定义的调度策略——比如按应用程序类型区分优先级,或者根据实时指标动态调整速率——就必须修改内核代码,或者串联多个 tc 分类器。
TC BPF 程序无法控制发送时机。 普通的 TC BPF 程序可以检查报文并决定放行或丢弃,但底层的 qdisc 仍然控制着报文的实际发送时间。第 20 课展示的正是这种模式:BPF 决定放行还是丢弃,却无法做到"在时刻 T 发送这个报文"。
用户态方案会引入额外开销。 tc-netem 配合外部工具或 DPDK 可以实现流量整形,但会带来上下文切换和部署复杂度。在测试场景中,你往往需要更轻量级的方案。
BPF qdisc 恰好解决了这些问题。从 Linux 6.16 开始,你可以用 eBPF 实现 Qdisc_ops 的回调函数(enqueue、dequeue、init、reset、destroy),并将其注册为一种 qdisc 类型。你的 BPF 程序可以完全控制报文的排队和发送时序,同时保持在内核态运行。本教程的 egress_pacer 就是用这种方式构建的 FIFO 限速器。
BPF Qdisc 的工作原理
与在现有 qdisc 内部运行的普通 TC BPF 程序不同,BPF qdisc 本身就是 qdisc。当你把它挂载到接口的 root 位置后,你的 BPF 代码会处理每一个出口报文。
整个生命周期如下:
- 初始化:用户态程序设置速率和队列上限,加载 BPF 程序,注册
struct_ops 实现,然后把它挂载到目标接口的 TC_H_ROOT 位置。
- 入队:当内核需要将报文排队发送时,它调用你的
enqueue 回调。你接收到一个 skb,创建一个节点来保存它,根据报文长度和速率计算发送时间,然后把节点加入队列。如果队列已满或分配失败,则丢弃报文。
- 出队:当内核想要发送报文时,它调用你的
dequeue 回调。你检查队首报文的发送时间是否已到。如果是,返回 skb;如果否,为正确的时间安排一个 watchdog 定时器并返回 NULL。定时器触发后,内核会再次调用 dequeue。
- 重置:当 qdisc 被移除时,内核调用
reset。你需要遍历所有剩余的报文,释放它们占用的资源,并将计数器清零。
在整个生命周期中,你的 BPF 程序拥有报文的所有权。从 enqueue 接收 skb,到在你的数据结构中持有它,再到在 dequeue 中返回它或在 reset 中释放它,BPF 程序始终是责任方。
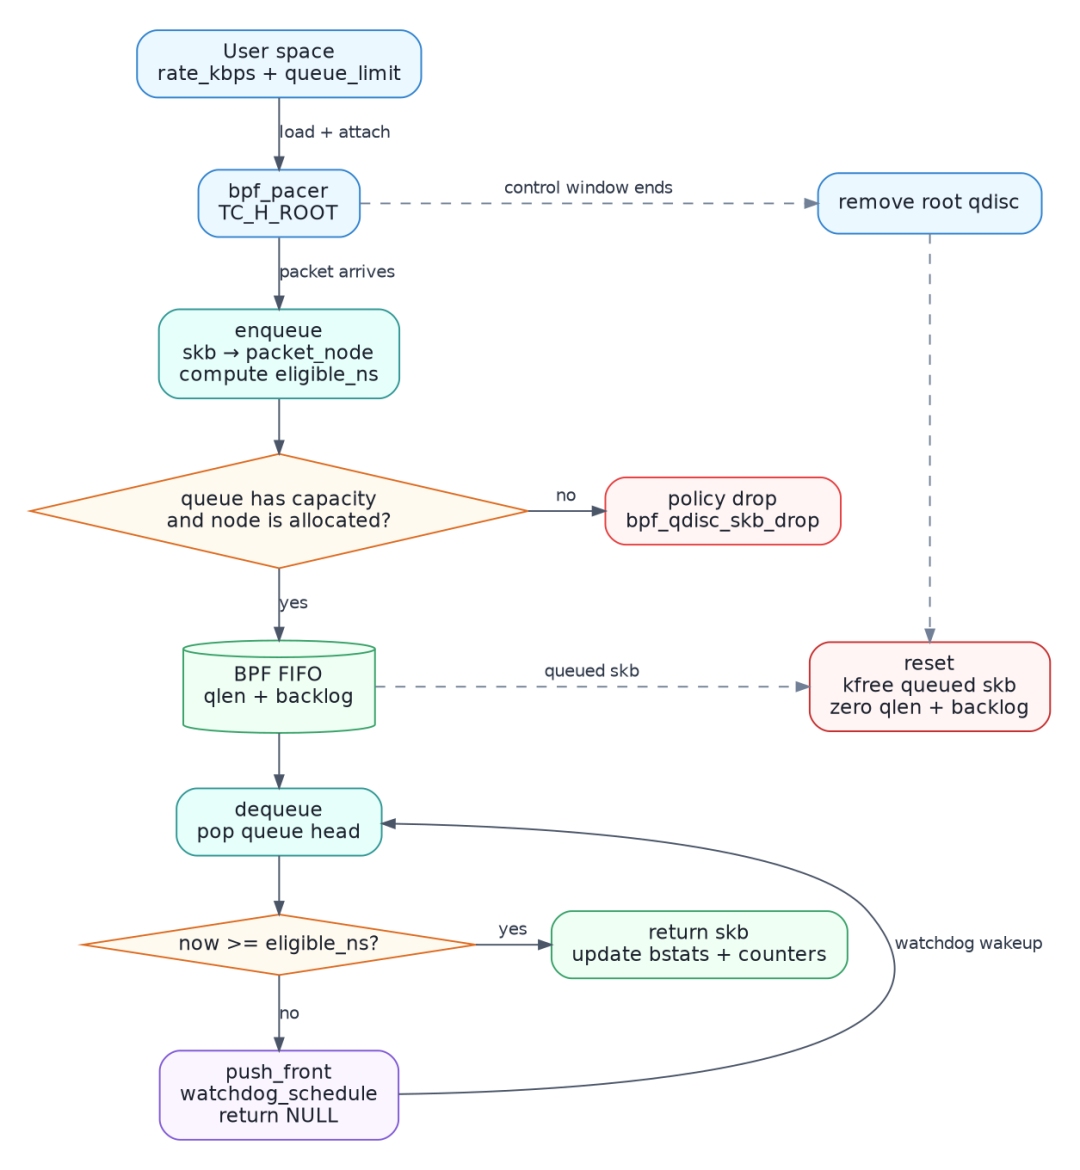
图中实线描绘了报文的正常路径:配置和挂载,然后入队进入 FIFO,再出队到发送路径。当队列已满或分配失败时,报文走 policy-drop 分支。如果在报文发送时间到来之前调用了 dequeue,节点会被推回队首,安排 watchdog,然后返回 NULL;watchdog 随后会重新进入 dequeue。虚线表示生命周期路径:移除 qdisc 会触发 reset,释放队列中的报文并清零 qlen 和 backlog。
代码实现
本实现由四个文件组成:定义统计结构的共享头文件、提供 BPF graph-object 声明的兼容头文件、实现 qdisc 回调的 BPF 程序,以及管理生命周期的用户态加载器。
共享头文件
egress_pacer.h 定义了 BPF 和用户态之间共享的统计结构。这六个计数器把每个报文的最终结果分门别类:
/* SPDX-License-Identifier: (LGPL-2.1 OR BSD-2-Clause) */
#ifndef __EGRESS_PACER_H
#define __EGRESS_PACER_H

struct pacer_stats {
    unsigned long long enqueued;
    unsigned long long dequeued;
    unsigned long long policy_dropped;
    unsigned long long cleanup_dropped;
    unsigned long long bytes_dequeued;
    unsigned long long max_qlen;
};

#endif /* __EGRESS_PACER_H */
enqueued / dequeued:成功进入和离开 FIFO 的报文数。policy_dropped:在入队阶段因队列已满或分配失败而丢弃的报文数。cleanup_dropped:reset 运行时仍在队列中的报文数。这些报文已入队但从未发送。bytes_dequeued:实际发送的总字节数。max_qlen:观察到的队列深度峰值。
兼容头文件
BPF qdisc 使用 "graph-object" kfunc,即用于管理 BPF 所持有的链表和对象的内核函数。这个本地头文件提供了必要的声明:
/* SPDX-License-Identifier: GPL-2.0 */
#ifndef __EGRESS_PACER_BPF_EXPERIMENTAL_H
#define __EGRESS_PACER_BPF_EXPERIMENTAL_H

#include <bpf/bpf_core_read.h>

#define __contains(name, node) \
    __attribute__((btf_decl_tag("contains:" #name ":" #node)))

extern void *bpf_obj_new_impl(__u64 local_type_id, void *meta) __ksym;
#define bpf_obj_new(type) \
    ((type *)bpf_obj_new_impl(bpf_core_type_id_local(type), NULL))

extern void bpf_obj_drop_impl(void *kptr, void *meta) __ksym;
#define bpf_obj_drop(kptr) bpf_obj_drop_impl(kptr, NULL)

extern int bpf_list_push_front_impl(struct bpf_list_head *head,
        struct bpf_list_node *node,
        void *meta, __u64 off) __ksym;
#define bpf_list_push_front(head, node) \
    bpf_list_push_front_impl(head, node, NULL, 0)

extern int bpf_list_push_back_impl(struct bpf_list_head *head,
       struct bpf_list_node *node,
       void *meta, __u64 off) __ksym;
#define bpf_list_push_back(head, node) \
    bpf_list_push_back_impl(head, node, NULL, 0)

extern struct bpf_list_node *bpf_list_pop_front(struct bpf_list_head *head) __ksym;

#endif /* __EGRESS_PACER_BPF_EXPERIMENTAL_H */
这些辅助函数让 BPF 代码可以安全地管理内核对象:
bpf_obj_new 分配给定类型的新对象。bpf_obj_drop 释放对象。bpf_list_push_back / bpf_list_push_front / bpf_list_pop_front 实现双向链表操作。__contains 宏生成 BTF 标签,告诉验证器 list head 包含的是哪种节点类型,从而实现安全的所有权追踪。
BPF 程序
egress_pacer.bpf.c 实现了 qdisc。SEC(".struct_ops") 声明将其注册为 Qdisc_ops 实现:
// SPDX-License-Identifier: GPL-2.0
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_tracing.h>
#include "bpf_experimental.h"
#include "egress_pacer.h"

const volatile __u64 rate_kbps = 1024;
const volatile __u32 queue_limit = 256;

struct packet_node {
    __u64 eligible_ns;
    __u32 packet_len;
    struct sk_buff __kptr *skb;
    struct bpf_list_node node;
};

private(A) struct bpf_spin_lock queue_lock;
private(A) struct bpf_list_head packet_queue __contains(packet_node, node);
private(A) __u64 next_departure_ns;

SEC("struct_ops/egress_pacer_enqueue")
int BPF_PROG(egress_pacer_enqueue, struct sk_buff *skb, struct Qdisc *sch,
      struct bpf_sk_buff_ptr *to_free)
{
    struct packet_node *packet;
    __u64 eligible_ns, interval_ns, now;
    __u32 packet_len = qdisc_packet_len(skb);

    if (sch->q.qlen >= sch->limit)
        goto drop;
    packet = bpf_obj_new(typeof(*packet));
    if (!packet)
        goto drop;

    now = bpf_ktime_get_ns();
    interval_ns = (__u64)packet_len * 8 * 1000000ULL / rate_kbps;
    packet->packet_len = packet_len;
    skb = bpf_kptr_xchg(&packet->skb, skb);

    bpf_spin_lock(&queue_lock);
    eligible_ns = next_departure_ns > now ? next_departure_ns : now;
    next_departure_ns = eligible_ns + interval_ns;
    packet->eligible_ns = eligible_ns;
    bpf_list_push_back(&packet_queue, &packet->node);
    sch->q.qlen++;
    sch->qstats.backlog += packet_len;
    bpf_spin_unlock(&queue_lock);
    return NET_XMIT_SUCCESS;

drop:
    bpf_qdisc_skb_drop(skb, to_free);
    return NET_XMIT_DROP;
}

SEC("struct_ops/egress_pacer_dequeue")
struct sk_buff *BPF_PROG(egress_pacer_dequeue, struct Qdisc *sch)
{
    struct bpf_list_node *node;
    struct packet_node *packet;
    struct sk_buff *skb = NULL;
    __u64 now = bpf_ktime_get_ns();

    bpf_spin_lock(&queue_lock);
    node = bpf_list_pop_front(&packet_queue);
    bpf_spin_unlock(&queue_lock);
    if (!node)
        return NULL;

    packet = container_of(node, struct packet_node, node);
    if (now < packet->eligible_ns) {
        bpf_spin_lock(&queue_lock);
        bpf_list_push_front(&packet_queue, &packet->node);
        bpf_spin_unlock(&queue_lock);
        bpf_qdisc_watchdog_schedule(sch, packet->eligible_ns, 0);
        return NULL;
    }

    skb = bpf_kptr_xchg(&packet->skb, skb);
    sch->q.qlen--;
    sch->qstats.backlog -= packet->packet_len;
    bpf_obj_drop(packet);
    return skb;
}

/* reset drains packet_queue and frees every remaining skb. */
SEC(".struct_ops")
struct Qdisc_ops pacer = {
    .enqueue = (void *)egress_pacer_enqueue,
    .dequeue = (void *)egress_pacer_dequeue,
    .init = (void *)egress_pacer_init,
    .reset = (void *)egress_pacer_reset,
    .destroy = (void *)egress_pacer_destroy,
    .id = "bpf_pacer",
};
关键数据结构
const volatile 变量 rate_kbps 和 queue_limit 位于 .rodata 段。用户态在 open() 之后、load() 之前写入它们,之后验证器将其视为编译期常量。
packet_node 结构体保存每个排队的报文:
eligible_ns:该报文最早可以发送的时间(纳秒)。packet_len:报文长度,用于 backlog 统计。skb:一个 __kptr 字段,拥有内核套接字缓冲区的所有权。__kptr 标注告诉验证器这个字段持有一个被拥有的内核指针。node:一个 bpf_list_node,用于链入 FIFO。
private(A) 宏将锁、链表头和出发时间戳放入一个私有数据段,并确保正确对齐。
入队回调
egress_pacer_enqueue 从内核接收报文:
- 从
qdisc_skb_cb(skb)->pkt_len 获取报文长度。
- 如果队列已满,丢弃报文。
- 分配一个
packet_node。如果分配失败,丢弃。
- 计算该报文何时可以发送:
interval_ns = packet_len * 8 * 1000000 / rate_kbps(比特数除以千比特每秒得到纳秒)。
- 用
bpf_kptr_xchg 将 skb 的所有权转移给节点。调用完成后,节点拥有这个 skb。
- 在自旋锁保护下设置报文的可发送时间。如果队列之前是空闲的(
next_departure_ns 在过去),这个报文可以立即发送;否则它需要排在上一个报文之后。
- 把节点推入 FIFO 尾部,更新计数器,解锁,返回成功。
bpf_qdisc_skb_drop 调用处理被丢弃的报文:它把 skb 加入内核的释放链表并更新 qdisc 统计。
出队回调
当内核想要发送报文时,会调用 egress_pacer_dequeue:
- 从 FIFO 弹出队首节点。
- 如果队列为空,返回 NULL。
- 检查当前时间是否已到达
eligible_ns。如果未到,把节点推回队首,为 eligible_ns 安排一个 watchdog 定时器,然后返回 NULL。定时器触发后,内核会再次调用 dequeue。
- 如果已经可以发送,用
bpf_kptr_xchg 从节点取出 skb,递减计数器,释放节点,更新统计,返回 skb。
watchdog 机制(bpf_qdisc_watchdog_schedule)是 BPF qdisc 实现发送时序的关键:你告诉内核什么时候唤醒你,它在那个时间调用 dequeue。
重置回调
egress_pacer_reset 在 qdisc 被移除时运行。队列中可能还有未发送的报文,必须释放它们:
- 用
bpf_for(一个用于有界迭代的 BPF 辅助函数)遍历所有节点。
- 弹出每个节点,取出其
skb,用 bpf_kfree_skb 释放。
- 释放的报文计入
cleanup_dropped。
- 将出发时间戳和 qdisc 计数器清零。
注册
末尾的 SEC(".struct_ops") 块将回调函数注册为 Qdisc_ops 结构体。id 字段("bpf_pacer")是用户态用于创建这个 qdisc 实例的名称。
用户态加载器
egress_pacer.c 处理命令行参数,配置 BPF 程序,挂载 qdisc,等待指定时长,然后清理:
// SPDX-License-Identifier: (LGPL-2.1 OR BSD-2-Clause)
#include <net/if.h>
#include <bpf/libbpf.h>
#include "egress_pacer.skel.h"

static struct {
    const char *interface;
    unsigned long long rate_kbps;
    unsigned int queue_limit;
    unsigned int duration;
} env = {
    .rate_kbps = 1024,
    .queue_limit = 256,
    .duration = 10,
};

/* Argument parsing, signal handling, and diagnostics are omitted here. */
static int parse_args(int argc, char **argv);
static int wait_for_duration(void);

int main(int argc, char **argv)
{
    struct egress_pacer_bpf *skel;
    struct bpf_tc_hook hook = {
        .sz = sizeof(hook),
        .attach_point = BPF_TC_QDISC,
        .parent = TC_H_ROOT,
        .handle = TC_H_MAKE(1 << 16, 0),
        .qdisc = "bpf_pacer",
    };
    bool qdisc_created = false;

    parse_args(argc, argv);
    hook.ifindex = if_nametoindex(env.interface);

    skel = egress_pacer_bpf__open();
    skel->rodata->rate_kbps = env.rate_kbps;
    skel->rodata->queue_limit = env.queue_limit;
    egress_pacer_bpf__load(skel);
    egress_pacer_bpf__attach(skel);

    if (!bpf_tc_hook_create(&hook))
        qdisc_created = true;

    printf("READY interface=%s rate_kbps=%llu queue_limit=%u duration=%u\n",
           env.interface, env.rate_kbps, env.queue_limit, env.duration);
    wait_for_duration();

    if (qdisc_created)
        bpf_tc_hook_destroy(&hook);
    printf("SUMMARY enqueued=%llu dequeued=%llu policy_dropped=%llu\n",
           skel->bss->stats.enqueued,
           skel->bss->stats.dequeued,
           skel->bss->stats.policy_dropped);
    egress_pacer_bpf__destroy(skel);
}
加载器遵循标准的 libbpf 模式:
- 解析参数,用
if_nametoindex 验证接口存在。
- 打开 skeleton,将速率和队列上限写入
.rodata。
- 加载 BPF 程序(这一步会进行验证和 JIT 编译)。
- 挂载
struct_ops 实现,使 bpf_pacer 成为可用的 qdisc 类型。
- 用
bpf_tc_hook_create 在目标接口上创建 root qdisc。
bpf_tc_hook_create 调用具有独占语义:如果接口已经有 root qdisc,内核返回 -EEXIST,程序直接退出而不做任何修改。若请求接口的 root qdisc 冲突,加载器会打印 tc qdisc show dev IFACE 和恢复命令 sudo tc qdisc del dev IFACE root。struct_ops 名称冲突是全局的,而不是某个接口局部的,因此加载器会改为打印所有接口的 tc qdisc show,不会猜测应该修改哪个接口。程序绝不会自动执行破坏性命令;只有确认显示的 bpf_pacer 项确实是残留状态后,才能删除对应的 root qdisc。这一安全措施意味着该工具最适合用于你完全控制配置的专用接口。
挂载成功后,程序打印 READY,然后每隔 100ms 检查一次,直到时长到期或收到信号。清理顺序很重要:先调用 bpf_tc_hook_destroy(触发 reset 并释放排队的报文),然后读取最终统计,最后销毁 skeleton。
编译与运行
从源码构建:
cd src/53-egress-pacer
make clean
make -j2
选择一个你能够控制的接口,并在挂载 pacer 前检查它当前的 root qdisc:
tc qdisc show dev veth-service
确认该接口可用于这次实验后,启动 pacer,让正常应用流量经过它:
sudo ./egress_pacer --interface veth-service --rate-kbps 64000 --queue-limit 256 --duration 30
qdisc 生效后工具才会打印 READY。运行时长结束后,输出形式如下:
READY interface=veth-service rate_kbps=64000 queue_limit=256 duration=30
SUMMARY enqueued=... dequeued=... policy_dropped=... cleanup_dropped=0 bytes_dequeued=... max_qlen=...
enqueued 表示 qdisc 接收的报文数,dequeued 表示已经交给设备的报文数,policy_dropped 表示队列满时拒绝的报文数。如果进程在正常清理前被强制终止并留下 bpf_pacer,下次启动会打印所有接口的 qdisc 状态。找到包含 bpf_pacer 的那一行,确认它确实是残留实例,然后再用 sudo tc qdisc del dev ACTUAL_IFACE root 删除实际所属接口的 root qdisc。
命令行选项:
Usage: ./egress_pacer --interface IFACE [--rate-kbps KBPS] [--queue-limit PACKETS] [--duration SEC] [--verbose]

Options:
  -i, --interface IFACE       目标接口(必选)
  -r, --rate-kbps KBPS        出口速率,单位 Kbit/s,范围 8-100000000(默认:1024)
  -q, --queue-limit PACKETS   队列容量,单位报文数,范围 1-65535(默认:256)
  -d, --duration SEC          运行时长,单位秒,范围 1-86400(默认:10)
  -v, --verbose               打印 libbpf 调试输出
  -h, --help                  显示帮助
看到 READY 就表示 qdisc 已安装并正在限速。时长结束(或按 Ctrl+C)后,程序移除 qdisc 并打印 SUMMARY。
环境要求
BPF qdisc 需要 Linux 6.16 或更高版本。内核必须启用 BTF 和 BPF JIT:
| 要求 |
最低版本 / 配置 |
| Linux 内核 |
6.16+ |
CONFIG_BPF |
y |
CONFIG_BPF_SYSCALL |
y |
CONFIG_BPF_JIT |
y |
CONFIG_DEBUG_INFO_BTF |
y |
CONFIG_NET_SCHED |
y |
CONFIG_NET_SCH_BPF |
y |
| libbpf |
1.6.0+ |
| 权限 |
root |
仓库已在 src/third_party 中包含 libbpf 和 bpftool。使用 iproute2 中的 tc 检查目标接口,并在必要时清理残留的 root qdisc。
总结
本教程通过一个完整的 FIFO 限速器演示了 BPF qdisc:
- enqueue 接管报文所有权,根据报文长度和速率安排发送时间。
- dequeue 使用 watchdog 定时器在正确的时刻被唤醒,并将报文返回给内核。
- reset 释放 qdisc 移除时仍在队列中的所有报文。
这三个阶段——接收报文、控制释放时机、清理资源——构成了自定义调度器的可复用模式。
这个调度器实现了一条聚合 FIFO,速率和队列上限在加载时固定。它有意保持简单,适合在受控接口上验证功能正确性。生产级调度器可以在此基础上添加公平性、动态策略或跨重启的状态持久化。
参考资料
- Linux BPF qdisc 合入 commit
- Qdisc watchdog 后续 commit
- libbpf qdisc TC hook 支持
- libbpf 1.6.0 发布说明
- 上游 BPF FIFO qdisc selftest
- 上游 BPF qdisc test runner
- libbpf 1.7.0 发布说明
 发表于 3 天前
|
查看: 7|
回复: 0
 /1


