如果让普通大模型直接处理客服、审核或浏览器操作,麻烦的通常不是它不会回答,而是太自信。它可能张口就是“肯定没问题”,可你很难稳定判断它到底有几分把握。
Jeff 走的是另一条路:不让模型自由生成答案,而是给它几个固定选项,让它预测每个选项的概率。程序再根据概率决定自动处理、人工复核,还是拒绝。
先看输入和输出
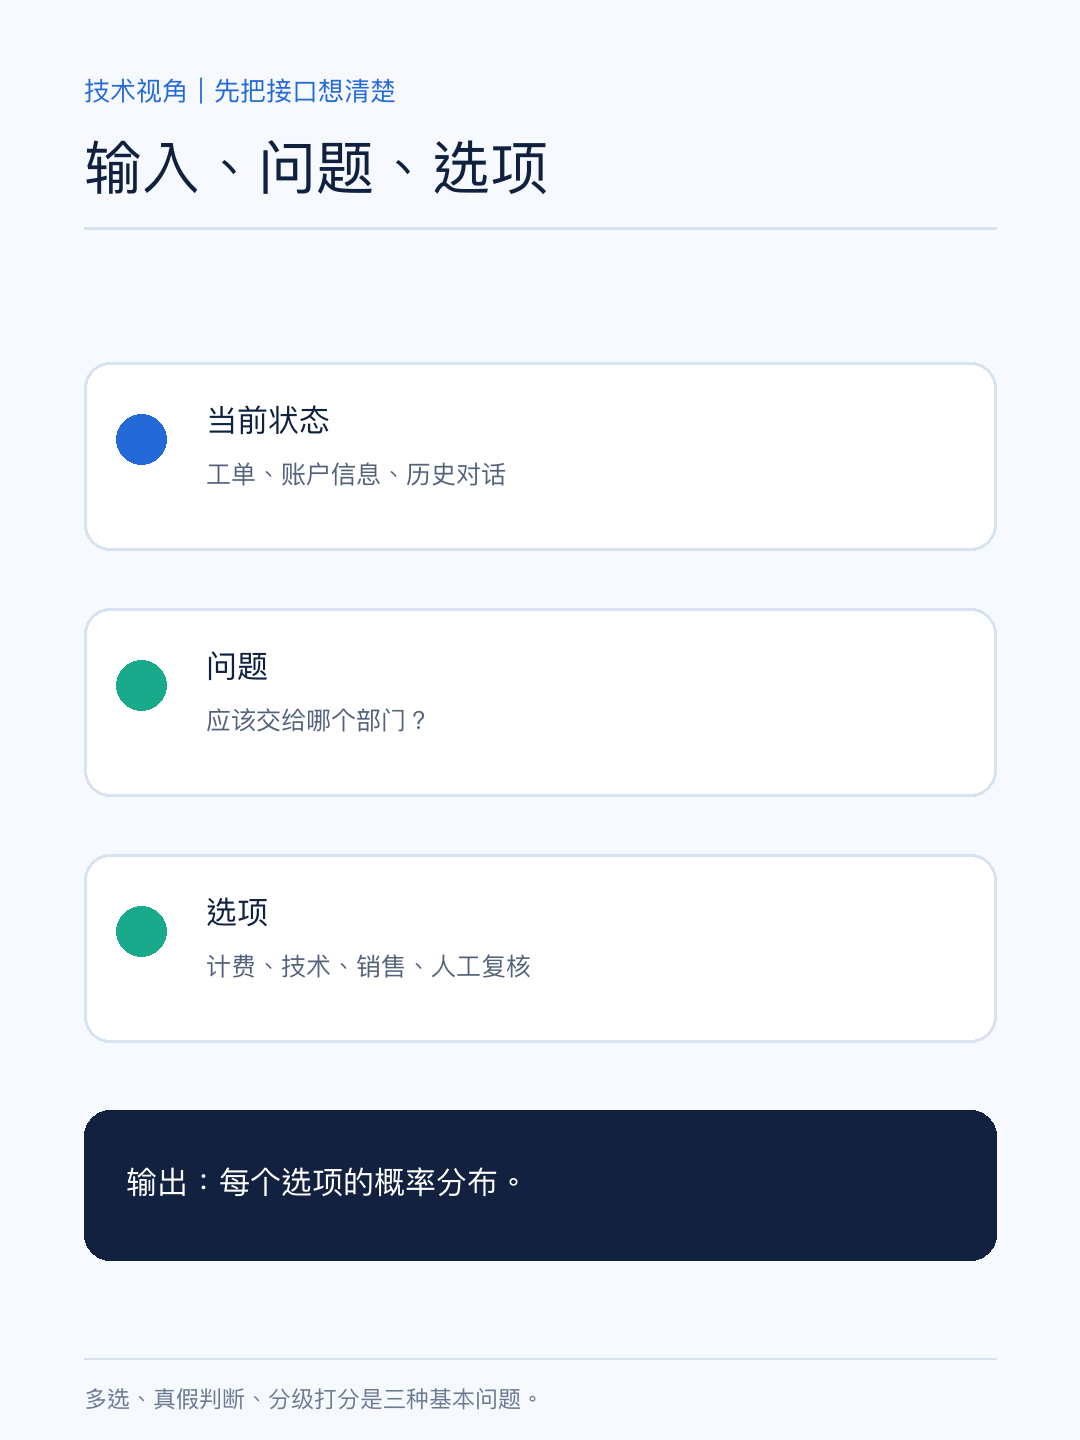
要先给 Jeff 三样输入:当前状态、问题、选项。
比如一个客服工单,状态里放用户问题、账户信息和历史对话;问题写成“这个请求应该交给哪个部门”;选项写成计费、技术、销售、人工复核,并为每个选项补一段判断说明。
输出不是一大段文字,而是每个选项对应的概率。问题要分成三种:多选、真假判断、分级打分。
多选适合客服路由。真假适合判断某条请求是不是提示注入。分级适合给线索、内容或风险打分。
阈值才是自动化的开关
拿“是不是 jailbreak”举例。你可以先定义三个动作:高风险自动拦截,中间区间交给人工,低风险正常放行。
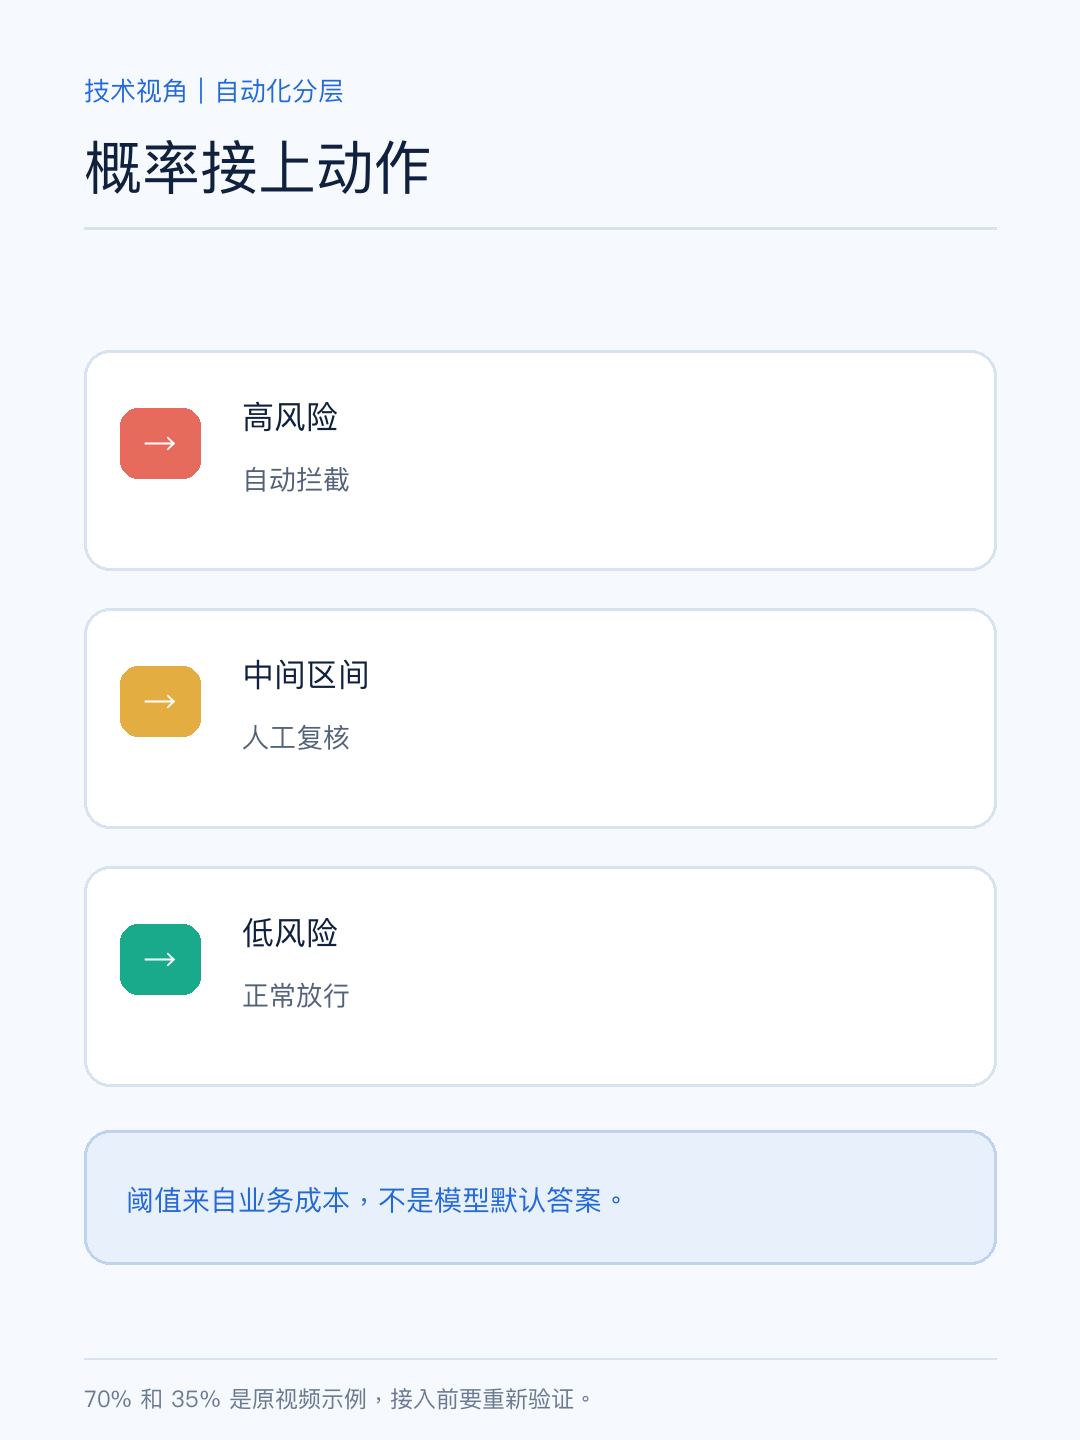
要根据误报和漏报成本重新定阈值。封掉一个正常用户,和放过一个攻击请求,代价可能完全不一样。
Jeff 的价值在于,概率输出给程序提供了一个可以接住的接口。模型不替你拍板业务动作,动作规则由你写。
浏览器自动化怎么接
浏览器操作里,最容易出错的是下一步点哪里。页面的 DOM 复杂,模型如果每次都读一大段内容,既慢又容易把上下文用光。
流程是:把任务、浏览器交互历史和当前 DOM 元素列表发给 Jeff。它只预测下一步动作:点击还是输入;如果点击,点哪个元素;如果输入,输入到哪个元素。需要写自然语言时,再交给一个小型大模型完成。
可以把这条链拆开:Jeff 负责动作选择,小模型负责生成文字。一个擅长快速分类,一个擅长组织语言。
三个可落地的练习
第一个是注册分析。先验证邮箱、补充人物或公司信息,再把这些信息和产品使用行为交给模型,分类成欺诈、升级销售机会、联盟或普通用户。
第二个是线索评分。抓取某个行业热门帖子的互动者,再让模型把他们分成人群类型和匹配程度。高分线索进入后续联系方式补全,低分线索不再消耗人工。
第三个是热门内容筛选。拉取过去 24 小时的帖子、作者资料、回复和互动数据,让模型判断它是产品发布、自然传播还是可能存在付费放大,并过滤掉与目标主题无关的噪音。
三个坑
选项设计比提示词长短重要。选项互相重叠,模型就算输出概率,也很难解释。
长上下文要拆。Jeff 的上下文窗口是 32K;资料再大,就要先分块、分别判断,再汇总。
不要把概率当准确率。它是模型对选项的信心表达,不是已经经过你业务验证的正确率。上线前拿历史样本测试,并保留人工复核。
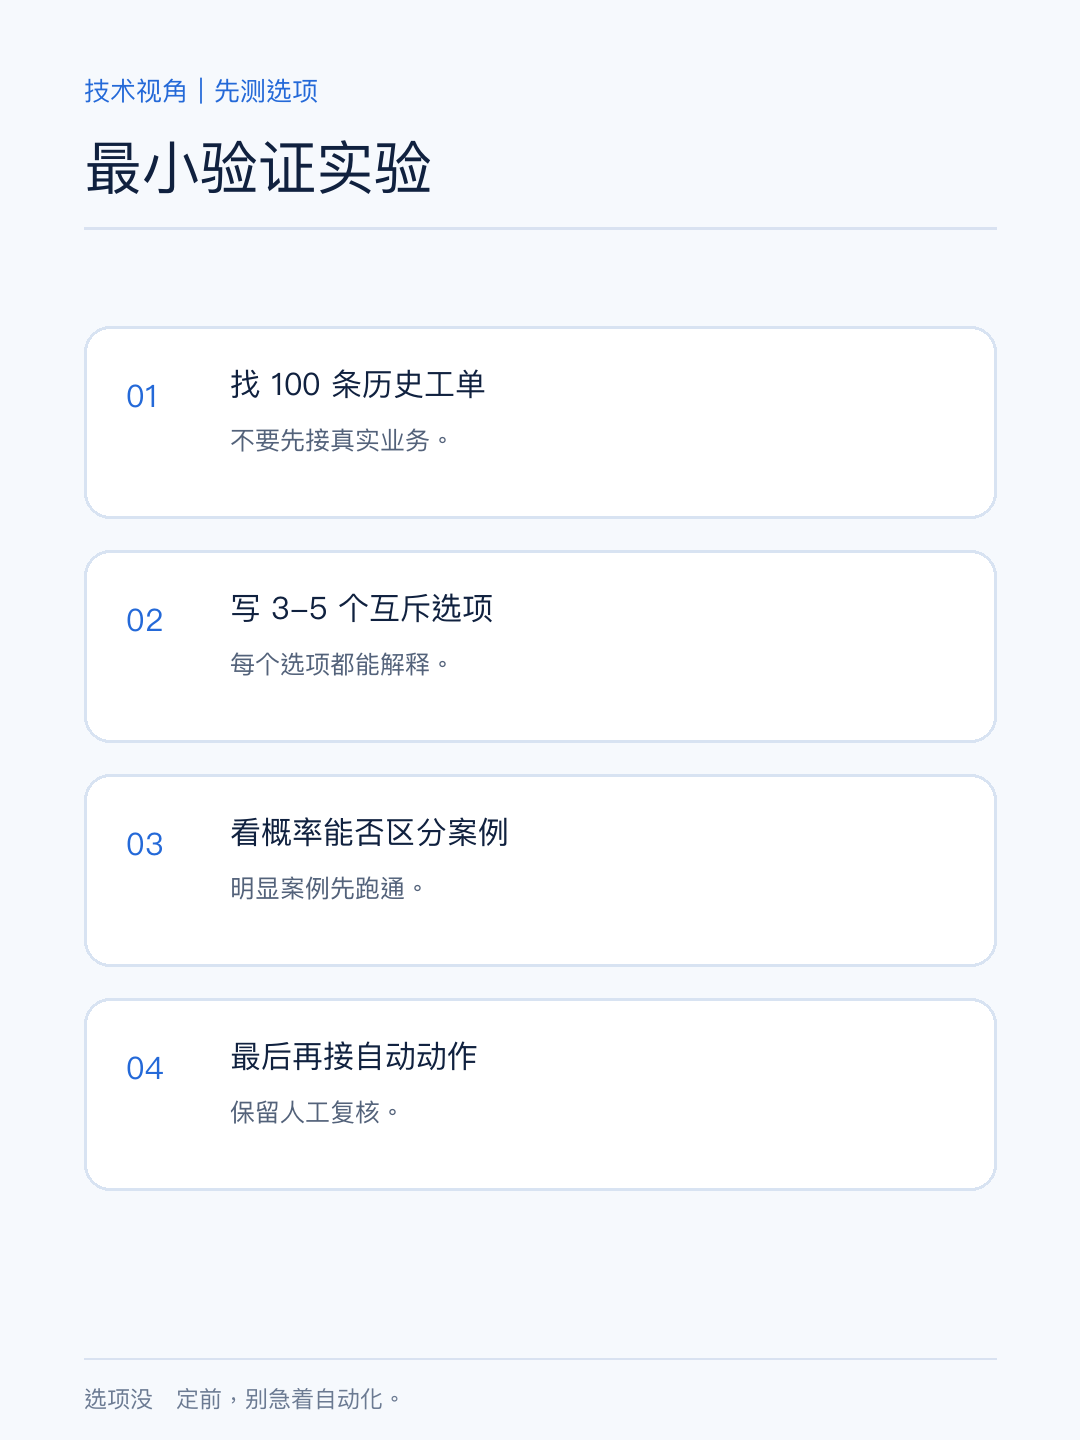
先别搭复杂系统。找 100 条历史工单,写出 3 到 5 个互斥选项,看看概率分布能不能区分明显案例。选项稳定了,再接自动动作。
 发表于 1 小时前
|
查看: 2|
回复: 0


