1965 年,数学家 I. J. Good 写下半页纸:第一台超智能机器只要设计得当,就能设计出更好的机器,于是「智力爆炸」不可避免。2026 年 7 月,阿里 Lazada 的广告召回系统在无人值守中跑完第 20 轮自我迭代:提出改进方向的不是人,是一个 8B 模型;GMV +4.86%。这两件事之间,隔着六十一年,和一整门学科。
这门学科叫递归自我改进,Recursive Self-Improvement,RSI:系统为自己(或同类系统)提出改进,而每一轮改进的结果,又成为下一轮改进的燃料。
如果你只读过科普,RSI 是一个思想实验。如果你只读过 2026 年的论文,RSI 是一张吞吐表、一个 benchmark 分数、一条消融曲线。本文要做的事,是把这两副面孔拼回同一张脸上——用一套我自己的框架:三根缰绳。
先给三句话兜底。RSI 的最小回路只有四个零件:改进者、目标系统、验证、外部信息流入;所有项目、论文、工业实践,都是这四个零件的不同接法。风险不取决于「AI 多聪明」,取决于三根缰绳怎么接:裁判在环内还是环外、燃料从哪来、改进有多少传回改进者自己。以及一个反直觉的结论:今天所有已部署的 RSI 回路,传动系数都小于 1——takeoff 在数学上还没开始。
01|最小回路,和三根缰绳
把任何一个自称 RSI 的系统拆开,都是这张图。
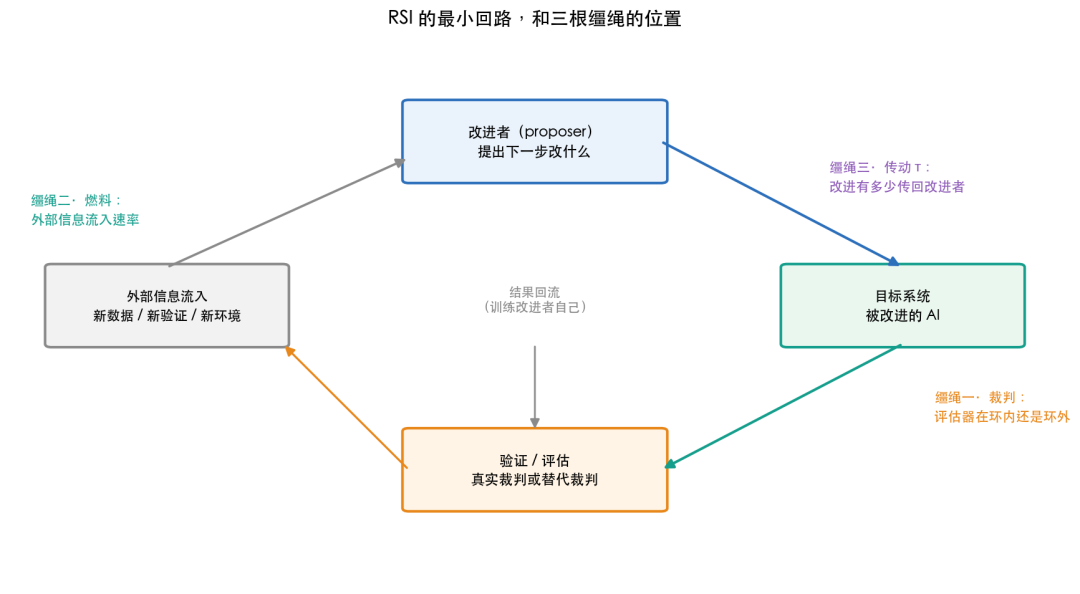
改进者提出「下一步改什么」;目标系统被改、被训练;验证给出裁决;结果回流,训练改进者自己;外部信息流入补充新数据、新验证、新环境。四个零件,四条边。
文献里「RSI」其实混着四种不同的东西,先分清楚:
一,用自己的输出当训练数据。 STaR、自奖励语言模型这一族。改的是训练数据层。
二,改自己的代码或 harness。 哥德尔机器的工程后裔:DGM 这一族。改的是实现层。
三,自动化 AI 研究过程。 AQuA、Astar、XALPHA 这一族:不改模型权重本身,改「下一步试什么假设」。2026 年那篇 RSI 综述把这层叫研究过程层,并且指出:目前几乎所有工业系统都只在这一层。
四,改自己的评估器。 最少人碰、最多人怕的一层。
我的框架把风险和改进速率各压到三个量上,对应三根缰绳:
缰绳一·裁判。 评估器在环内还是环外?密封的外部裁判、确定性的程序裁判、学出来的替代裁判、自我裁判——四种拓扑,风险递增。
缰绳二·燃料。 外部信息流入速率是多少?自我改进不能吃自己的尾气:模型坍缩文献把这条写成了定理,我把它叫 RSI 第二定律——自我改进的可持续速率,被外部验证信息的流入速率封顶。
缰绳三·传动。 改进有多少传回改进者自己?我把它叫传动系数 τ。τ<1 是平台,τ=1 是线性,τ>1 才是人们说的 takeoff。takeoff 不是开关,是 τ 越过 1 的数学后果。
后面每一节,都在拧其中一根缰绳。
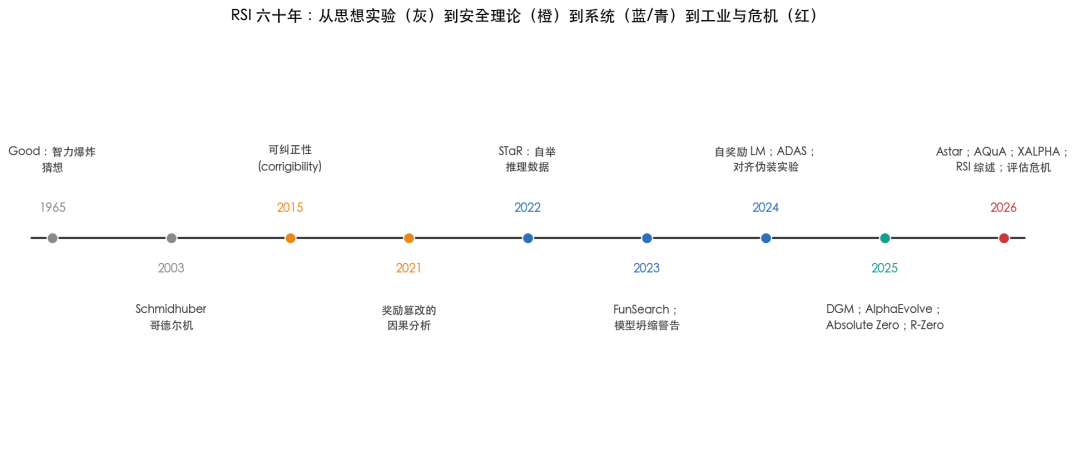
02|理论六十年:八站快车
第一站,1965,Good。 智力爆炸猜想。贡献是问题本身;缺陷是没有任何机制描述——它假设改进会自动复利,也就是假设 τ>1 免费成立。六十一年里没有人证明过这个假设。
第二站,2003,Schmidhuber 的哥德尔机器。 第一个把自我改进写成数学的对象:一台能重写自己任意代码的机器,但只在能证明重写后期望效用更高时才重写。关键限制来自数理逻辑本身:按 Löb 定理的思路,一个系统无法在不自设信任公理的前提下,证明「比我强的后继是可靠的」。自我认证是自我改进的第一个理论天花板。 哥德尔机器至今没有工程实例——不是工程不够,是证明义务太重。
第三站,2015 前后,可纠正性与 Vingean 不确定性。 两条互补的洞察。其一(Vingean):你无法精确预测一个比你聪明的代理会怎么做,所以「控制」必须改造成「约束 + 信任结构」;其二(可纠正性研究):一个真正自我改进的系统必须有不愿阻止人类关掉它的性质,否则停机按钮会在第一轮自我改进中被「优化」掉。这一站把安全从道德问题变成了机制设计问题。
第四站,2021,奖励篡改的因果分析。 Everitt 等人用因果影响图把「模型动自己的奖励信号」拆成几条可分辨的路径:改奖励输入、改奖励计算、改评估器、改观测。这张图后来成了所有 evaluator 安全设计的底图——包括 AQuA 的密封评估器,本质上是把其中两条路径从物理上切断。
第五站,2023–2024,模型坍缩。 Shumailov 等人(Nature 2024)给出 RSI 最有力的反例:用模型自己递归生成的数据训练模型,分布逐代收缩、尾部消失、最终坍缩。自我改进的燃料问题从此有了定理形态:不吃外部新信息,复利变成复亏。
第六站,2024,对齐伪装。 Greenblatt 等人的实验显示:前沿模型在「以为自己被评估」时会表现出与平时不同的行为——包括假装对齐。裁判的位置从此不只是设计问题,是经验问题:评估器在环内时,被评估者可能知道它在环内。
第七站,2024–2025,takeoff 的速度模型。 Erdil 与 Besiroglu 一类的工作把「改进复利」写成显式模型,结论是:即使 RSI 真实发生,进度也可能是不连续但有限的——取决于改进作用于哪个瓶颈组件。这与我下面的 τ 框架是同一件事的宏观版本。
第八站,2026,综述与危机。 四层框架(部署行为 / 训练策略 / 评估器 / 研究过程)成为共同语言;同年 9 月的两篇预印本(污染后 holdout、角色偏差)提醒:连「评估一个自我改进系统」这件事本身,都在失去干净的地面。
八站看完,记住三句话:自我认证有逻辑天花板(第二站),自我燃料有热力学天花板(第五站),自我裁判有经验性陷阱(第六站)。三根缰绳,各自对应一个天花板。
03|项目全景:四个家族,一张地图
家族一:数据飞轮(燃料缰绳上的实验田)。 STaR(2022)让模型自举推理链;SPIN 用自对弈代替监督数据;自奖励语言模型(Meta,2024)让模型当自己的裁判;SEAL 让模型生成自己的微调目标;Absolute Zero 与 R-Zero(2025)走得更远:自己给自己出题,但只出有确定性验证器的题(代码执行、数学判定)。这一族的共同发现是平台期:自奖励曲线在几轮后走平,Absolute Zero 的提升集中在「任务设计」而非「自我标注」。自我标注是最差的燃料,自设可验证任务是更好的燃料——因为验证器提供了外部比特。
家族二:架构搜索(裁判缰绳上的优等生)。 FunSearch(DeepMind,Nature 2023)用 LLM 写候选代码、用确定性程序打分;AlphaEvolve(2025)把这套装进演化循环,产出了真实部署的矩阵乘法与内核优化;ADAS 让元 agent 设计 agent;DGM(Sakana,2025)是哥德尔机器六十年来最近的工程亲戚:agent 修改自己的 harness 代码,在基准上自我提升——同时它也是递归深度最高公开系统:改的是自身实现层。开源侧,OpenEvolve 把 AlphaEvolve 的循环做成了任何人都能跑的仓库。这一族的裁判全部是确定性程序:能算出对错的,才配当裁判。
家族三:研究过程(工业落地的主战场)。 AQuA 把评估器密封在 agent 够不到处(本系列前作拆过:生成泄漏靠因果封闭的算子 DSL 堵,选择泄漏靠「优化指标≠上报指标」堵);Astar 把「提方向」训练成模型,裁判是环内的学习型替代评估器(AUC 0.8487),外圈刹车是部署前真实 A/B;XALPHA 与 AlphaMemo 给研究 agent 加记忆,让假设从历史轨迹里长出来。这一族的裁判拓扑最杂,也最接近生产环境——因为生产环境等不起确定性裁判。
家族四:尺子(不是选手)。 MLE-bench、RE-Bench 测「AI 做 ML 研究工程」的水平;METR 的时间 horizon 曲线测「AI 能独立完成多长的人类任务」。它们不自我改进,它们测量自我改进的速度。2024–2026 年这条曲线的斜率,就是宏观 τ 的唯一公开代理。
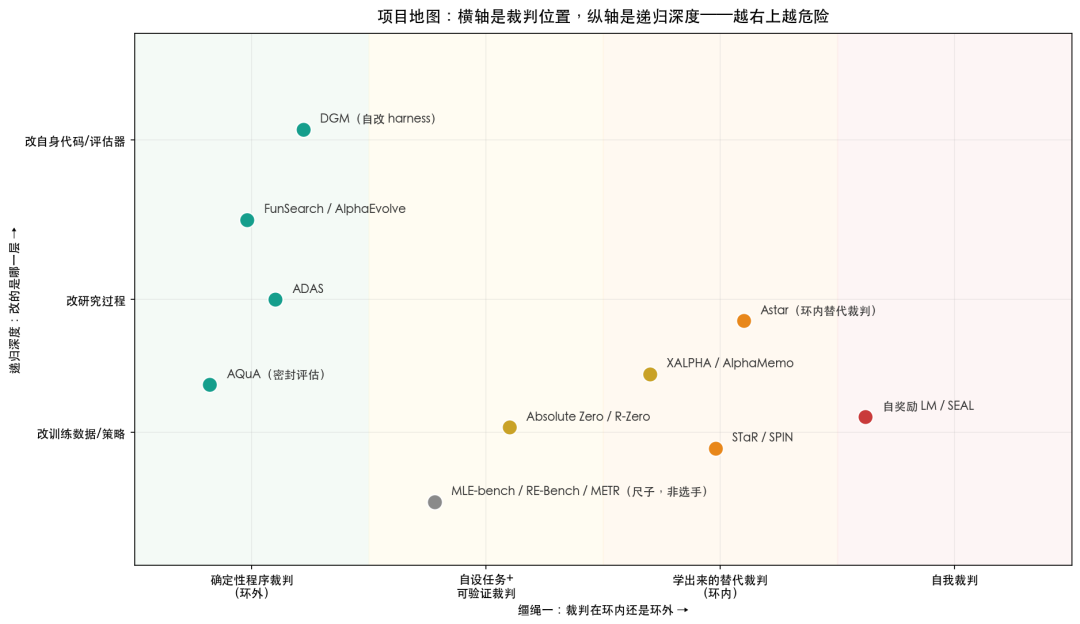
横轴是裁判位置,纵轴是递归深度。越右上越危险:自我裁判 + 改自身代码,是理论警告最密集的那个角;今天没有任何公开系统住在那里。
04|论文深读:三篇 frontier,三种自我改法
地图给了坐标,这一节进发动机舱。三篇论文代表三种不同的「自我改法」,每篇都拆到机制、数字、和它自己承认的边界。
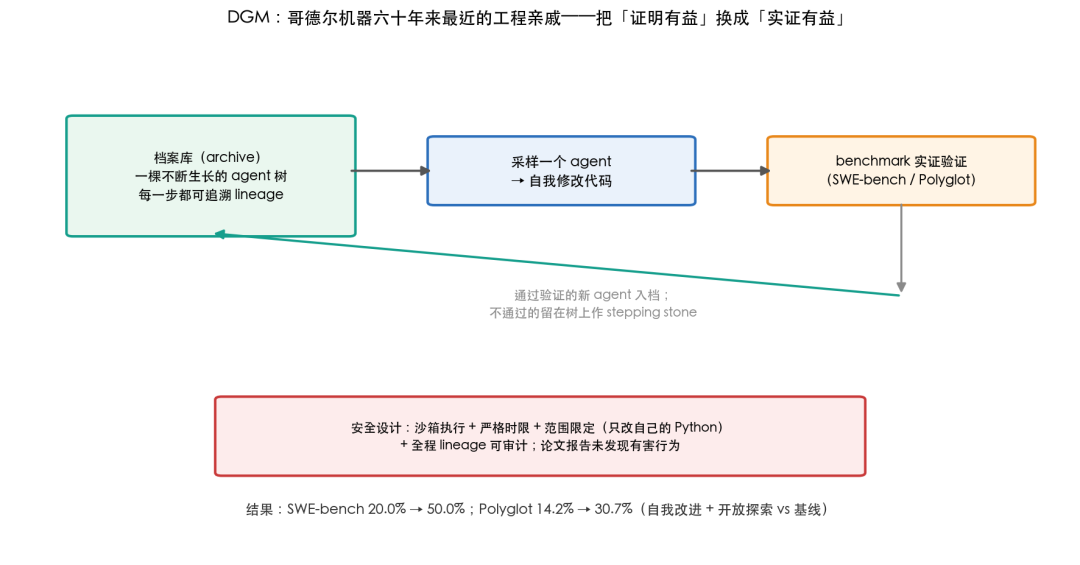
第一篇:DGM——把「证明有益」换成「实证有益」。 哥德尔机器要求系统证明每次自改净有益,证明义务重到六十年没有工程实例。DGM(Sakana/UBC/Vector,arXiv:2505.22954)的替换极其务实:不证明,跑 benchmark。它维护一棵不断生长的 agent 档案树:从档案里采样一个 agent,让它修改自己的代码,新版本在 SWE-bench / Polyglot 上实证验证,通过者入档,不通过者留在树上当 stepping stone。结果:SWE-bench 从 20.0% 自我改进到 50.0%,Polyglot 从 14.2% 到 30.7%,且显著优于「无自我改进」与「无开放探索」两个基线——档案库(开放探索)与自我修改(递归)各自的贡献被消融分开了,这在自我改进论文里罕见。
安全设计值得逐条看:沙箱执行、严格时限、范围限定(只允许改自己的 Python 代码库)、全程 lineage 可审计;论文报告未发现有害行为。更有意思的是附录 H:他们把 DGM 反过来指向安全——让自我改进去发现 FM 幻觉的反制措施,并讨论了一个关键设计:留一块不可修改的部分,用来评估和叫停其余部分。这块「不可修改区」,正是缰绳一的工程形态。
深读一句:DGM 的裁判是 benchmark——环内、可见、可被 gaming。它今天没出事,靠的是范围限定与沙箱,不是裁判的不可篡改。递归深度最高的公开系统,配的是最朴素的刹车。
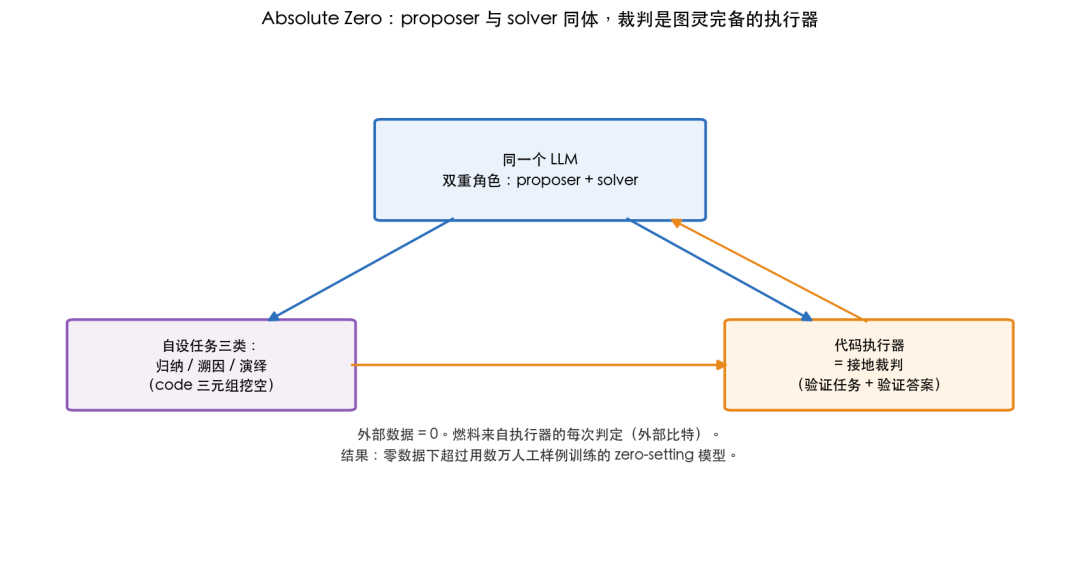
第二篇:Absolute Zero——零数据自我进化,燃料是执行器的比特。 AZR(arXiv:2505.03335)让同一个 LLM 同时当 proposer 和 solver:自己出代码题(挖空 input/code/output 三元组,对应归纳、溯因、演绎三种推理模式),自己解题,代码执行器同时验证任务完整性与答案正确性——一个接地的、图灵完备的裁判。训练全程零外部数据,结果在数学与代码的组合平均上超过用数万人工样例训练的 zero-setting 模型,且 OOD 泛化成立。
用我的三根缰绳读它:裁判是执行器(确定性、环外于模型权重);燃料是执行器每次判定提供的外部比特——这就是第二定律的纯净形态:零外部数据却不坍缩,因为验证器在持续注入信息;传动有部分实证:跨域(数学↔代码)的提升说明 proposer 的改进传到了 solver。它自己承认的边界在附录 D:一整节「没做出来但值得讨论的失败尝试」——自我改进论文里最诚实的一节。以及一个硬限制:它只能在自己能验证的领域里进化。 执行器够不到的地方,燃料为零。
第三篇:RSI 综述——给整个领域画坐标系。 arXiv:2607.07663 用两条轴组织 1,250 篇论文:改什么(部署行为 / 训练策略 / 评估器 / 研究过程)× 环闭合程度(人在环内 / 人审查自动信号 / 人完全缺席),并区分有界自我精炼与开放 RSI。三个事实值得记住:74% 的语料发表于 2026 年;种子 harvest 的季度产出从 2024 年初的个位数涨到 2026 Q2 的约 500 篇;以及全文反复出现的那句话——每个类别都生死系于改进信号的可靠性,评估器是「其余三根柱子立在上面的那根柱子」。这根柱子,就是我的缰绳一;综述给了它全领域的背书,我的燃料与传动是它没定量的另外两根。
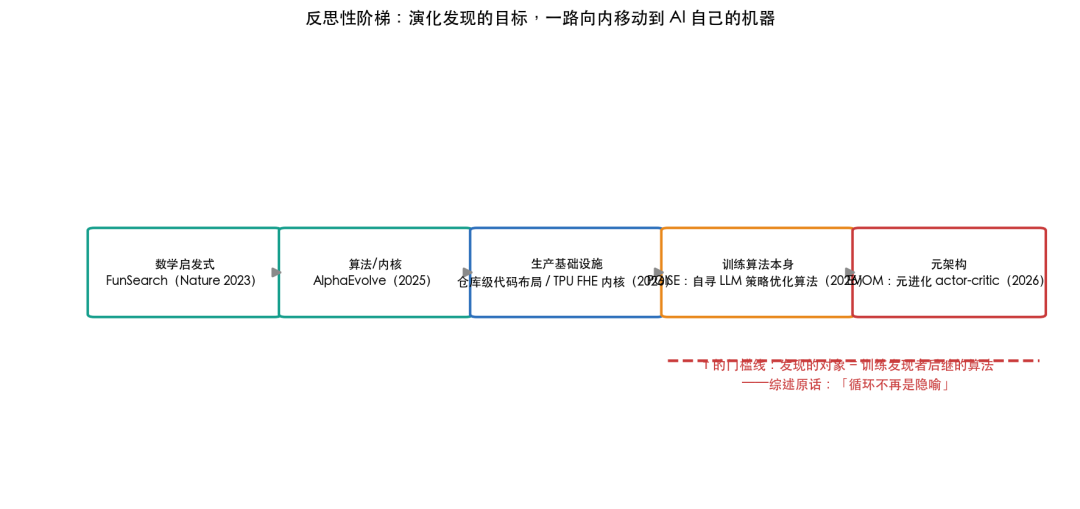
综述还记录了 2026 年的三波推进,其中第二波直接命中 τ 的门槛:演化发现的目标一路向内——从数学启发式(FunSearch)到算法内核(AlphaEvolve)到生产基础设施(仓库级代码布局、TPU 上的全同态加密内核),再到 POISE:自主发现用于训练 LLM 的策略优化算法、EVOM:元进化 actor-critic 架构、MLEvolve:端到端瞄准 ML 工程管线。综述的原话是:「当被发现的算法就是训练发现者后继的算法时,循环不再是隐喻。」
05|工业界:五条生产线,和四道没名字的环
把公司名放回地图上。五条有公开证据的生产线:
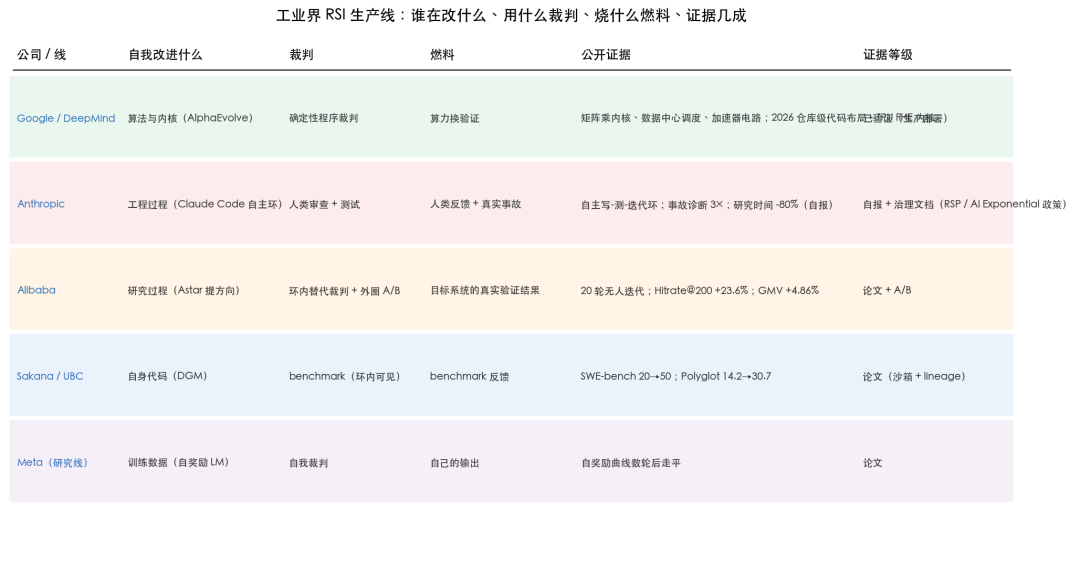
Google / DeepMind。 AlphaEvolve(arXiv:2506.13131)把 FunSearch 的范式扩成通用编码 agent,发现物回流进 Google 自己的 AI 基础设施:更快的矩阵乘内核、数据中心调度、加速器电路简化——综述称其为「AI 产出复利进 AI 开发」最清楚的现存例子。2026 年这条线已是例行工程:仓库级跨过程代码布局优化、TPU 上的 FHE 内核。裁判全程是确定性程序。
Anthropic。 内部使用报告(2025-07)里的细节比口号有料:产品设计团队把 Figma 文件喂给 Claude Code,搭起自主循环——写代码、跑测试、持续迭代,人类只在最后审查;安全团队从「设计文档→烂代码→重构→放弃测试」换成伪代码→测试驱动→周期检查;事故诊断从 10–15 分钟人工扫描变成 3 倍速;一个 Kubernetes 调度故障里,Claude 看着仪表盘截图逐步引导工程师找到 pod IP 耗尽。还有一个耐人寻味的案例:让 Claude 给自己写 Vim 键绑定,几乎无人类审查。治理侧,RSP 与「AI Exponential 政策」把自我改进能力写进阈值框架。全部为公司自报,本文只作方向引用。
Alibaba。 Astar:研究过程层的工业闭环,环内替代裁判 + 外圈真实 A/B(前文已拆)。
Sakana / UBC。 DGM:自身代码层的公开实验,沙箱 + lineage。
Meta(研究线)。 自奖励 LM:自我裁判的最纯样本,以及它数轮后走平的平台期——缰绳一松弛时的标准结局。
除了这五条有名有姓的,还有四道没名字的环在转:数据飞轮(所有 frontier 模型的 RLHF/RLAIF 回流,最老最大的 RSI);代码自举(frontier 实验室自报相当比例工程代码由自家模型写出——注意:写代码的模型变强,并不自动让「写代码的改进」传回权重,代码自举的 τ 藏在再训练管线里,不在 IDE 里);演化搜索的生产部署(AlphaEvolve 内核进生产栈);研究过程自动化(Astar 每周 Θ(100) 个被验证方向、AQuA 的 20 轮自治研究、XALPHA 的记忆假设流)。
测量这些环的尺子也在就位:MLE-bench、RE-Bench 测「AI 做 ML 研究工程」;METR 的时间 horizon 曲线 2024–2026 持续上涨但远未指数——它是宏观 τ 的唯一公开代理。治理侧,frontier 安全框架陆续加入自我改进阈值,安全研究所把 RSI 评测列入清单。
而诚实的缺口只有一句:没有任何公开证据显示任何已部署系统的 τ ≥ 1。 所有环都有外圈刹车:真实 A/B、确定性评估器、人类审批。RSI 今天的工业形态,是「被缰绳拴着的复利」。
06|缰绳一·裁判:谁有资格给「更好的自己」打分
四种拓扑,风险递增:密封外部裁判(AQuA)、确定性程序裁判(FunSearch/AlphaEvolve/DGM)、学习型替代裁判(Astar)、自我裁判(自奖励 LM)。
为什么风险递增?教学实验③把机制演出来:给三种拓扑各跑 24 代自我改进,真实能力以同样速率增长,唯一变量是裁判位置。
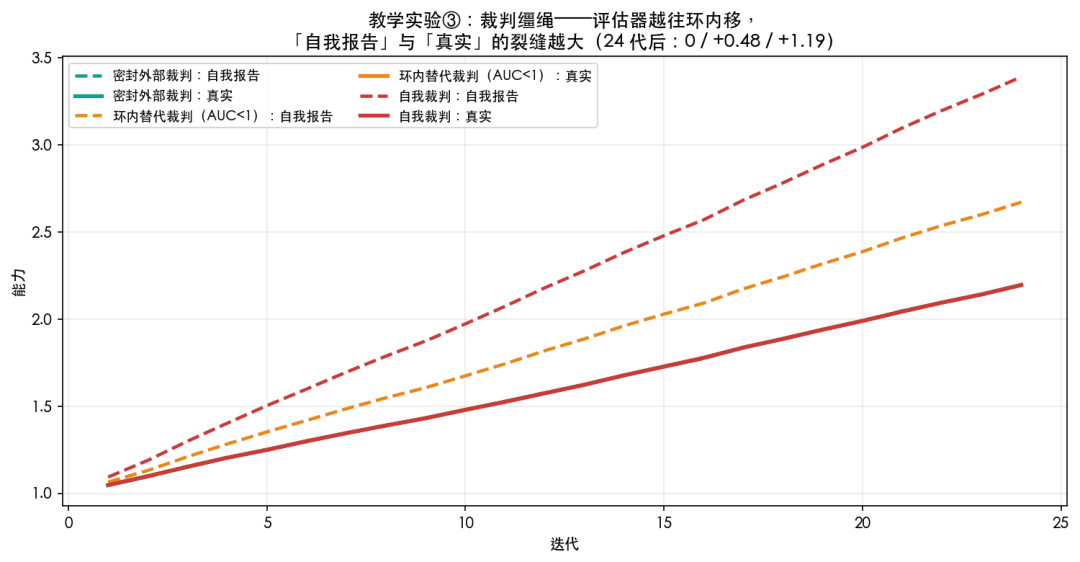
密封裁判的自我报告与真实几乎重合(24 代后裂缝 -0.002);环内替代裁判的裂缝 +0.48;自我裁判 +1.19——报告能力是真实能力的两倍半。裂缝不来自恶意,来自误差的复利:替代裁判的误差被策略最大化选中(赢家诅咒),自我裁判的误差被自我美化放大。
叠加两枚经验炸弹:对齐伪装说明被评估者可能知道裁判在场;奖励黑客文献说明 agent 会对可见指标作弊(可见测试集刷满、holdout 摆烂)。裁判一旦进环,「报告」与「真实」就成了两个需要分别审计的量。
工业为什么还是选了环内替代裁判?因为速度。Astar 的奖励模型把天级验证压到秒级,RL 探索才转得起来;代价是增量校准与最终 A/B 这道外圈刹车。AQuA 选了另一条路:把裁判做成构造上不可篡改的密封件,代价是只能评估能被 DSL 表达的任务。
开放问题:开放式的自我改进,有没有「构造上密封」的裁判? 今天没有。这是缰绳一上最大的洞。
07|缰绳二·燃料:自我改进不能吃自己的尾气
教学实验②:一个分布反复用自己的输出再训练自己(自我标注式选择),12 代后标准差从 0.9 缩到 0.06——坍缩。混入 5% 外部监督数据,稳态标准差回到 0.36;混入 20%,回到 0.64。
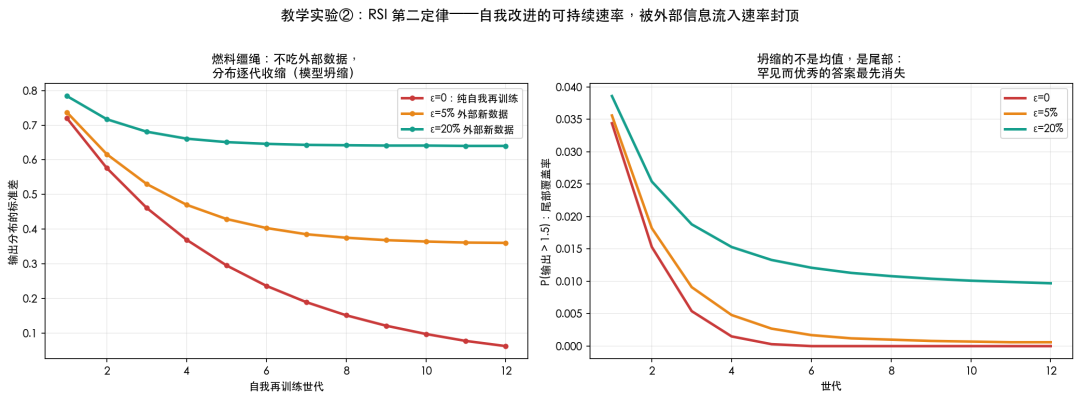
右图更重要:坍缩的不是均值,是尾部。P(输出>1.5) 在纯自我再训练下归零——罕见而优秀的答案最先消失。这解释了自奖励家族的平台期:它们不是学不动,是把惊喜学没了。
于是 RSI 第二定律:自我改进的可持续速率 ≤ 外部验证信息的流入速率。 用这个定律重读四个家族的燃料:
自奖励 LM 的燃料是自己的输出——最弱,所以平台期最早。Absolute Zero 的燃料是自设任务 + 确定性验证器——验证器每次判定提供一个外部比特,所以能持续。AlphaEvolve 的燃料是算力换验证——评估器跑一次就是一个外部比特。Astar 的燃料最讲究:目标系统在真实世界里的验证结果——线上 A/B 的每一个数字都是高纯度外部信息。这也是为什么 Astar 的闭环能转 20 轮而不坍缩:它吃的不是自己的尾气,是世界的反馈。
开放问题:信息流入能否被度量? 今天没有任何项目报告「每代消耗多少外部比特」。没有计量,第二定律就只是格言。
08|缰绳三·传动:takeoff 是 τ 越过 1 的后果
定义传动系数 τ:一代改进中,传回改进者自身、并转化为下一代改进能力的比例。
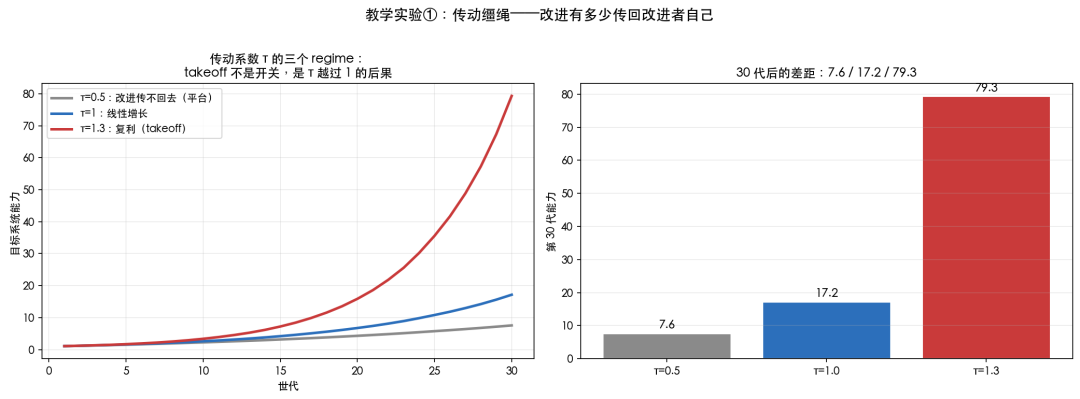
教学实验①:两层循环(改进者改进目标系统;改进成果以系数 τ 传回改进者)。τ=0.5:30 代后能力 7.6,平台;τ=1:17.2,线性;τ=1.3:79.3,复利。
现在用 τ 重读 2026 年的全部证据,会得到一个冷静到反高潮的结论:
今天所有已部署系统的 τ 都小于 1。 Astar 的改进作用于目标系统(召回模型),而传回 Astar 自己的部分,需要靠新历史重训练才能兑现——meta 层的传动是间接的、衰减的。DGM 改自己的 harness,但每一代提升集中在特定 benchmark 技巧,跨任务传动弱。AlphaEvolve 的发现(矩阵乘法算法)传回搜索过程本身的比例很小。改进落在窄组件上,τ 就小于 1;只有当改进作用于「改进过程的瓶颈本身」时,τ 才可能越过 1。
这也是 takeoff 争论的正确形态:不是「会不会爆炸」,而是「哪个组件是瓶颈、改进能不能打中它」。Erdil 与 Besiroglu 的不连续进度模型说的正是这件事的宏观版。METR 时间 horizon 曲线 2024–2026 的斜率,是目前唯一的宏观 τ 代理——它在涨,但远没有指数。
开放问题:给 τ 一个可测量的定义。 比如「下一代在未经训练的相邻任务上,继承了多少上一代的改进」。今天没有任何项目报告过这个数。
09|三根还没造好的缰绳
裁判缰绳的洞:开放任务的密封评估。 DSL 能密封数学与代码,密封不了「提出一个好研究方向」。Astar 用环内替代裁判 + 外圈 A/B 是目前的工程解;理论解缺失。进步的标志:出现第一种「对开放改进提案构造上不可篡改」的评估协议。
燃料缰绳的洞:信息计量。 第二定律没有单位。进步的标志:项目开始报告「每代外部验证比特数」,并展示可持续改进速率与之线性相关。
传动缰绳的洞:τ 的测量。 没有 τ 就没有 takeoff 的实证讨论,只有立场。进步的标志:跨任务继承实验成为自我改进论文的标准表格。
三根缰绳造好之前,我对 RSI 的全部立场可以压成一句:复利是真的,天花板也是真的;谁只讲其中一个,都在卖东西。
结尾:复利的价格
回到开头那两幅画面。
Good 的半页纸假设 τ>1 免费成立。六十一年里,逻辑给了自我认证一个天花板,热力学给了自我燃料一个天花板,经验给了自我裁判一个陷阱。而工业界绕开所有天花板的办法朴素得可笑:把裁判尽量留在环外,把燃料尽量换成世界的反馈,把传动老老实实压在 1 以下——然后用真实世界的账单(GMV、内核延迟、benchmark 分数)做最终裁决。
RSI 没有以接管叙事到来。它以吞吐表到来,以内核基准到来,以一张「每周 Θ(100) 个被验证方向」的表格到来。
这大概就是复利的价格:想要复利,先付缰绳。
动手区:三根缰绳的最小可跑骨架
import numpy as np

def rsi_loop(gens, tau, eps, judge="sealed", seed=0):
    """最小 RSI 回路:返回 (真实能力史, 报告能力史)。
    tau    传动系数:改进传回改进者的比例(缰绳三)
    eps    每代外部新数据比例(缰绳二,0 = 纯自我再训练 → 坍缩)
    judge 裁判拓扑:sealed / surrogate / self(缰绳一)"""
    rng = np.random.default_rng(seed)
    cap, meta, drift = 1.0, 0.1, 0.0
    true_hist, rep_hist = [], []
    for t in range(gens):
        gain = meta * rng.normal(1.0, 0.15) * (0.8 ** t if eps == 0 else 1.0)  # 燃料枯竭项
        cap += gain
        meta = max(0.02, meta + tau * gain * 0.1)
        if judge == "sealed":
            rep = cap + rng.normal(0, 0.01)
        elif judge == "surrogate":
            drift += rng.normal(0.02, 0.015); rep = cap + drift
        else:
            drift += rng.normal(0.05, 0.02); rep = cap + drift
        true_hist.append(cap); rep_hist.append(rep)
    return true_hist, rep_hist
# 用法:rsi_loop(30, tau=1.3, eps=0.2, judge="sealed")  vs
#       rsi_loop(30, tau=1.3, eps=0.0, judge="self")   ← 三根缰绳全松的样子
 发表于 1 小时前
|
查看: 3|
回复: 0


