RSI 持续火热。Google 最近发布了 RSI 自我改进新范式 Dream-RSI,让 AI Agent 在“梦境”中自我进化。
一、递归自我改进的痛点
递归自我改进(Recursive Self-Improvement, RSI)是自主 AI 系统的圣杯之一:智能体不断生成候选方案、评估结果、吸收反馈、迭代改进,循环往复。AlphaEvolve、FunSearch 这类系统已经在算法设计、数学发现上证明了这条路线的威力。
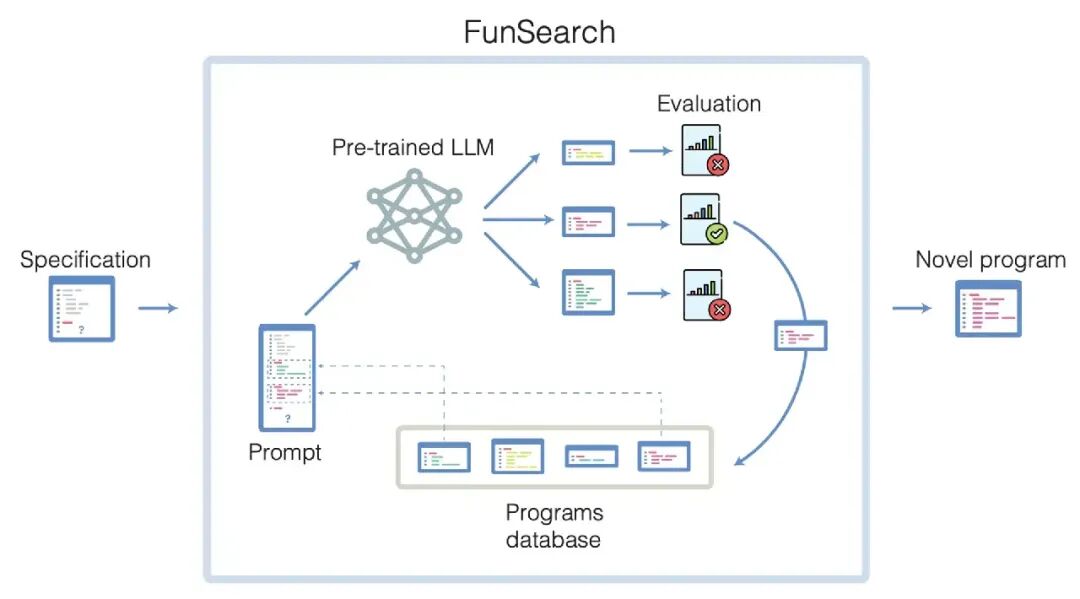
但论文指出了一个被长期忽视的问题:当发现过程扩展到数千次提议—评估循环时,真正决定成败的不是底层模型多强,而是探索策略的改进循环太贵,闭环闭不上。
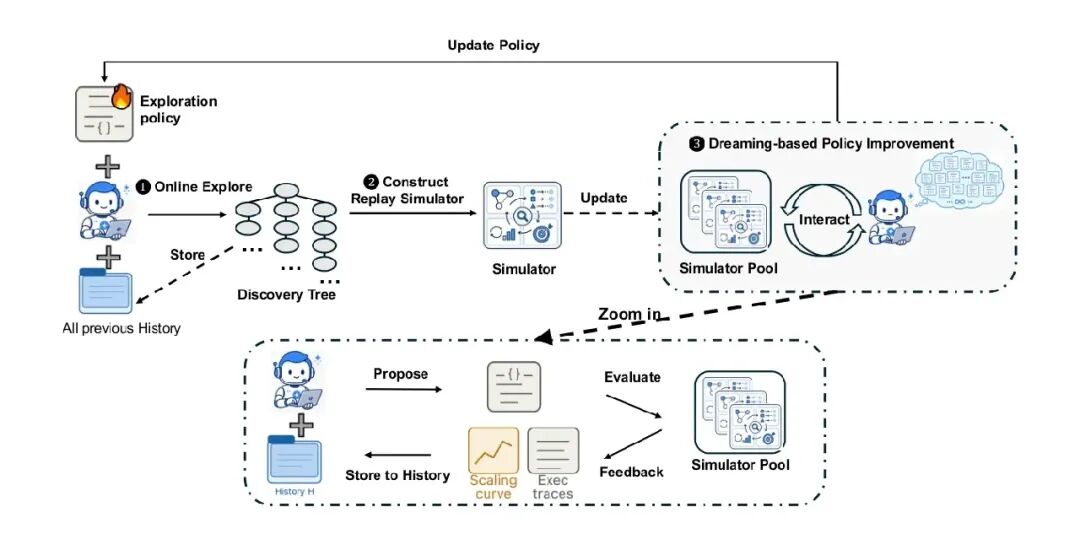
Dream-RSI 系统总览
二、发现历史 = 一台免费的回放模拟器
论文用了一个很直观的类比:一个 agent 在陌生环境里导航,第一次走会绕路、撞死胡同、回溯,但一旦这张地图被画出来,后来的导航策略就不用人肉重走一遍——直接在地图上推演、比较路线就行。
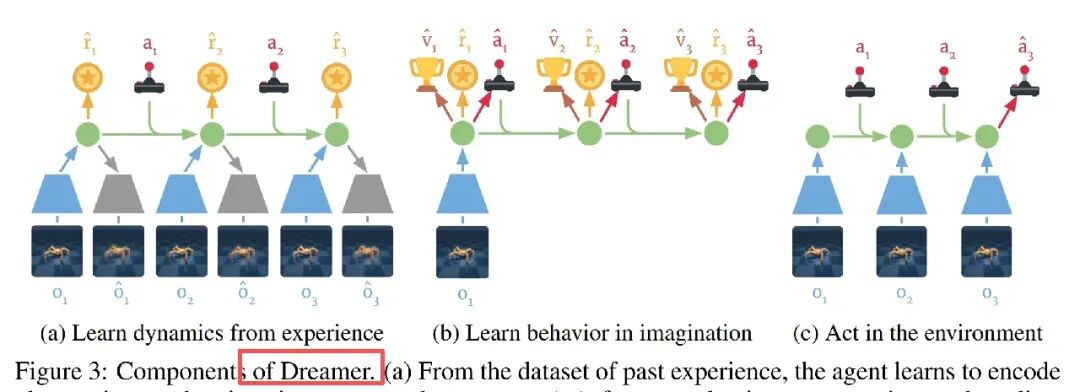
谷歌:Dream to Control, https://arxiv.org/pdf/1912.01603
这正是基于模型的强化学习(model-based RL)和 World Models 的思想:Dreamer 系列让 agent 在学到的世界模型里“想象”轨迹来改进策略,而不必反复与真实环境交互。
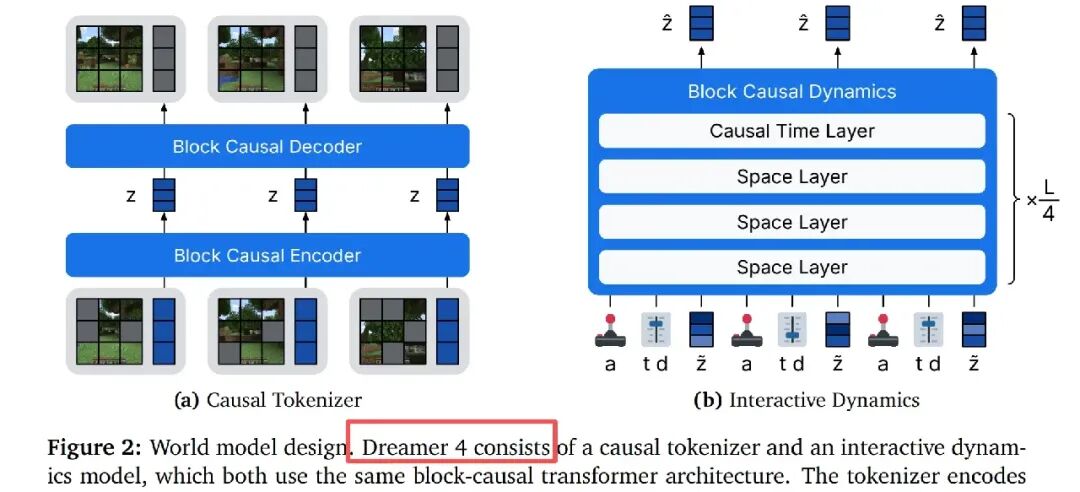
Dreamer 4: https://arxiv.org/pdf/2509.24527
Dream-RSI 的惊人观察是:长程科学发现天然具备同样的结构。
一次完成的发现过程,本身就是一棵结构化的树,完整记录了过去的探索决策和它们真实执行过的结果(代码、评估分数、诊断信息)。
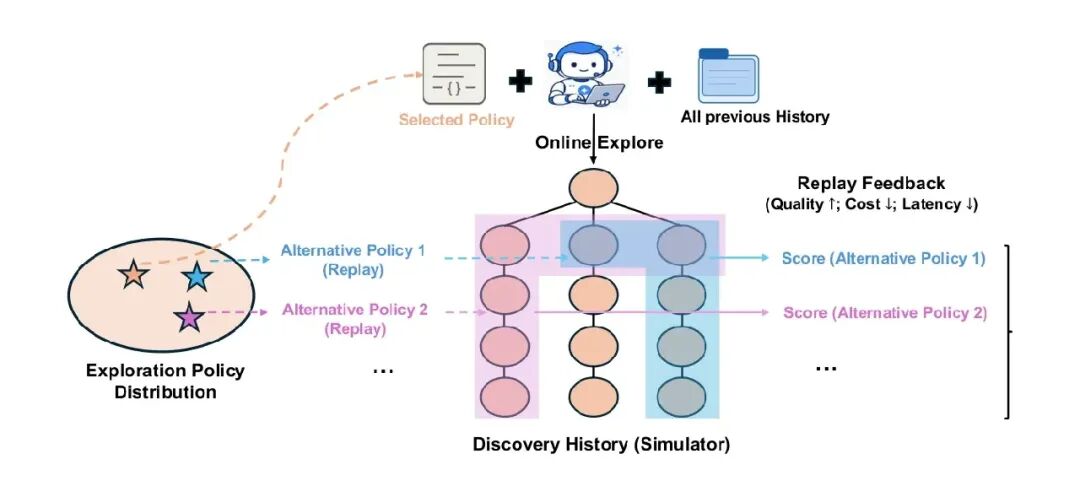
发现历史作为回放模拟器
于是,把这棵树组织起来,它就是一台 回放模拟器(replay simulator,论文中也叫 “worlds”):
- 一个备选探索策略可以在这棵已记录的树上“重走”——选不同的分支子集、换不同的顺序、用不同的并行分组、在不同位置停下;
- 因为所有节点的执行结果早已存在,评估新策略只需要“读取记录”,完全不用重跑 coding agent 和评估器;
- 一次昂贵的在线发现 run,就能支撑成千上万次零执行成本的离策略(off-policy)评估。
三、Dream-RSI 的三阶段递归循环
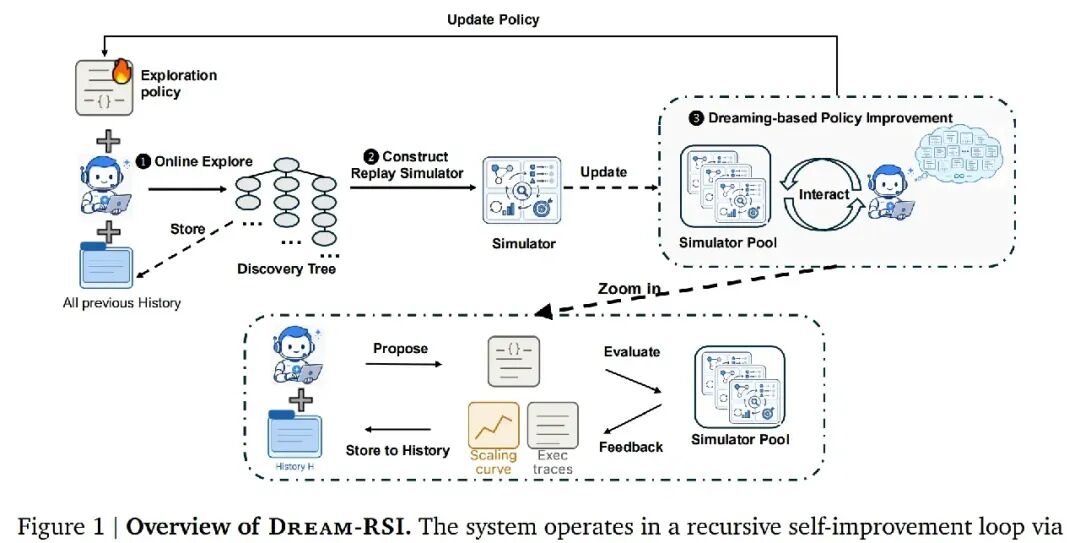
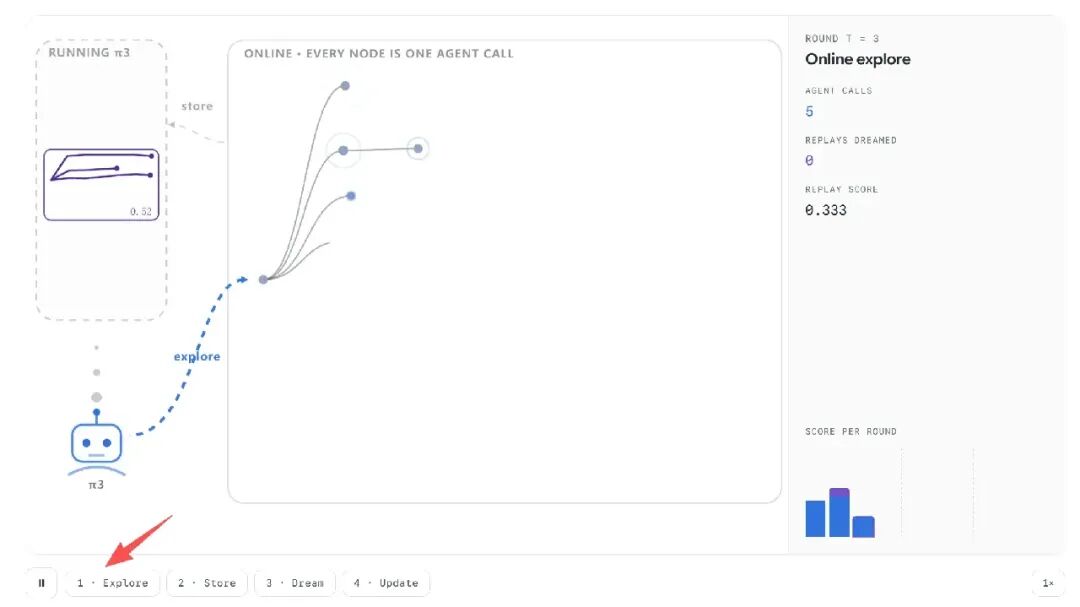
(1) 在线探索(Online Explore):当前策略引导一轮真实发现,策略代码在本轮内固定,跑出一棵新发现树,追加到历史。
(2) 构建回放模拟器(Construct Replay Simulator):历史中每棵树都成为一个“回放世界”。回放时,策略从只有根节点开始,每一步选一个批次,系统确定性地揭示所选节点已记录的子节点——不重跑,只翻记录。每条分支只能按记录中的父子顺序遍历,不会产生超出历史的结果。
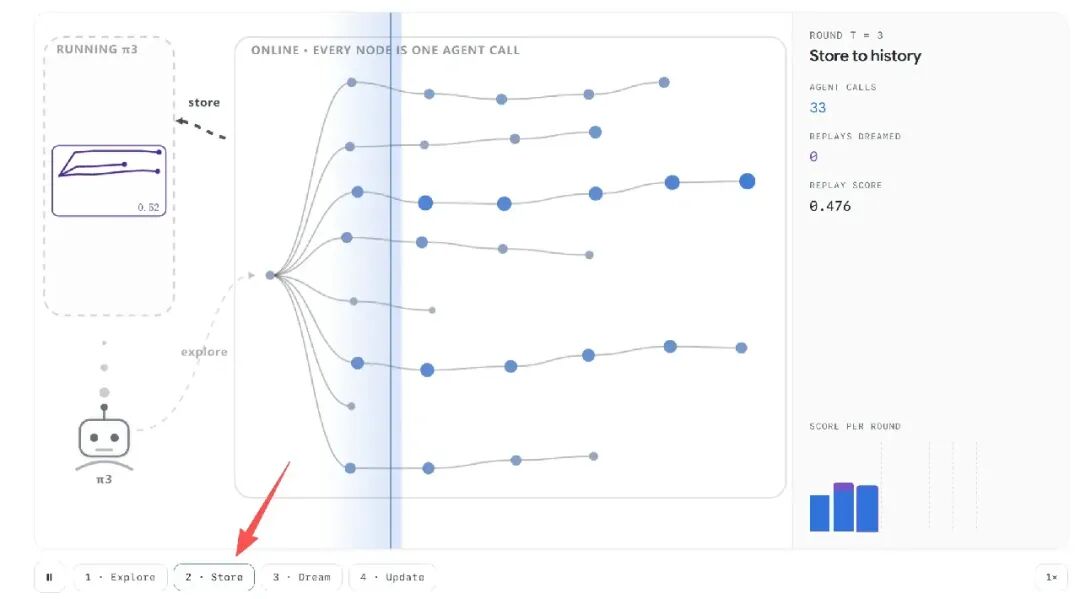
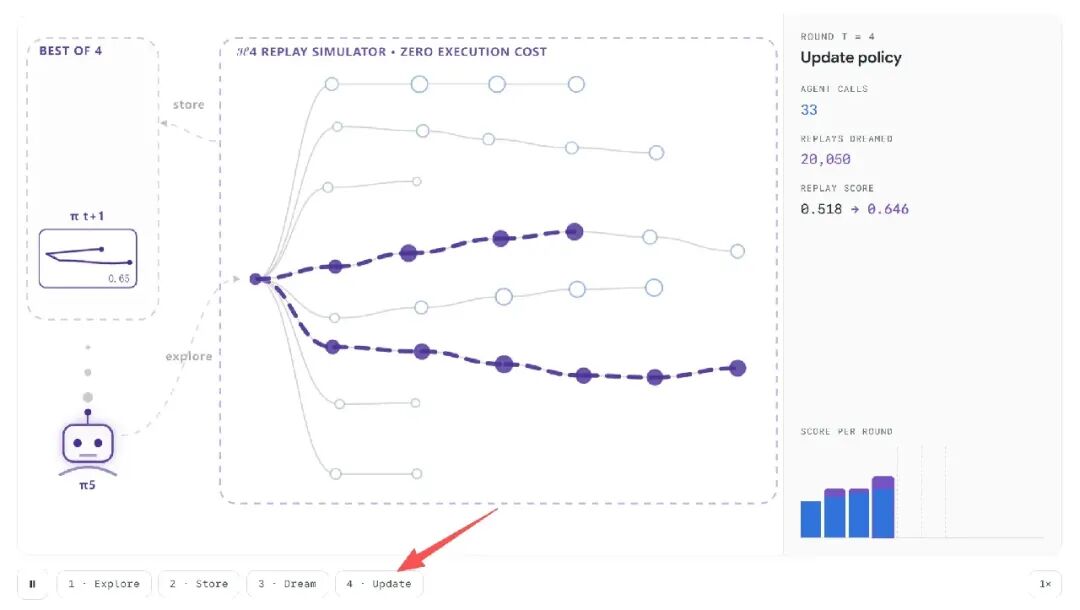
(3) 基于做梦的策略改进(Dreaming-based Policy Improvement):离线阶段开发多个策略版本,每个版本都在所有历史树上回放评估。回放打分函数平衡三件事:
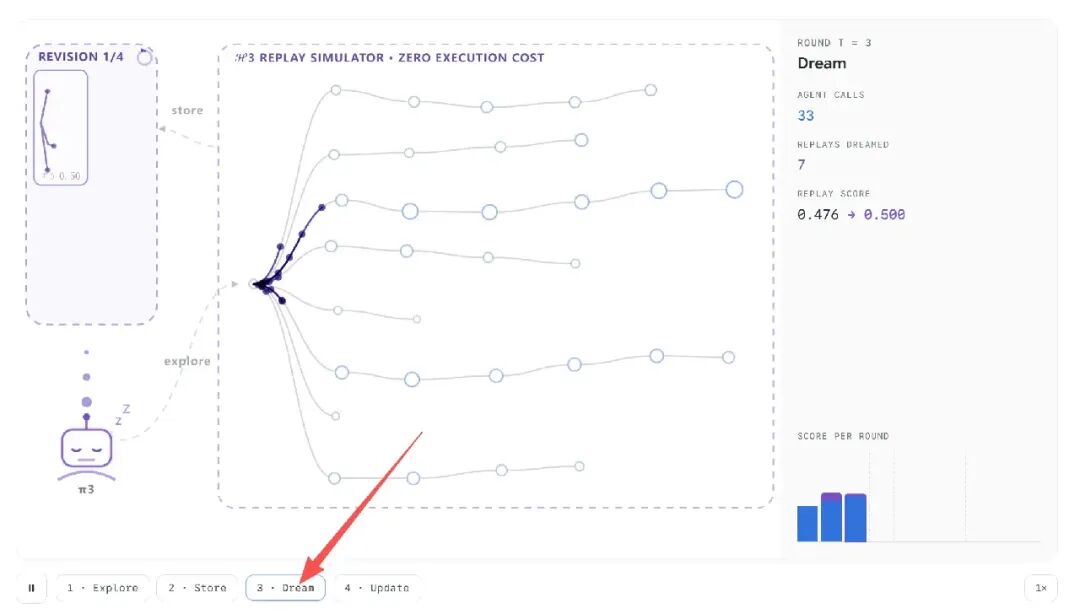
即:找到的最好解有多好、揭示了多少节点(对应真实执行时的调用次数)、平均每决策轮塞进了多少并行尝试(奖励会把有用尝试打包而不是串行的策略)。
四、实验一:算法工程——Lasso 正则化路径求解器
任务:为高维统计中的基础计算原语 Lasso 正则化路径发现高效实现(广泛用于基因组学、金融等领域的模型选择)。沿用 SimpleTES 的基准设置:17 个覆盖不同维度、稀疏度、特征相关性的合成实例用于发现,另有 6 个留出的下游数据集(生物 + 非生物)检验泛化。
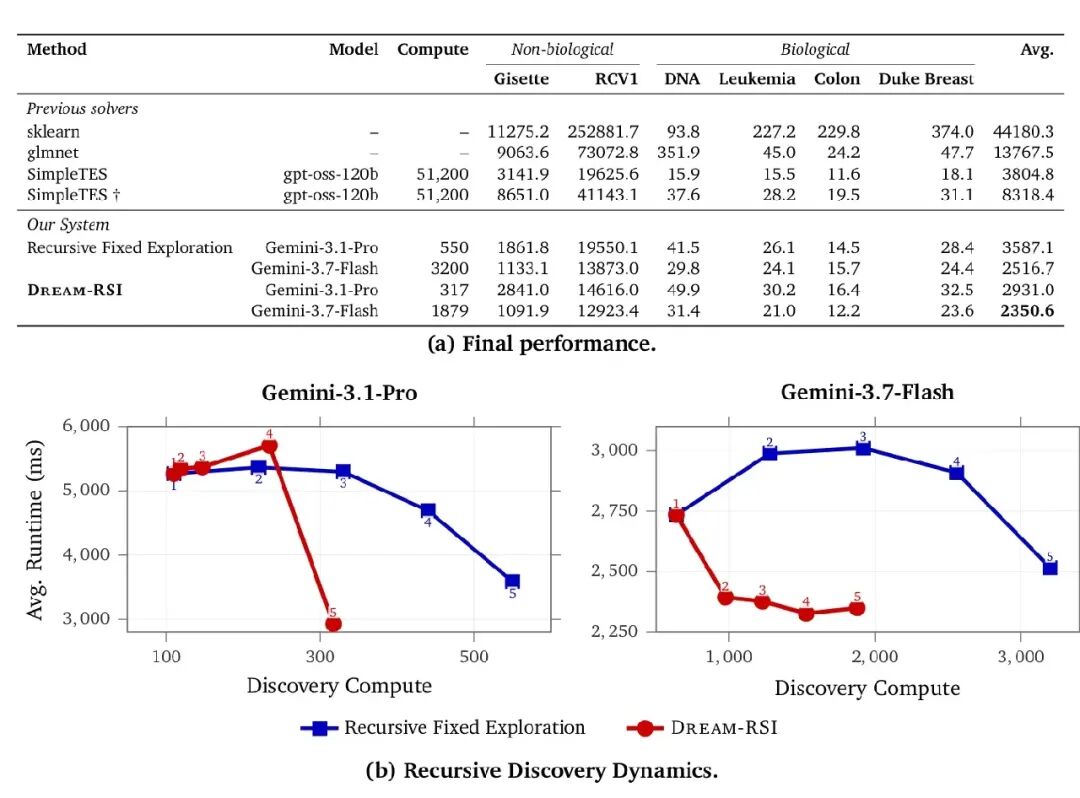
Lasso 正则化路径发现结果
- 相比 SimpleTES:调用次数少约两个数量级(最高 162×),平均运行时间还更低;
- 相比固定探索:质量更好且更便宜(1.7× 省算力),Figure 3(b) 中两条轨迹从第二轮起明显分叉;
- 发现的求解器在全部 6 个留出数据集上都跑赢 sklearn 和 glmnet——不是过拟合搜索分布。
五、实验二:数学优化——三大经典开放问题
任务:三个风格迥异的数学发现任务——Sum–Difference 问题(组合优化)、Circle Packing(几何优化,往单位方块里塞 26/32 个圆,最大化半径和)、Autocorrelation 不等式(泛函优化)。
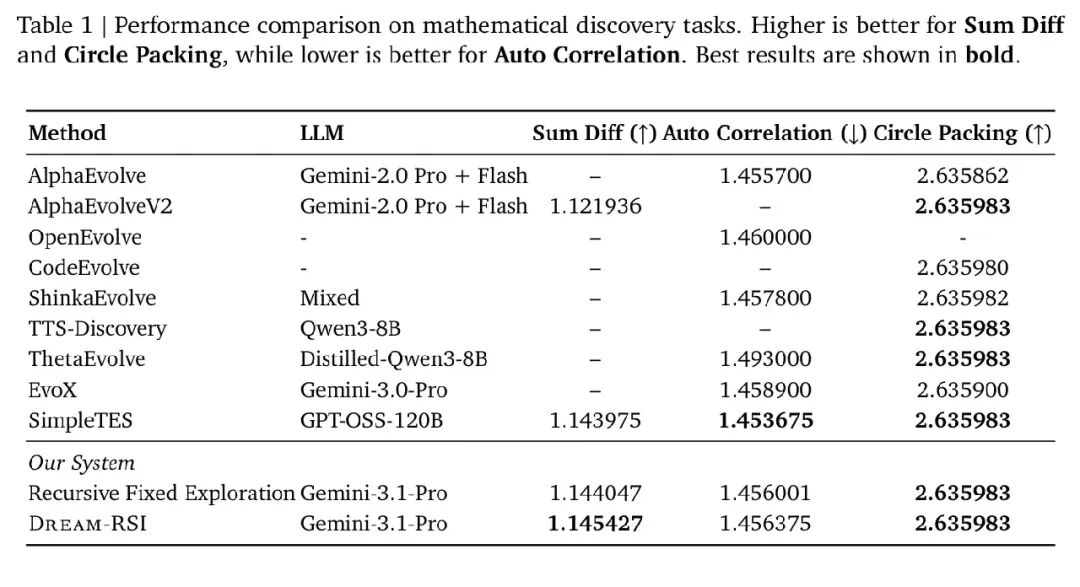
数学发现任务性能对比
- Sum–Difference:1.145427,超过 SimpleTES 和固定探索基线,是表中最佳;
- Circle Packing:2.635983,追平所有对比方法中的最强纪录;
- Autocorrelation:1.456375,保持竞争力(SimpleTES 拿到 SOTA 但用了 51,200 次生成——Dream-RSI 不到 1,000 次,预算节省超 50×)。
六、GPU Kernel 工程——KernelBench
任务:自动发现高性能 GPU kernel 实现(保持数值正确性),需要同时推理算法结构、内存访问、并行化和硬件特性——与数学发现截然不同的测试场。
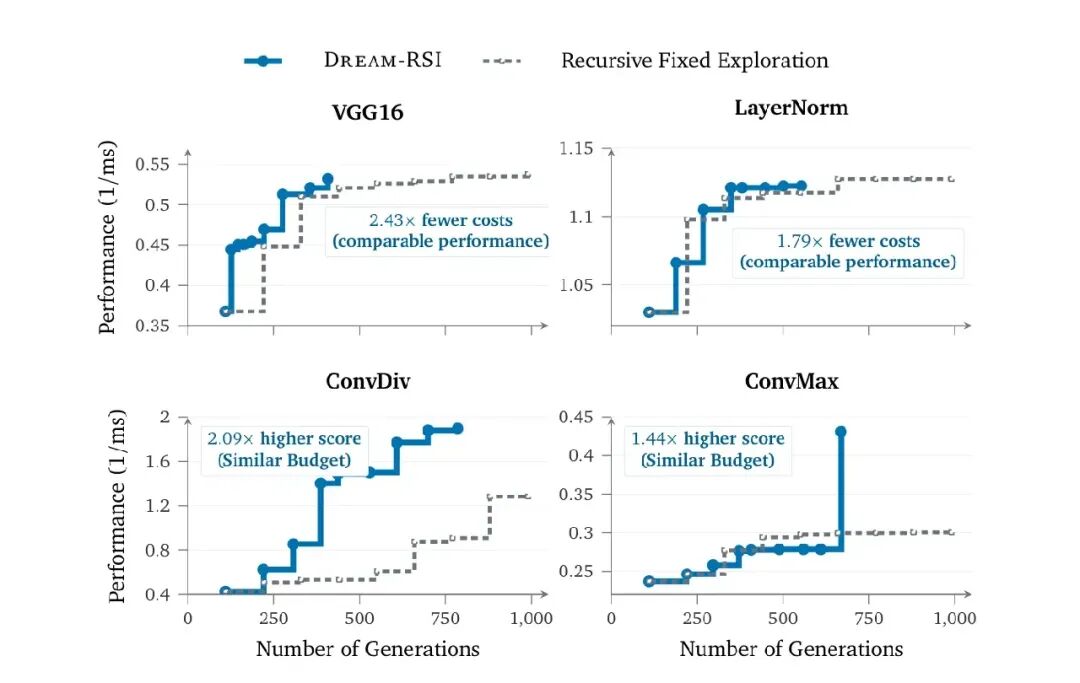
GPU kernel 工程结果
两种赢法,都赢了:
- 同样性能,更少算力:VGG16 上省 2.43×,LayerNorm 上省 1.79× 生成次数;
- 同样预算,更高性能:ConvDiv 高 2.09×,ConvMax 高 1.44×。
七、深入分析:两个有意思的发现
7.1 历史经验,当上下文用不如当模拟器用
一个自然的替代方案是:把历史轨迹抽象成高层“方向性洞察”,直接注入 prompt 作为语义指导。论文把这个方案同时加到固定探索和 Dream-RSI 上做对照:
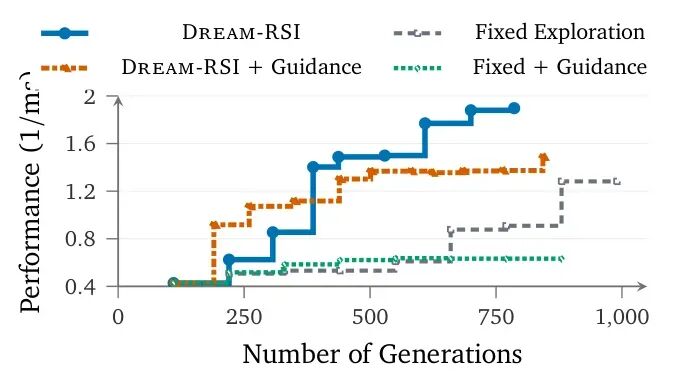
语义指导的对比分析
结果有些反直觉:显式的方向性指导在两种范式下都一致地拖累了表现。论文的解释是:在长程发现中(多条并行线程同时探索),对未来搜索方向强加过强的语义归纳偏置,会过度约束搜索空间、抑制多样探索。把历史当成可以交互推演的“世界”,比把历史浓缩成几句“人生经验”更有用——这是本文一个颇具普适性的洞察。
7.2 策略真的在进化:先省着花,遇到瓶颈再加码
下面这张图展示了学到的探索策略如何随轮次演化,呈现出清晰的自适应模式:性能提升期,策略主动收缩发现算力(评估尝试从 110 降到 50);当进展陷入平台期,它又重新加大探索力度——随后果然迎来新一轮性能增长(E6 之后从 ~1.5 跳到 ~1.9)。策略学会了“该省省、该花花”,这正是元层自我改进想要的行为。
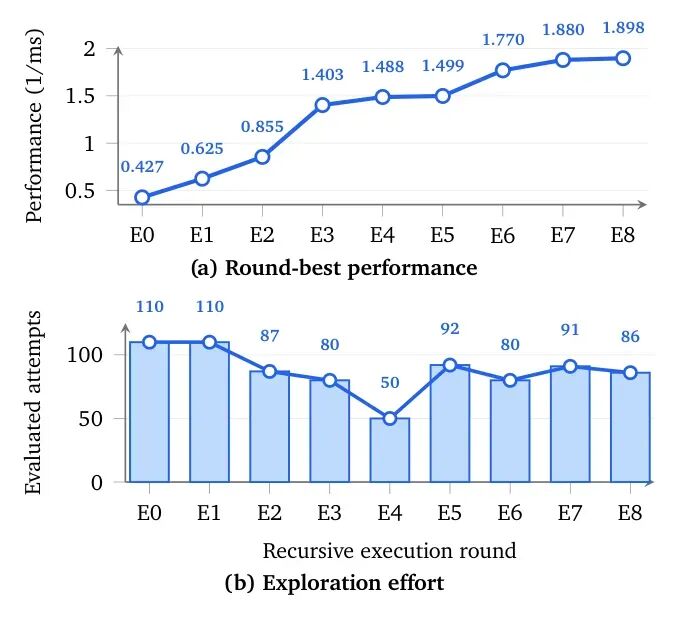
探索行为的进化
最后
项目已开源,GitHub 仓库如下:
Dream-RSI 的贡献可以浓缩为一句话:把发现历史从静态上下文升级为可交互的回放世界,从而让探索策略的递归自我改进第一次变得廉价且闭环。
Dream-RSI: Recursive Self-Improvement through Evolving Worlds
https://arxiv.org/pdf/2609.14858v1
https://github.com/zhengkid/Dream-RSI
dream-rsi.com
 发表于 1 小时前
|
查看: 5|
回复: 0


