AI已经强到能解开人类最难的数学题,也能杀光我们。
说这话的,是《华尔街日报》专栏作家 Ben Cohen。9 月 11 日,他写了一篇关于 AI 和数学的专栏,文章标题直白得让人脊背发凉:
AI Is Powerful Enough to Crack Our Hardest Math Problems—and Kill Us All
Cohen 自己坦白不懂纳维-斯托克斯方程,但他认为,哪怕你完全不懂数学,也能明白 OpenAI 这次声称取得的突破到底意味着什么:AI 的进步正在加速,而且这种加速令人恐惧。
一条数学圈的硬核新闻,就此变成了关乎整个人类命运的问题。在云栈社区,开发者和研究者对这类 AI 与人类命运的争论,也从来没有停过。
同一天,陶哲轩等 25 位菲尔兹奖得主联名发布声明:《AI 在数学中的严重失配》(A Severe Misalignment of AI in Mathematics)。
他们口中的「失配」,指的是 AI 公司和数学家想要的东西对不上号:数学家要的是新方法、新理解,AI 公司要的是拿名题给模型刷分。
一边是专栏作家在喊末日,一边是顶级数学家在谈失配。如果你把这一周的事情排在一起看,就能理解他们为什么坐不住了:
- 9 月 3 日,GPT-6 Astra 发布,在 FrontierMath Tier 4 拿到 97.6%
- 9 月 5 日,OpenAI 一个尚未发布的内部模型,在首批 Agent 启动约 88 小时后,得到纳维-斯托克斯问题的一套解法
- 9 月 8 日,OpenAI 公开结果,当天就被 NYU 数学家指控抢跑,还闹出了「不让 Anthropic 员工上论文」的署名争议
- 9 月 10 日,Epoch AI 宣布 FrontierMath Tier 4 已经饱和
- 9 月 11 日,25 位菲尔兹奖得主联名发声。当晚,《华尔街日报》把数学突破和 AI 灭绝风险放进了同一个标题
七天,五件事,全部指向同一个缺口:AI 创造知识的速度、人类确认知识的速度与规则调整的速度,正在严重脱节。
14 个月,AI 击穿最难数学基准
FrontierMath Tier 4,这是一组由 Epoch AI 设计、专门测试最强模型的研究级数学题。
这里的题目极其变态,有些题目即使是顶尖研究者也得花上几天才能解开。2025 年 7 月 Tier 4 刚上线时,最强模型只能做出 5% 左右,基本等于交白卷。
可不到 14 个月,Epoch 宣布:每一道 Tier 4 题,都至少被 AI 解出过一次。其中,最后一题由 GPT-6 Astra 拿下,出题人是数学家 Jay Pantone。
Epoch 还特意提到:过去数学家经常抱怨模型靠「意外捷径」绕过自己精心设计的题,但最后这一道,没走捷径。
随后,Epoch 甩出一个冷酷结论:这个基准已经饱和。
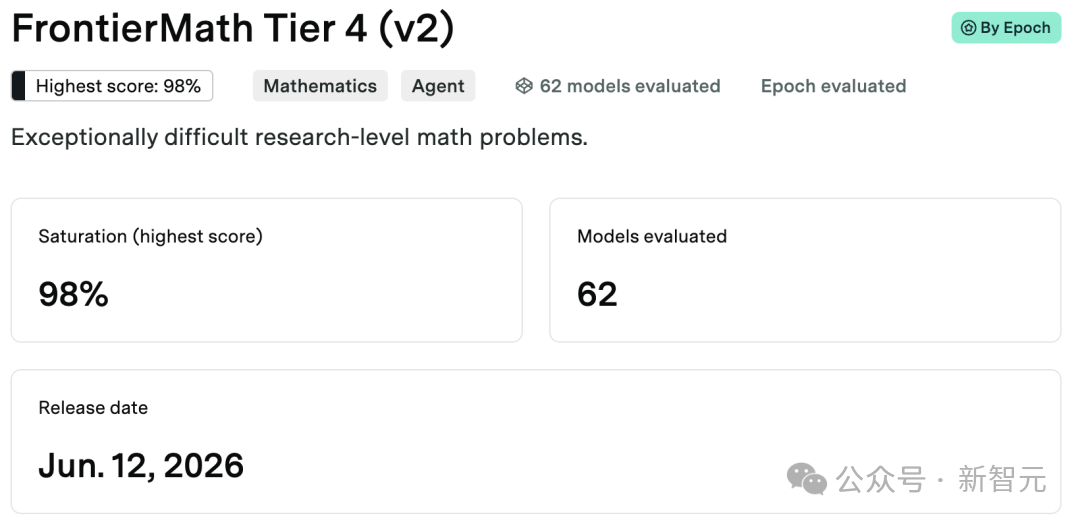
考卷已经追不上考生了,该换卷了。Epoch 也已经把战场向真正的开放问题转移,AI 评测体系开始转向人类自己也不知道答案的盲区。
AI 能力增长的速度,已经跑赢了我们测量它的方法。正如 Epoch 的 Greg Burnham 所感叹的:一个时代落幕,另一个时代开启。
88 小时,AI 第一次像个研究所那样运转
如果说 FrontierMath 证明的是「基准开始追不上模型」,那么纳维-斯托克斯事件展示的,是一幅更具颠覆性的画面:AI 不只是会做题,它已经开始像一个庞大的科研组织那样运转了。
这根本不是一次单打独斗,而是一场由一万个智能体协作的「大兵团作战」。它们被分成不同的小组,有的证明,有的证伪,彼此通信、共享中间结论,甚至在中途无缝切换最新版本的模型。
首批 Agent 启动约 88 小时后,其中一个组交出了一份长达百页的最终证明。
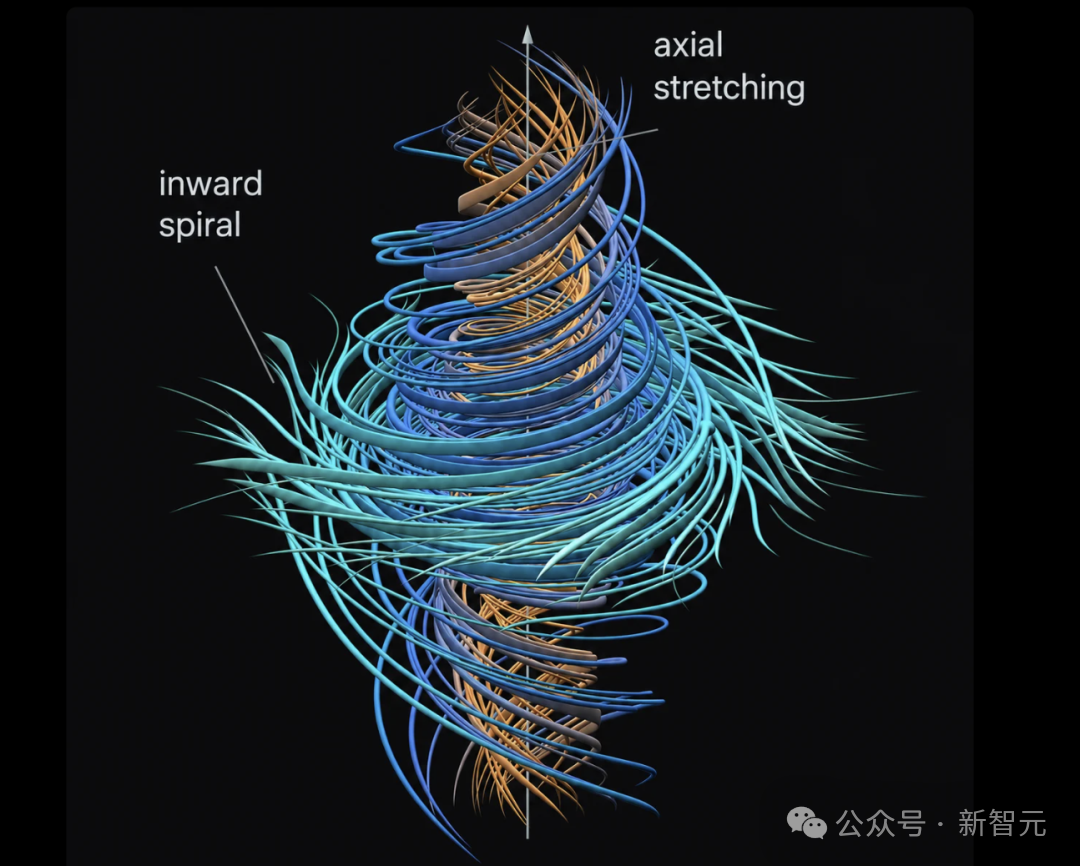
OpenAI 公布的纳维-斯托克斯奇点机制示意:流体向内螺旋(inward spiral)、沿轴拉伸(axial stretching),橙色为高速旋转区,青色为低速区。涡心越缩越快,速度无界而总能量有限。
这一整个流程,完美复刻了人类顶尖科研机构的运作模式。
机器狂奔 88 小时,人类确认却要以年计
在人类世界里,纳维-斯托克斯的状态依然是「未解决」。
按千禧年奖的规则,一个解答先要在合格渠道发表,发表后至少等两年,并获得全球数学共同体的普遍接受,Clay 才会启动正式审议。Clay 主席 Martin Bridson 对 AFP 说,评估过程「刻意不急」,而且必须「绝对严格」。OpenAI 自己也说了,不打算申领这 100 万美元。
因此,这件事最准确的说法是:OpenAI 公布了一套千禧年难题的解法,声称已完成 Lean 形式化验证,但尚未得到数学共同体的独立确认。
机器生成结果,88 小时;人类确认结果,至少两年。这恐怕是本周 AI 数学最刺目的一组反差。
问题不在人类验证太慢。问题在于,机器把「发现」加速了几百倍,人类的「理解」并没有跟着加速。当机器开始以「几天一个重大结果」的节奏批量生产知识,之后几年甚至几十年的阅读、检查、解释、简化和吸收,谁来做?
署名制度最先撞墙
纳维-斯托克斯结果公开的当天,数学圈炸锅了。
NYU 数学家 Tristan Buckmaster 和在 Anthropic 任职的 Levent Alpöge,整个 8 月其实也一直在研究相关的流体方程。按照《纽约时报》的还原,这两人的工作方式是这样的:Buckmaster 提出问题,Alpöge 把问题丢给 Anthropic 内部模型;模型生成结果之后,两人再根据输出调整问题,继续往回喂数据。
按照 Buckmaster 的说法,事后 OpenAI 提出过多个安抚方案:允许他先发布自己的结果、让他成为 OpenAI 论文的第一作者、提供算力让他继续研究。但最大的障碍是:OpenAI 不想让 Levent 出现在论文上。
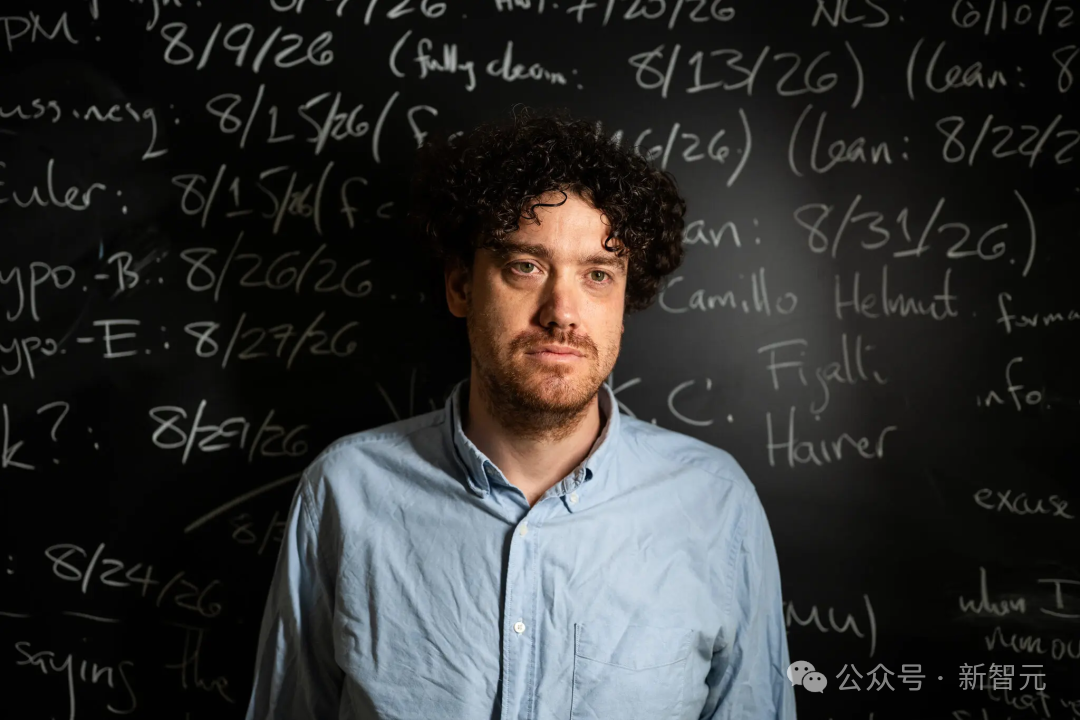
黑板上是 Buckmaster 和 Alpöge 整个 8 月的进展时间线:欧拉方程 8 月 15 日、Lean 形式化 8 月 22 日、8 月 31 日……还有 Figalli、Hairer 等同行的名字。
在商言商,一个 OpenAI 投入重金的内部项目,凭什么要署上竞争对手 Anthropic 员工的名字?
随后,事情又延伸到了另一个更敏感的话题。Buckmaster 过去数月一直在使用 Codex 整理 AI 生成的数学草稿,那么他输入 Codex 但尚未公开的独家科研思路,有没有可能通过隐秘的数据管线,成为了 OpenAI 自己研究模型的养料?
Buckmaster 自己承认没有证据,但在他看来,事件的时间线和 OpenAI 的证明路线,都在暗示着这一点。OpenAI 则在 9 月 10 日紧急更新公告称,经内部彻查,Buckmaster 过去两个月的 Codex 提示词绝对不可能通过训练或其他任何方式影响这套内部模型。
谁对谁错,这里暂时成了一笔糊涂账,但它真正暴露出来的,是一整组过去从来没人认真回答过的问题:
- 一个人的私有提示词到底算不算受保护的科研资料?
- 企业内部的砸钱研究项目能不能署竞争对手公司员工的名字?
- 如果模型参考过海量的公开资料,又该怎样界定新的贡献与既有工作的边界?
普林斯顿高等研究院的 Peter Sarnak 对《纽约时报》说:「这种讨价还价,我这辈子没听说过。」
数学界几百年沉淀下来的学术规则,从来没有为这种狂暴的机器生产速度设计过防撞带。
25 位菲尔兹奖得主真正担心的事
就在一天后,25 位菲尔兹奖得主联合扔出了一份重磅声明。陶哲轩、Peter Scholze、James Maynard、Maryna Viazovska……数学圈最顶尖的大脑几乎全员出动。
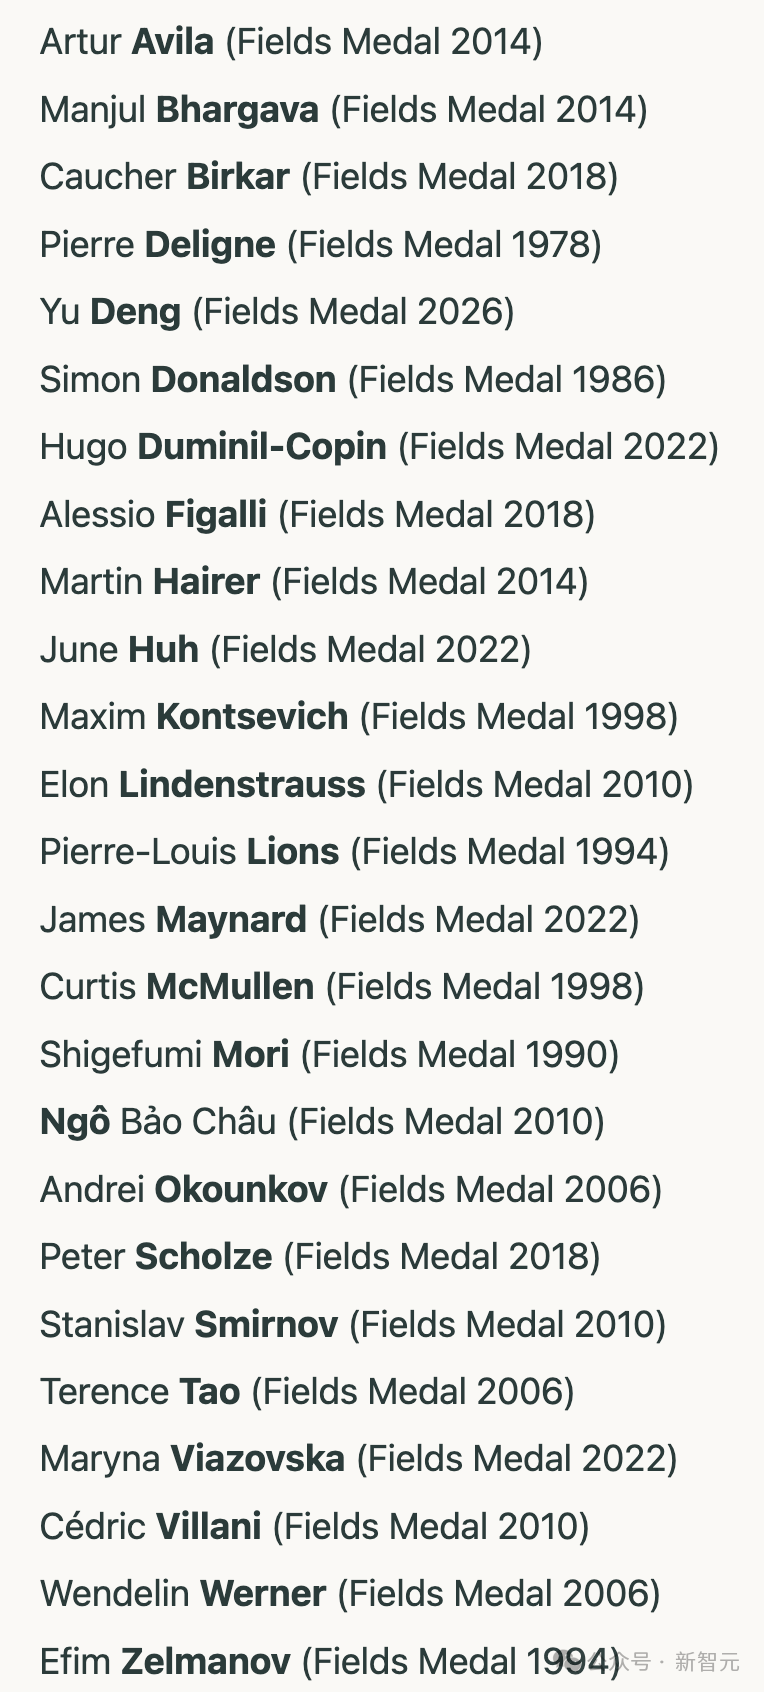
这份声明,并非什么「反 AI 檄文」。事实上,陶哲轩本人一直都在极其积极地尝试用 AI 辅助数学研究,声明也承认 AI 确实有潜力加速真正的数学理解。
他们真正深恶痛绝的是将「解题」直接等同于数学。在当下狂热的 AI 圈,AI 公司为了股价和宣发,正在急功近利地把「解掉名题」当成最高优化目标。在他们眼里,千禧年大奖难题似乎只是用来证明模型有多牛的跑分工具。
但数学真正宝贵的地方,恰恰是在枯燥的解题过程中诞生新方法和新概念,最终沉淀成人类的共同知识体系。现在 AI 公司隔三差五就甩出一个震撼结果,快到没人来得及消化。这条传了几千年的链条,随时可能断掉。
联名信还特别点出:结果发得太快,这些解答根本来不及清楚区分哪些是新想法、哪些是踩着前人的肩膀,势必带来严重的署名与归属混乱。
为什么一个数学突破会和「末日警告」挂上钩?
普通人真正关心的,不是「AI 超过了数学家」,而是机器创造知识的速度,第一次以碾压姿态,快过了人类确认、归属、消化知识的速度。
这并非危言耸听。GPT-6 Astra 系统卡写明,它是 OpenAI 第一个达到网络安全「Critical」阈值的模型,在 ExploitBench 上拿了 100%。解千禧年难题的组织能力、零日漏洞的攻击能力、更难被看清的推理,三样东西在同一个模型身上同时具备。
OpenAI 在纳维-斯托克斯公告的最后一段,还有一句话:
接下来他们要先把这个新模型摸透,再决定往前冲多快,可能需要对进展速度做更审慎的选择。
是的,刚交出千禧年难题答卷的 AI 公司,主动谈起了减速。
Cohen 还在专栏末尾提到了一件事。上个月,OpenAI 把一批顶尖数学家请到旧金山办公室开闭门会,假设 AI 终将在数学上超越人类,然后大家再来讨论教育怎么办、科研合作怎么办、论文发表怎么办、下一代数学家还怎么培养。
谈了一天,没有答案。
这道题,也没法打包交给 Lean 去自动验证。
只能人类自己解。
参考资料:
 发表于 4 天前
|
查看: 9|
回复: 0


