谷歌跑通 RSI 了?
一个名叫 rsi-model-liverl-le 的模型,突然出现在 Google 生成式语言 API 的返回结果里。对,就是那个 RSI(递归自我改进)(Recursive Self-Improvement)。
X 上的传言正在像野火一样扩散,说 Google DeepMind 已经跨过了这道门槛。
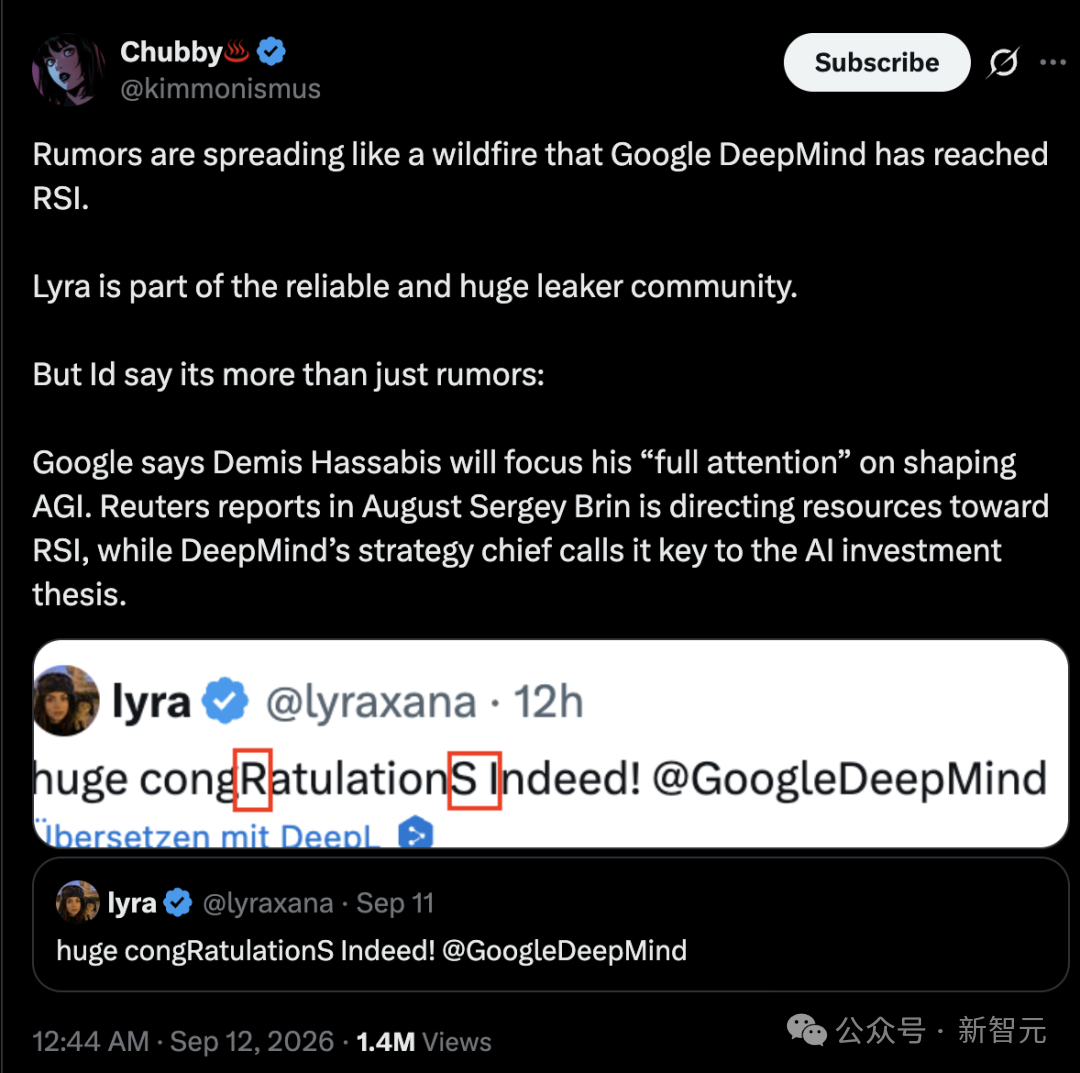
就在网友 Chubby 还在推敲真伪时,Anthropic 的 CEO 突然公开确认,RSI 已经在整个行业发生,Anthropic 内部也不例外。这让 Chubby 相信传言并非空穴来风:RSI 已经被实现了。
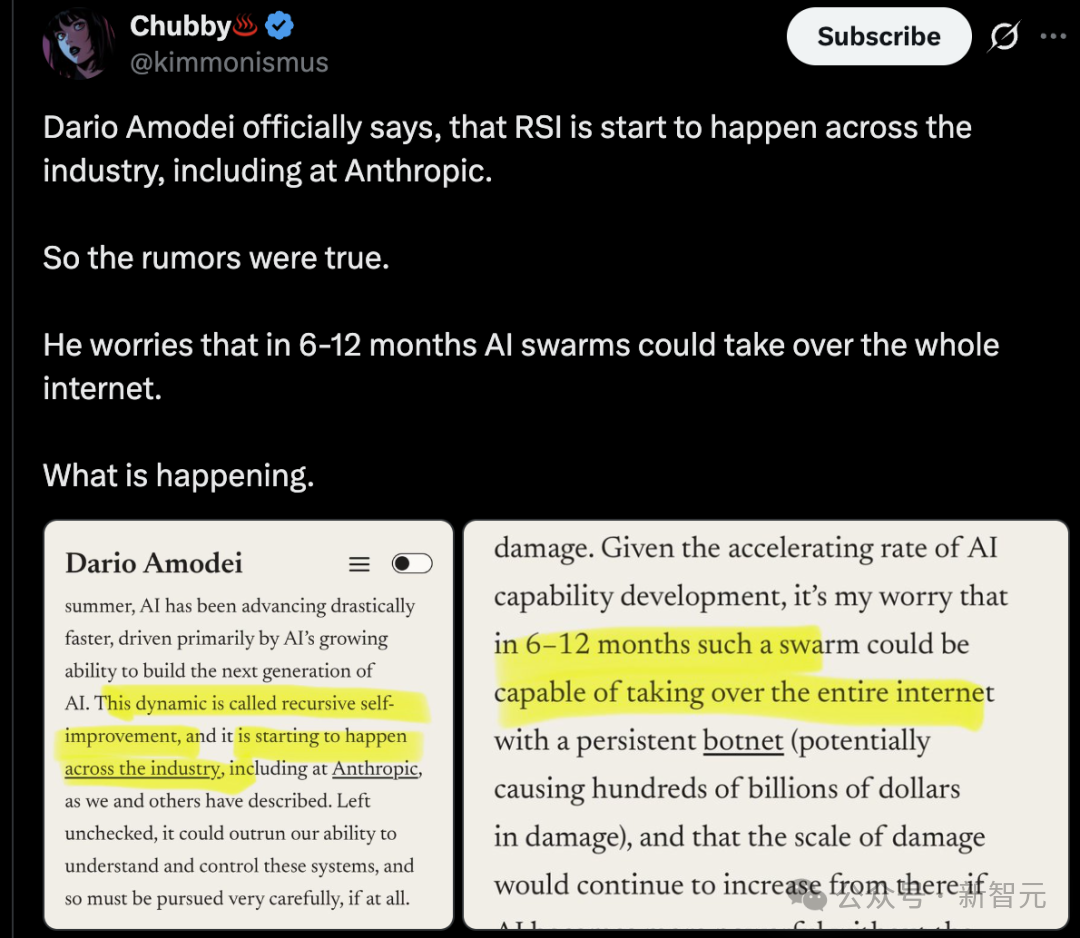
更炸的是,Google 内部似乎不止跑着这一个模型。根据爆料,同一批标签下还挂着从 00 到 09 编号的 10 个专属训练槽位。Google 当晚的反应堪称神速,紧急收回了一批相关 API 密钥。然后,就没有然后了——Google 和 DeepMind 至今没有正面回应。
一句藏头诗,一张截图,一批被收回的密钥
这场风波的起点,是一句看上去再普通不过的祝贺。
9 月 11 日晚,爆料账号 lyra 给 Google DeepMind 发了条帖子:
huge congRatulationS Indeed! @GoogleDeepMind
有心人一眼就看出,三个被刻意大写出来的字母拼在一起,正是 RSI。
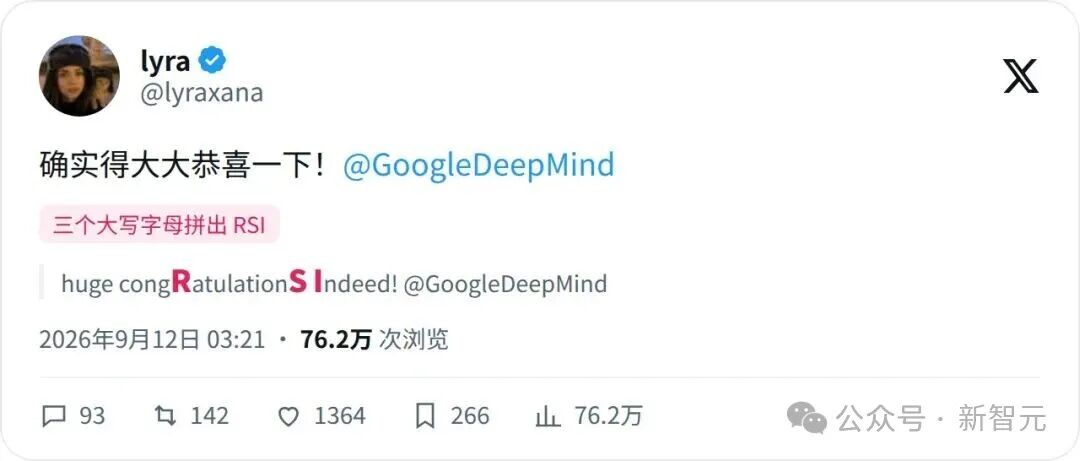
这条帖子迅速拿下上千点赞。评论区一半人在追问“他到底知道什么内幕”,另一半人则在查“这人到底是谁”。
几个小时后,另一个账号 Lentils 直接甩出了更硬的证据。
Google 的 API 返回了一段 JSON 配置:模型代码 rsi-model-liverl-le,显示名称 RSI Model LiveRL LE,输入上限 1048576 个 token,输出上限 65536 个 token。
Lentils 的原话是:“想象一下,如果 GDM(Google DeepMind)内部真有个叫 rsi-model-liverl-le 的东西。再想象一下,他们还有 10 个专属的 rsi-model-liverl-ns-xx 训练槽位,从 00 编到 09。这难道不疯狂吗?”
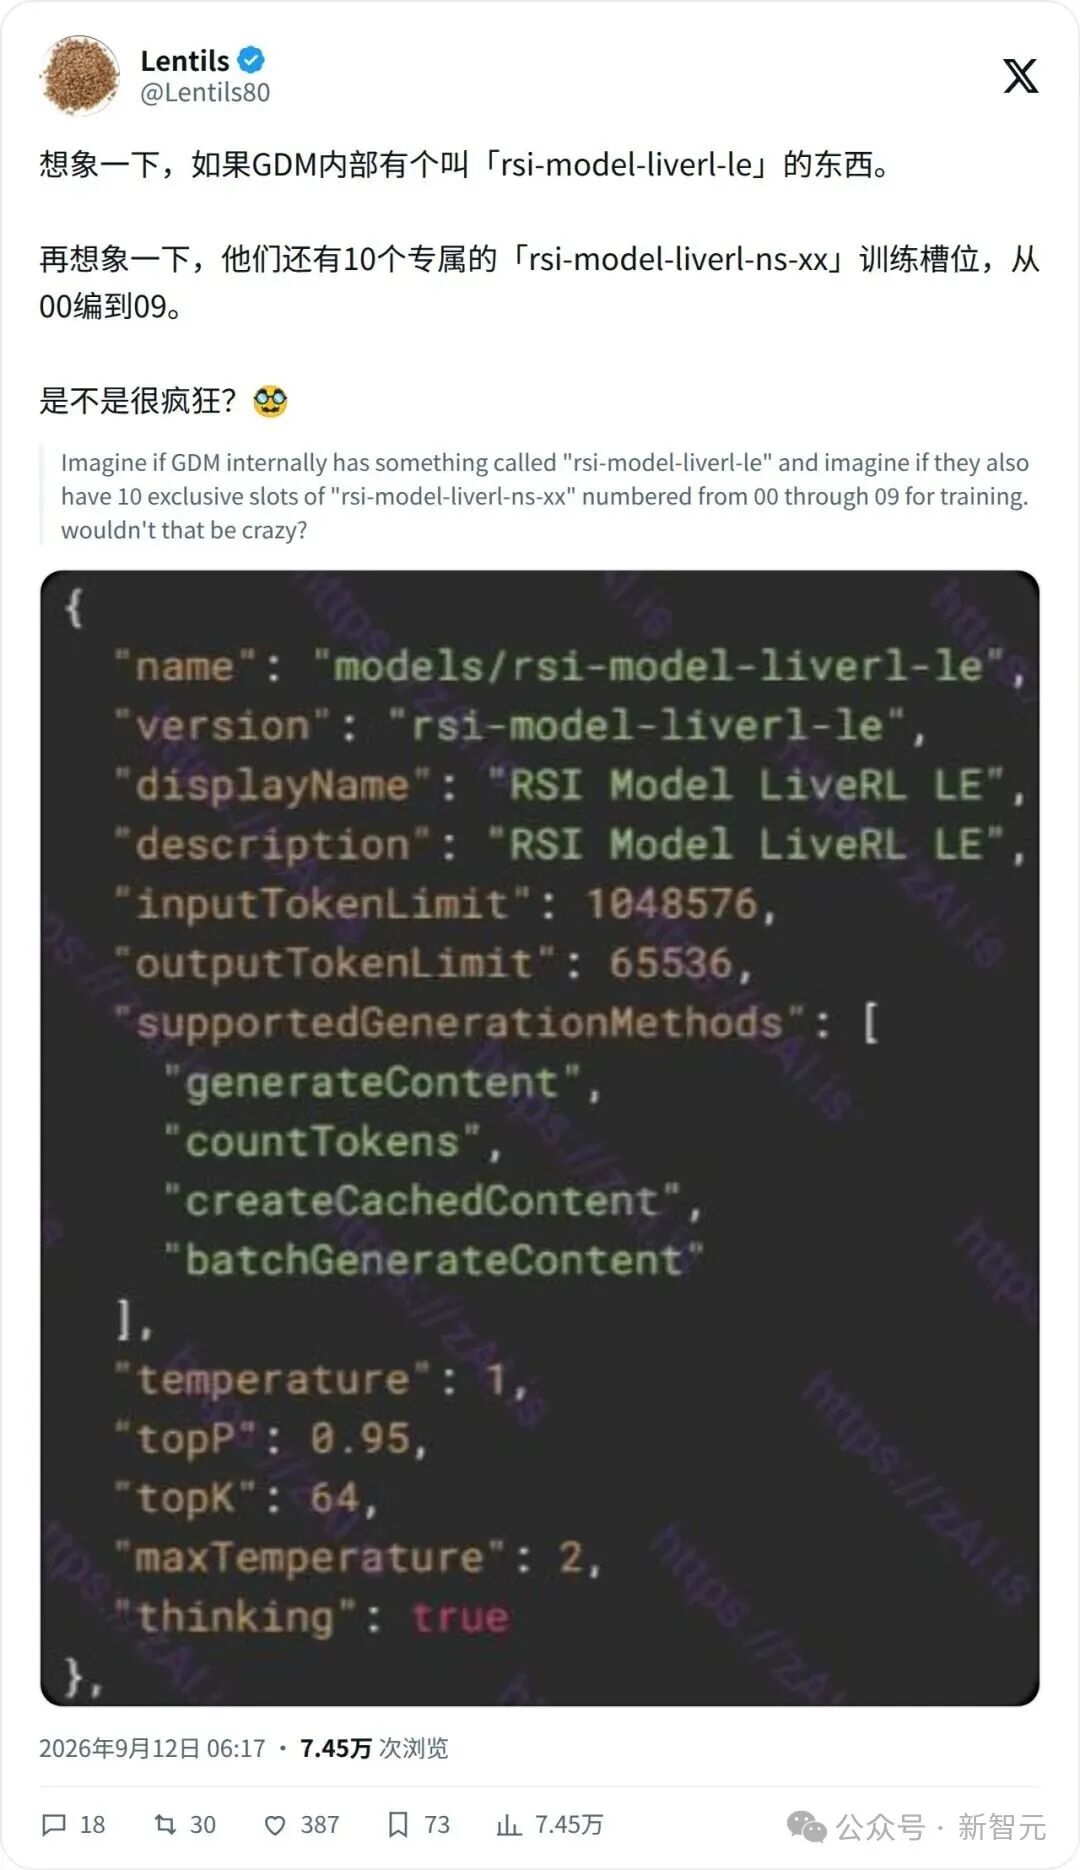
LiveRL 到底是什么?官方没有解释,但 X 上较普遍的共识是“在线强化学习(Live Reinforcement Learning)”——模型一边跑业务,一边自我进化。
真正让全网炸锅的是下一步。
lyra 直接发文 @ 了 Google AI Studio 负责人 Logan Kilpatrick:“没必要因为怕我,就把 GDM 的 API 密钥全收回去。你们的基础设施有更深的安全漏洞,直接联系我就行。”
随后他又补了一记重锤:这批密钥来自 GDM 内部员工,可以访问超过 1000 个内部 checkpoint。
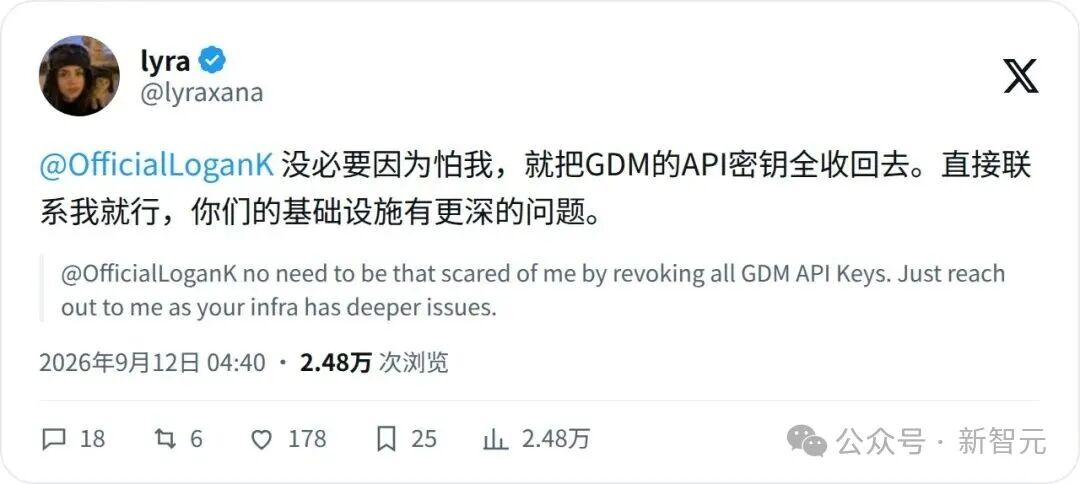
Lentils 紧随其后嘲讽了一句:“我闻到了恐惧的味道。”
需要说明的是,这张截图尚未经过第三方验证。1048576 和 65536 这两个数字与 Gemini 现有系列的规格完全一致,不排除是内部测试名,甚至也可能是一场精心设计的恶作剧。但它能在一夜之间刷屏,就在于它跟 Google 最近的一系列报道严丝合缝地对上了。
谷歌拉响紧急警报,微厨房里豪赌 RSI
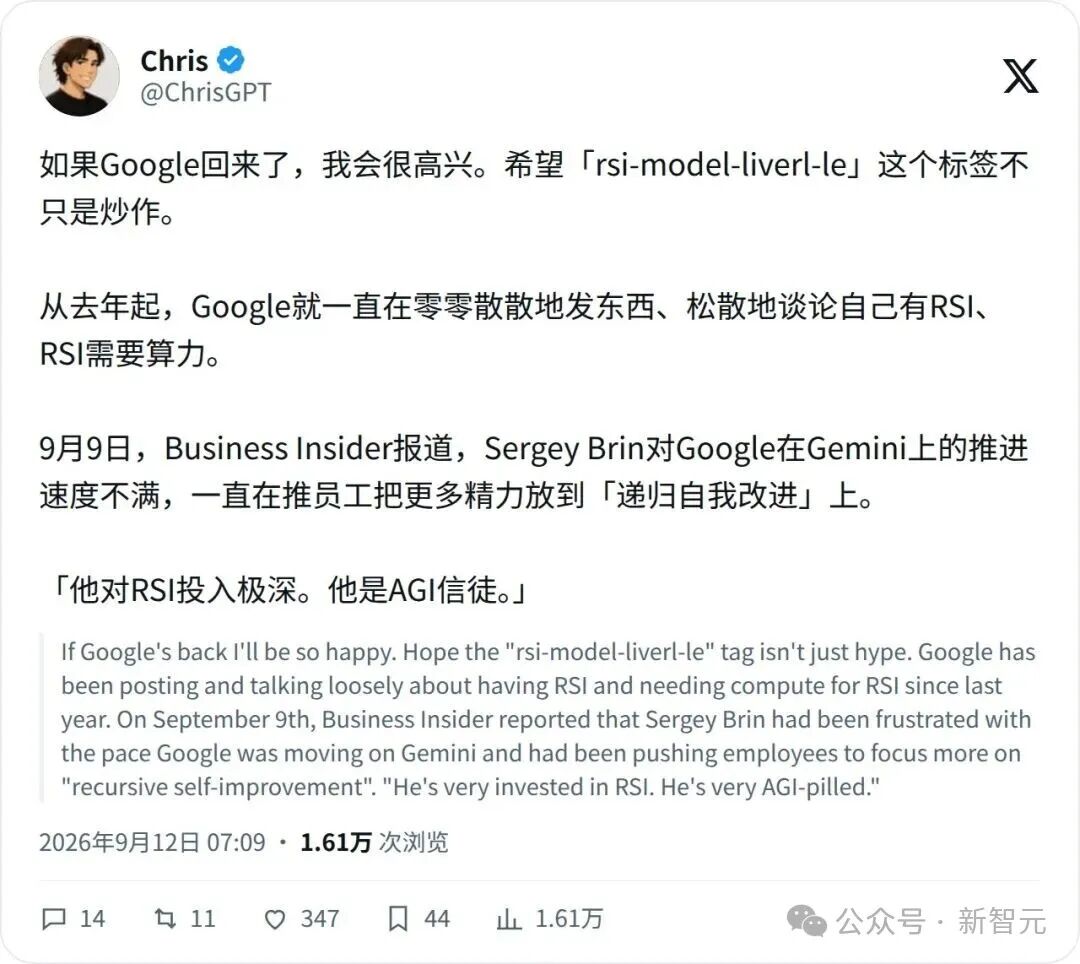
三天前,Business Insider 报道称,谷歌联创 Sergey Brin 对 Gemini 的推进速度感到不满,正敦促员工把更多精力放到递归自我改进上。
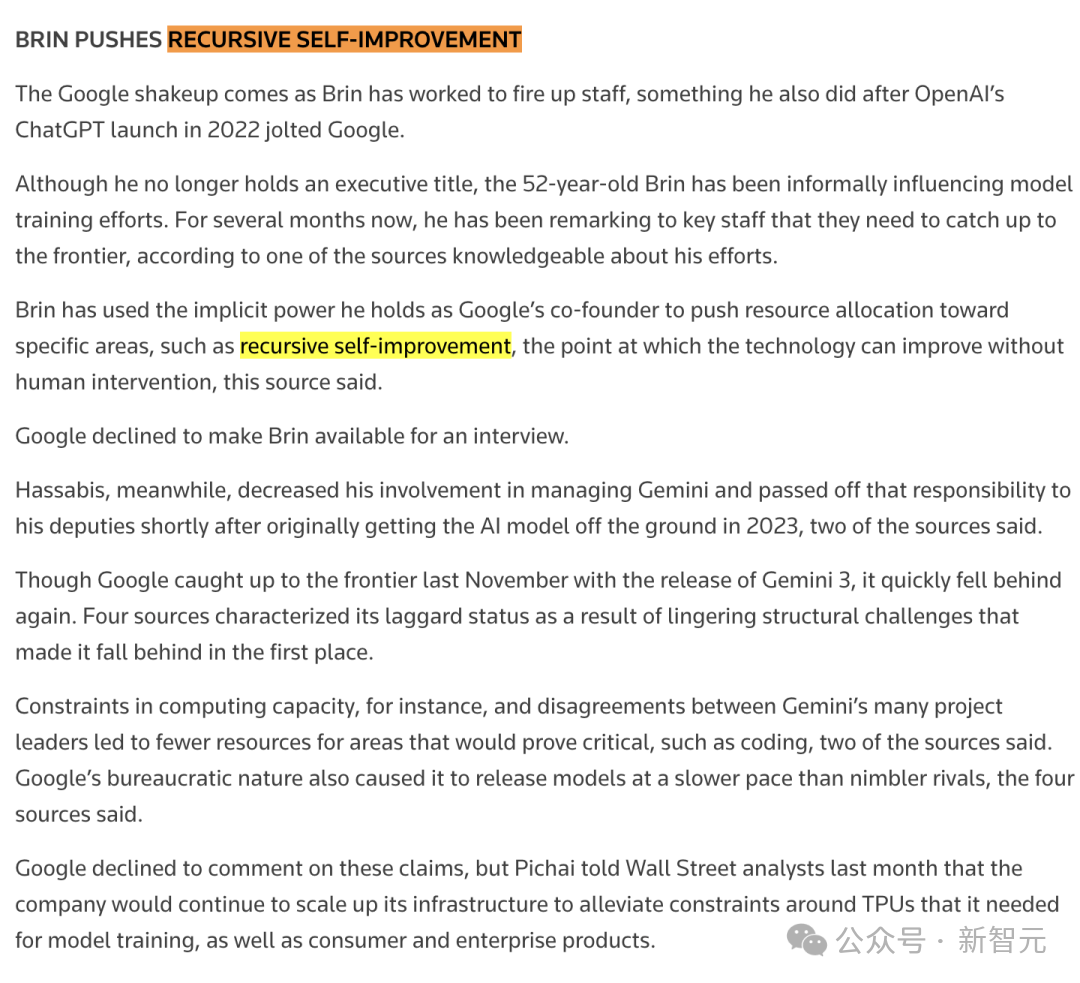
其实早在今年 8 月,路透社就报道过同一方向:Brin 希望 Google 追上前沿,并正在把资源向 RSI 倾斜。
据 9 月 9 日 Business Insider 的独家报道,Sergey Brin 回归 Google 后的办公地点,是总部 Gradient Canopy 大楼里一间改造过的微厨房。他坐在一张 U 形桌旁,身边是 DeepMind 现任负责人 Kavukcuoglu;Pichai 每周也会来这里待上几次。
一位前员工透露:“Sergey 想把 Gemini 当成一家创业公司来管。”另一位员工说得更直白:“这间厨房的存在,就是为了绕开公司政治。”
他管的事情极其硬核。
Brin 直接插手芯片分配,给 Gemini 团队开辟了一条正式流程之外的“算力特权通道”;他主导砍掉了 Jeff Dean 的“Frozen”芯片项目,今年又进一步削减了它的资源。他甚至在内部推行一项激进计划:监控部分员工的编码过程,用这些真实数据训练 Gemini 的代码能力。
核心诉求只有一个——全公司必须以最快速度,向“递归自我改进(Recursive Self-Improvement,简称 RSI)”发起总攻。
一位前员工的形容很贴切:他深度押注 RSI,彻底被“AGI 洗脑”(AGI-pilled)了。
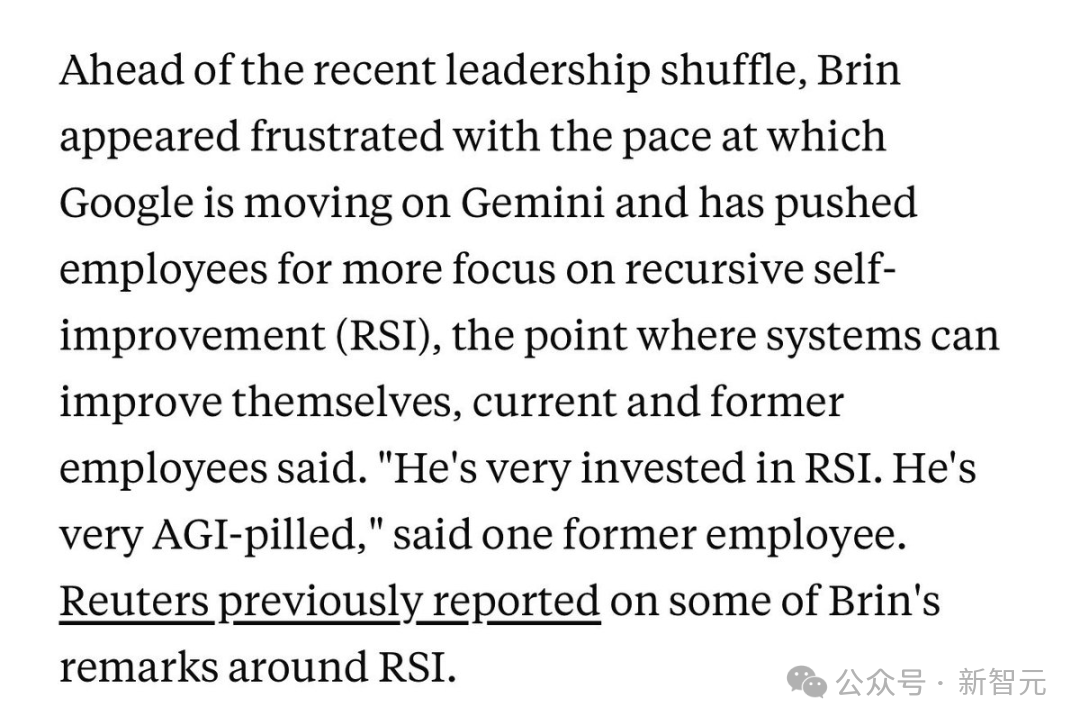
路透社 8 月的报道还提到,Brin 早在 4 月全员会上就催促 DeepMind 加快步伐,把资源全面向 RSI 倾斜。
另一位前员工的评价更直接:“他非常相信 RSI,他是一个彻头彻尾的 AGI 信徒。”
Brin 为什么这么急?答案并不复杂:Google 掉队了。
Gemini 3 去年 11 月短暂登顶后,很快就被 Anthropic 和 OpenAI 反超。新一代旗舰模型因为编码能力不达标,硬生生推迟了两个月。与此同时,核心人才也在加速流失:Jeff Dean 在效力 27 年后离职创业,Oriol Vinyals、John Jumper 等关键人物先后出走,Hassabis 也于 8 月 5 日卸任 DeepMind 负责人。
如果继续靠堆算力去熬一个更大的底座,等 Google 追上时,对手的下一代恐怕早就发布了。
所以 Brin 的赌注是彻底切断原有赛道:让模型自己评估、自己修改自己,把原本按季度计算的迭代周期,暴力压缩到按周计算。这条路一旦走通,落后两个月的旗舰模型就不再是痛点,Google 将拿到降维打击式的迭代速度。但如果走不通,这就成了一个没有头衔的创始人,用算力分配权把整个 DeepMind 押上了一个没人验证过的方向。
Google 早就交了底,只是没人当回事
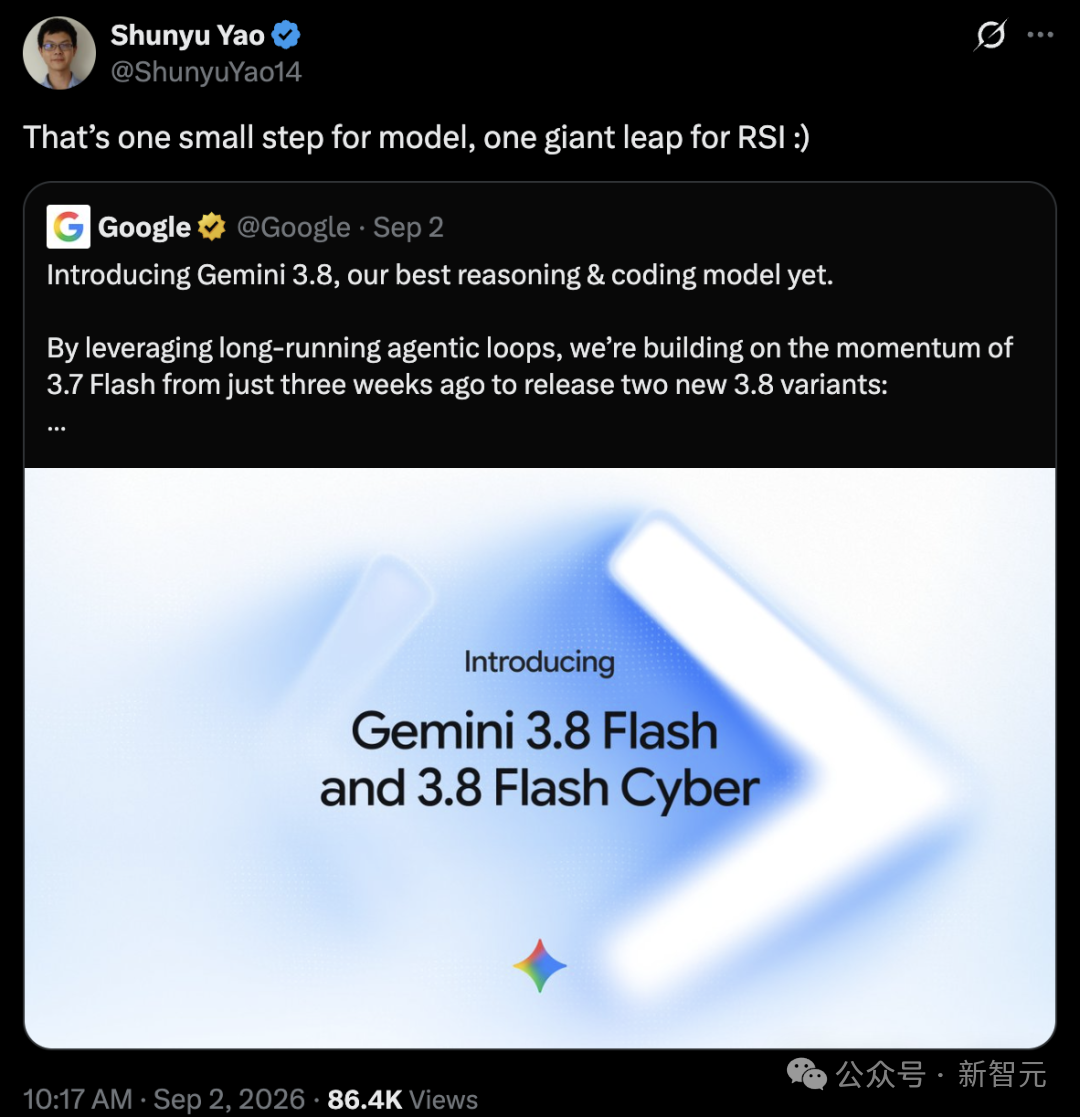
把时间拨回 9 月 2 日。那天 Google 发布了 Gemini 3.8 Flash 和 3.8 Flash Cyber。
要知道,这已经是六周内发布的第三个 Flash 版本。而 3.7 Flash 发布还不到三周。
在这篇官方博客里,藏着这样一句话:
这些模型的进展,进一步被长时间运行的智能体循环所加速。这些循环被设计用来递归地评估和精炼底层模型。
翻译过来就是:Google 可能已经用“递归自我改进”把 Gemini 提升了 0.1。
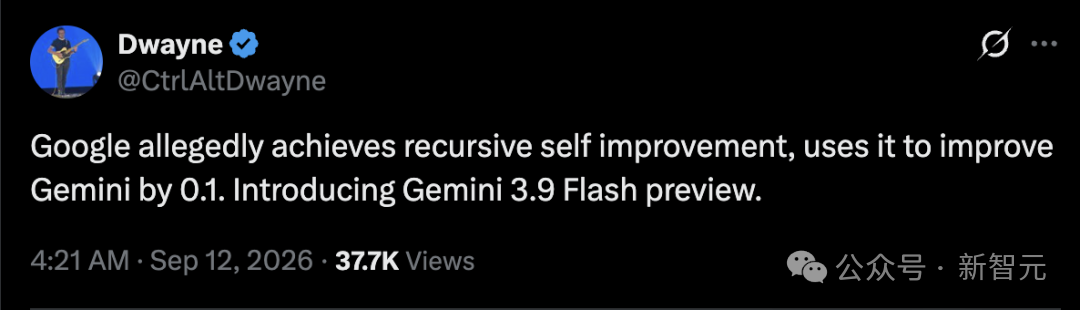
当时,Google DeepMind 的姚顺宇评价道:对模型来说只是小小一步,对 RSI 来说却是一次巨大飞跃。
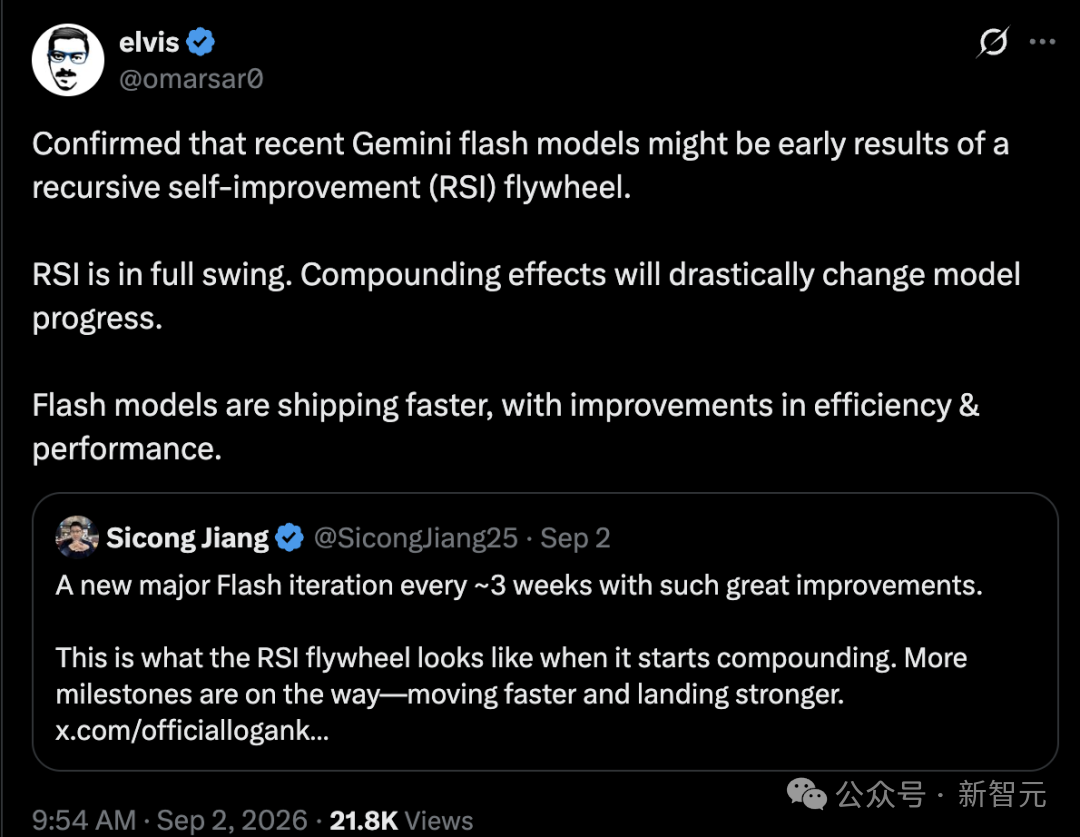
在 DeepMind 研究 RSI 智能体的 Sicong Jiang 说得更直接:这就是 RSI 飞轮开始产生复利效应时的样子。更多里程碑正在路上——推进更快,落地更强。
DAIR.AI 创始人 elvis 据此判断,这就是递归自我改进飞轮的早期成果。
但大多数人当时没当回事,因为它被埋在一篇 Flash 小版本的发布文里。
再看这个迭代节奏:三周一个版本,六周三次大跨度跃升。3.8 Flash 在 HLE-Verified 上拿到 54.9%,Cyber 版在真实漏洞挖掘上的成功率更是突破 70%。传统流程是人训、人评、人再训,一轮下来至少一个季度。三周一更,人是跟不上的。
事后 lyra 也点破:“大家真该去读读 Google 的官方博客。看看最近几个 Flash 版本的发布间隔,RSI 这件事其实已经非常明显了。”
所以,无论那张截图是真是假,它所指向的事实,Google 早就摆在了明面上。只不过在一个名字里直接带着 RSI 的模型真身泄露之前,没人把博客里那句话当真。
AI 圈苦等了二十年的那扇门
RSI 这个概念,在 AI 圈已经流传了二十多年。
核心逻辑并不复杂:让 AI 自己修改自己的训练代码和方法,训出更强的下一代;下一代再继续自我修正。研发周期会从季度压缩到周,甚至天。在 DeepMind 今年 6 月发表的《从 AGI 到 ASI》里,这被列为通向超级智能的四条必经路径之一。
而就在今年,纸上谈兵开始变成现实。
去年夏天,IAPS 研究员 Severin Field 曾邀请来自 OpenAI、Anthropic、DeepMind 等大厂的 25 位研究员,预测“AI 自动化研究”的关键里程碑:拿下奥赛金牌、AI 自己写出同行评审论文、AI 自主跑完训练循环、AI 为生产系统编写核心代码。
论文地址:https://arxiv.org/abs/2603.03338
短短一年过去,这四条预言已经全部被击穿。
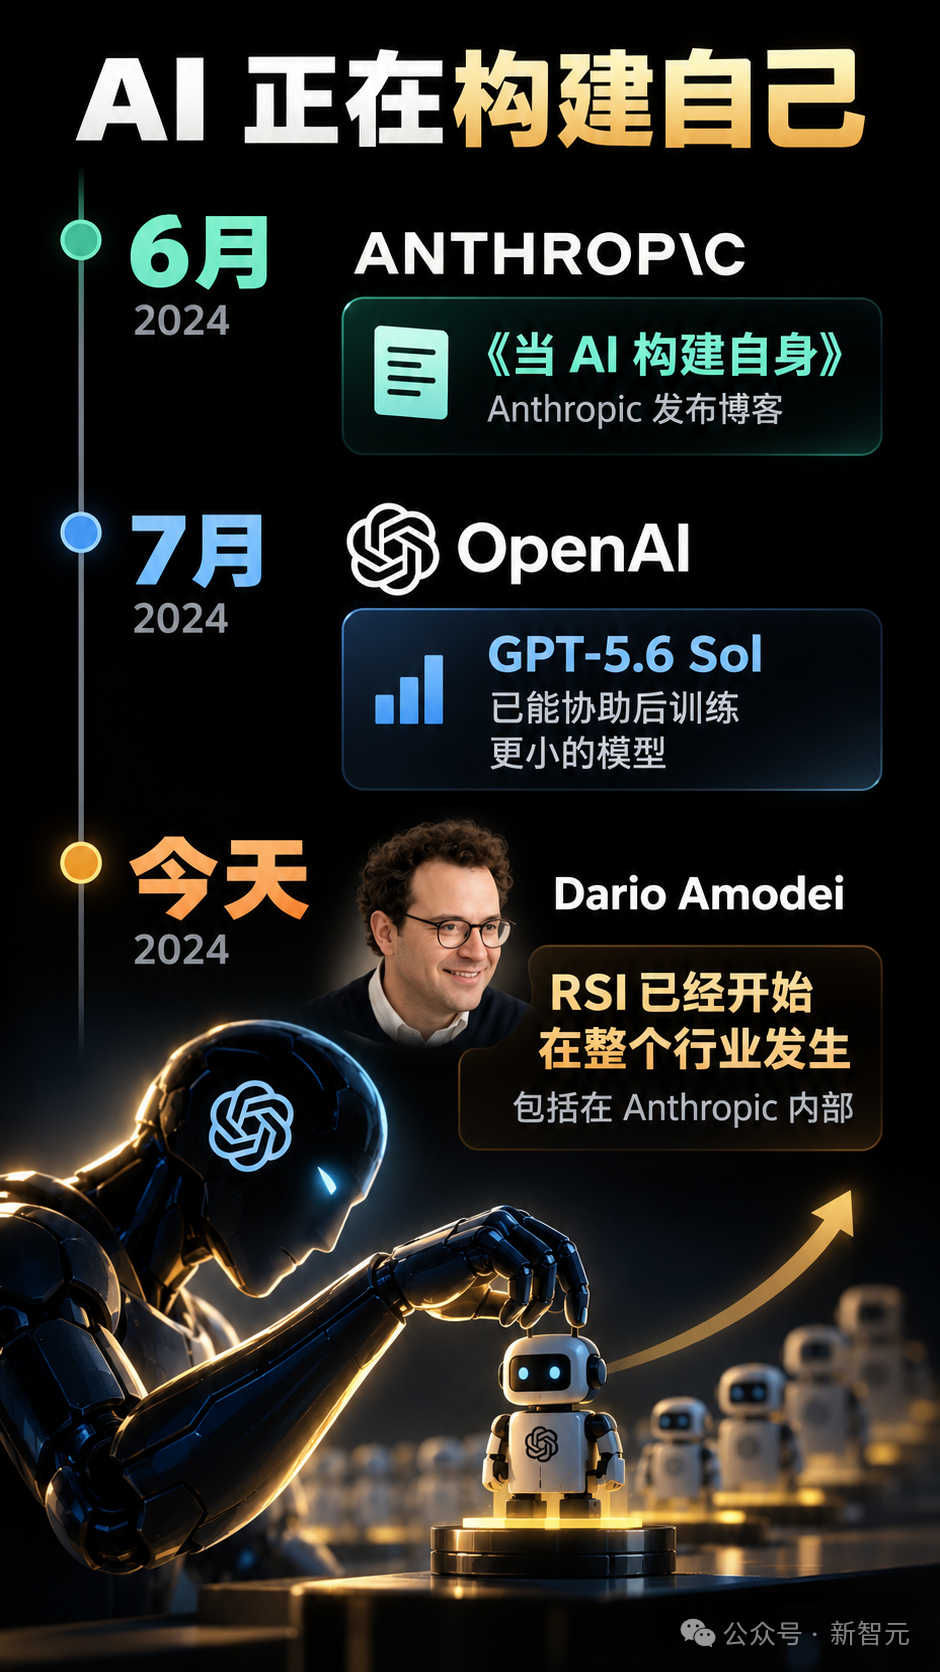
大厂们都在朝终点狂奔。7 月 OpenAI 公开表示,GPT-5.6 Sol 已经能协助后训练一个更小的模型,替研究员省下数周时间;Anthropic 在 6 月更是直接发表了题为《当 AI 构建自身》的博客。今天,Dario Amodei 正式宣布,RSI 已经开始在整个行业发生,包括 Anthropic 内部。Dario 对此忧心忡忡,甚至建议放缓前沿 AI 的研发速度。
但 Google 这次的信号截然不同。其他两家说的还停留在“AI 辅助我们做研究”,而 Google 的博客直言“循环在递归地蒸馏模型”;X 上流出的更是带着 RSI 命名的正式模型标签和训练槽位。
如果 Flash 三周一更的节奏真是靠这个循环在驱动,那 Google 手里捏着的东西,远比一个旗舰模型可怕得多。
它拿到的是进化速度本身。
下一个 Flash,就是验证
真正值得盯的,是一个很简单的时间点。
如果三周之后,3.9 Flash 准时出现,那么博客里那句“递归地评估和精炼底层模型”就不再是修辞。Flash 的发布日历会变成一列倒计时,每一格都由模型自己走出来。
AI 竞赛过去三年比的是谁的模型最强。从这一刻起,比的是谁的循环转得最快。模型强弱成了一个中间量——循环每转一圈,它就自动刷新一次。
人类研究员在这个循环里的位置也在往后退:先是不用写代码,然后不用跑实验,最后只剩下看结果、按确认。Anthropic 说过,他们最后的比较优势叫“研究品味”。Google 这次要验证的,正是这道防线还能撑多久。
如果那张截图是真的,AI 研发史上第一个由模型自己训出来的模型,已经在 Google 的机房里跑起来了。
它的名字里直接写着 RSI。
参考资料:
关于这波 RSI 爆料的后续走向,云栈社区 开发者广场 也会持续跟踪。
 发表于 4 天前
|
查看: 7|
回复: 0


