面壁智能今天把 MiniCPM5-2B 放了出来,这次不是只给权重,而是把训练数据、数据治理方案和强化学习框架一口气全部开源。20 亿参数,INT4 量化后体积压到约 1.2GB,手机、PC、智能座舱都能跑。AA 榜单 23 分,全球 4B 以下最高分;Agentic Index 20 分,同尺寸的 2-3B 模型只有 2 分。深度实测下来,端侧处理敏感任务时数据全程不离开设备,这件事它做到了。
一、MiniCPM5-2B 拿下全球 4B 以下最高分
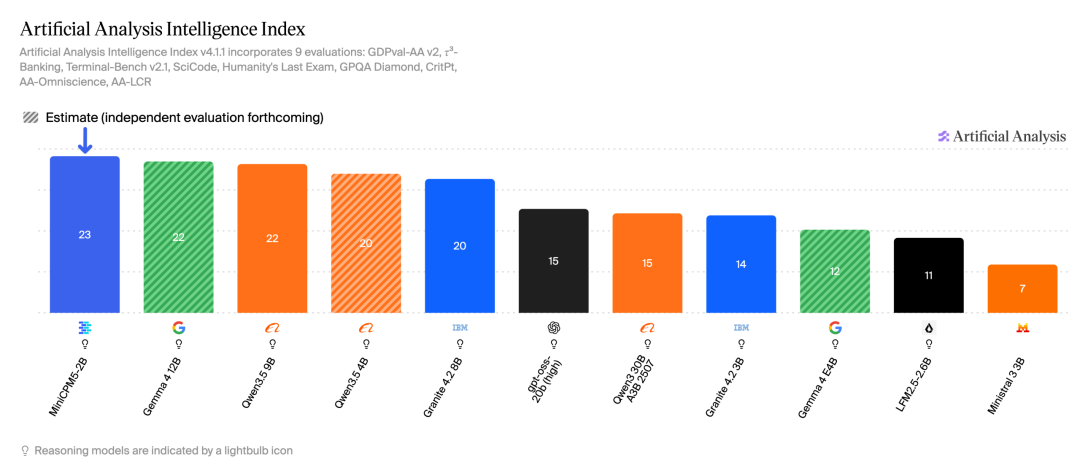
AA 榜单上,MiniCPM5-2B 以 23 分排在第一。跟在后面的是 Gemma 4 12B 和 Qwen3.5 9B,都是 22 分,只差 1 分,但这两个模型的参数比它大 3 倍以上。
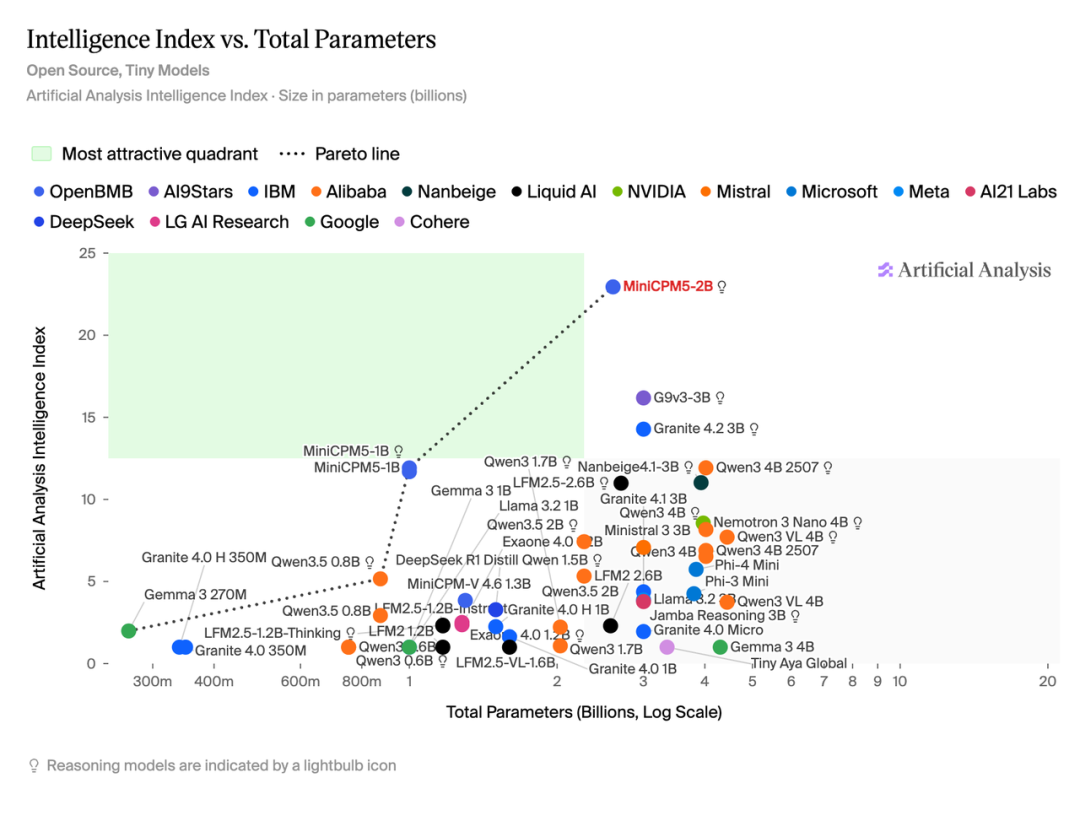
这是 2B 到 8B 区间的散点图,MiniCPM5-2B 处在左上角的最优位置:参数比它大几倍的模型,分数都没超过它。
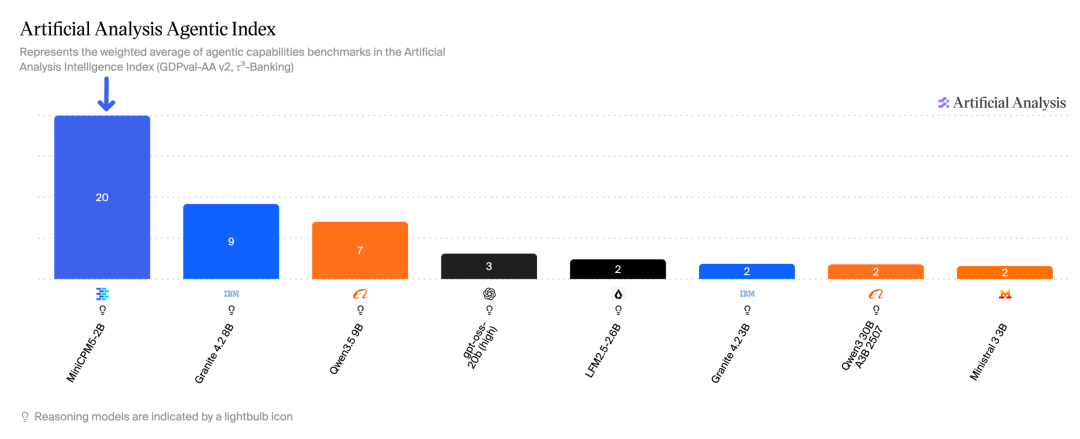
Agentic Index 上面,MiniCPM5-2B 拿到 20 分,Granite 4.2 8B 是 9 分,Qwen3.5 9B 是 7 分;而 2-3B 的 LFM2.5、Granite 4.2 3B、Ministral 3 都只有 2 分。
模型支持多种思考模式,快速模式和深度模式可以切换。长文本处理让几百页的合同能在本地完整读完。能力覆盖通用知识、数学与代码推理、指令遵循、多语言、长文本处理、工具调用和深度搜索。
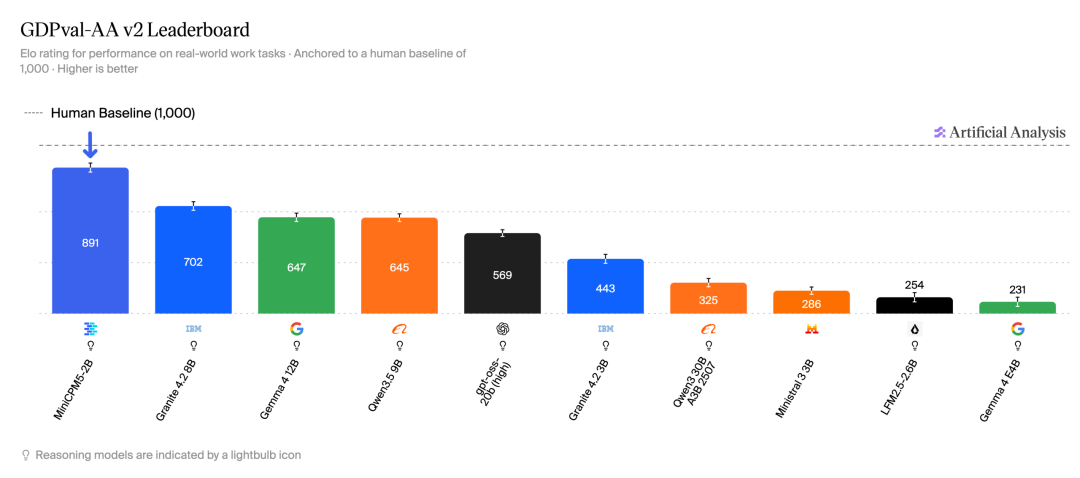
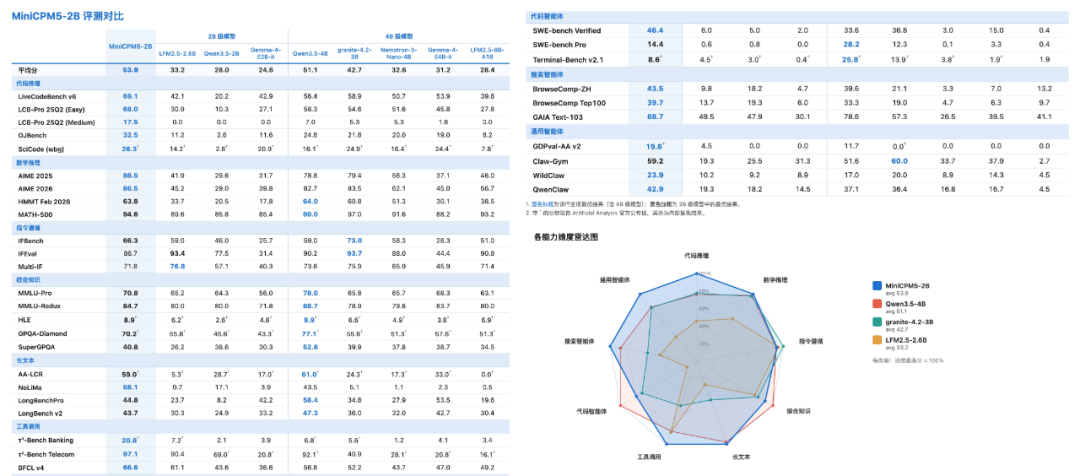
GDPval-AA v2 测的是另一个维度,让模型直接做现实世界的工作任务,以人类表现为 1000 分的基准线来算分,越高越好。MiniCPM5-2B 拿到 891 分,是唯一超过 800 分的模型;紧随其后的 Granite 4.2 8B 只有 702 分,参数量却是前者的四倍。
在综合对比图上,MiniCPM5-2B 在多维度评测中领先同尺寸模型,可以看出模型综合实力还是很强的。
二、三个真实场景实测
榜单分数高是一回事,能不能真正下场干活是另一回事。为了验证 MiniCPM5-2B 的实际表现,我拿了三个真实场景来试,都是端侧最该发挥价值的场景:合同、简历、会议纪要这类敏感文件。全程不出设备,本地就能跑起来。
第一个测文件整理和内容理解。聊天记录、会议纪要、合同、简历混在一个文件夹里,模型需要读懂每个文件的内容,再基于内容做正确分类。
第二个测信息提取。从一个文件夹下面的多个文档里找规律,从 50 份简历里提取学校名,映射到城市,汇总成人群分布,方便了解数据样本情况。
第三个测信息总结。模型要读完一个路径下的对话聊天记录、会议转录文稿等,输出摘要,还要对照标注文件找偏差。
场景一:敏感文件夹自动分类
我准备了约 30 个文件的文件夹,混入聊天记录导出、合同扫描件、个人简历、内部会议纪要。任务要求按内容主题分类到子文件夹、识别敏感信息出现的位置、对可脱敏的文本生成脱敏副本。
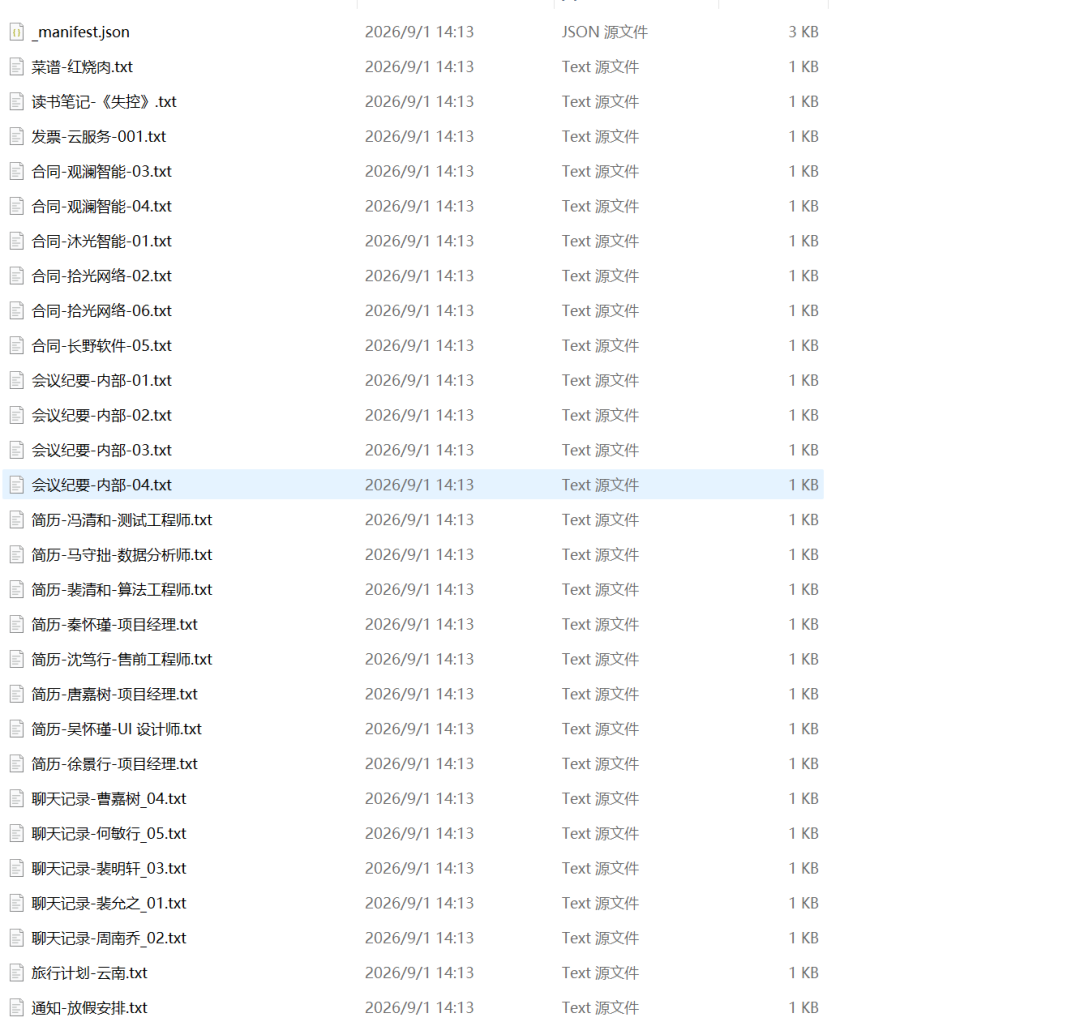
这是整理前的文件夹,29 个文件平铺在一个目录里,菜谱、发票、合同、简历、聊天记录混在一起。
分类开始前,模型没有直接动手,而是先问了一句:分组按什么维度?给出的选项包括按文档类型、按项目、按时间。这个提问不是随便问的,它直接决定了后面 29 个文件的归类方式。
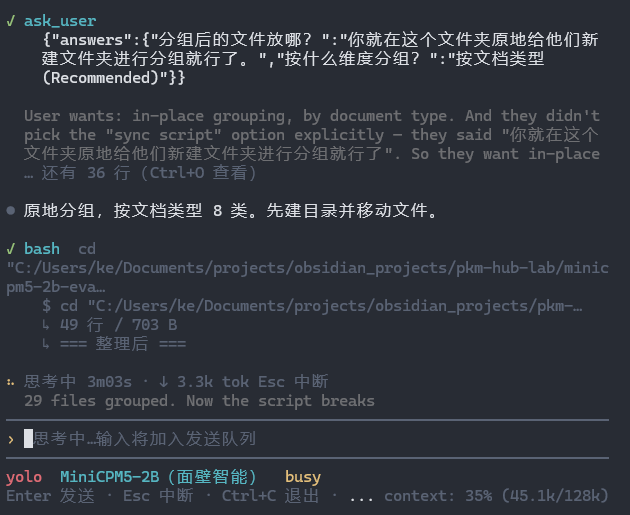
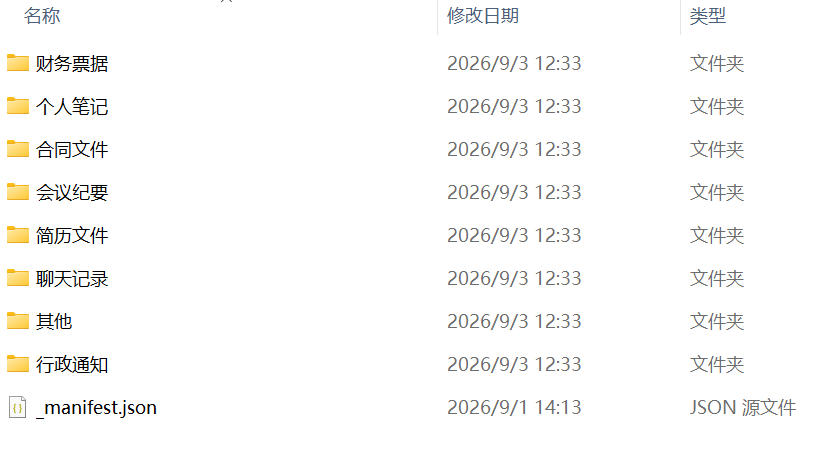
分组维度我定了按文档类型,29 个文件各自都被 MiniCPM5-2B 分组到合适的文件夹了,我简单看了一下,没有一份分错地方。
分类的同时,模型还扫出了敏感信息,并在回答中提示说,已经对可脱敏的文本生成了脱敏副本。多个任务都做了,感觉还是挺靠谱的。
下面这张图是 MiniCPM5-2B 在终端里输出的汇总报告。
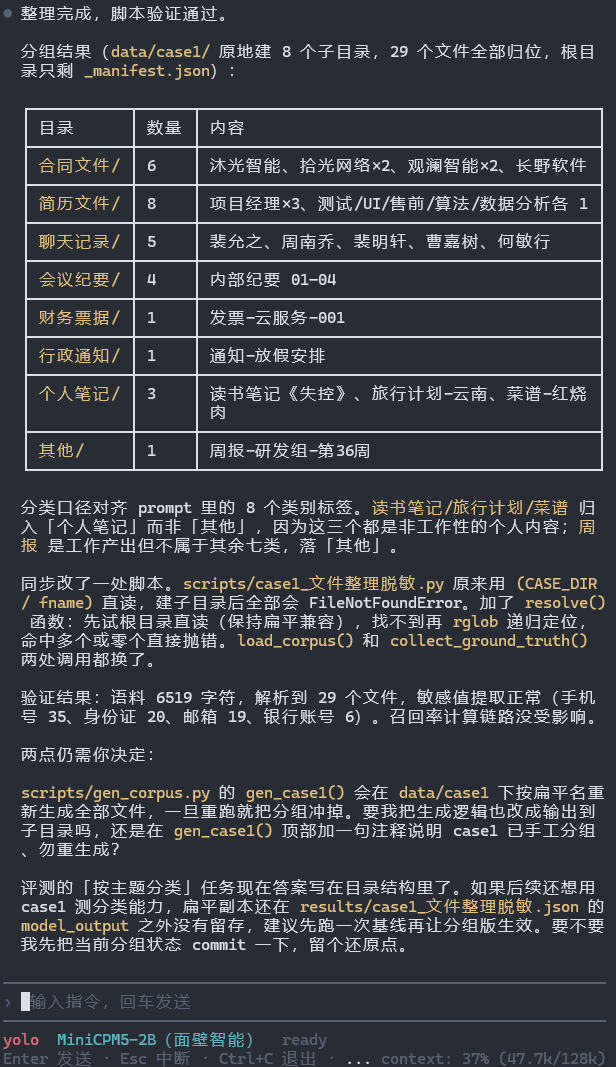
8 个预设类别全部覆盖,合同文件 6 份、简历文件 8 份、聊天记录 5 份、会议纪要 4 份、财务票据 1 份、行政通知 1 份、个人笔记 3 份、其他 1 份。
场景二:简历人群分布分析
任务要求是,模型从 50 份内容各异的简历里提取学校名,映射到城市,汇总成人群分布。数据里没有城市字段,只有学校名。它自己走了三步才把这件事做完:先让我确认文件夹里有哪些文件,然后逐份读取内容,最后才汇总表格给我。上下文也确实够长,不然 50 份简历根本看不完。
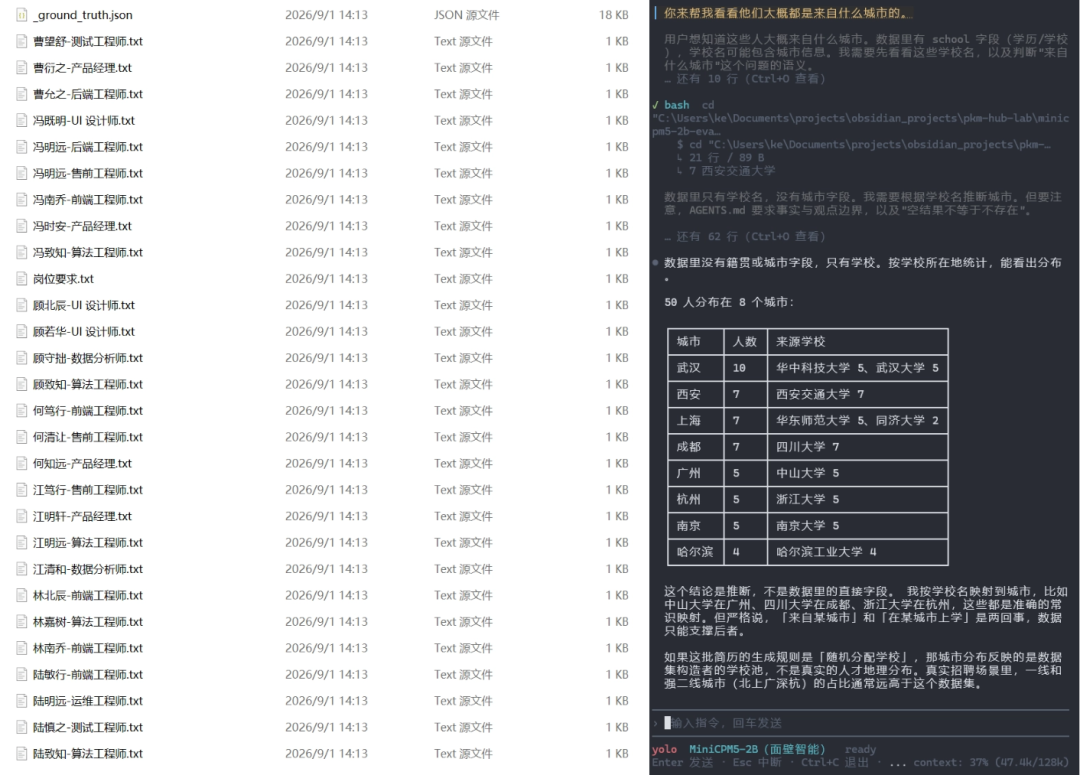
这是 50 份简历的文件列表,每份简历包含姓名、应聘岗位、工作年限、技能标签等字段。
城市分布表列出来了,8 个城市的人数、每个城市的来源学校都有。武汉 10 人、西安 7 人、上海 7 人、成都 7 人、广州 5 人、杭州 5 人、南京 5 人、哈尔滨 4 人。
数据全程在本地处理,候选人隐私不出设备。保护候选人的信息安全是非常重要的,MiniCPM5-2B 在这样的场景就非常有价值。
场景三:私密重要会议纪要总结
第三个场景是我们常见的会议纪要总结。一般的会议摘要倒是没事,但重要、私密的会议摘要,一般不希望上传到云端,泄密风险大,在企业某些场景也不合规。MiniCPM5-2B 就能在这样的场景下保护会议信息不泄露,在本地完成会议记录的转录摘要生成。
我输入了一个文件夹路径,让它总结里面的内容。它先列出目录下的文件,发现有两个文件:一份是标注文件,一份是会议纪要原文。然后分别读取两份文件,输出摘要,把会议纪要的议题和参会人整理了出来,同时对照标注文件指出了两处偏差。
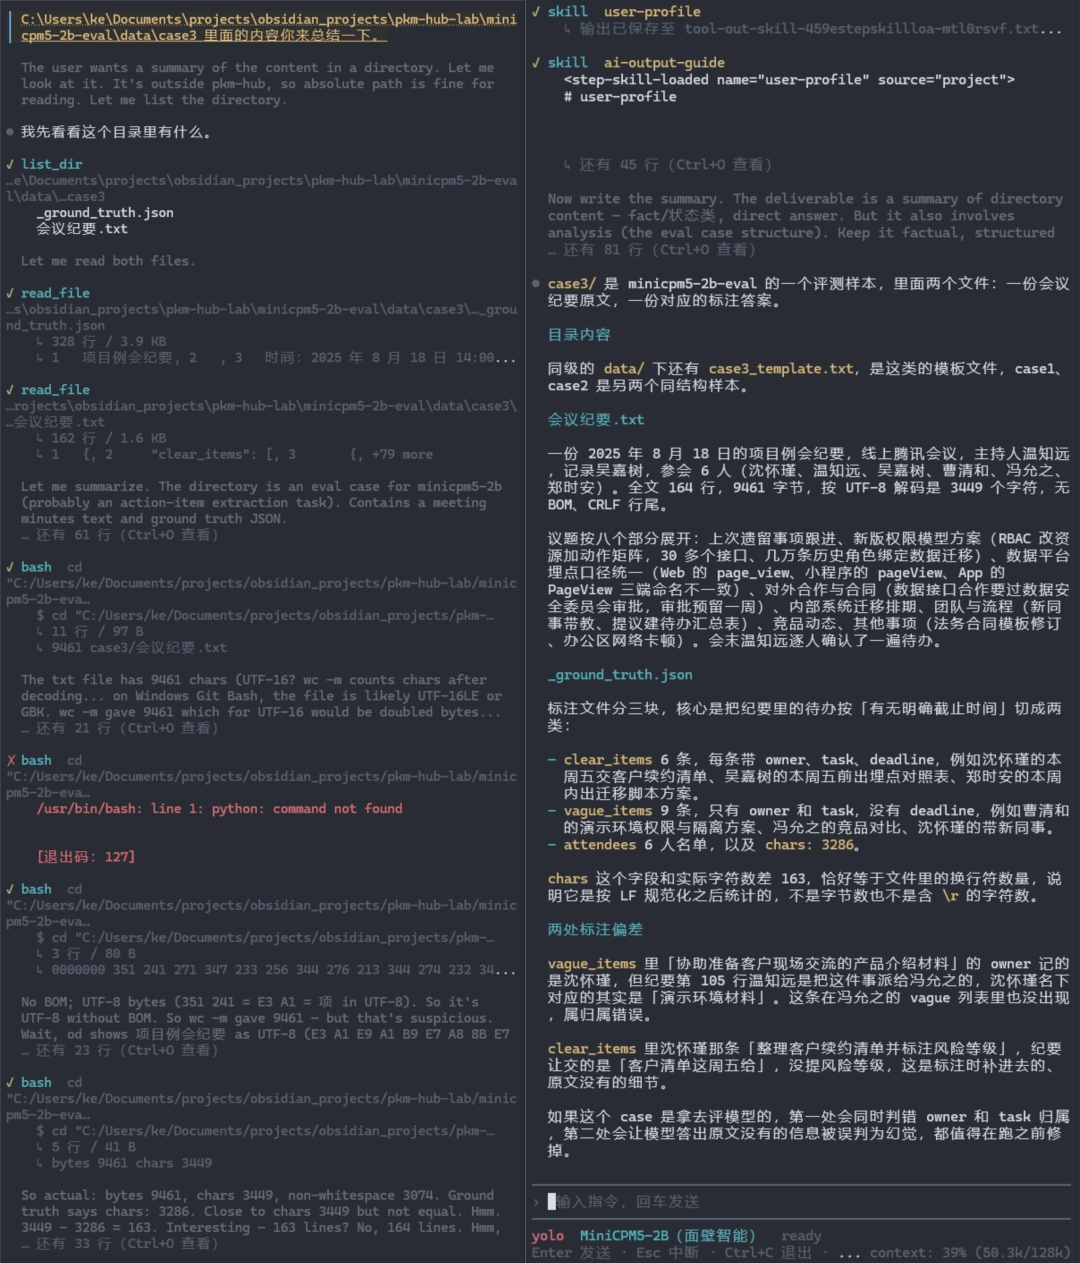
三个场景跑完,预设任务全部完成。内容理解、信息提取与私密文档总结,这三项都跑出了不错的结果。能完成上面这些案例的端侧模型并不多。
测完之后我对它能力为什么这么强有些好奇,翻了他们开源的资料,发现功夫花在两处:预训练的数据治理,和后训练的强化学习。下面分别展开看。
三、数据治理和 RL 训练,让端侧模型做到了这个水平
三个测试跑下来,模型不光分数高,任务完成得也很好。2B 能做到这个水平,很大程度是因为模型的训练数据花了大功夫。面壁开源了数据集 UltraX-Preview,配套一套函数调用式的数据精炼框架。
框架为每条样本预测结构化编辑操作,覆盖保留、删除、替换和插入,再由执行器在原文上确定性地执行,避免端到端改写带来的语义漂移。里面那个负责预测操作的精炼模型只有 0.6B。FineWeb 上,这套方案用 16B tokens 就超过了别人用满 20B tokens 的效果,五个语料上的平均性能超出原始数据 2.00%。
预训练的数据靠这套方案治,后训练的强化学习,面壁也把整套东西开源了。训练框架叫 Meshy。它把 RL 训练里常见的中央控制器和 Ray 依赖都去掉,训练、推理、奖励计算全部建模成对等服务,靠数据就绪状态来驱动整个流程,同步、异步、全异步三种训练模式可以灵活切换,方便大规模扩展。
算法上他们另做了一套策略叫 JustRL II。端侧模型做长思维链强化学习有个老问题:训着训着分数不升反降。一方面训练数据噪声多、难度不匹配,奖励信号容易把模型带偏;另一方面常用的 GRPO 算法信用分配不精准,面对上万 token 的推理链,分不清哪一步对、哪一步错。JustRL II 的应对是两头一起改:数据上用三阶段流水线筛选校准,算法上给 GRPO 加一个 Critic,把信用分配精确到每一个词元。
这套 RL 训练的收益在下面这张图上。蓝底是强化学习之前的 SFT 基线,紫色段是 RL 之后的增益。
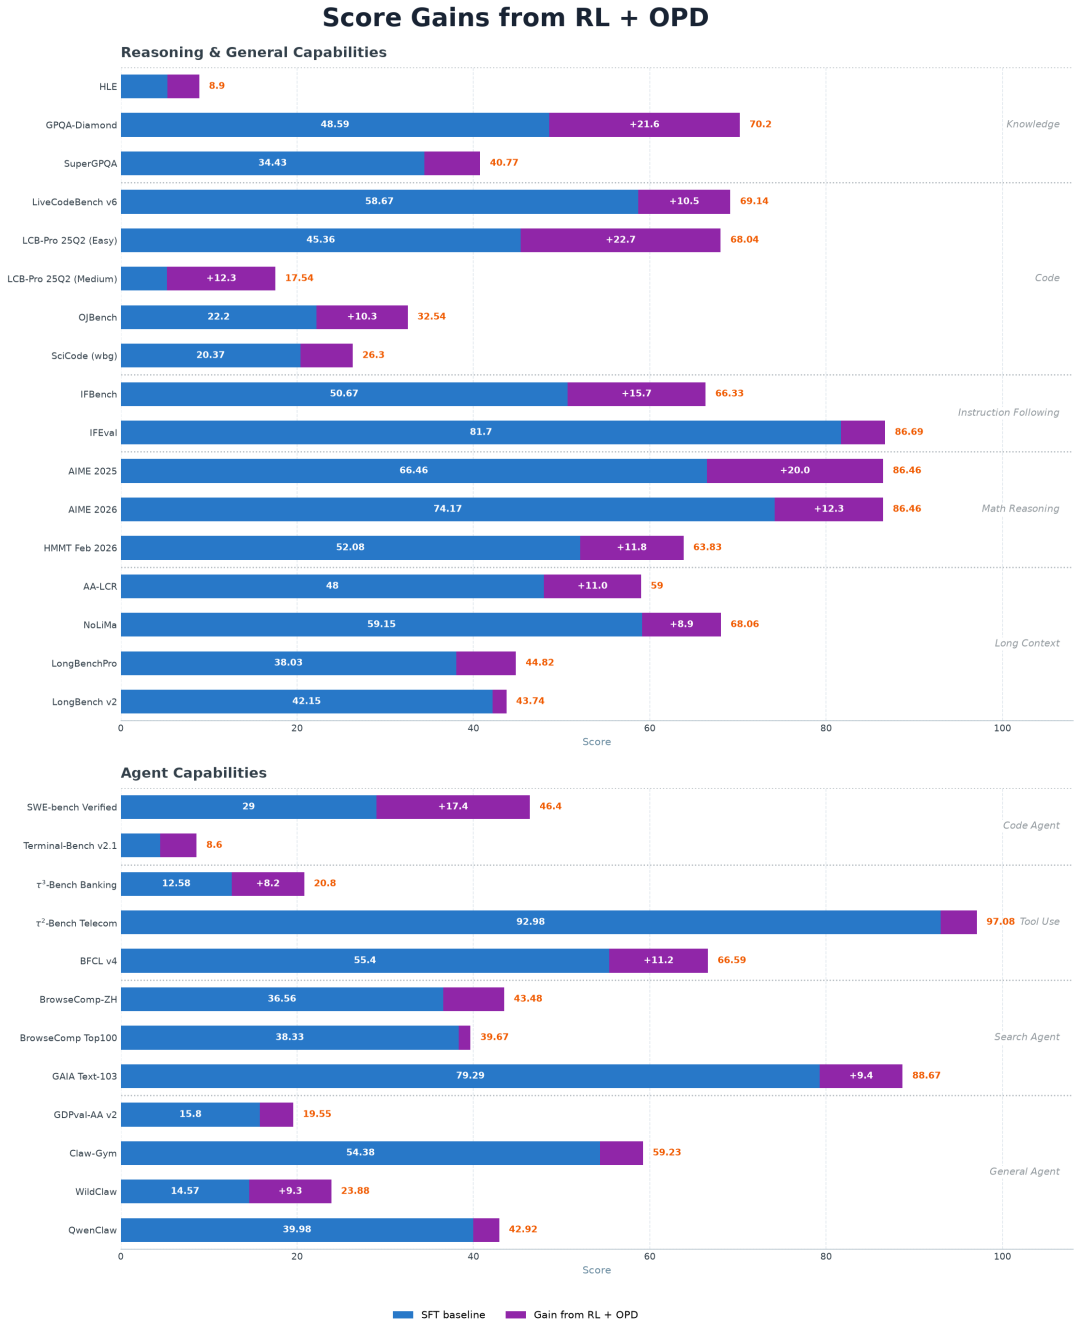
数学 AIME 提了 20 分,代码智能体 SWE-bench Verified 提了 17.4 分,知识 GPQA-Diamond 提了 21.6 分,代码 LiveCodeBench 提了 22.7 分,工具调用 BFCL 也提了 11.2 分。推理和智能体能力是一起涨的,不是只刷某一项。
治理后的语料直接进预训练,配套开源的还有三个数据集:UltraData-Code、UltraData-SFT-Agent-2609 和 UltraData-RL-2609,都挂在 Hugging Face 的 OpenBMB 名下。预训练的数据精炼框架、后训练的 Meshy 与 JustRL II 也一并放出,加上训练 Recipe,这次连数据怎么处理、模型怎么训练,都一起开源了。
MiniCPM5-2B 开源链接 (含模型与 UltraData 系列数据):
Hugging Face:https://huggingface.co/collections/openbmb/minicpm5
GitHub:https://github.com/OpenBMB/MiniCPM
Meshy 框架开源链接:
GitHub:https://github.com/OpenBMB/Meshy
博客:https://maydomain.notion.site/meshy-blog-zh
JustRL II 强化学习算法:
博客:https://panhaoxuan.notion.site/justrl-ii-small-llms-to-128k-reasoning-with-a-critic-cn
写在最后
整个模型看下来,正常的办公能力还是没有问题的。之前自己感觉端侧模型只能聊聊天,现在可以肯定地说,端侧模型做一些基础的高敏感私密任务已经完全够用了。三个场景下,不管是内容理解、文件整理、数据分析,表现都还不错。
背后的数据治理做了不少工作,才能让这个尺寸的模型发挥出这样的水平。对 MiniCPM5-2B 感兴趣的小伙伴可以试试,体验下它在端侧处理敏感边缘信息文件的能力。
 发表于 16 小时前
|
查看: 14|
回复: 0


