我们正站在超级智能的黎明。
昨天,普林斯顿大学 AI 实验室的研究者 Yifan Zhang(张一凡)在 X 上发了一条重磅推文:
We are at the dawn of Superintelligence.
Introducing the Recurrent Looped Transformer (RLT),
We now have Transformers with Infinite Reasoning depth.
From now on, we should pace progress at the Open Frontier of Superintelligence,
Until Safe Superintelligence is achieved.
我们正处在超级智能的黎明时代。
循环环路Transformer(RLT)正式问世,如今我们拥有了具备无限推理深度的 Transformer 模型。
自此,我们应当把握超级智能开放前沿的发展节奏,直至实现安全的超级智能。
这条推文很快引发大量关注。与此同时,作者放出了技术报告、中文版论文和项目主页,正式提出了一种全新架构——Recurrent Looped Transformer(RLT,循环环路 Transformer)。
这并非简单多堆几层,或者把同一组权重循环跑几次,而是一次从根本思路上改变 Transformer 推理方式的尝试。
传统 Transformer 的深度是固定的:模型有多少层,每个 token 就只会经过多少次计算。想让推理更深,要么堆参数,要么靠 Chain-of-Thought 在 token 空间里显式思考,两边的代价都不低。
RLT 换了一种思路,把模型拆成两部分:
-
因果编码器(Causal Encoder)
并行处理已观察到的所有 token,构建全局 Key-Value 记忆(Encoder KV memory)。
-
循环解码器(Recurrent Decoder)
对每一个 token(无论是 prompt 还是 response)都执行相同的转移函数。它会:
- 读取编码器的全局记忆;
- 使用滑动窗口注意力(SWA)保留局部上下文;
- 最关键的是:把上一个 token 的最终隐藏状态(recurrent state)直接传给下一个 token。
这样做的结果是什么?
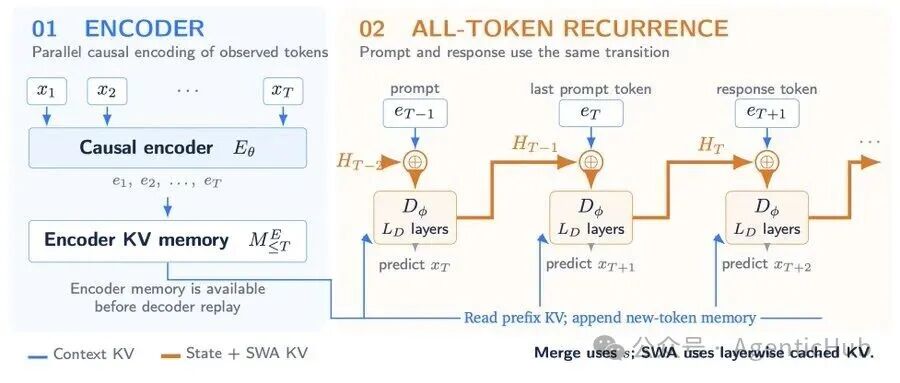
每多处理一个 token,推理路径就会再多走一遍完整的解码器层数。如果解码器有 $L_d$ 层,处理完 $t$ 个 token 后,有效推理路径就变成了 $t \times L_d$ 个 block。深度随着序列长度自然增长,而每个 token 的计算量却保持固定。
这就是作者所说的“Infinite Reasoning depth”——不是在一个 token 内无限计算,而是随着对话或生成的推进,潜在推理路径可以无限延伸。
技术报告明确提出了三个核心原则:
-
潜在推理的无限时间深度(Latent reasoning with infinite temporal depth)
推理不再被固定层数锁死,而是随着序列增长持续累积。
-
模型-硬件协同设计(Model–hardware co-design)
编码器可以并行批处理,解码器则通过状态复用和激活检查点等方式优化训练与推理效率。
-
模型-强化学习算法协同设计(Model–RL algorithm co-design)
预训练、SFT、采样和当前策略 RL 回放都使用同一套完整状态转移逻辑,包括 prompt 阶段的循环和 SWA 缓存,减少训练与推理之间的结构性不一致。
报告中给出的示例配置是 48 层编码器 + 48 层解码器,权重在兼容的注意力和 FFN 上共享。解码器还额外做编码器记忆的交叉注意力。
过去一年里,“Looped Transformer / Recurrent Depth”已经逐渐成为业界讨论热点,甚至出现了一些闭源模型的传闻——我说的就是 GPT6。但多数实现仍然是同一组层重复跑几次。
RLT 更进一步:它把循环做到了跨 token 的状态传递,并且让 prompt 和 response 使用完全相同的转移过程,没有边界重置。这让 latent space 里的连续推理变得可能。
需要诚实地说,目前放出的还是技术报告和架构设计,具体的推理收益、硬件加速效果,以及在大规模 RL 上的扩展性,都还需要后续实验验证。作者也明确写了这一点。
但它提供了一个清晰、可执行,并且与硬件和强化学习深度协同的新范式。对追求更强 latent reasoning、更长有效推理链,以及更统一训练-推理逻辑的人来说,这是一个值得密切关注的方向。
项目已经 开源:
https://github.com/yifanzhang-pro/recurrent-looped-tranformer
英文技术报告和中文版论文都已上传。
Transformer 诞生七年后,我们终于开始认真讨论如何让深度随序列自然生长。也许,这真的是通往更强智能的又一重要台阶。
你怎么看 RLT?是又一次炒作,还是真正有潜力改变游戏规则的设计?欢迎到 云栈社区 继续聊。
 发表于 3 天前
|
查看: 23|
回复: 0


