这周国产大模型圈挺热闹,九月里好几家同台发了新品。但最让我在意的,不是谁又堆了多少参数,而是 DeepSeek V4.1 Flash 悄悄把模型的骨架改了。
单看像一次普通升级,放远一点看,我觉得这是个信号:国产模型的竞争,正从「谁的参数更大」转向「谁更会省」。
便宜的背后是效率,不是补贴
V4.1 Flash 总参数 552B,听着还是个巨无霸。但它这次真正的改动不在规模,在结构。
官方叫它 Causal Encoder-Decoder 非对称结构,把 40 层 Transformer 拆成 20 层 encoder 加 20 层 decoder。结果很反直觉:读输入(prefill)时每 token 只激活 8B 参数,写输出(decode)时激活 16B。
传统模型这两步激活量一样,它掰成了不对称。为什么这事值得单独拎出来说?因为 agent 场景里,输入往往远大于输出。超长的 system prompt、几十万 token 的上下文、几十轮工具结果回填。读题阶段用 8B 更划算,写答案阶段用 16B 保质量。等于长输入变便宜了,输出没掉档。
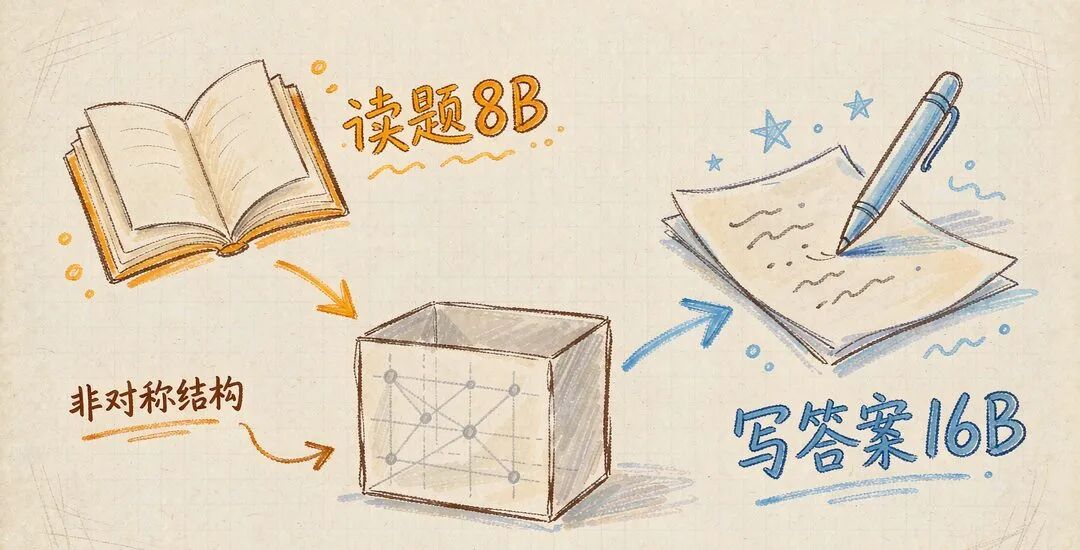
把缓存压到了四分之一
如果说非对称结构还是工程层面的巧思,那 KV Cache 的压缩就是直接冲着账单来的。
KV Cache 是推理时的缓存:生成新 token 时,上文算过的中间结果存下来复用,不用每次从头重算。它很吃显存,上下文越长吃得越多,长对话、长文档、多轮工具调用的开销主要压在它身上。
V4.1 Flash 把单 token 的 KV Cache 压到 890 字节,大约是上一代 V4 Flash 的四分之一,对 HBM 显存需求降到四分之一,对 SSD 降到八分之一,相对初代模型累计缩小了 437 倍。
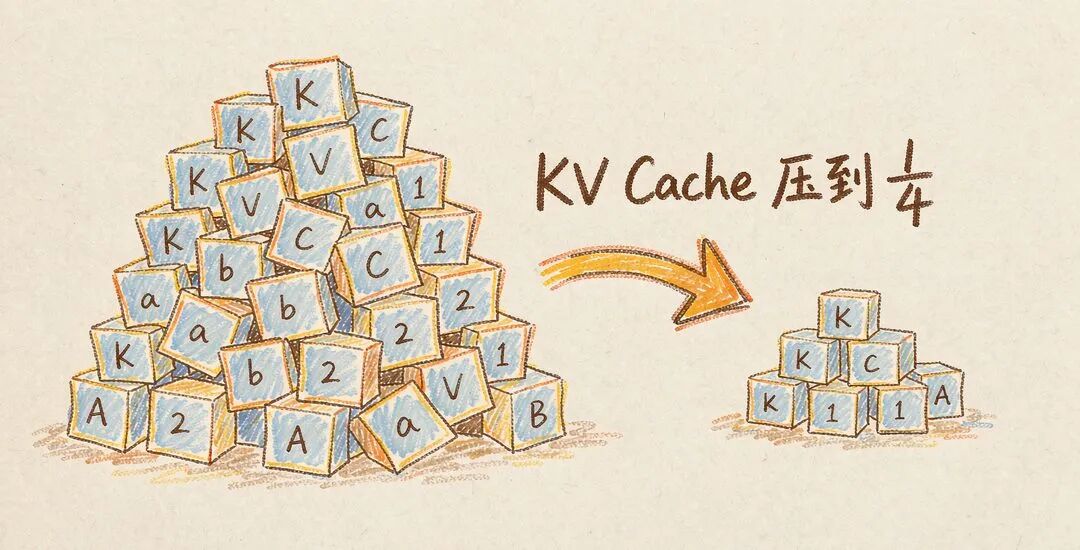
一个 10 万 token 的上下文会话,单 token 890 字节算下来,KV Cache 大约占 89 MB;换成上一代 V4 Flash(单 token 约 3560 字节)就要约 356 MB。一个会话差出 4 倍显存。长上下文跑起来顺不顺,往往就卡在这。
压缩稀疏注意力第二代、分层稀疏索引、再把缓存本身用 4 位浮点存。三管齐下,效果很直接:同一个长会话,显存占用和重复计算一起下来了。
价格跟着效率走,不是烧钱补贴
新价格 9 月 10 日 12:00 生效,单位是元/百万 token。缓存命中输入闲时 0.02、高峰 0.04;缓存未命中闲时 1、高峰 2;输出闲时 4、高峰 8。高峰是工作日北京时间的白天两段,其余闲时正好半价。
对比旧 Flash,缓存命中输入降了 60%,未命中输入降 33%,输出降 11%。
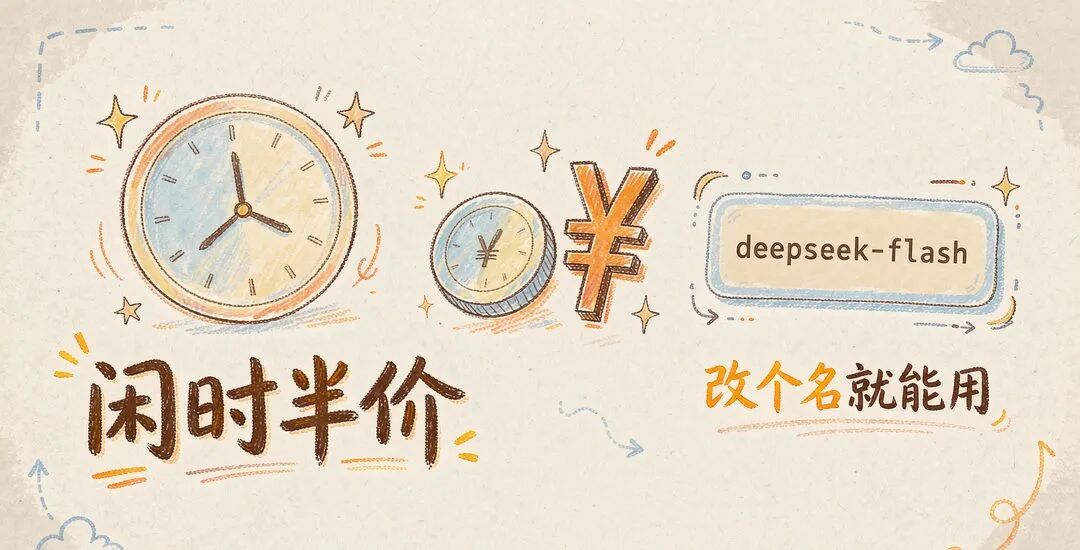
这不是靠烧钱做补贴式降价,是架构红利传导到了账单上。模型自己更会算、更会存,省下来的成本才敢让给调用方。闲时半价也不是噱头,它反映了一个事实:推理资源在闲时有富余,价格机制在把这份富余让出来。
顺带说一句 V4 Pro。它并没有下线,现在仍按自己那套更高价提供服务,输出大约是 Flash 的 6 到 7 倍。两个档位都还在,丰俭由人。
行业正在换挡
把镜头拉远,V4.1 Flash 只是这条线上的一个点。真正的变化是:模型的竞争焦点,从「能不能算」挪到了「能不能便宜地大规模算」。
原因很现实。今年以来,Agent、长文档、百万上下文这些场景集中爆发,大家发现推理成本的大头不在单次生成,而在反复 prefill 同样的长前缀、在缓存被上下文撑爆。瓶颈变了,优化的着力点就跟着变。
国产阵营这一年的动作,不约而同往效率走:MoE 把激活参数拆小、稀疏注意力砍掉无用计算、缓存量化把存储压扁。V4.1 Flash 把这几样叠到了一起,只是它做得更彻底。
这对普通人意味着什么?意味着百万上下文的 Agent,正从奢侈品变成日用品。以前跑一个长上下文 agent,账单能吓退小团队;现在架构把单位成本压下来,再加上闲时半价,个人和小团队真能用得起、用得勤了。这比单纯的「参数又大了」更有含金量,因为它直接降低了使用门槛。
「百万上下文的 Agent,正从奢侈品变成日用品。」
两个坑,和一次反转
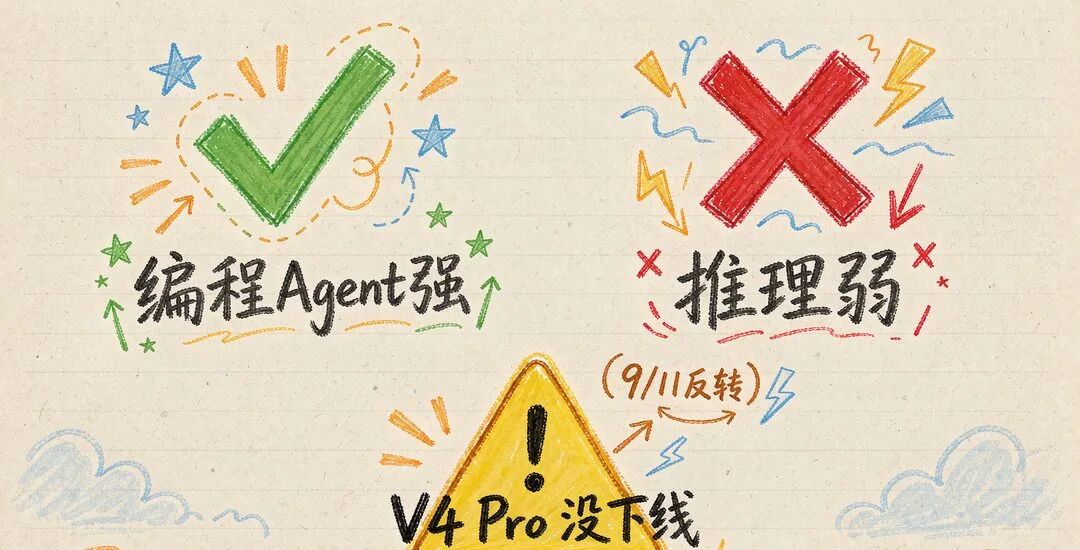
观点归观点,落到自己账上得清醒。V4.1 Flash 有两个绕不开的短板。
1:它费 token。单次任务消耗的 output token 比 V4 Pro 和部分旗舰还多,「单价低」不等于「每件事都最便宜」;按 Intelligence Index 任务算约 0.27 美元,比 V4 Pro 低约 60%,但比旧 V4 Flash 略高一点。
2:推理不是它的强项。官方自评 HLE 36.8(低于 V4 Pro 的 42.7),Terminal-Bench 4.0 仅 31.2(Claude Opus 5 为 51.8);编程和 agent 自动化强,但专家级科学类任务与巨型闭源模型仍有明显差距。
写在最后
V4.1 Flash 不是「又便宜了一点」,是它代表的方向:国产模型开始把架构效率当成卖点,不是堆参数。对咱们这种拿 AI 提效、又想要节省成本的朋友来说,这个方向是对的。
你如果也在用 DeepSeek 跑 agent,可以留意下这个趋势,比追每一次参数上新更有意义。像这类国产大模型的效率走向,开发者广场上也有不少人在跟踪讨论。
 发表于 15 小时前
|
查看: 19|
回复: 0


