演讲金句:我们这一代人出生太晚,错过了探索地球的黄金年代;出生又太早,来不及探索星辰;但刚好赶上了解决机器人这个命题的时代。 If you believe in robotics, robotics will believe in you.
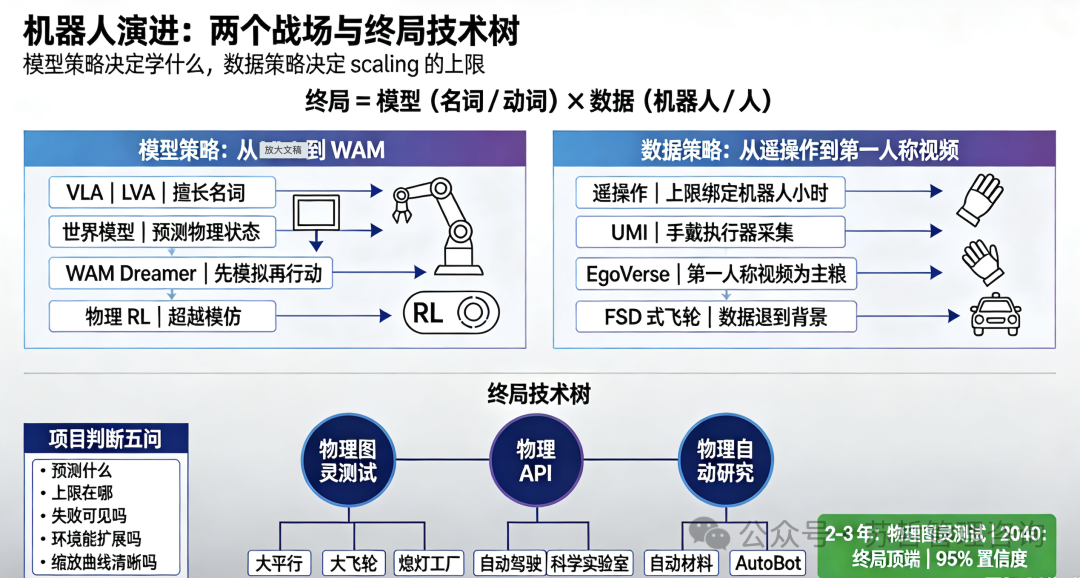
编者摘要:NVIDIA 机器人首席科学家 Jim Fan 提出论断:VLA 视觉语言动作范式已落幕,具身智能终局仅剩两大核心战场,即模型学静态名词知识、还是动态物理动词能力,数据依托机器人硬件、还是人类真实场景。行业告别 VLA(实为偏重语言的 LVA),迈入 WAM 世界动作模型新时代。
WAM 复刻大模型发展逻辑,通过像素预测自发涌现物理规律,可提前模拟推演动作,实现机器人零样本实操,还能可视化诊断故障,解决了传统模型不懂物理动态的核心短板。数据层面,传统遥操作受机器人硬件数量限制,存在产能天花板。
行业已迭代至可穿戴采集、人类第一人称视频训练模式,依托海量真人场景数据突破规模瓶颈。搭配 DreamDojo 神经仿真器,以算力生成无限仿真环境。技术终局将依次实现物理图灵测试、物理 API、机器人自主科研,预计 2040 年完成全域技术落地。
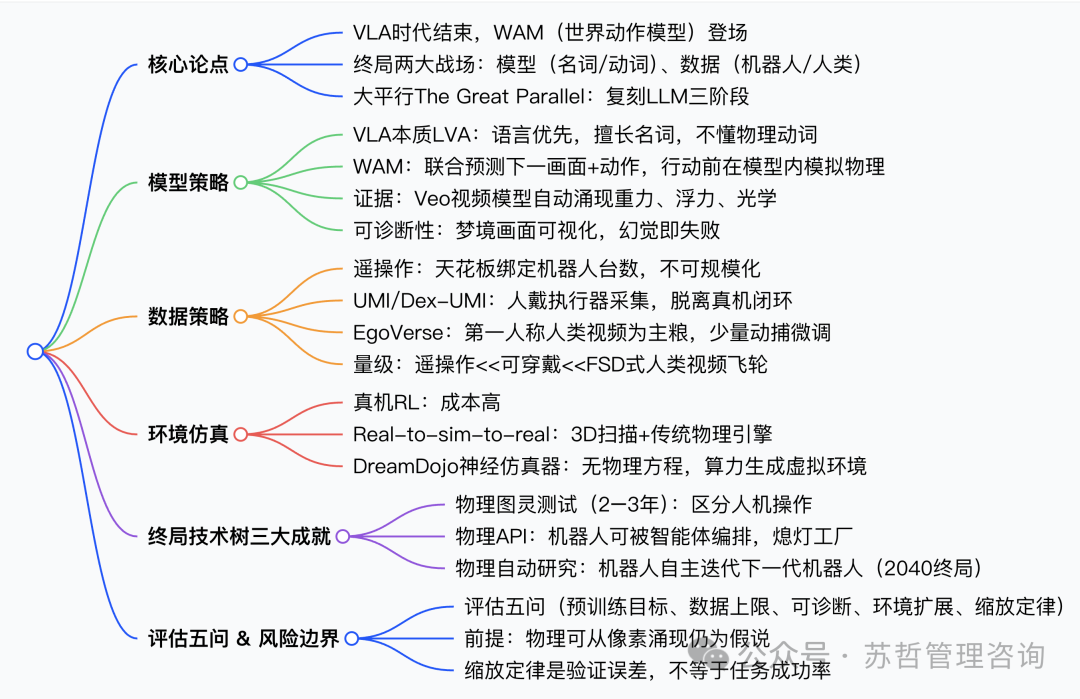
10 个关键问题 Q&A
Q1:VLA 为什么被判定为过渡期方案,不是终局?
A:VLA 主干是 VLM,预训练目标是理解、描述世界,不是预测世界动态变化。模型能看懂语言、识别物体,但缺少对物理动态的原生理解,学到的是名词知识,不是动词(交互、运动、碰撞)。
Q2:WAM 和 VLA 最核心差别是什么?
A:VLA:图像→语言理解→输出动作;WAM:预测未来世界状态,再基于模拟推演输出动作。WAM 主干是世界视频模型,而非语言模型。
Q3:EgoVerse 为什么只需要极少量机器人 / 遥操作数据?
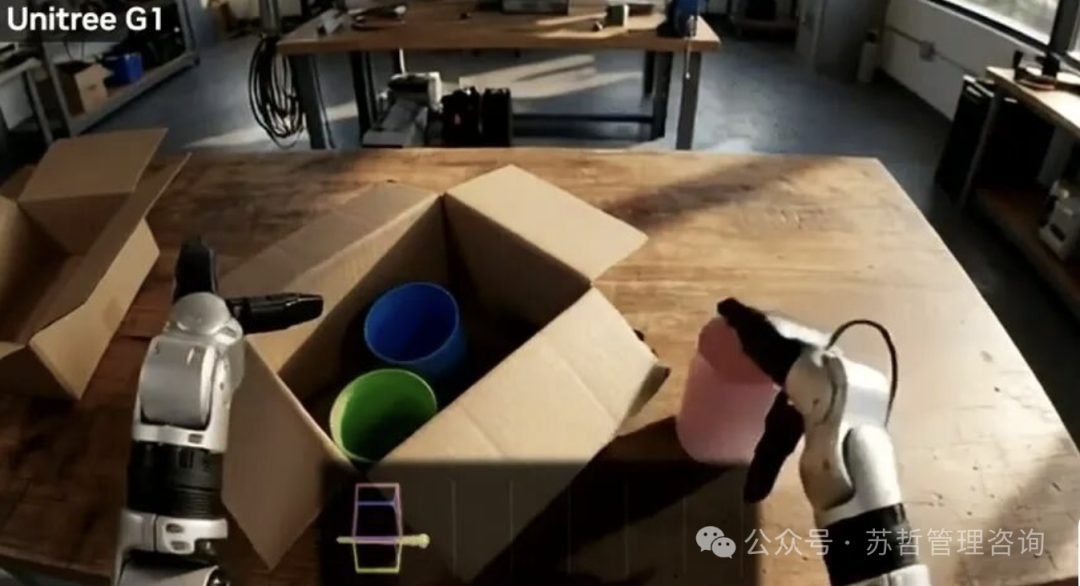
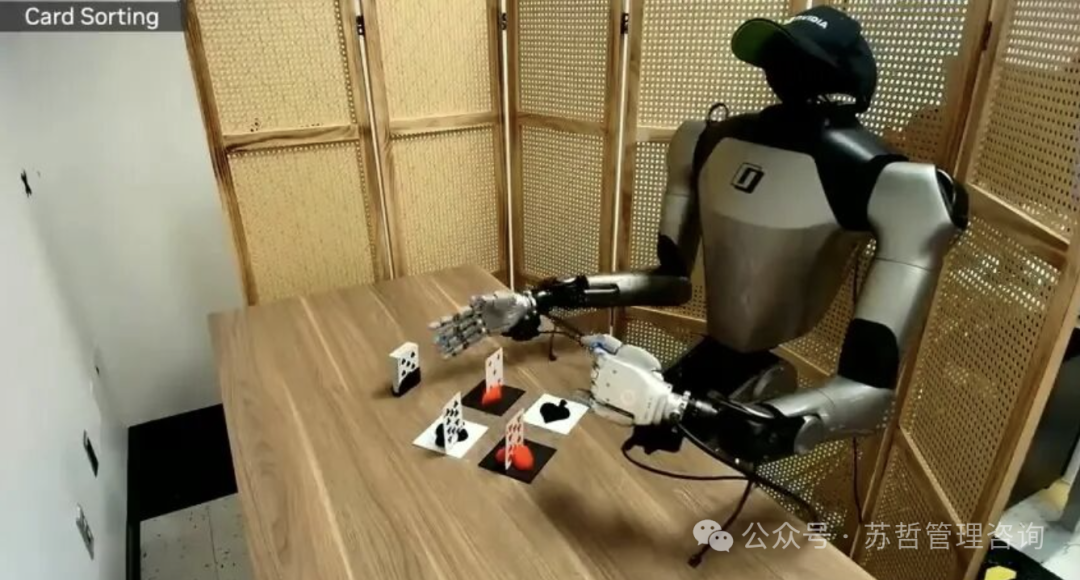
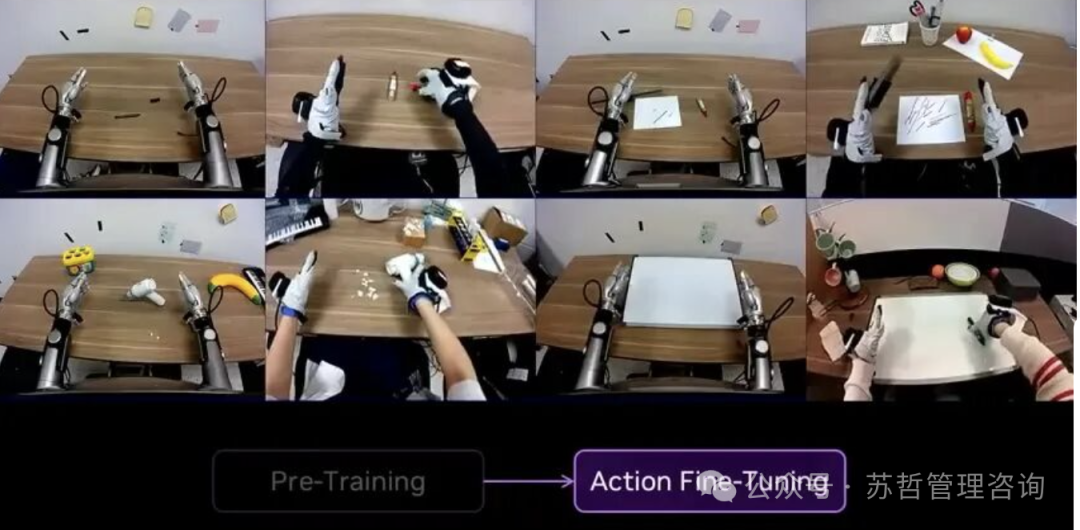
A:预训练全部用人类第一视角视频学习人手与环境交互规律,只需要少量高精度动作数据做对齐微调,把人类手部交互知识迁移到机器灵巧手上。
Q4:UMI 解决了遥操作的什么痛点?
A:传统遥操作必须操控真实机器人本体采集数据,数据产能受限于真机数量。UMI 让操作员手持机器人末端执行器直接采集,机器人本体退出采集回路,大幅降低硬件成本、提升采集速度。
Q5:DreamDojo 神经仿真器和传统物理仿真器差异?
A:传统仿真器依靠手写物理方程、几何材质渲染;DreamDojo 从真实视频中学习力学、物理规则,纯生成式像素仿真,可生成任意机器人机体与场景,无需建模。
Q6:缩放定律在这里的含义是什么?
A:灵巧操作领域也存在缩放关系:训练步数增加,人类验证集手部姿态 MSE 误差持续下降。这代表可以提前估算算力投入对应的能力收益,是规模化投入的前提。注意:该曲线只对应姿态误差,不是任务成功率。
Q7:什么是 “大飞轮 The Great Flywheel”?
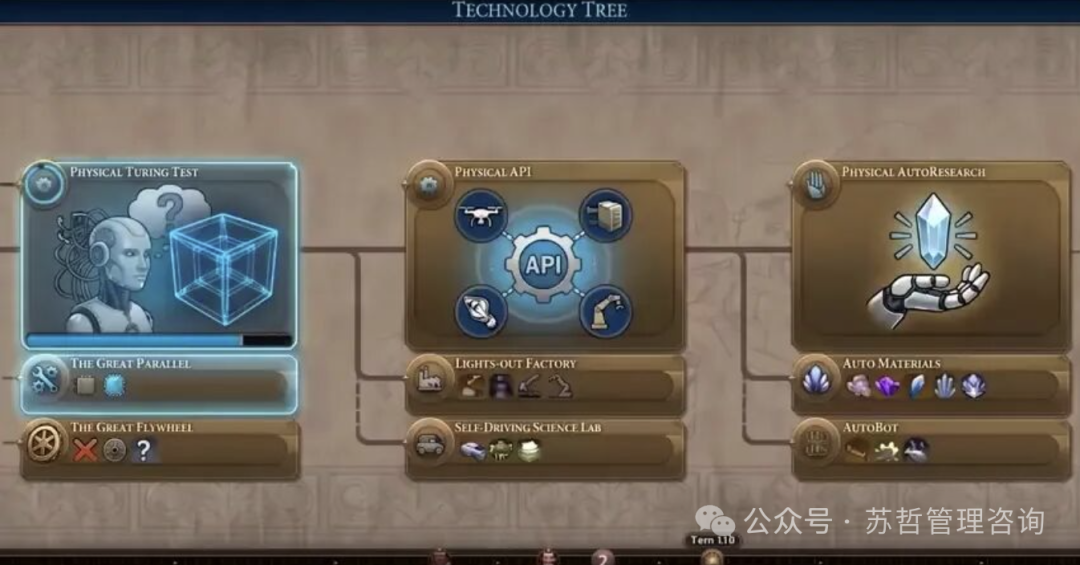
A:演讲幻灯片和大平行并列的子节点。大平行是技术路径(抄 LLM);大飞轮是数据自增强闭环:采集数据→训练模型→用模型生成更多仿真数据,持续迭代,形成自驱动循环。
Q8:物理图灵测试如何衡量?
A:不是语言图灵测试,是物理操作层面:在广泛日常劳动任务中,观察者无法区分这件操作是人完成还是机器人完成;量化指标:单位能量输入带来的劳动产出。
Q9:Jim 对时间线的判断有多大置信度?
A:物理图灵测试 2–3 年;物理 API、自动研究到 2040 年,95% 置信度,属于研究者主观预测,不是确定时间表。
Q10:这套路线的最大风险假设是什么?
A:核心前提:物理规律、物体动态交互,可以直接从海量像素视频预测中涌现。当前证据是 Veo 生成视频和 Dreamer 真机实验,还不是已经被完整证明的底层原理。一旦这个假设不成立,整个 “大平行” 路线会受限。
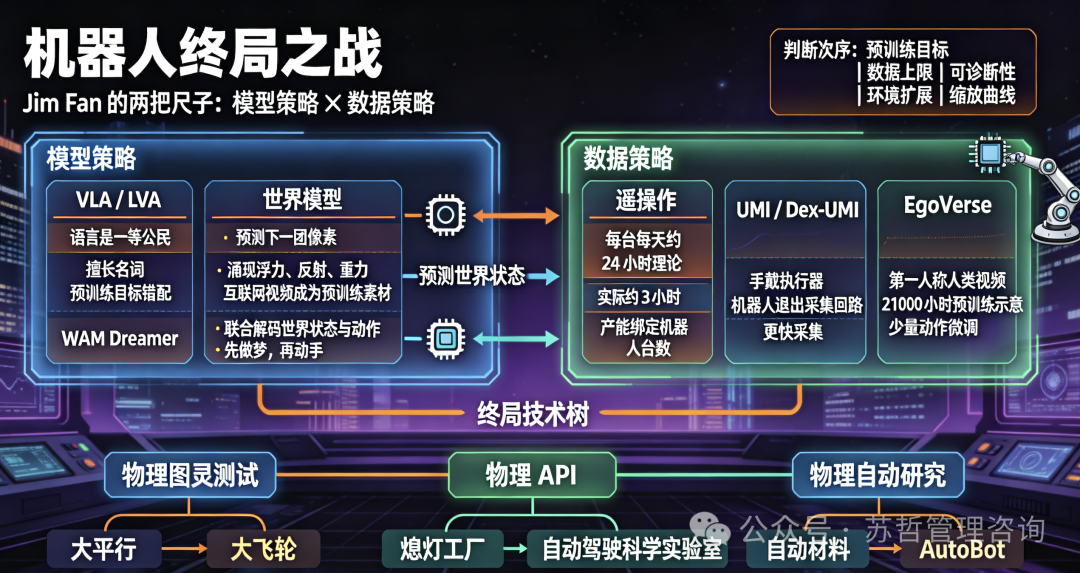
附录:Jim Fan 红杉 AI Ascent 演讲
NVIDIA 具身智能负责人 Jim Fan 的核心论断:VLA 范式已经走到尽头,通用机器人终局只有两大战场:模型学名词还是动词;数据上限绑定在机器人台数,还是绑定在人类本身。 他提出大平行(The Great Parallel):机器人完整复刻大语言模型的三阶段路线,把 “预测下一个 token” 替换为预测物理世界下一个状态,由此走向 WAM(世界动作模型 World Action Model)新范式。
一、模型战场:VLA 为什么落幕,WAM 是什么
VLA(视觉 - 语言 - 动作)的本质缺陷:名为 VLA,实为 LVA
主流 VLA 做法:在预训练 VLM(视觉语言模型)上嫁接动作头。绝大多数参数都给了语言,语言是一等公民,视觉、动作是附属。
- 优势:擅长识别物体、名词理解、理解文本指令;
- 短板:不理解物理、不懂动词。能认出泰勒・斯威夫特海报,能看懂指令,但是预判不了碰撞、浮力、物体倾倒这类动态物理交互;预训练学的是静态名词知识,不是世界动态演化。
WAM(世界动作模型,Dreamer/DreamZero):模型要学动词
WAM 核心机制:联合解码下一帧世界画面 + 下一时刻机器人动作。机器人行动前先在模型内部 “做梦” 推演未来几秒物理演化,基于模拟结果输出动作。
- 物理规律(重力、浮力、反射)不是人工编码,从海量互联网视频像素预测中自发涌现(Veo-3 为证据);
- 可诊断性:模型 “梦出来” 的画面可以可视化。视频预测准,动作就成功;视频幻觉,动作失败,把策略失败从单纯的成功率数字,变成可观测、可定位的问题;
- 当前阶段类比:WAM 大致处在 GPT-2 的水平,证明可行性,但远未成熟。
大平行三阶段(对标 LLM):
- 世界建模预训练:Simulating,预测下一个物理世界状态(对标 GPT-3 next token 预训练)
- 动作微调:Aligning,把模拟空间对齐到真实机器人可执行的动作空间(对标 InstructGPT 监督微调)
- 物理强化学习:Surpassing,通过仿真试错突破模仿学习天花板(对标 o1 推理强化学习)
二、数据战场:遥操作是黄金时代,也是天花板
传统遥操作的致命瓶颈
遥操作靠人控制真机采集轨迹,看似好用,但产能被机器人硬件数量锁死。理论上限单台每天 24 小时,实际仅约 3 小时;想要 10 倍数据,就要购置 10 倍机器人,无法规模化。
两代破局方案,逐步把机器人移出数据采集回路
-
UMI(通用操控接口)→ Dex-UMI
人手持佩戴式夹爪 / 外骨骼,直接模拟机器人末端执行器采集动作,真机本体不参与数据采集闭环,大幅提升采集效率。衍生出 Generalist、Sunday Robotics 等独角兽。Dex-UMI 进一步做到五指灵巧手一对一映射。
-
EgoVerse(第一人称人类视频,演讲订正:网传 EgoScale 是口述误听)
训练配方极具颠覆性:预训练使用 21000 小时人类第一人称野外视频,零机器人真机数据;仅用 50 小时高精度动捕手套数据 + 4 小时遥操作做动作微调(遥操作占比不足千分之一)。核心思路:Ego-Exo 对齐——第一人称人类视角,和外部视角机器人,在同一场景、同相机视角下对齐。数据量级预测:遥操作(最小)< 可穿戴设备(数十万小时)< FSD 式第一人称人类视频飞轮(一年可达千万小时)。Jim 判断:未来 1–2 年,遥操作数据占比会下降到几乎可以忽略。
三、环境外环:DreamDojo 神经仿真器,算力 = 环境 = 数据
真机上跑强化学习成本极高,百万环境意味着百万台机器人。三层递进方案:
- 真机 RL:可靠,但硬件成本爆炸;
- Real-to-sim-to-real:手机扫描 3D 场景,在传统物理引擎重建、做数据增广,但受限于图形引擎;
- DreamDojo 神经仿真器:纯数据驱动的世界模型仿真,不需要手写物理方程、传统图形渲染。输入动作,直接生成完整场景像素与传感器信号,把仿真环境生成交给算力,实现无限环境试错。
四、终局技术树:三大里程碑(文明科技树比喻)
- 物理图灵测试(进度过半):无法区分任务是人还是机器人完成;衡量指标:单位能量输入,得到多少劳动产出。预测 2–3 年达成。子节点:大平行(The Great Parallel,已点亮)、大飞轮(The Great Flywheel,数据闭环)
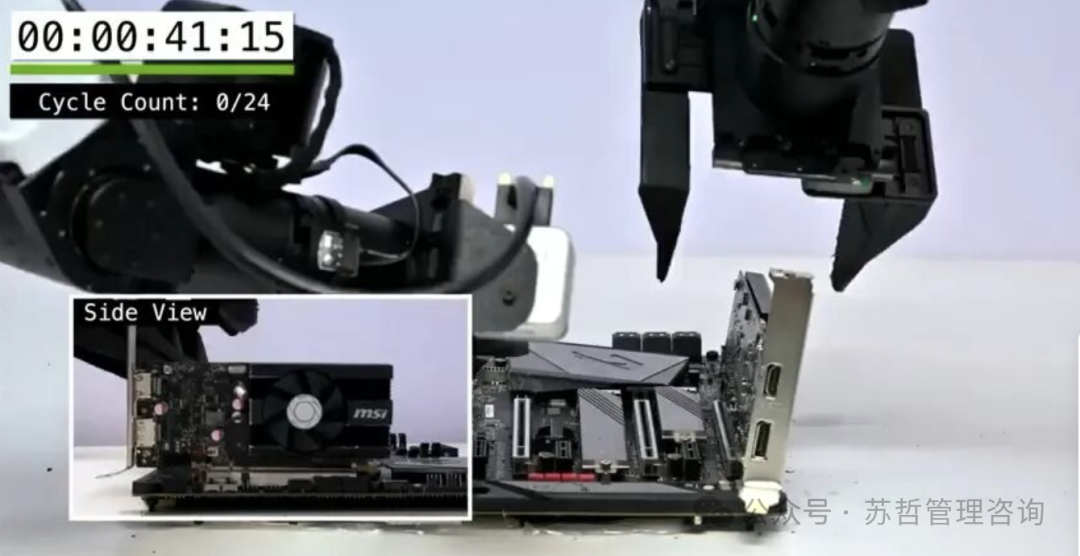
- 物理 API:机器人集群可以像软件一样用 API 编排调度;落地形态:熄灯工厂(原子打印机,输入图纸输出实物)、自动化化学 / 生物湿实验室。
- 物理自动研究:机器人自主设计、制造、迭代下一代机器人;输入能量,输出下一代机器人。
时间预测:95% 置信度,2040 年解锁全部终局节点;2026 正好处于从 AlexNet 到 2040 终点的中点。
五、评估项目的五把尺子(演讲最有工程价值部分)
判断任何机器人项目,依次问 5 个问题:
- 预训练目标预测什么?预测符号(名词)还是预测世界状态(物理动词);
- 数据上限绑定在哪?绑定机器人台数 = 天花板低;绑定人类第一视角视频,才有巨大缩放潜力;
- 策略失败能不能可视化诊断?有没有类似 Dreamer 的 “梦境画面”,而不是只有成功率;
- 环境数量是否能脱离硬件数量增长?真机 RL、传统仿真、神经仿真器,三者上限完全不同;
- 能不能画出清晰的 缩放定律 曲线,明确坐标轴(本次是训练步数 vs 人类验证集 MSE,不是泛化的投入 / 任务成功率)。
六、重要边界与前提(不能盲目采信)
- 整个大平行的根基假设:物理规律能从像素预测中自发涌现,目前只有 Veo-3、Dreamer 的实证,并非已经证明的科学定律;
- 缩放定律衡量的是验证集 MSE(误差),不等于真实任务成功率,中间存在 gap;
- 量级数据(21000 小时、千万小时数据飞轮)来自口述,没有现场图表;
- 立场提示:这是 NVIDIA 研究者的路线主张,天然偏向算力、世界模型、大规模视频预训练路线,属于前沿假说而非行业定论。
七、结尾金句
我们这一代人出生太晚,错过了探索地球的黄金年代;出生又太早,来不及探索星辰;但刚好赶上了解决机器人这个命题的时代。 If you believe in robotics, robotics will believe in you.
 发表于 15 小时前
|
查看: 16|
回复: 0


