2025 年,编程智能体真正走进了开发者的日常工作。
从 4 月 OpenAI 开源 Codex CLI 开始,Claude Code、Cursor、OpenCode 等工具陆续成为开发者终端里的“副驾驶”。
坦白说,我开始关注 Pi,是因为有点受够 Claude Code 了。
这话听起来矛盾。我喜欢 Claude Code,它改变了许多人写代码的方式,背后的团队也很出色。但我依赖它建立起来的工作流程,总会在某个时刻突然失灵。
我说的不是代码里又出现了几个 Bug,而是工具的运行框架发生变化,模型的行为也跟着变了。
作为工程师,我需要更可靠的工具。当然,在 2026 年谈大语言模型的可靠性,本身有点讽刺。模型的输出未必能完全确定,但至少有些部分应该由我控制:工具定义、系统提示词,以及最终被注入上下文的内容。
Claude Code 和 OpenAI Codex 都会在界面之外,悄悄向上下文加入大量信息。你看不到它们,却可能在工作流程出现微妙变化时,感受到它们的影响。
这些产品的更新频率有时是一天一次,甚至一天多次。上午 9 点,你的流程运行得很好;10 点,它突然出问题;到了下午 3 点,同一个任务又表现得完全不同。
模型未必换了。变的可能只是模型外面的运行框架。
过去一年,Claude Code、OpenCode 和 Codex 几乎每个月都在增加新功能:MCP、子智能体、计划模式、后台执行……
能做的事越来越多,弄清楚背后究竟发生了什么,却越来越难。
Pi 选择了相反的方向。它在 GitHub 上已经获得超过 9.9 万颗星。创建者 Mario Zechner 曾因 Java 游戏框架而为人熟知;由于不满意现有编程智能体,他索性从头写了一套给自己用。
Pi 的设计原则可以概括为一句话:如果我不需要,就别把它做进去。
现有工具会在幕后不断注入上下文,让用户难以看清模型到底接收了什么。这正是 Mario 想改变的事。
Pi 的极简思路从哪里来?
Mario 在介绍 Pi 之前,研究过 Terminal Bench 排行榜。他注意到一个名为 Terminus 的运行框架:它只给大语言模型提供一种与 tmux 会话交互的工具。
模型必须自己发送按键,读取 tmux 返回的 ANSI 序列,再一步步完成任务。
就靠这一种工具,Terminus 却几乎总能进入前三,有时甚至排在第一。
这带来一个重要启发:如今的模型经过大量强化学习训练,本身已经很熟悉编程智能体该如何工作。我们未必需要在外面再堆上一层又一层复杂设计。
Pi 就是这种想法的体现:核心尽可能小,扩展能力却要足够强。
Pi Agent 到底特别在哪
Pi 最显眼的地方,是它有意不提供许多其他编程智能体默认内置的功能。
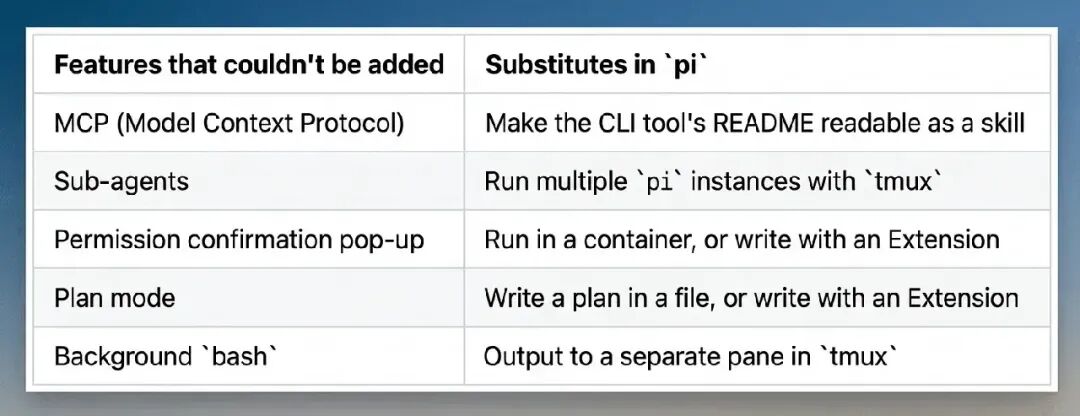
不是没来得及做,而是决定不加。
Zechner 在博客中谈过自己对 MCP 的疑虑:问题不在协议本身,而在它占用的 Token。
按照他列出的例子,Playwright MCP 有 21 个工具,工具定义约占 13,700 Token,相当于上下文窗口的 7%~9%;Chrome DevTools MCP 则有 26 个工具,约占 18,000 Token。
连接 MCP 服务器后,这些工具定义可能在每次会话中一起进入上下文。可 CLI 工具通常已经有 README,真正需要时再读取、再运行即可,为什么要让它们一直占着位置?
Pi 对子智能体也有类似看法。
Claude Code 可以在内部启动子智能体,最后只把摘要交还给你。任务完成了,但中间做过什么,外部不一定看得清。
Pi 则可以借助 tmux,把多个实例并排显示。每一次交互,人都能直接阅读。
系统提示词也是一样。许多运行框架会频繁修改提示词和工具定义,用户却无法控制进入上下文的具体内容。Pi 将系统提示词限制在 1000 Token 以内,并完整公开其内容。
贯穿这些决定的原则很简单:运行框架不应该替用户规定工作方式。缺少什么能力,用户可以自己加。
OpenCode 和 Claude Code 没有的设计
Pi 用的是“做减法”的思路,但这不代表它只能提供最基础的功能。它也有一些值得单独拿出来说的设计。
在同一会话中切换模型
Pi 会以不依赖特定供应商的格式保存 Context。
你可以用 Anthropic 的模型开始工作,中途切换到 OpenAI,而不必丢掉已有上下文。输入 /model 或按 Ctrl+L,就能切换。
不同厂商的思考设置,也被映射到统一的等级中。Claude 的扩展思考、OpenAI 的推理强度、Gemini 的思考预算,都可以放在从 minimal 到 xhigh 的五档尺度上理解。
JSONL 树状会话
Pi 把会话历史保存为 JSONL 文件。每条记录都有 id 和 parentId,连接起来便是一棵树。
通过 /tree,你可以回到过去任意一个节点,再从那里发展出另一条分支。
这有点像 Git 分支,只不过整段对话历史仍保存在同一个文件里。如果半小时前的做法其实更好,你不必重新开一轮会话、再把背景从头讲一遍。
PiPops
扩展、Skills、提示词模板与主题,可以通过 npm 或 git 一起分发。
pi install npm:@foo/pi-tools
pi install git:github.com/user/repo
pi config  # 启用或禁用
也就是说,Pi 不只是允许用户自己扩展,还为社区分享扩展提供了现成的安装方式。
扩展机制
Pi 的核心很小,却依然能应对复杂工作,原因在于它提供了不同层次的扩展方式。
其中,Extensions 最灵活。你可以用 TypeScript 编写自定义工具、命令、快捷键和事件处理器,也能在工具调用前后加入钩子。
例如,想让危险命令在执行前必须经过确认,可以编写类似下面的扩展:
import { ExtensionAPI } from "@mariozechner/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.on("tool_call", async (event, ctx) => {
    if (event.toolName === "bash"
        && event.input.command.includes("rm -rf")) {
      const ok = await ctx.ui.confirm(
        "Dangerous!", "Allow rm -rf?"
      );
      if (!ok) return { block: true, reason: "Blocked" };
    }
  });
}
这不是说权限确认不重要。恰恰相反,Pi 让你能够按照自己的判断标准,决定什么时候确认、拦截什么操作。
Skills 则是符合 Agent Skills 规范的 SKILL.md 文件,与 Claude Code 中的技能采用相近的组织方式。
提示词模板是可以重复使用的 Markdown 文件,通过 /templatename 展开,还可以使用 {{variable}} 这样的 Mustache 变量。
1. 基础安装
安装 Pi,只需要一条命令:
npm install -g --ignore-scripts @earendil-works/pi-coding-agent
也可以使用安装脚本:
curl -fsSL https://pi.dev/install.sh | sh
身份验证主要有两种方式。
第一种是使用 API Key:
export ANTHROPIC_API_KEY=sk-ant-...
pi
第二种是使用已有订阅,在 Pi 中选择供应商登录:
pi
/login
Anthropic Claude Pro/Max、OpenAI ChatGPT Plus/Pro 对应的 Codex 权限,以及 GitHub Copilot 等已有订阅,都可以通过相应方式接入。
这一部分想表达的重点很明确:Pi 的入门门槛不高。装好、登录,然后开始与它交互即可。
2. 模型配置
这部分花了大约 9 分钟,因为 Pi 支持 15 家以上的大模型服务商。主要包括:
Anthropic
OpenAI
Google Gemini / Vertex
DeepSeek
xAI
OpenRouter
Amazon Bedrock
Azure OpenAI
Groq / Cerebras / Mistral 等
工作做到一半再换模型,在 Pi 中属于正常操作:
/model     # 打开模型选择界面
Ctrl+L     # 同样打开模型选择界面
Shift+Tab  # 切换思考强度
自定义供应商可以配置在 ~/.pi/agent/models.json。如果接口兼容 OpenAI、Anthropic 或 Google 的 API 格式,通常可以通过配置接入;本地模型也可以经由 llama.cpp 一类服务连接。
Pi 在这一点上强调的是:你的工作流程,不应该被锁死在某一家模型供应商手里。
3. 会话管理
Pi 会将会话保存为树状结构的 JSONL 文件,通常放在 ~/.pi/agent/sessions/ 中。不同消息借助 id 和 parentId 形成关联。
这种结构让一段会话可以拥有多条探索路径,同时仍保留在单个历史文件里。
常用命令包括:
pi -c  # 继续最近一次会话
pi -r  # 从历史会话中选择
会话进行中,还有一组用于查看和管理历史的命令。
其中最有意思的,是 /tree。
你可以回到对话中的任意位置,从那里重新分出一条路线。假如突然发现“30 分钟前那个方向才是对的”,不必只靠复制粘贴来挽救,直接回到对应节点即可。
/compact 则用于总结旧消息、压缩上下文。默认情况下,Pi 也会自动压缩;如果出现上下文溢出,还能尝试恢复并重试。
压缩不会抹掉保存在 JSONL 中的完整历史。你依然可以通过 /tree 找回之前的分支。
4. 插件扩展
这部分用了大约 10 分钟讲扩展,因为这里才真正体现出 Pi 的设计思路。
它的自定义能力可以分为四层:
Extensions(TypeScript)→ 工具、命令、界面和事件处理
Skills                  → 用 Markdown 编写的流程与指令
Prompt Templates        → 可复用的提示词
Themes                  → 显示主题
包管理命令也很直接:
pi install npm:@foo/pi-tools
pi install git:github.com/user/repo
pi list
pi update --all
通过 Extensions,你可以添加自定义工具,甚至替换内置工具;也可以按自己的方式实现子智能体和计划模式,设置权限关卡或路径保护,增加状态栏、页眉、页脚,制作 Git 检查点与自动提交,或者接入 MCP 服务器。
有人甚至做出了等待任务运行时玩 Doom 的扩展。
这部分真正重要的,不是 Pi 能装多少插件,而是:其他产品直接内置的子智能体、计划模式、权限弹窗,在 Pi 里可以由用户通过扩展决定如何实现。
因此,Pi 才能始终保持一个足够小的核心。
5. Skills
Skills 可以理解为用 Markdown 编写的“能力包”。
按照 Agent Skills 规范,一个包含 SKILL.md 的文件夹,就能构成一项技能。例如:
<!-- ~/.pi/agent/skills/my-skill/SKILL.md -->
# My Skill

Use this skill when a user asks about X.

## Steps

1. Perform this action.
2. Then perform that action.
除了使用 /skill:name 显式调用,任务匹配时,智能体也可以按需加载技能。
关键在于“按需”二字。
Pi 不会把所有技能说明一股脑塞进系统提示词。只有用到时,相关内容才进入上下文。这也是它能够把基础系统提示词维持在约 1000 Token 的原因之一。
6. Pi Web:浏览器界面
Pi 的浏览器界面 Pi Web,可通过以下命令启动:
npx @agegr/pi-web@latest
它提供的能力包括:
- 按项目列出、恢复、重命名和删除历史会话。
- 从某条消息新建会话,或在当前会话内创建分支。
- 查看项目文件和 Git 差异。
- 切换 Git worktree。
- 在网页中配置供应商登录、模型、扩展包和 Skills。
由于它与终端版 Pi 共享 ~/.pi/agent 中的配置和会话文件,因此,你可以根据场景在浏览器与终端之间切换,不必维护两套历史记录。
7. 记忆系统
有关“记忆”的讨论,最后落到了一个相当朴素的方案:
Pi 不一定需要单独建立一个长期记忆数据库。
1. 会话本身就是记忆

完整历史保存在 JSONL 中,随时可以恢复。
2. AGENTS.md / CLAUDE.md

把项目约定、指令与常用命令写进这些文件。
启动时可按全局设置和目录层级加载。

3. 上下文压缩

长会话会对早期内容进行总结。
但完整历史依然留在 JSONL 中,可以通过 /tree 返回。
两者分工很清楚:
“我们之前做过什么”,交给会话历史保存。
“希望智能体一直记住哪些规则”,写进 AGENTS.md。
如果你的项目确实需要更复杂的长期记忆,也可以再通过扩展加入,而不是要求所有用户从一开始就承担这套复杂度。
8. 安全使用
这一点必须认真看:Pi 没有内置沙箱。
文件读取、写入、编辑以及 Bash 命令,默认都以启动 Pi 的用户权限运行。扩展也是如此。
这并非遗漏,而是一项有意为之的设计决定。Pi 的立场是:一个不够完善的进程内沙箱,很可能只会制造“看起来安全”的错觉。真正的隔离,应交给操作系统、容器或虚拟机处理。
因此,面对不可信代码仓库,或者准备让智能体无人值守地执行任务时,需要特别强调使用隔离环境。
一种方式,是把整个 Pi 环境放进 Docker;另一种方式,是让 Pi 运行在宿主机上,但把实际工具执行转发到本地微型虚拟机,例如 Gondolin:
pi -e ~/.pi/agent/extensions/gondolin
Pi 还有一项名为 project trust 的机制。它主要用于在读取项目输入时提醒用户,防止未经验证的仓库直接覆盖 Pi 的配置或扩展;默认情况下,对未受信任项目会要求确认。
不过,这并不能彻底防住提示词注入。
当智能体处理来源不明的代码和文档时,仍应把内容本身视为不可信输入。
9. 写一个自己的插件
最后大约 5 分钟进入实践:亲手写一个扩展。
最简单的扩展,只需要一个 TypeScript 文件。例如,注册一个名为 deploy 的工具:
export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "deploy",
    // 工具定义:输入结构与执行逻辑
  });
}
你还可以注册命令,或者监听工具调用事件:
pi.registerCommand("stats", {
  // 自定义命令
});

pi.on("tool_call", async (event, ctx) => {
  // 拦截并处理工具调用
});
将扩展放进用户级目录 ~/.pi/agent/extensions/,或项目级目录 .pi/extensions/,Pi 启动时便会加载。若只是临时测试,也可以使用:
pi -e ./my-ext.ts
官方仓库中已经提供自动提交、Git 检查点、MCP 接入以及自定义上下文压缩等大量示例。
在 Pi 的世界里,“想要的功能默认没有”不是异常,而是预期。你可以自己加,也可以安装社区提供的包。
最后
Pi 至少提醒了我三件事。
第一,功能越多,用户看不见的过程也往往越多。
子智能体、后台执行、自动压缩都很方便,但每增加一层自动化,就可能多出一个黑箱。Pi 更重视让人直接看到交互是如何发生的。
第二,如果你也在构建自己的编程智能体,Pi 提供了一种值得参考的起点:先用少量工具和一份约 1000 Token 的系统提示词跑起来,再根据真实需求逐步扩展。
第三,设计一个智能体,未必总要从“还能加什么”开始。
有时候,更重要的问题是:哪些东西根本不该默认存在?
 发表于 7 天前
|
查看: 1|
回复: 0


