前言
很多团队在用上 AI 编程工具之后,都会遇到这个瓶颈:AI 的“短期记忆”够了,但“长期记忆”没有。
每次任务都是一次全新的开始,之前积累的理解完全浪费。
2026 年 7 月,LangChain 开源了 OpenWiki,专门解决这个问题。
开源 5 天就冲到了 9K+ Star ,到今天已经积累了超过 16,500 Star 。
这篇文章,我就把 OpenWiki 为什么越来越多人用的原因,从头到尾给你拆解一遍。
一、OpenWiki 到底是什么?
有些小伙伴可能会说:“Wiki 我知道,Confluence、语雀不都是 Wiki 吗?有什么新鲜的?”
传统 Wiki 是写给人看的。
你打开一个项目的 Confluence 页面,看到的是人类写的介绍文档——架构概述、部署指南、API 说明。这些文档的读者是开发者,写作风格是散文式的。
OpenWiki 的读者不是人,是 AI Agent。
它是一个命令行工具,扫描你的代码库,然后用 LLM 生成一套 Markdown Wiki。
但它生成的 Wiki 不是给人读的“说明文档”,而是给 AI Agent 读的“上下文记忆”。
一句话说清: OpenWiki 是 AI 编程 Agent 的“长期记忆系统”——把代码库的结构、架构、依赖关系“编译”成一套 Agent 可以快速查阅的 Wiki,让 Agent 不用每次都从头翻代码。
LangChain 官方对 OpenWiki 的定位非常精准:“An agent reads your sources, synthesizes a linked Markdown wiki you own, and keeps it current on every change.”
二、一张图看懂 OpenWiki 的核心架构
在深入代码之前,我们先建立一个整体认知。
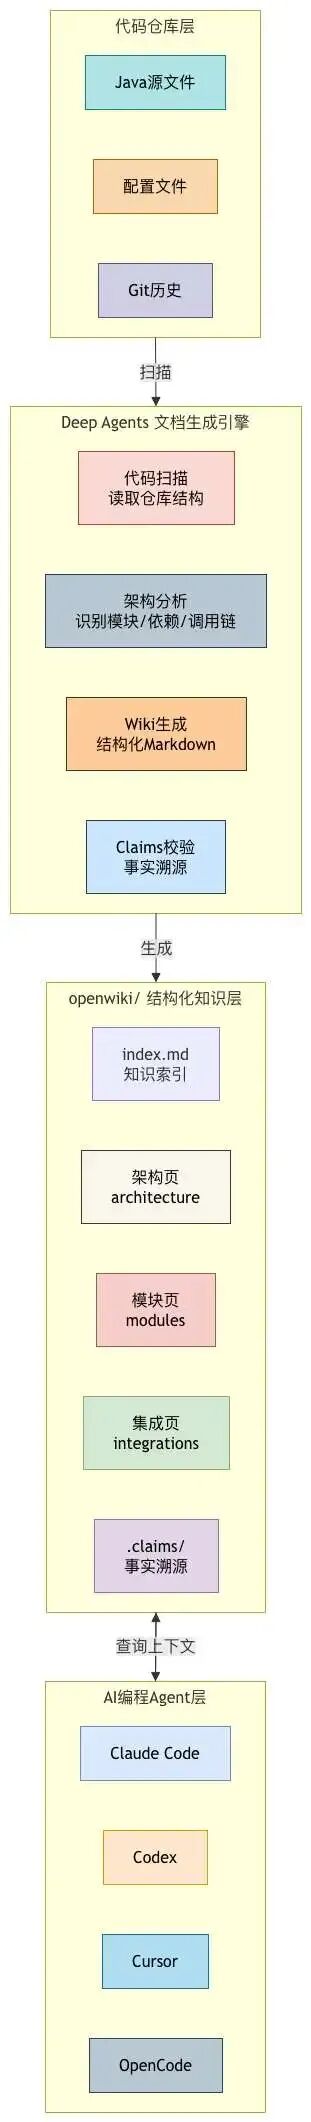
OpenWiki 的核心架构分为 三层:
第一层:代码仓库层——只读不改,保留原始代码和 Git 历史。
第二层:Deep Agents 文档生成引擎——一个基于 LangChain Deep Agents 构建的 Agent,负责扫描代码、分析架构、生成 Wiki,并通过 Claims 机制保证每条事实都有据可查。
第三层:结构化知识层——生成在 openwiki/ 目录下的 Markdown Wiki,包含架构页、模块页、集成页等,每条事实都放在 openwiki/.claims/ 下进行溯源。
三、核心设计理念
为 Agent 写文档,不是为人写文档。
这是 OpenWiki 最反直觉、也最关键的设计决策。
传统项目文档是给人看的。人类读文档,能容忍模糊、能脑补上下文、能从散乱的段落中提取信息。
但 Agent 不行。Agent 的上下文窗口是有限的,每一行无用信息都在消耗宝贵的 Token。
如果文档里塞满了人类喜欢的“叙事铺垫”和“背景介绍”,Agent 读起来效率极低。
OpenWiki 的设计原则完全不同:输出不是供人类阅读的散文,而是针对 LLM 上下文优化的结构化 Markdown。每一页都经过精心组织,让 Agent 能 快速定位到相关上下文。
具体体现在几个方面:
Claims 机制——每条事实性陈述都关联一个 Claim,记录它来自哪个文件的哪一行。LLM 如果总结错了,你可以直接溯源验证。
OKF 格式支持——OpenWiki 0.2 版本全面支持 Google 的 Open Knowledge Format(OKF),每个 Markdown 概念都带有 YAML front matter,类型信息明确,方便 Agent 解析。
自动更新机制——代码变了,Wiki 跟着变。openwiki --update 会刷新过时的 Claims,保持 Wiki 和代码同步。
多语言支持——支持用 --language <locale> 生成其他语言的文档,但代码和标识符保持原样。
四、底层原理
Deep Agents + 确定性工程。
OpenWiki 建立在 LangChain 的 Deep Agents 之上,但它不是“把代码丢给 LLM 让它自由发挥”那么简单。
它的工作流是 Agent 驱动 + 确定性工程 的混合模式。
4.1 生成流程
当你在项目根目录运行 openwiki --init 时,背后的流程是这样的:

第一步:代码扫描——扫描仓库结构,收集 Git 上下文(分支、提交历史、变更文件)。
第二步:架构分析——Deep Agents 会话读取代码库,识别模块划分、依赖关系、调用链路、集成点。
第三步:Wiki 生成——生成结构化的 Markdown 页面,包括架构概览、模块说明、集成指南等。
第四步:Claims 校验——每条事实性陈述关联一个 Claim,记录来源文件和行号,保证可溯源。
第五步:写入文件——Wiki 写入 openwiki/ 目录,同时在仓库根目录的 AGENTS.md 和 CLAUDE.md 中插入指针,让 AI 编程 Agent 知道“先读 Wiki 再干活”。
4.2 增量更新机制
openwiki --update 不是从头重新生成,而是 增量更新。它会对比代码变更和 Wiki 中已有的 Claims,只更新过时的部分,重新校验受影响的页面。
这个机制的核心价值在于:Wiki 的维护成本随代码量线性增长,而不是指数增长。 代码加了一个新模块,只需要更新相关的几页,不需要整个 Wiki 重写。
4.3 CI 自动化
OpenWiki 提供了 GitHub Actions、GitLab CI 和 Bitbucket Pipelines 的示例工作流。你只需要把示例文件复制到对应目录,每次代码提交后,CI 会自动运行 openwiki --update,然后开一个 PR 把 Wiki 更新提交上去。
这意味着 Wiki 永远不会过时。 代码改了,Wiki 自动跟着改,不需要人工维护。
五、5 分钟跑通 OpenWiki
5.1 安装
OpenWiki 是一个 Node.js CLI 工具,需要 Node 22+:
npm install -g openwiki
Windows 用户建议用 npm 或 pnpm 安装,bun 安装可能会触发 better-sqlite3 的原生编译,需要 Visual Studio Build Tools。
5.2 初始化代码库 Wiki
在 Java 项目根目录运行:
openwiki --init
首次运行会引导你选择推理提供商(OpenAI、Anthropic、Bedrock、Gemini 等 12 种)、输入 API Key、选择模型,然后自动扫描代码库并生成 Wiki。
生成后的目录结构:
your-project/
├── openwiki/
│   ├── index.md              # 知识索引
│   ├── architecture.md       # 架构概览
│   ├── modules/              # 各模块说明
│   ├── integrations.md       # 集成点
│   ├── .claims/              # 事实溯源
│   └── INSTRUCTIONS.md       # Wiki生成指令
├── AGENTS.md                 # Agent指令(自动更新)
└── CLAUDE.md                 # Claude Code指令(自动更新)
5.3 查看生成的 Wiki
在浏览器中可视化浏览 Wiki:
openwiki visualize
这会打开一个本地的交互式节点图,左侧是 Wiki 页面树,右侧是 Markdown 阅读器,可以直观地看到各页面之间的关联关系。
5.4 保持 Wiki 更新
代码变更后更新 Wiki:
openwiki --update
在代码模式下,更新还会 调和过时的 Claims——如果源文件的证据变了,对应的 Wiki 页面会自动更新。
5.5 CI 自动化配置
把 OpenWiki 的 GitHub Actions 工作流复制到项目中:
# 从OpenWiki仓库复制示例
cp examples/openwiki-update.yml .github/workflows/openwiki-update.yml
配置 OPENROUTER_API_KEY 等环境变量后,每次代码提交都会自动更新 Wiki 并开 PR。
5.6 个人知识库模式
除了代码库,OpenWiki 还支持个人知识库模式:
openwiki personal --init
它会从配置的数据源(本地 Git 仓库、Gmail、Notion、Web 搜索、Hacker News、X/Twitter)中摄取知识,生成一个本地个人知识库,存储在 ~/.openwiki/wiki。
六、OpenWiki 与 LLM Wiki 的关系
有些小伙伴可能会问:“LLM Wiki 不是 Karpathy 提出的概念吗?OpenWiki 跟它什么关系?”
OpenWiki 是 LLM Wiki 理念的第一个完整工程实现。
Karpathy 在 2026 年初提出了“LLM Wiki”的方法论——把知识“编译”成结构化 Wiki,而不是每次查询都从零检索。OpenWiki 就是 LangChain 照着这套思路做出来的 CLI 工具。
| 对比维度 |
传统RAG |
OpenWiki(LLM Wiki) |
| 知识组织 |
向量碎片 |
结构化Markdown页面 |
| 更新方式 |
每次查询重新检索 |
增量更新Claims |
| 可审计性 |
弱(黑盒检索) |
强(Claims溯源) |
| 知识积累 |
用完即弃 |
编译一次、持续复用 |
| Agent友好度 |
需检索后拼接 |
直接读Wiki |
RAG 是“解释器模式”,每次执行都从头解析。OpenWiki 是“编译器模式”,编译一次、反复使用。
七、优缺点
优点
1. 为 Agent 而生,不是为人而生——输出是结构化 Markdown,针对 LLM 上下文优化。Agent 读 Wiki 比翻代码快得多,Token 消耗大幅降低。
2. Claims 溯源,事实可验证——每条事实性陈述都关联来源文件和行号。LLM 如果总结错了,你可以直接溯源验证。
3. 自动更新,永不过时——支持 GitHub Actions、GitLab CI、Bitbucket Pipelines。代码改了,Wiki 自动跟着改。
4. 支持 12 种模型提供商——从 OpenAI、Anthropic 到 Bedrock、Gemini,还可以接任何 OpenAI 兼容的网关。不锁定任何一家。
5. 内置连接器丰富——支持 Custom MCP、Notion、Slack、Gmail、X、Web Search、Hacker News、本地 Git 仓库等数据源。
6. OKF 格式,标准化输出——全面支持 Google Open Knowledge Format,每条概念都有明确的类型信息。
7. 可视化节点图——openwiki visualize 把 Wiki 变成可交互的节点图,人类也可以浏览。
8. 完全开源,MIT 协议——可自由使用、修改、商用。
9. 与 AI 编程工具无缝集成——自动在 AGENTS.md 和 CLAUDE.md 中插入指针,Claude Code、Codex、OpenCode、Cursor 都能发现并查阅 Wiki。
10. 个人知识库模式——除了代码库,还支持从 Gmail、Notion、X 等数据源构建个人知识库。
缺点
1. 需要 Node.js 22+ 环境——对于老项目或没有 Node 环境的团队,需要额外安装。
2. 编译过程消耗 Token——每次 --init 和 --update 都是一次完整的 LLM 分析过程,Token 消耗不低。
3. 中文文档生成支持有限——虽然支持 --language 参数,但中文生成的 Wiki 质量可能不如英文。
4. 生态仍在早期——虽然 Star 数增长很快,但社区插件和第三方集成还在发展中。
5. 需要 Schema 设计能力——openwiki/INSTRUCTIONS.md 定义了 Wiki 的生成范围和质量标准,写得不好会导致 Wiki 组织混乱。
八、适用场景
| 场景 |
推荐程度 |
理由 |
| 大型代码库的AI编程 |
✅✅✅ 强烈推荐 |
让Agent有持久上下文,不用每次翻代码 |
| 多Agent协作项目 |
✅✅✅ 强烈推荐 |
所有Agent共享同一套Wiki记忆 |
| 团队知识沉淀 |
✅✅✅ 强烈推荐 |
把代码理解编译成可复用的Wiki |
| 个人知识管理 |
✅✅✅ 强烈推荐 |
从Gmail/Notion/X构建个人知识库 |
| CI/CD自动化 |
✅✅✅ 强烈推荐 |
代码提交自动更新Wiki |
| 快速上手陌生项目 |
✅✅✅ 强烈推荐 |
openwiki --init 一键生成项目Wiki |
| 对Token成本敏感的团队 |
✅✅ 推荐 |
编译一次、反复使用,长期省Token |
| 一次性查询场景 |
⚠️ 需评估 |
RAG更轻量,不需要前期编译成本 |
| Node环境受限的项目 |
⚠️ 需评估 |
需要Node 22+,老项目需额外配置 |
九、写在最后
回到最初的问题:为什么越来越多人用 OpenWiki?
答案其实不复杂——因为它解决了 AI 编程时代一个被忽视的核心问题:Agent 的长期记忆。
AI 编程工具越来越强了,但它们的“短期记忆”够了,“长期记忆”没有。每次任务都是一次全新的开始,之前积累的理解完全浪费。
你花时间让 AI 理解的项目架构,下个任务它完全不记得。
OpenWiki 做的事情,就是 把代码库“编译”成一套 Agent 可以快速查阅的 Wiki。编译一次,反复使用。代码变了,Wiki 自动跟着变。每条事实都有溯源,你可以验证,也可以审计。
RAG 让 AI 帮你找答案,OpenWiki 让 AI 记住你的项目。
开源地址:
 发表于 3 天前
|
查看: 1|
回复: 0


