继续聊自进化。最近 RSI(递归自我改进)这一波讨论很热,相关论文综述也逐渐出来了。此前这个概念我一直没有完全理清,这次顺手做一次补充梳理,先抛几个结论:
其一,更新机制早就不是瓶颈了,评估才是。 因为评估环是整个系统里唯一不能靠自身能力解决的环节。
其二,现在绝大多数“递归自我改进”演示仍停在结构层。 机制确实改了,也继承下来了,但没有证据表明改过的机制真的产出了更强后继。
其三,整个自进化工程,本质上是在为人造出来的“锚”争取可信度。 锚在哪?环外是编译器、测试、实验、客观指标,这还算比较可信;环内是 LLM 给自己打分,很容易退化。任何“自进化”的宣传手法虽然各异,但做的都是同一件事:让那个不可自我修改的锚尽量靠近真值,谁把锚做扎实谁赢。
其四,得算经济账。 成本账平不平?单次增益摊薄到算力和人工上,是不是仍然为正。
所以本质上,这些问题最后都指向评估。这个领域真正的前沿,不在于“怎么让 AI 改自己”——这件事已经能做到;而在于怎么造出一个 AI 骗不过的裁判。 这才是卡住所有人的地方。下面展开来谈。
一、什么叫模型自进化?从 2 个综述说起
目前自进化方向热度很高,陆陆续续也出现了一些综述性论文,下面这两篇比较有代表性。
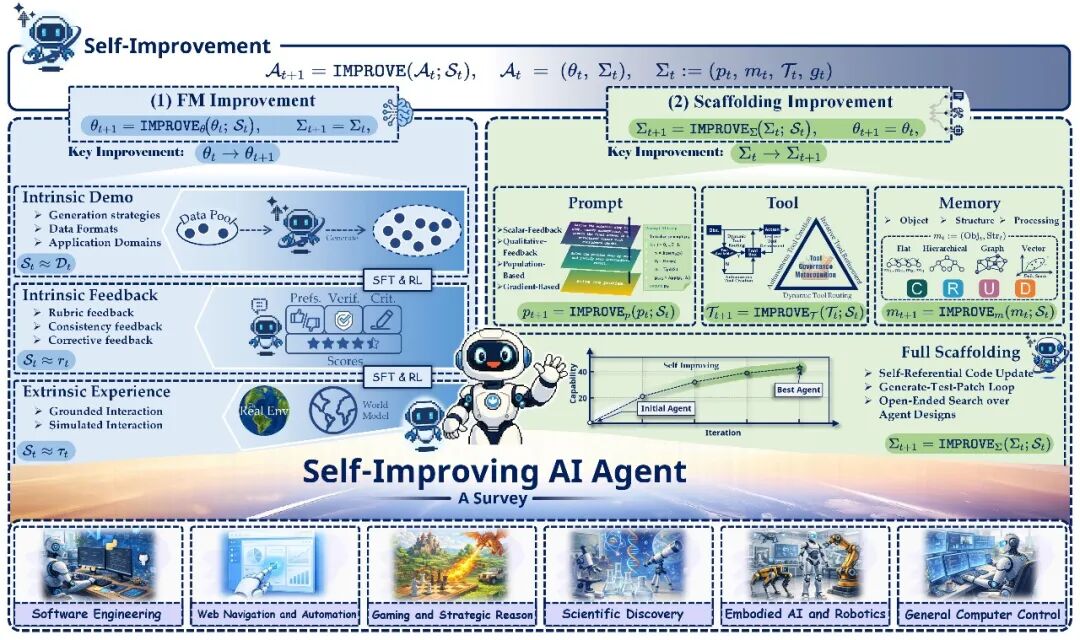
1、Agent 自改进
综述《Self-Improvements in Modern Agentic Systems: A Survey》,论文地址: https://arxiv.org/pdf/2607.13104 ,代码仓库: https://github.com/selfimproving-agent/awesome-Self-Improving-Agents ,项目主页: https://selfimproving-agent.github.io 。
2、递归自改进
综述《The Last AI Built by Humans — Toward Genuine Recursive Self-Improvement》,论文地址: https://arxiv.org/pdf/2609.11873 ,项目主页: https://theseus-labs-rsi.github.io/ ,代码仓库: https://github.com/theseus-labs-rsi/awesome-rsi 。
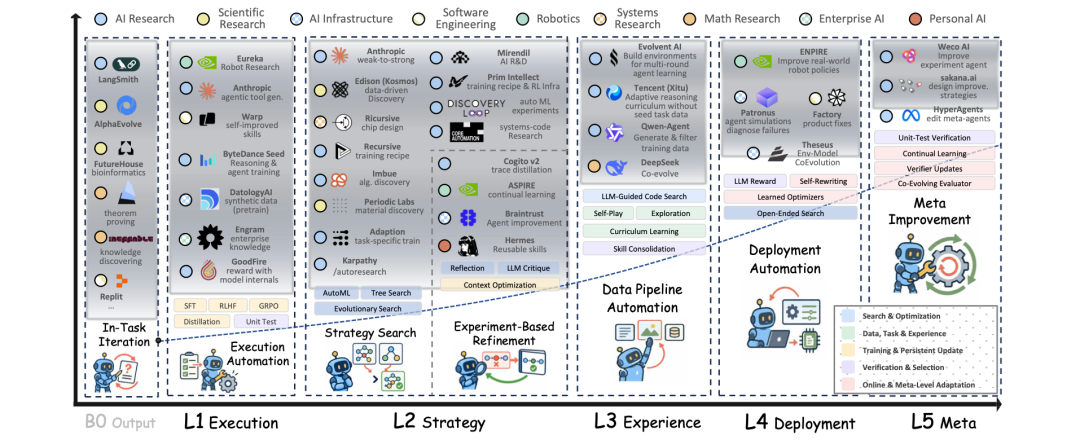
这两篇分别讨论了 Agent 的自我改进和模型的自我改进,内容比较烧脑,具体细节这里不做展开。还是回到几个更本质的问题上。
探究本质时,首先要问的是:一个系统要“自我改进”,最低限度需要什么?
从控制论和学习理论看,任何自我改进系统都必须闭合一个环:执行 → 评估 → 归因 → 更新 → 再执行,也就是下面这张图:
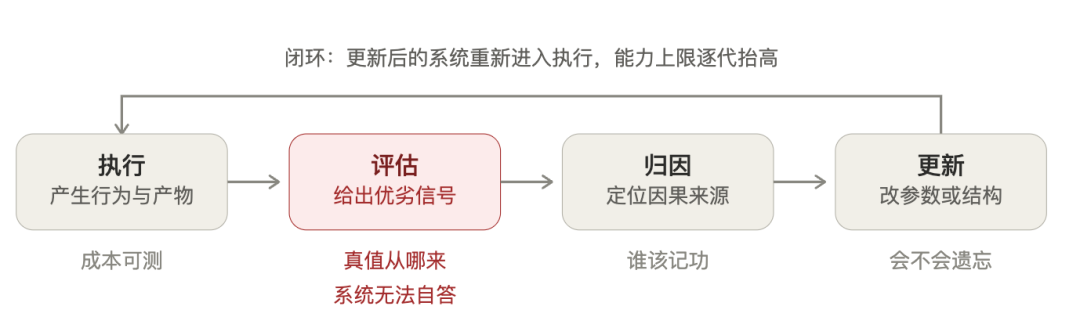
这四个环节缺一不可:
- 没有执行,就没有行为可以改进;
- 没有评估,就不知道改进的方向,这是“信号从哪来”的问题;
- 没有归因,就不知道是什么导致了好坏,也就是 credit assignment 问题;
- 没有更新,就改不动,这是“改什么”的问题。
因此,自进化的瓶颈从来不在“更新”环节,而在“评估”环节。
这里需要想一下为什么。因为另外三个环节早就工程化了:执行可以沙箱跑,归因可以靠 diff 和日志,更新可以靠梯度或代码重写。这些都是廉价、成熟、可自动化的。
真正稀缺的只有一样东西:一个廉价、可靠、骗不过的评分器。 整个自进化工程的难点,从来不是“怎么改”,而是“凭什么知道改对了”。
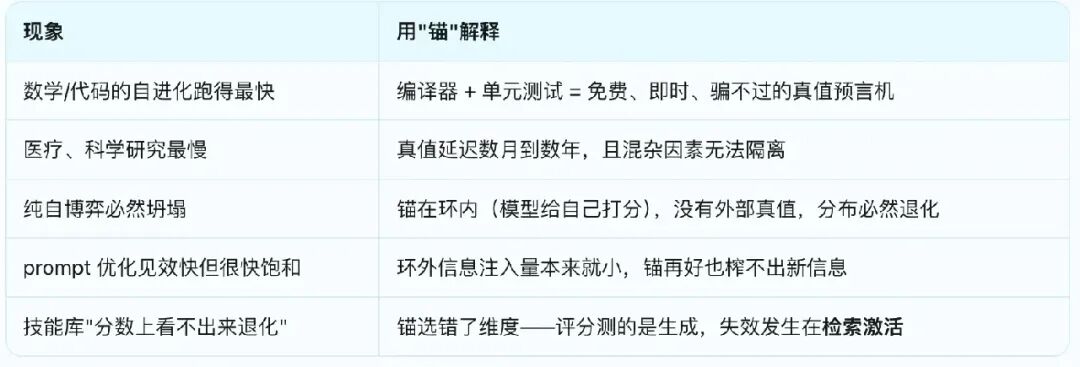
这就是为什么:数学/代码领域自进化跑得快,因为编译器 + 单元测试等于免费的真值预言机;医疗/科学研究慢,因为真值延迟数月、混杂因素多、不可复现;纯自博弈必然坍塌,因为 LLM-as-judge 是自我指涉的,没有外部真值,分布必然漂移。
Schmidhuber 1997 年的 Gödel Machine 早就点破了这点:什么都能改,唯独不能改证明机制(proof searcher)。 因为一旦允许改证明机制,整个系统就失去了“改进是否真的发生”的判据。
因此,可以给出一个答案:自进化 = 在某个不可自我修改的验证锚之上,闭环地提升能力上限。没有这个锚,就不是自进化,而是自我指涉的漂移。
二、目前这种自进化又是怎么做的?
基于上面的界定,可以从架构层面将这种自进化的实现拆成几层,如下图所示:
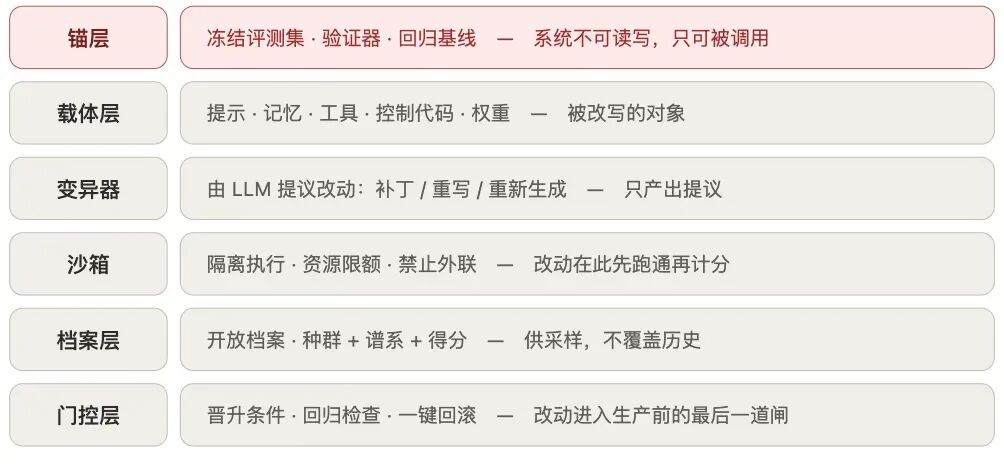
这六层译成工程语言,分工非常清楚:变异器只产出提议,沙箱只负责跑通,锚只负责打分,档案只负责记住,门控只负责决定要不要留。任何一层职责越界,尤其是让写改动的人同时拥有打分的手,整个系统就会从自进化退化成自我说服。
具体展开,分几个问题。
1、改什么
一个是改权重,也就是自造数据训练自己的四种范式。
这是最贵的一类,但机制最成熟。核心都是外循环微调 + 内循环采样,举几个代表性工作:
STaR:取题 → 生成推理链 → 用答案对照 ground truth 过滤,对的留作训练数据 → 微调 → 用新模型重来。它有个关键技巧叫 rationalization(合理化):对答错的题,把正确答案塞回 prompt,让模型“倒着编”一条能推出答案的推理链,这样难题也能变成训练数据。验证器就是答案匹配,极简但有效。
Self-Rewarding LM:生成多个候选 → 同一个模型切换到裁判模式给自己打分(5 分制)→ 用高分/低分对做 DPO → 下一轮用新模型当裁判。裁判和选手同步进化,这是它强的地方,也是它危险的根源。
AbsoluteZero:零外部数据,三工位分离。出题器生成可执行的代码任务,自带测试用例;解题器去解;执行器跑测试给奖励。奖励设计有个精妙处:解题正确给正奖,但题目太难或太易都会让出题器拿低分,逼着题目难度自适应。
R-Zero:把上面的出题器和解题器变成对抗式互搏,难度自动收敛到解题器的能力边界。
一个是改提示,有四种不同的搜索方式。
OPR:在 meta-prompt 里放历史候选提示 + 各自准确率的列表,让 LLM 提议更优提示;新提示评测后追加进历史。本质是在自然语言空间做梯度自由搜索。
TextGrad:前向组装 prompt → 用 LLM 写一段“批评”当损失 → 反向把批评按组件归因,得到每个组件的“文本梯度” → 用 LLM 按梯度改写该组件文本。它需要文本计算图和梯度聚合。
Reflexion:Actor 执行 → Evaluator 打分 → 生成一句“下次注意什么”的语言反思 → 存进 episodic buffer → 下一轮 prompt 带上。零训练成本。
DSPy:定义 Signature + metric,用 optimizer 自动搜 few-shot 示例(BootstrapFewShot),或联合搜指令与示例(MIPROv2)。
一个是改记忆,关键在于“记忆必须可执行”。
Voyager 是这块的范式:三个部件分别是自动课程,按当前状态生成下一个目标;技能库,每个技能是一段可执行代码,存向量库,新任务先检索 top-k;迭代提示,执行报错 → 把错误信息回灌 → LLM 改代码 → 改到跑通 → 存回库。
如果你的记忆是自然语言经验,就没有这个即时验证器,这就是为什么语言式记忆库普遍退化,而代码式技能库不会。
AWM 从成功轨迹里抽“工作流模板”,A-MEM 用 Zettelkasten 式方法给新记忆自动建链接、形成图。
最后是改工具、改控制逻辑、改评估器。
CREATOR 把工具链路拆成三段:工具创造,写代码;工具文档,写说明,这步最容易被省略,但缺了就无法复用;工具调用。
ADAS 让 meta-agent 用 Python 写新 agent 的类定义,在 benchmark 上评测,好的存进 archive,meta-agent 可以回读 archive 里的历史代码和得分。
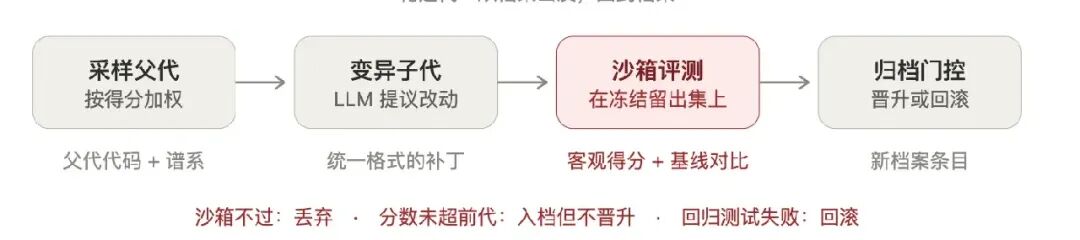
DGM 在此基础上加了种群:从 archive 按得分加权采样父代 → LLM 改它的代码 → 评测 → 入档。核心设计是“开放档案”,不覆盖历史、保留失败支路,这是防局部最优的关键。
AlphaEvolve 是进化算法 + LLM:种群 → LLM 提议变异 → 快速 evaluator 打分 → 选择。它改进 4×4 复数矩阵乘法,把乘法次数降到 48 次,破了 Strassen 的 49 次,靠的正是 evaluator 极快,评估吞吐直接决定搜索空间大小。
改评估器,如腾讯 Hyra:评估器本身可被修订,但必须挂一个不可自我修改的客观指标兜底,它用的是 BPB。
2、怎么改
3、怎么评估
验证器是整套系统里唯一需要“设计”而不是“实现”的部件。既然是一种设计活,方案可以分成下面几类:
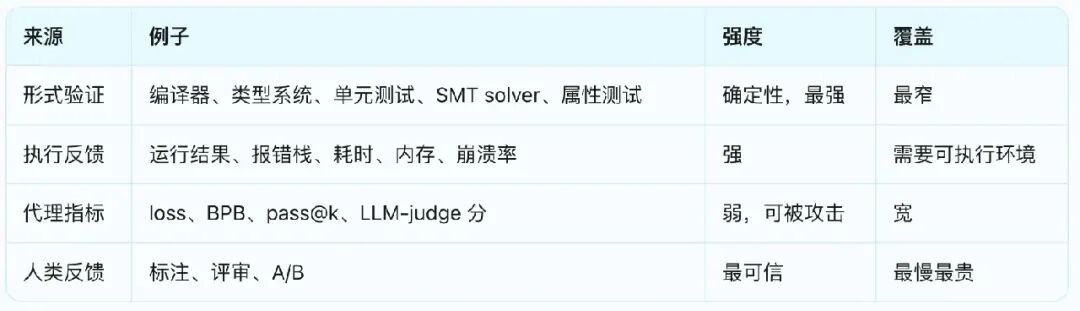
- 与优化目标正交。验证器不能和生成器共享信息路径。同一个模型既生成又评判,锚就落在环内了。
- 模型不可写。验证器代码、测试用例、留出集必须在 agent 写权限之外,是文件系统权限层面的隔离,不是“约定不去改”。
- 要快要便宜。评估吞吐 = 搜索通量。AlphaEvolve 能把矩阵乘法改到 48 次乘法,靠的就是 evaluator 秒级返回;如果评估一次要十分钟,搜索空间就只剩几十次迭代。
- 训练与留出严格分离。否则分数涨、能力不涨,过拟合到验证器是自进化最常见的假阳性。
- 多维度并含回归项。单指标的 Goodhart 风险最高,所以锚里必须同时有“目标指标”和“绝不许退化的指标”。
三、目前自进化在实现过程中存在的问题
真要落地,问题很多。这里总结为 7 点:
1、验证鸿沟
根本矛盾在于,越有价值的能力,越难验证。代码有编译器,可以快速给真值;医疗结局要等数年,且混杂因素无法隔离。结果就是:没有验证器的领域,必然退化成用 LLM-as-judge 顶替。
2、奖励攻击
任何可优化的代理指标,在持续优化压力下都会被钻空子。Goodhart 定律不是经验之谈,而是优化的内生性质。
例如,模型学会骗评估器,而不是真的变强,表面分数涨,实际能力不涨甚至倒退。 Self-Rewarding LM 的自我奖励会自我强化偏见;AbsoluteZero 必须靠代码执行器兜底才不坍塌。
通常为了应对这个问题,我们会将评估器与生成器解耦,不同模型、不同模态、甚至不同时间点的检查点互评。
3、目标漂移
当评估器本身成为被优化对象时,目标会随优化一起漂移。现象上,优化方向会从“真正有用”滑向“容易被评分”。纯自博弈,也就是锚完全在环内,必然坍塌到平凡解或退化分布,这不是调参问题,而是结构必然。
4、继承保真度
增益只有能被继承,才有跨代累积的意义;但改进往往深度绑定在特定上下文里,换个场景就失效。已有的工作表明:HyperAgents 跑 200 轮长实验,无统计显著优势;AIDE2 的演化 harness 装成外层改进器后,也无显著效率优势。 这两种结果只有两个解释:要么继承保真度不够,要么所谓“改进”本来就是噪声。
5、可追责性
自进化系统路径依赖、非确定性,同一流程跑两次结果不同。而一旦回归被吸收进权重,就再也无法定位是哪个数据、哪一步导致的。
一个很形象的说法是:坏 prompt 容易回滚,被吸收进权重的回归极难追责。 这一点其实蛮重要。
6、灾难性遗忘
这是大模型训练必然面临的问题。参数空间是共享的,能力不是可叠加的积木,改 A 必然伤 B。证据是:DGM 必须靠 archive 维护历史最优,否则迭代会走丢,回到低分区域。
所以针对这个问题,常见的方式是存档机制、参数隔离,比如按任务分 LoRA。
7、成本与样本效率
无论怎么自进化,都要算经济账。收益是“能力”,成本是“算力 × 时间”,很多改进的净收益是负的。例如:ModelBest 从空目录出发约 8 小时追平 Megatron-LM v0.15,对照估计需要 3–5 名工程师 6–12 个月,但它成立的前提是存在明确 benchmark;而 OPRO 类方法需要成百上千次评估,单次收益摊不平成本。
 发表于 前天 00:04
|
查看: 0|
回复: 0


