来看看知识自进化的话题,有点意思。
严格来讲,知识自进化(Knowledge Self-Evolution, KSE)指的是一个系统在不依赖每次人工重建的前提下,将新经验持续转化为结构化、互连、带版本的知识资产,并自动完成结构重组、矛盾消解、记忆反思与外部补充的能力。它是一套“让知识资产随时间增值”的机制总称,并非某个具体框架。这个可以展开聊聊。
一、大家谈的知识自进化都是啥?
之前看过 llm-wiki,里面点出一个矛盾:LLM 的上下文是“阅后即焚”的,而 RAG 每次查询都从原始文档重新检索、重新拼凑,没有任何积累。问一个需要综合 5 份文档的微妙问题,模型每次都得从零再推理一遍。
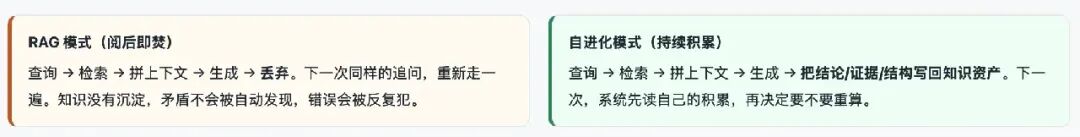
所以这里的逻辑在于:知识的价值在于复利。人类记忆靠“编码→存储→巩固→提取→再巩固”把经验变成长期资产。AI 系统要“智能”,就必须把一次性推理变成可持久化、可结构化、可互连、可演化的知识资产。
因此,自进化的纵向机制就落在三层架构上,也就是 Karpathy 的 LLMWiki 模式,归纳如下:
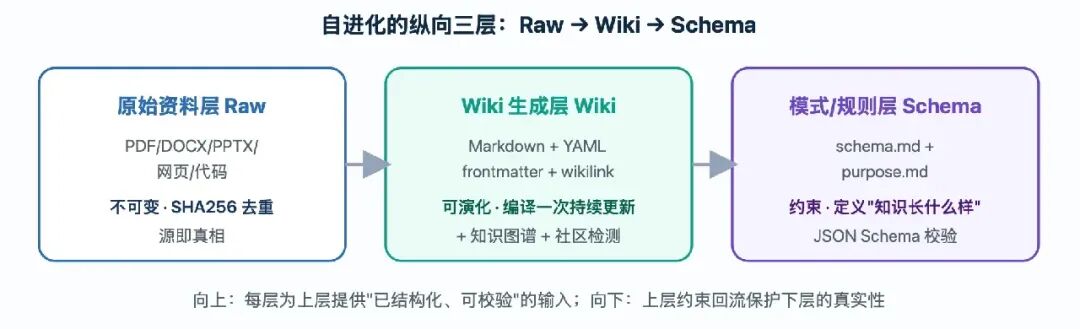
原始资料层(Raw,不可变):PDF/DOCX/PPTX/网页/代码,SHA256 去重,源即真相;
Wiki 生成层(Wiki,LLM 生成、可演化):Markdown + YAML frontmatter + wikilink + 知识图谱 + 社区检测,知识在这一层“编译一次、持续更新”;
模式/规则层(Schema,约束):schema.md + purpose.md + JSON Schema 校验,定义“知识长什么样、为什么长这样”。
顺着这个纵向思路,“怎么进化”是机制问题,横向则要回答“谁在进化”。知识自进化会发生在三类主体上:
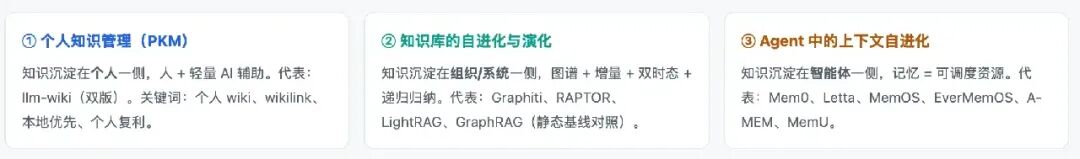
一类是个人知识管理(PKM):知识沉淀在个人一侧,人 + 轻量 AI 辅助。代表:llm-wiki(双版);
一类是知识库的自进化与演化:知识沉淀在组织/系统一侧,图谱 + 增量 + 双时态 + 递归归纳。代表:Graphiti、RAPTOR、LightRAG、GraphRAG(静态基线对照);
一类是 Agent 中的上下文自进化:知识沉淀在智能体一侧,记忆等于可调度资源。代表:Mem0、Letta、MemOS、EverMemOS、A-MEM、MemU。
但问题又来了——大家都说自己有“自进化”,可真正的自进化总得有个判定依据吧?其实可以归纳出 5 种信号,如下表所示:
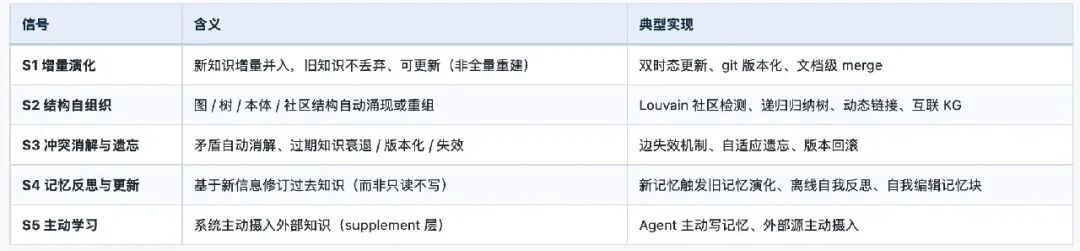
基于这个表,可以写个等式:知识自进化 = 把“一次性推理”升级为“可复用的认知资产”,并通过增量、结构、冲突消解、反思、主动学习五条信号,让资产随时间不退化反而增值。它买的不是“更聪明的模型”,而是“更便宜、更可靠、可审计的智能”。
二、关于自进化的3篇文章指引
事实上,云栈社区已经系统整理过一些关于自进化的文章,这里做个索引列表。
1、《技术再总结:知识自进化的3个Demo级项目及9个基本问题》(https://mp.weixin.qq.com/s/_n5dTGG0sXZXWMdj696j2g),介绍了 LLMWiki / Obsidian-Wiki / GBrain 三个项目。
2、《技术总结:本体论4个技术报告及本体自进化、本体驱动Agent自进化的一些分析》(https://mp.weixin.qq.com/s/F0TBKqKwgIJ9iAIQDWKUmg),对本体自进化(Ontology Self-Evolution)和本体驱动的 Agent 自进化(Ontology-driven Agent Self-Evolution)做了总结。
3、《再看本体如何增强Agent自进化?Agent用于时序建模任务技术综述》(https://mp.weixin.qq.com/s/uHo-tw9E-heuxG8FvARp9A),里面提到一篇文章(ref: https://mp.weixin.qq.com/s/Bh6hRpeRMf-zjodKDkSKVQ),同样讲了本体增强的自进化方法。
 发表于 昨天 23:39
|
查看: 19|
回复: 0


