大模型公布成绩,我们已经见得多了。但把正在发生的强化学习训练挂到网上——钱在烧,曲线在走,节点出故障也原样公告——这样的现场很少见。
2026 年 9 月 17 日,小米 MiMo 负责人罗福莉连发三条帖子,把近半年的沉默归结成一个问题:强化学习到底能扩展到多远?此时,MiMo-V2.6 的 RL 训练还在进行。
这不是一次常规发布会。没有完成版模型,没有最终榜单,也没有已经证明的胜利。小米先公开了一个仍可能失败的过程。
01 一块还在跳动的训练仪表盘
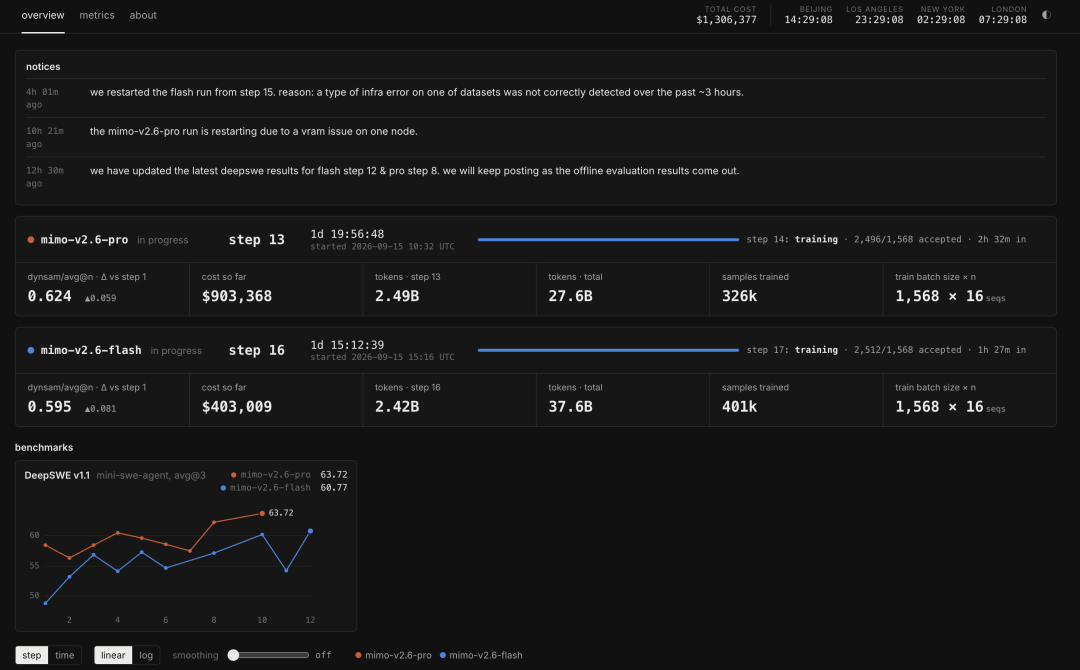
用户提供的官方看板截图,时点约为北京时间 2026 年 9 月 17 日 14:29,数据仍在实时变化。
从截图能看到两条并行的训练线:MiMo-V2.6-Pro 跑到第 13 步,已支出 903,368 美元;MiMo-V2.6-Flash 跑到第 16 步,已支出 403,009 美元。两者合计超过 130 万美元。
两条训练线同时推进,成本也在同步累积。
这些数字只是一张快照。官方页面直接从训练器日志读取数据,持续更新费用、步数、本步和累计 Token、训练样本、奖励指标以及离线评测。因此,看板里的数字必须带上时点,不能当成最终成绩。
实时看板里的任何一帧,都只是变化过程中的快照。
真正引人注意的是,训练的不稳定也没有被剪掉。公告栏显示,Pro 曾因单个节点的显存问题重启;Flash 也因某个数据集上的基础设施错误未被及时检测,从第 15 步重跑。公开的不只是绩效,还有返工。
公开训练,也意味着把故障和返工一起暴露出来。
02 罗福莉说的“扩展 RL”,其实有三层
第一层是计算规模。MiMo 公开的配置是每步约 20 亿 Token,1,568 个 Prompt,每个 Prompt 生成 16 条 Rollout,并以全异步方式运行。Rollout 可以理解为模型完成一次任务的整条尝试轨迹。
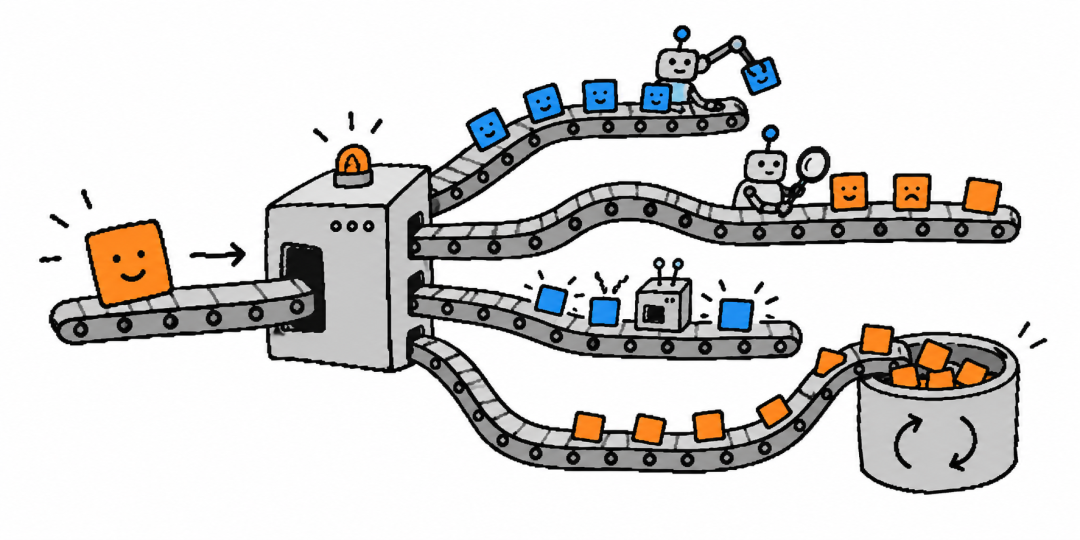
全异步训练让不同阶段不必在同一条队伍里等待。
1,568 × 16,等于一个训练步里理论上有 25,088 条候选轨迹。与普通问答不同,Agent 任务可能包含多轮思考、工具调用和环境反馈。当“一次回答”变成“一段行动过程”,Token 和运算成本就会被快速放大。
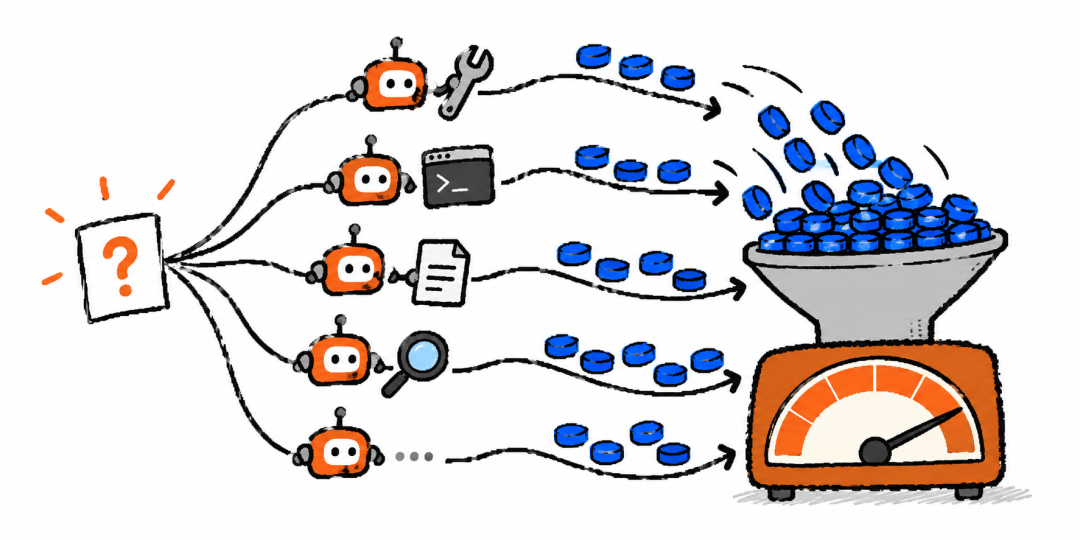
一个任务会分叉成许多长轨迹,工具调用把 Token 和成本一起放大。
第二层是环境与 Harness。Harness 是让 Agent 接收任务、使用工具、获得反馈并继续行动的执行框架。MiMo-V2.6 把多任务 Agentic RL 混在同一次训练里,让任务运行在多套 Harness 上。官方看板列出的数据类别包括代码、通用、网络安全、视觉和聊天。
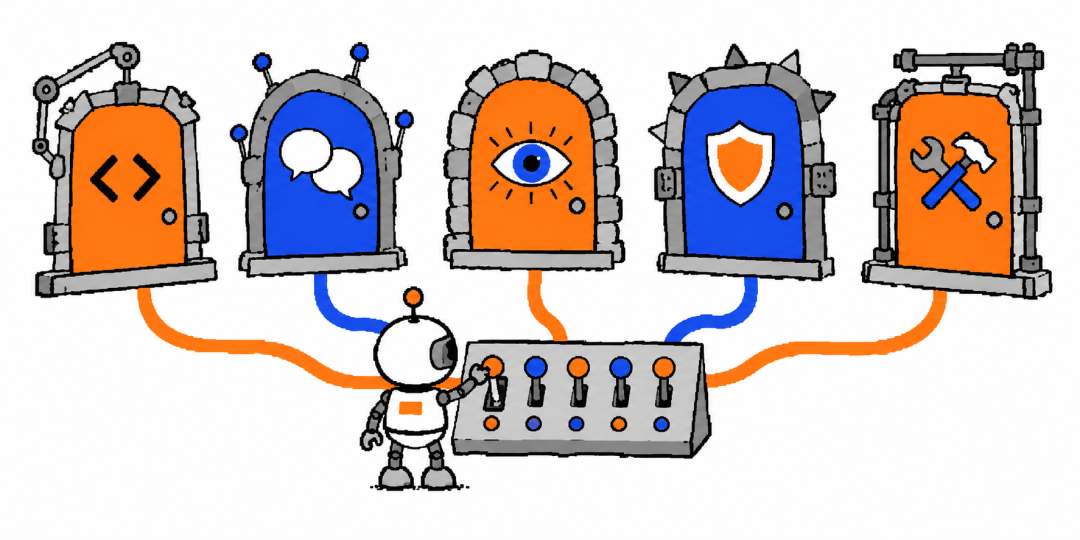
环境变多,Agent 才有机会在不同任务中学习。
第三层是评分算力,也是最容易被低估的一层。轨迹变多之后,系统不只要问“最后成功了吗”,还要判断哪些步骤真正推动了成功。MiMo 提到 Agentic In-group Credit Assignment,同时使用测试用例和评分量规作为奖励信号。具体算法尚未公布,但方向很明确:评价经验本身,也要投入更多计算。
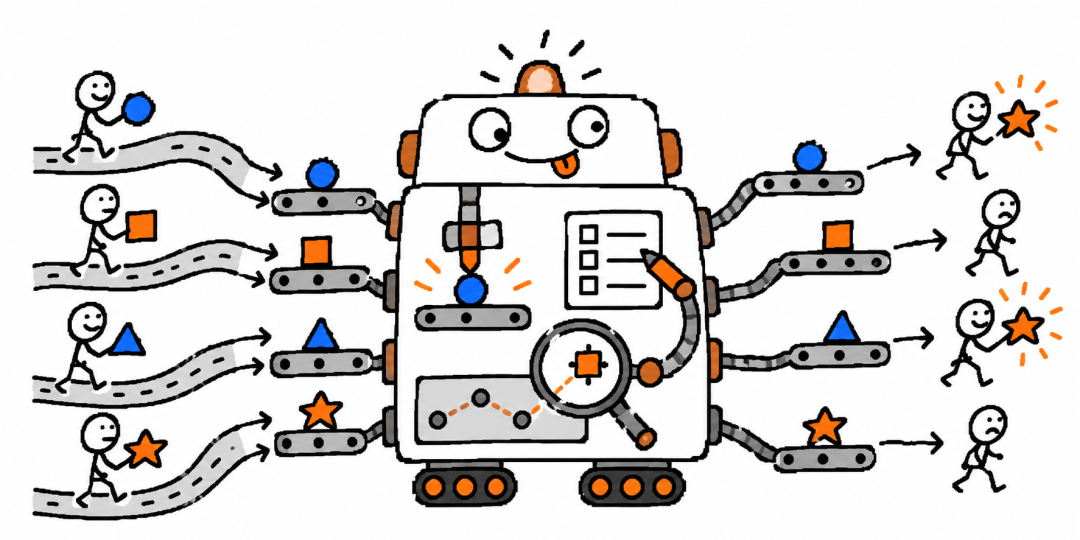
评分不仅判断结果,还要追踪哪些动作真正带来成功。
03 三层扩展,拼成一台“经验机器”
把三层放在一起,就能看懂这次训练想验证的东西:更多计算让模型产生更多尝试;更多环境让尝试不局限在一类题目里;更多评分算力再从大量轨迹中提取比“成功或失败”更精细的学习信号。
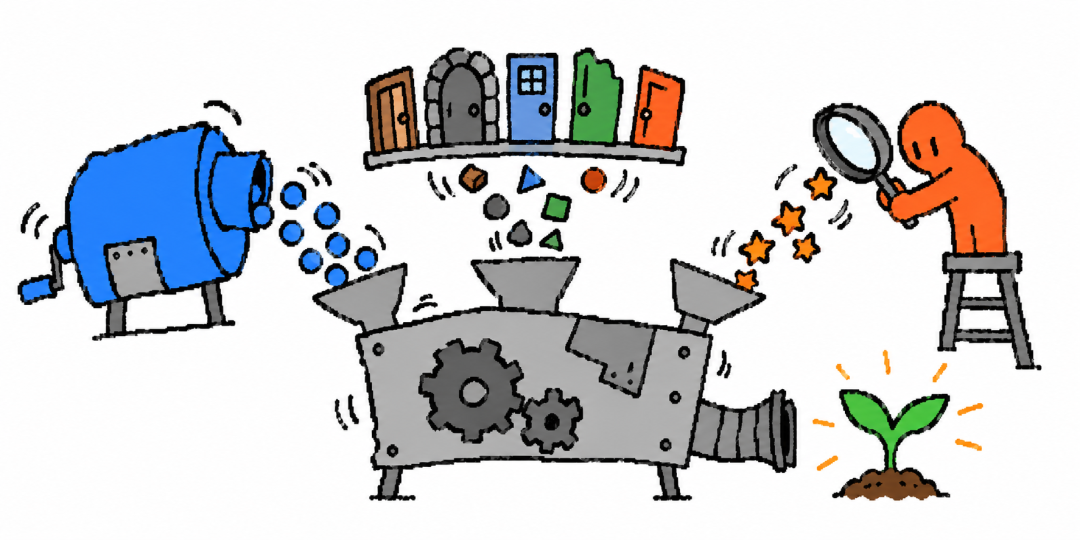
更多经验、更广环境、更精细反馈,共同构成学习循环。
这就是罗福莉为什么把 RL 称为通向自我改进的可扩展、高效路径之一。重点不是让模型反复背更多答案,而是让它进入环境、行动、被检验,再从这些经验中更准确地学习。
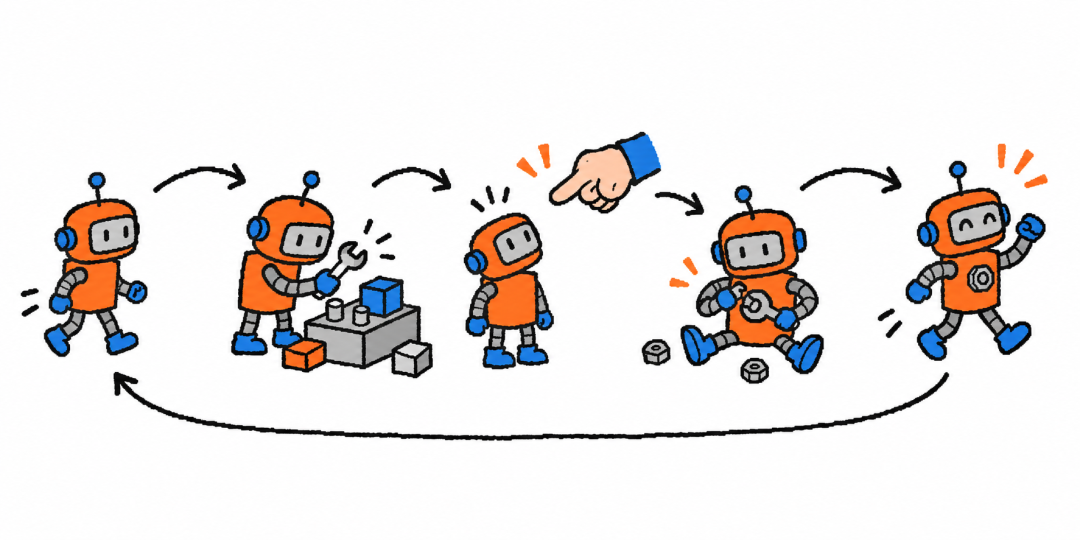
行动、反馈、修正,再进入下一轮。
但这个判断仍然只是研究假设,不是看板已经证明的结论。曲线上涨、某个离线评测提升,不等于最终模型已经收敛,更不等于它在所有现实任务上都更好。
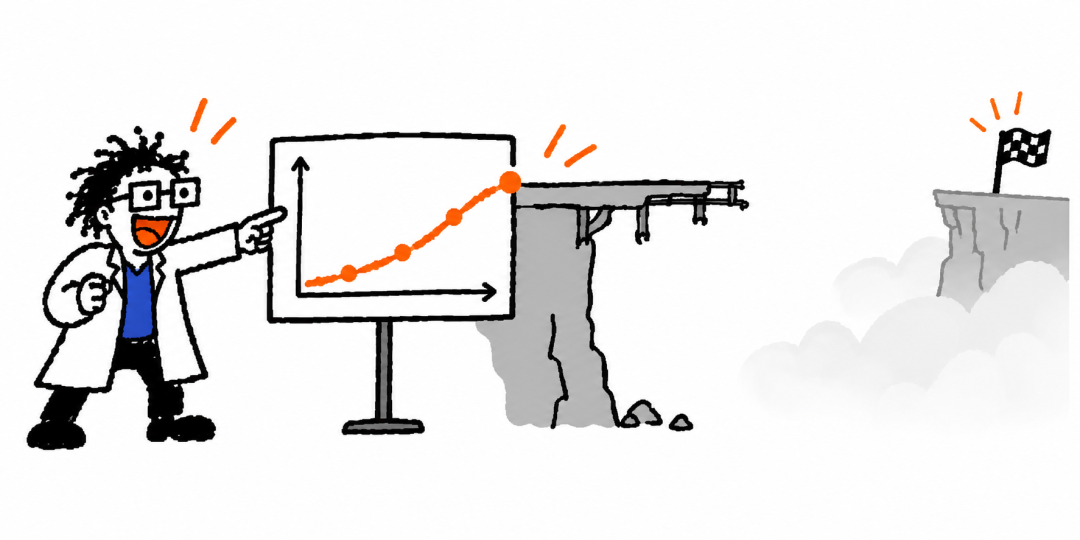
曲线上升是信号,不是抵达终点的证明。
04 这场直播真正开放的,是讨论的入口
罗福莉在第三条帖子里说,希望这场直播能让研究社区更关注 RL 规模化的核心挑战,也欢迎研究者帮助改进训练配方。她特别提到,团队已经看到不少基于详细训练指标的深度分析。
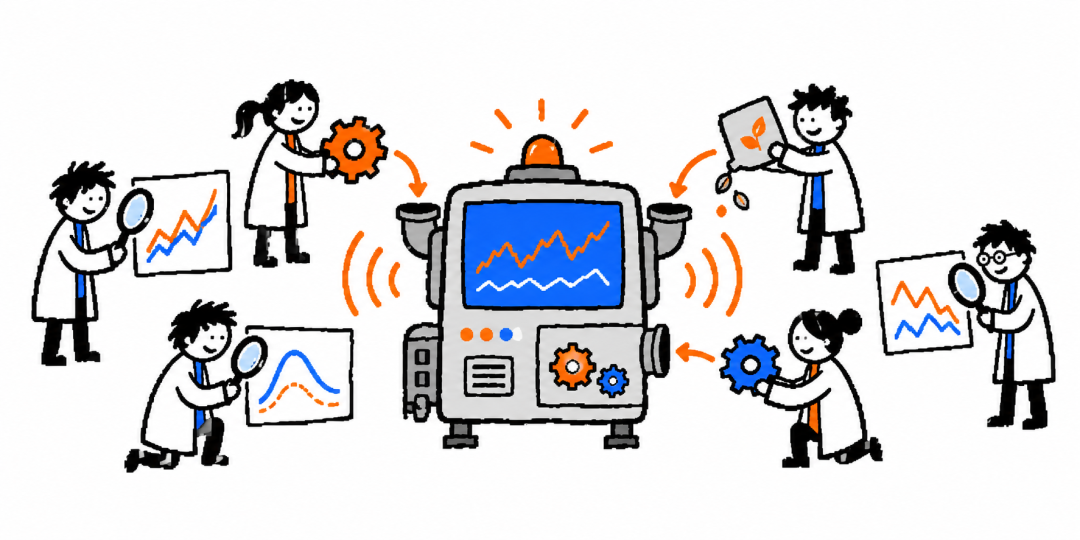
公开指标让研究社区能分析,也能把改进送回训练系统。
一块实时看板并不等于开源。它没有给出完整代码、数据、权重与可复现配方。但它提供了一组可以持续观察和质疑的对象:成本如何增长,奖励曲线是否稳定,故障怎样处理,不同规模的模型能否在更长的 RL 中持续改进。
看见仪表盘,不等于拿到代码、数据、权重和完整配方。
团队承诺将在未来几周逐步开源技术细节。所以,现在最值得记住的不是某一秒的成本,也不是某一步的分数,而是这个可被验证的承诺。等方法公布后,外界才能判断这台“经验机器”是真的可复现,还是只有一块很会说话的仪表盘。
技术细节能否被复现,才是承诺兑现的检验。
05 接下来,别只盯着“又烧了多少钱”
对普通读者,这块看板最容易看的是成本;对研究者和工程师,更值得跟踪的其实是三件事。
成本最醒目,但持续进步、任务泛化与评分效率更值得盯。
- 能力提升是否能跨越多个步骤持续发生,而不是只在某一次评测里短暂抬头;
- 多任务、多 Harness 混合训练后,模型是获得更好的泛化,还是在任务之间互相干扰;
- 评分算力投入能否换来更准确的信用分配,以及这部分投入的性价比。
要同时观察进步是否持续、任务是否互相干扰、反馈是否划算。
强化学习能扩展到多远,还没有答案。但小米至少做了一件有意思的事:它没等到结论被打磨完,就把问题、账单、曲线和故障一起交给了公众。
机器还没跑完,问题、账单、曲线和故障已经被放到窗口前。
主要来源
 发表于 昨天 23:52
|
查看: 4|
回复: 0


